Kiedy regresja porządkowa, a kiedy inny model
Pytasz respondentów, jak oceniają swój sen, jak często czują się przemęczeni albo na ile zgadzają się z jakimś stwierdzeniem. Odpowiedzi mają kolejność, ale odległości między nimi nie są znane: nie wiadomo, czy różnica między „złą” a „przeciętną” jakością snu jest taka sama jak między „dobrą” a „bardzo dobrą”. Tak wygląda zmienna na skali porządkowej. Gdy to ona jest zmienną zależną, a chcesz sprawdzić wpływ kilku predyktorów naraz, najczęściej sięga się po porządkową regresję logistyczną, czyli model proporcjonalnych szans.
Definicję, krótki przykład i listę pojęć znajdziesz w haśle regresja porządkowa. Ten poradnik prowadzi przez całą analizę na jednym zbiorze danych, w siedmiu krokach: od opisu zmiennej przez dopasowanie modelu, ilorazy szans i prawdopodobieństwa, sprawdzenie założenia, ocenę dopasowania po tabelę i opis w stylu APA. Jeśli regresji logistycznej jeszcze nie znasz, zacznij od poradnika regresja logistyczna krok po kroku. Regresja porządkowa to jej rozszerzenie, a wiele zasad (iloraz szans, prawdopodobieństwa przewidywane, test ilorazu wiarygodności) przenosi się wprost.
Najpierw upewnij się, że to właściwe narzędzie. Wybór modelu wynika z tego, jaką zmienną zależną masz.
| Zmienna zależna | Przykład | Model |
|---|---|---|
| Ilościowa, wiele wartości | wynik testu, suma punktów skali | regresja liniowa (wieloraka) |
| Dwie kategorie | zdał – nie zdał | regresja logistyczna |
| Kilka uporządkowanych kategorii | jakość snu od „bardzo zła” do „bardzo dobra”, wykształcenie, stopień nasilenia objawów | regresja porządkowa |
| Kilka kategorii bez kolejności | wybrany kierunek studiów, preferowana forma terapii | wielomianowa regresja logistyczna |
| Liczba zdarzeń | liczba wizyt u lekarza w roku | regresja Poissona lub ujemna dwumianowa |
Dwie pokusy są tu szczególnie częste. Pierwsza to policzenie zwykłej regresji liniowej na kodach 1–5. Liddell i Kruschke (2018) przejrzeli artykuły z trzech czołowych czasopism psychologicznych i stwierdzili, że wszystkie, w których dane były porządkowe, analizowały je modelami metrycznymi. Pokazali też, że może to dawać fałszywe alarmy, utratę mocy, a nawet odwrócenie kierunku efektu. Bürkner i Vuorre (2019) dodają, że traktowanie danych porządkowych jak metrycznych zniekształca wielkości efektów. Druga pokusa to połączenie kategorii w dwie grupy („dobry sen” – „zły sen”) i policzenie regresji logistycznej. To wyrzuca część informacji, podobnie jak dzielenie medianą zmiennej ilościowej, którego MacCallum i in. (2002) prawie nigdy nie uznają za uzasadnione. W kroku 6 zobaczysz, ile to kosztuje w naszych danych.
Uczciwie trzeba dodać, że spór o skale Likerta nie jest rozstrzygnięty. Norman (2010) przypomina, że metody parametryczne są odporne na naruszenia założeń i dają się stosować także do danych ze skal Likerta. Sullivan i Artino (2013) rozróżniają jednak pojedynczą pozycję, której odpowiedzi są porządkowe, od skali złożonej z wielu pozycji. Regresja porządkowa jest najbardziej naturalna wtedy, gdy zmienna zależna to jedno pytanie z kilkoma odpowiedziami, a nie suma lub średnia z kilkunastu pozycji. O tym, ile stopni odpowiedzi warto dać respondentom, piszemy w tekście ile stopni skali Likerta wybrać.
Przykład: od czego zależy jakość snu studentów?
W przykładzie (dane symulowane) 320 studentów oceniło jakość swojego snu w ostatnim miesiącu na pięciostopniowej skali: bardzo zła, zła, przeciętna, dobra, bardzo dobra. Predyktorami są trzy zmienne:
- stres – średnia z 10 pozycji ocenianych od 1 do 5 (M = 3.02, SD = 0.75);
- czas z telefonem w łóżku przed zaśnięciem w minutach (mediana 41 min, IQR 25.75–65.00); w modelu liczony w jednostkach 30 minut, bo „o minutę” to zmiana bez znaczenia;
- regularna aktywność fizyczna (1 = tak; 125 osób, 39.1%).
Hipotezy są proste: wyższy stres i dłuższy czas z telefonem wiążą się z gorszą jakością snu, a aktywność fizyczna – z lepszą, przy kontroli pozostałych zmiennych.
Plik do pobrania: regresja-porzadkowa-dane-przyklad.csv – 320 wierszy, kolumny id, sen (1 = bardzo zła … 5 = bardzo dobra), stres, ekran (minuty), sport (1 = tak). Wszystkie liczby w tekście, tabeli i na rysunkach pochodzą z kodu w sekcji Przykład w R.
Krok 1. Opisz zmienną zależną i sprawdź liczebności kategorii
Zanim policzysz model, zobacz, jak rozkładają się odpowiedzi. W modelu porządkowym ważna jest liczebność każdej kategorii, a nie tylko całej próby. Kategorie, które wybrało kilka osób, dają niestabilne progi, a w skrajnym przypadku model nie da się oszacować.
| Jakość snu | n (%) w całej próbie | % bez regularnej aktywności (n = 195) | % z regularną aktywnością (n = 125) |
|---|---|---|---|
| bardzo zła | 37 (11.6%) | 13.8 | 8.0 |
| zła | 75 (23.4%) | 28.2 | 16.0 |
| przeciętna | 97 (30.3%) | 31.8 | 28.0 |
| dobra | 85 (26.6%) | 21.5 | 34.4 |
| bardzo dobra | 26 (8.1%) | 4.6 | 13.6 |
Najmniej liczna kategoria („bardzo dobra”) ma 26 osób, co przy trzech predyktorach wystarcza. Gdyby skrajną odpowiedź wybrały np. trzy osoby, rozważ połączenie jej z sąsiednią, ale zrób to przed analizą, z uzasadnieniem merytorycznym, i opisz w pracy. Już tabela krzyżowa podpowiada wynik: wśród osób aktywnych odpowiedzi przesuwają się w stronę lepszego snu. Taki opis to dobry wstęp do rozdziału wyników, ale nie zastępuje modelu, bo nie uwzględnia stresu ani czasu z telefonem.
Krok 2. Dopasuj model proporcjonalnych szans
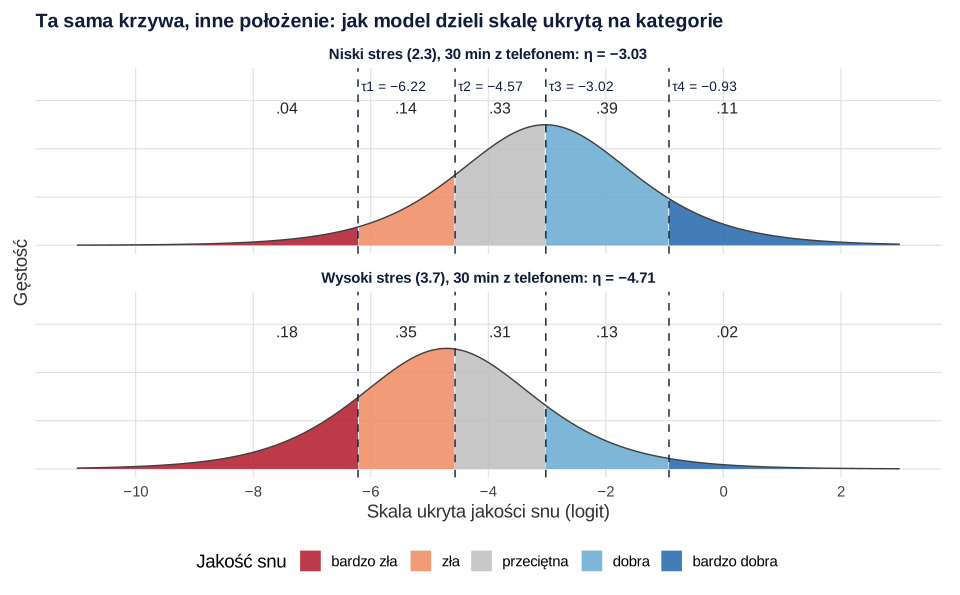
Model proporcjonalnych szans, opisany przez McCullagha (1980), nie wymaga przypisywania kategoriom wartości liczbowych. Korzysta tylko z ich kolejności. Zamiast prawdopodobieństwa jednej kategorii modeluje prawdopodobieństwa skumulowane: że odpowiedź jest co najwyżej „bardzo zła”, co najwyżej „zła”, co najwyżej „przeciętna” i co najwyżej „dobra”. Przy pięciu kategoriach powstają cztery takie podziały, a każdy ma własny próg (τ), lecz wszystkie mają te same współczynniki predyktorów.
Znak minus nie jest pomyłką. Funkcja MASS::polr() w R używa takiej parametryzacji, aby dodatni współczynnik oznaczał przesunięcie w stronę wyższych kategorii (tu: lepszego snu). Inne programy mogą zapisywać model ze znakiem plus. Zanim zinterpretujesz wydruk z SPSS, JASP lub jamovi, sprawdź w dokumentacji swojej wersji, jak program definiuje progi i znaki współczynników. Model szacuje się metodą największej wiarygodności.
W naszych danych model z trzema predyktorami jest lepiej dopasowany niż model bez predyktorów (z samymi progami). Test ilorazu wiarygodności porównuje dewiancje obu modeli (964.73 i 870.02): χ²(3) = 94.71, p < .001. Oszacowany model ma postać:
τ1 = −6.22, τ2 = −4.57, τ3 = −3.02, τ4 = −0.93
Najłatwiej zrozumieć ten model przez zmienną ukrytą. Wyobraź sobie, że każdy student ma ciągłą, nieobserwowaną „jakość snu”, a pytanie w ankiecie tnie ją w czterech miejscach – na progach τ. Predyktory przesuwają całą krzywą rozkładu tej zmiennej w lewo lub w prawo, ale nie zmieniają jej kształtu. Dlatego jeden współczynnik wystarcza dla wszystkich progów. Rysunek 1 pokazuje dwa profile studentów, które różnią się tylko stresem.
Progi same w sobie rzadko są przedmiotem hipotez. Podaj je w tabeli, ale nie interpretuj ich jak stałej w regresji liniowej. Zwróć jedynie uwagę, czy rosną (muszą) i czy odstępy między nimi są sensowne. Bardzo bliskie progi oznaczają, że jakąś kategorię wybiera niewiele osób.
Krok 3. Zinterpretuj współczynniki jako ilorazy szans
Tak jak w regresji logistycznej, współczynnik b zamieniasz na iloraz szans: OR = eb. Różnica polega na tym, czego dotyczą szanse. W modelu porządkowym to szanse odpowiedzi wyższej niż dowolny próg wobec odpowiedzi na progu lub poniżej: „co najmniej zła” wobec „bardzo złej”, „co najmniej przeciętna” wobec „złej lub bardzo złej” i tak dalej. Model zakłada, że ten iloraz jest taki sam dla każdego podziału – stąd nazwa „proporcjonalne szanse”.
- Stres: b = −1.20, OR = 0.30, 95% CI [0.22, 0.41]. Wzrost stresu o 1 punkt wiąże się z mniej więcej 3.3 raza mniejszymi szansami lepszej jakości snu (1 / 0.30 = 3.32), niezależnie od tego, gdzie postawisz granicę „lepszego” snu. Jeden punkt to jednak więcej niż jedno odchylenie standardowe tej skali. Dla wzrostu o 1 SD (0.75 punktu) OR = 0.41.
- Telefon w łóżku: b = −0.27, OR = 0.76, 95% CI [0.64, 0.91]. Każde dodatkowe 30 minut z telefonem przed snem wiąże się z szansami lepszej jakości snu mniejszymi o około 24%, przy tym samym stresie i aktywności.
- Aktywność fizyczna: b = 0.73, OR = 2.08, 95% CI [1.36, 3.20]. Osoby regularnie aktywne mają około dwukrotnie większe szanse odpowiedzi wyższej niż dowolny próg niż osoby nieaktywne o tym samym poziomie stresu i czasie z telefonem.
Przedziały ufności dla OR liczone są z profilu funkcji wiarygodności (domyślnie w confint() dla modeli polr), a przedział jest niesymetryczny wokół OR, bo powstaje na skali logitu. Wartość p przy współczynniku pochodzi z testu Walda (z = b / SE).
Iloraz szans nie mówi, o ile wzrośnie prawdopodobieństwo konkretnej odpowiedzi. Zdanie „aktywni dwa razy częściej śpią bardzo dobrze” jest błędne – OR dotyczy szans skumulowanych, a prawdopodobieństwo pojedynczej kategorii może się zmieniać w różnym stopniu, a nawet w przeciwnych kierunkach. Środkowe kategorie są tu szczególnie zdradliwe: przesunięcie rozkładu w prawo zmniejsza odsetek odpowiedzi „zła”, ale odsetek odpowiedzi „przeciętna” może przy tym wzrosnąć albo spaść. Dlatego kolejny krok jest obowiązkowy.
Krok 4. Przelicz model na prawdopodobieństwa przewidywane
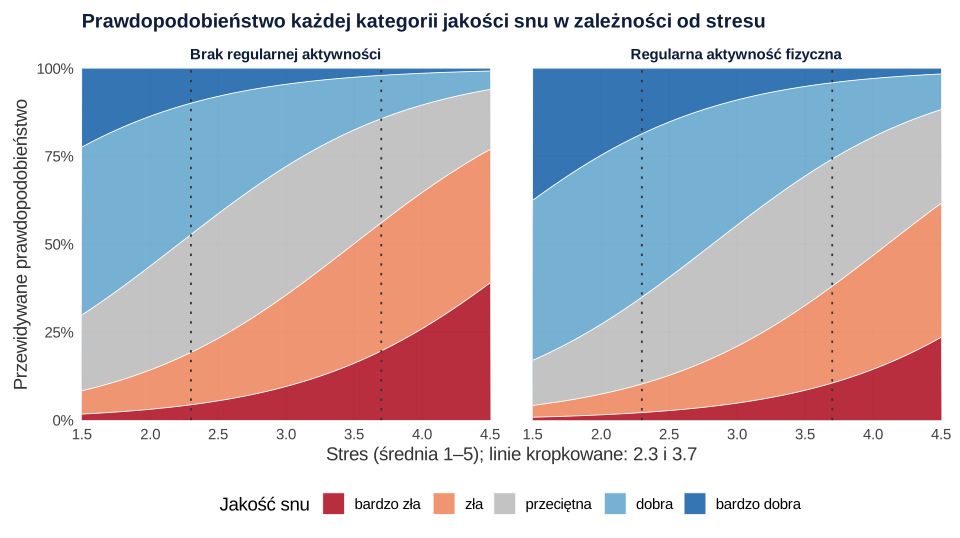
Najlepiej zrozumiałą formą wyniku są prawdopodobieństwa każdej odpowiedzi dla kilku typowych profili studentów. „Niski” i „wysoki” stres to tu w przybliżeniu średnia minus i plus jedno odchylenie standardowe (2.3 i 3.7 punktu).
| Profil studenta | bardzo zła | zła | przeciętna | dobra | bardzo dobra | dobra lub bardzo dobra [95% CI] |
|---|---|---|---|---|---|---|
| Niski stres, 30 min z telefonem, bez sportu | .04 | .14 | .33 | .39 | .11 | .50 [.40, .59] |
| Wysoki stres, 30 min, bez sportu | .18 | .36 | .31 | .13 | .02 | .16 [.11, .21] |
| Wysoki stres, 90 min, bez sportu | .28 | .39 | .24 | .08 | .01 | .10 [.06, .15] |
| Wysoki stres, 90 min, sport | .16 | .33 | .33 | .16 | .03 | .18 [.12, .27] |
Przy niskim stresie połowa takich studentów (.50) ocenia sen jako dobry lub bardzo dobry, przy wysokim – tylko .16. Dodanie godziny z telefonem obniża ten odsetek do .10, a regularna aktywność fizyczna częściowo to rekompensuje (.18). Przedziały ufności dla prawdopodobieństw policzono, losując 2000 zestawów współczynników z ich rozkładu (z macierzy kowariancji oszacowań) i odczytując 2.5. i 97.5. centyl. Zwróć uwagę na odpowiedź „przeciętna” w ostatnich dwóch wierszach: sport podnosi jej prawdopodobieństwo z .24 do .33, choć „przesuwa w stronę lepszego snu” – po prostu ubywa odpowiedzi złych.
Rysunek 2 pokazuje cały zakres stresu. Każdy pionowy przekrój to rozkład pięciu odpowiedzi, który sumuje się do 100%.
Jedną liczbą w punktach procentowych opisuje efekt przeciętny efekt krańcowy (AME). Dla każdej osoby z próby liczysz prawdopodobieństwo snu dobrego lub bardzo dobrego dwa razy: jakby była aktywna i jakby nie była, a różnice uśredniasz. W przykładzie regularna aktywność wiąże się średnio z prawdopodobieństwem dobrego lub bardzo dobrego snu wyższym o 14.1 punktu procentowego, 95% CI [5.9, 22.4]. Ta liczba jest dla promotora znacznie bardziej zrozumiała niż „OR = 2.08”.
Krok 5. Sprawdź założenie proporcjonalnych szans
Kluczowe założenie modelu mówi, że każdy predyktor ma ten sam efekt dla wszystkich progów. Szczegóły, przykład naruszenia i sposoby postępowania opisuje hasło założenie proporcjonalnych szans. Tu pokażę dwie praktyczne kontrole na naszych danych.
Kontrola wzrokowa. Brant (1990) zauważył, że model proporcjonalnych szans można przedstawić jako serię regresji logistycznych dla podziałów „powyżej progu” wobec reszty, ze wspólnymi współczynnikami. Dopasuj więc cztery osobne regresje logistyczne i porównaj ich OR ze wspólnym OR z modelu (rysunek 3). Dla stresu osobne OR wynoszą 0.28, 0.31, 0.31 i 0.21 (wspólny 0.30), dla telefonu 0.70, 0.82, 0.73 i 0.89 (wspólny 0.76), a dla aktywności 1.53, 1.97, 2.27 i 2.51 (wspólny 2.08). Wszystkie przedziały ufności obejmują wspólny OR.
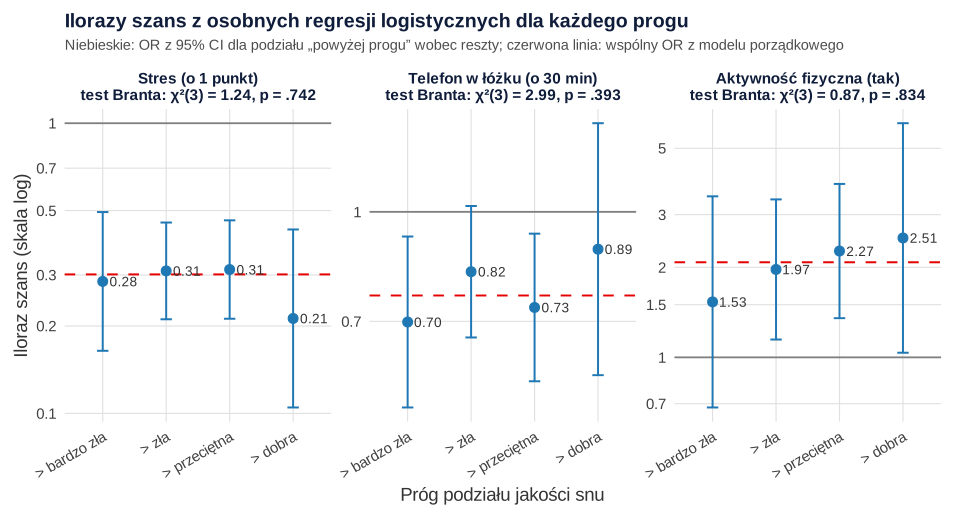
Test Branta. Formalnie porównuje te same współczynniki, uwzględniając, że cztery regresje liczono na tych samych osobach. Pakietu brant nie ma w naszym środowisku R, dlatego test policzono ze wzorów Branta (1990) w kilku linijkach kodu (przepis 3). Wynik ogólny: χ²(9) = 5.16, p = .820. Dla poszczególnych predyktorów: stres χ²(3) = 1.24, p = .742; telefon χ²(3) = 2.99, p = .393; aktywność χ²(3) = 0.87, p = .834. Brak podstaw, by odrzucić założenie.
Dwie uwagi o interpretacji. Po pierwsze, w dużych próbach test Branta wykrywa nawet drobne, praktycznie nieistotne różnice, a w małych przeoczy duże. Patrz więc na wielkość różnic między OR (rysunek 3), a nie tylko na p. Po drugie, rosnący ciąg OR dla aktywności (1.53 → 2.51) to typowy wzorzec, którego przy tej liczebności nie da się odróżnić od przypadku. Gdyby się potwierdził w większej próbie, znaczyłby, że aktywność silniej odróżnia sen dobry od przeciętnego niż bardzo zły od złego.
Co zrobić, gdy założenie jest naruszone? Nie trzeba od razu porzucać modelu. Fullerton (2009) pokazuje, że model proporcjonalnych szans to tylko jeden z kilkunastu modeli logistycznych dla danych porządkowych, różniących się tym, dla których zmiennych przyjmuje się to założenie. Najczęściej wystarcza model częściowo proporcjonalnych szans (Peterson i Harrell, 1990), w którym tylko predyktor naruszający założenie dostaje osobne współczynniki dla progów. Inne rozwiązania to modele sekwencyjne lub kategorii przyległych (Bürkner i Vuorre, 2019) albo – w ostateczności – wielomianowa regresja logistyczna, która ignoruje kolejność kategorii. W R takie modele liczy np. pakiet ordinal (funkcja clm() z argumentem nominal) albo VGAM. W naszym środowisku żadnego z nich nie ma, więc przykładu nie pokazuję – to celowa decyzja, a nie przeoczenie.
Pozostałe założenia są takie jak w regresji logistycznej: niezależne obserwacje (każda osoba raz), brak silnej współliniowości predyktorów, liniowa zależność logitu od predyktorów ciągłych i wystarczająco liczne kategorie. Predyktory jakościowe o kilku poziomach koduj zero-jedynkowo. Model nie zakłada normalności reszt ani równych odstępów między kategoriami.
Krok 6. Oceń dopasowanie i porównaj z prostszymi podejściami
Pseudo-R². W przykładzie McFadden = .098, Cox–Snell = .256, Nagelkerke = .269. To różne miary, nie „procent wyjaśnionej wariancji”. Menard (2000) pokazał, że analogi R² w regresji logistycznej różnią się zachowaniem i nie zawsze zgadzają się z miarami trafności predykcji. Podaj jedną, nazwij ją i nie porównuj z R² z regresji liniowej. Więcej w haśle pseudo-R².
Zgodność przewidywanych i obserwowanych odsetków. Średnie przewidywane prawdopodobieństwa kategorii (11.7%, 23.3%, 30.1%, 26.7% i 8.2%) prawie dokładnie odtwarzają rozkład obserwowany (11.6%, 23.4%, 30.3%, 26.6% i 8.1%). To dobra wiadomość, ale tylko minimalny warunek: model z samymi progami odtwarza rozkład tak samo. Ważniejsze jest, czy predyktory poprawiają dopasowanie – to pokazał test ilorazu wiarygodności w kroku 2.
Co by wyszło innymi metodami? Na tych samych danych policzono też regresję liniową na kodach 1–5 oraz regresję logistyczną po połączeniu odpowiedzi w „dobry lub bardzo dobry sen” (34.7% osób) wobec reszty.
| Predyktor | Regresja porządkowa (z) | Regresja liniowa na kodach 1–5 (t) | Regresja logistyczna po podziale (z) |
|---|---|---|---|
| Stres | −7.82 | −8.68 | −5.83 |
| Telefon w łóżku | −3.06 | −2.94 | −2.54 |
| Aktywność fizyczna | 3.35 | 3.37 | 3.11 |
Dychotomizacja wyniku wyraźnie osłabia statystyki testowe (dla stresu z −7.82 do −5.83), bo wyrzuca informację o tym, czy ktoś śpi „źle”, czy „bardzo źle”. Regresja liniowa daje tu podobne wnioski co porządkowa – w tych danych odstępy między kategoriami są dość równe, a rozkład odpowiedzi nie jest skrajnie skośny. Nie zawsze tak będzie: Liddell i Kruschke (2018) pokazują sytuacje, w których model metryczny myli się poważnie. Model liniowy ma też inne słabości: zakłada, że przejście z „bardzo złej” do „złej” jakości snu znaczy tyle samo co z „dobrej” do „bardzo dobrej”, i przewiduje „średnią kategorię” (tu od 1.58 do 4.41), a nie rozkład odpowiedzi. Regresja porządkowa odpowiada na pytanie, które zadałeś respondentom: jak prawdopodobne są poszczególne odpowiedzi.
Jeśli planujesz badanie, pamiętaj, że w modelach dla wyników kategorialnych liczba osób w najrzadszych kategoriach ogranicza liczbę predyktorów. Ogólne zasady planowania liczebności znajdziesz w poradniku dobór liczebności próby.
Krok 7. Tabela i opis w stylu APA
W rozdziale wyników podaj: nazwę modelu (porządkowa regresja logistyczna, model proporcjonalnych szans), kodowanie zmiennej zależnej i kierunek współczynników, liczebność i rozkład kategorii, test całego modelu, jedną miarę pseudo-R², wynik sprawdzenia założenia proporcjonalnych szans, a dla każdego predyktora b, SE, p i OR z 95% CI. Progi umieść w tabeli. Układ tabeli jest podobny do tabeli regresji logistycznej w APA, a ogólne zasady opisuje poradnik tabele APA – wzory i przykłady.
Tabela 1
Porządkowa regresja logistyczna (model proporcjonalnych szans): predyktory jakości snu
| Predyktor | b | SE | z | p | OR | 95% CI dla OR |
|---|---|---|---|---|---|---|
| Stres (1–5) | −1.20 | 0.15 | −7.82 | < .001 | 0.30 | [0.22, 0.41] |
| Telefon w łóżku (na 30 min) | −0.27 | 0.09 | −3.06 | .002 | 0.76 | [0.64, 0.91] |
| Regularna aktywność fizyczna (1 = tak) | 0.73 | 0.22 | 3.35 | < .001 | 2.08 | [1.36, 3.20] |
| Progi (τ) | ||||||
| bardzo zła | zła | −6.22 | 0.58 | ||||
| zła | przeciętna | −4.57 | 0.53 | ||||
| przeciętna | dobra | −3.02 | 0.50 | ||||
| dobra | bardzo dobra | −0.93 | 0.49 |
Uwaga. N = 320 (dane symulowane). Zmienna zależna: jakość snu w ostatnim miesiącu (1 = bardzo zła … 5 = bardzo dobra). Model: logit P(Y ≤ j) = τj − (b1X1 + b2X2 + b3X3); dodatnie b oznacza większe szanse lepszej jakości snu. Test ilorazu wiarygodności względem modelu bez predyktorów: χ2(3) = 94.71, p < .001; R2 Nagelkerkego = .27. Test Branta: χ2(9) = 5.16, p = .820. OR = skumulowany iloraz szans; 95% CI z profilu funkcji wiarygodności.
Pamiętaj o języku: dane są przekrojowe, więc piszesz „wiązał się z”, a nie „powodował”. Więcej gotowych zdań do innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA. Jeśli w Twojej pracy założenie proporcjonalnych szans jest naruszone albo nie wiesz, jak przedstawić wyniki promotorowi, możemy pomóc w ramach analiz statystycznych dla studentów: sprawdzimy model i wyjaśnimy wyniki tak, abyś umiał(a) je samodzielnie obronić.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Pobierz plik regresja-porzadkowa-dane-przyklad.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – przepisy 2–4 korzystają z obiektów dane, m0 i m1 z przepisu 1. Potrzebny jest tylko pakiet MASS, dołączany do każdej instalacji R. Pakietów ordinal i brant w naszym środowisku nie ma; funkcja ordinal::clm() dałaby te same oszacowania co MASS::polr().
1. Opis zmiennych, model i ilorazy szans
R
# Regresja porządkowa (model proporcjonalnych szans): jakość snu a stres, telefon w łóżku i sport (dane symulowane)
options(width = 110)
library(MASS)                                   # polr()
dane <- read.csv("regresja-porzadkowa-dane-przyklad.csv")
etykiety <- c("bardzo zła", "zła", "przeciętna", "dobra", "bardzo dobra")
dane$sen_f   <- factor(dane$sen, levels = 1:5, labels = etykiety, ordered = TRUE)
dane$ekran30 <- dane$ekran / 30                 # czas z telefonem w łóżku w jednostkach 30 minut

# 1. Opis zmiennych
tab <- table(dane$sen_f)
print(rbind(n = tab, procent = round(100 * prop.table(tab), 1)))
round(c(M_stres = mean(dane$stres), SD_stres = sd(dane$stres),
        Me_ekran = median(dane$ekran), Q1 = unname(quantile(dane$ekran, .25)), Q3 = unname(quantile(dane$ekran, .75)),
        sport_n = sum(dane$sport), sport_proc = 100 * mean(dane$sport)), 2)
round(100 * prop.table(table(sport = dane$sport, dane$sen_f), 1), 1)   # odsetki w wierszach

# 2. Model zerowy i model z predyktorami
m0 <- polr(sen_f ~ 1, data = dane, Hess = TRUE)
m1 <- polr(sen_f ~ stres + ekran30 + sport, data = dane, Hess = TRUE)
anova(m0, m1)                                   # test ilorazu wiarygodności
LR <- deviance(m0) - deviance(m1)
data.frame(chi2 = round(LR, 2), df = 3, p = format.pval(pchisq(LR, 3, lower.tail = FALSE), eps = 1e-4))

# 3. Współczynniki, z, p (rozkład normalny), OR z 95% CI z profilu wiarygodności
wsp <- coef(summary(m1))
z <- wsp[, "Value"] / wsp[, "Std. Error"]
ci <- suppressMessages(confint(m1))             # przedziały profilowe dla nachyleń
tabela <- data.frame(b = wsp[1:3, "Value"], SE = wsp[1:3, "Std. Error"], z = z[1:3],
                     p = 2 * pnorm(-abs(z[1:3])), OR = exp(wsp[1:3, "Value"]),
                     OR_dolna = exp(ci[, 1]), OR_gorna = exp(ci[, 2]))
tabela <- round(tabela, 3); tabela$p <- format.pval(2 * pnorm(-abs(z[1:3])), digits = 3, eps = 1e-4)
print(tabela)
cat("Progi (zeta, skala logitu):\n"); print(round(wsp[4:7, 1:2], 3))
# OR dla wzrostu stresu o 1 SD i odwrotność OR stresu
round(c(OR_stres_1SD = unname(exp(coef(m1)["stres"] * sd(dane$stres))), odwrotnosc_OR_stres = unname(1 / exp(coef(m1)["stres"]))), 2)
Wynik w R
        bardzo zła  zła przeciętna dobra bardzo dobra
n             37.0 75.0       97.0  85.0         26.0
procent       11.6 23.4       30.3  26.6          8.1
   M_stres   SD_stres   Me_ekran         Q1         Q3    sport_n sport_proc
      3.02       0.75      41.00      25.75      65.00     125.00      39.06

sport bardzo zła  zła przeciętna dobra bardzo dobra
    0       13.8 28.2       31.8  21.5          4.6
    1        8.0 16.0       28.0  34.4         13.6
Likelihood ratio tests of ordinal regression models

Response: sen_f
                    Model Resid. df Resid. Dev   Test    Df LR stat. Pr(Chi)
1                       1       316   964.7286
2 stres + ekran30 + sport       313   870.0182 1 vs 2     3 94.71041       0
   chi2 df       p
1 94.71  3 < 1e-04
             b    SE      z        p    OR OR_dolna OR_gorna
stres   -1.200 0.153 -7.816  < 1e-04 0.301    0.222    0.405
ekran30 -0.272 0.089 -3.056 0.002244 0.762    0.639    0.906
sport    0.732 0.218  3.353 0.000801 2.079    1.358    3.198
Progi (zeta, skala logitu):
                    Value Std. Error
bardzo zła|zła     -6.217      0.579
zła|przeciętna     -4.565      0.533
przeciętna|dobra   -3.021      0.499
dobra|bardzo dobra -0.925      0.494
       OR_stres_1SD odwrotnosc_OR_stres
               0.41                3.32
2. Prawdopodobieństwa przewidywane i przeciętny efekt krańcowy
R
# Prawdopodobieństwa przewidywane dla profili i przeciętny efekt sportu (kontynuacja przepisu 1: dane, m1)
options(width = 110)
profile <- data.frame(stres = c(2.3, 3.7, 3.7, 3.7), ekran30 = c(1, 1, 3, 3), sport = c(0, 0, 0, 1),
                      row.names = c("niski stres, 30 min", "wysoki stres, 30 min", "wysoki stres, 90 min",
                                    "wysoki stres, 90 min, sport"))
pr <- predict(m1, newdata = profile, type = "probs")
print(round(cbind(profile, pr), 3))

# 95% przedziały dla P(sen dobry lub bardzo dobry): symulacja z rozkładu oszacowań (2000 losowań)
set.seed(89)
los <- MASS::mvrnorm(2000, mu = c(coef(m1), m1$zeta), Sigma = vcov(m1))
p_dobry <- function(th, nd) {                   # P(Y >= "dobra") = 1 − P(Y <= "przeciętna")
  eta <- as.matrix(nd[, c("stres", "ekran30", "sport")]) %*% th[1:3]
  1 - plogis(th[6] - eta)                       # th[6] = próg 3|4
}
p_hat <- p_dobry(c(coef(m1), m1$zeta), profile)
p_sym <- apply(los, 1, p_dobry, nd = profile)
print(round(data.frame(P_dobry = p_hat, dolna = apply(p_sym, 1, quantile, .025),
                       gorna = apply(p_sym, 1, quantile, .975), row.names = rownames(profile)), 3))

# Przeciętny efekt krańcowy sportu: średnia różnica P(sen dobry lub bardzo dobry) przy sport = 1 i sport = 0
d1 <- transform(dane, sport = 1); d0 <- transform(dane, sport = 0)
ame <- function(th) mean(p_dobry(th, d1) - p_dobry(th, d0))
ame_sym <- apply(los, 1, ame)
round(100 * c(AME_sport = ame(c(coef(m1), m1$zeta)), dolna = unname(quantile(ame_sym, .025)),
              gorna = unname(quantile(ame_sym, .975))), 1)
# Obserwowane i przewidywane (średnie z modelu) odsetki kategorii
round(rbind(obserwowane = 100 * prop.table(table(dane$sen_f)), przewidywane = 100 * colMeans(fitted(m1))), 1)
Wynik w R
                            stres ekran30 sport bardzo zła   zła przeciętna dobra bardzo dobra
niski stres, 30 min           2.3       1     0      0.040 0.138      0.325 0.389        0.109
wysoki stres, 30 min          3.7       1     0      0.181 0.355      0.308 0.134        0.022
wysoki stres, 90 min          3.7       3     0      0.277 0.389      0.237 0.084        0.013
wysoki stres, 90 min, sport   3.7       3     1      0.155 0.334      0.328 0.155        0.027
                            P_dobry dolna gorna
niski stres, 30 min           0.498 0.404 0.588
wysoki stres, 30 min          0.156 0.110 0.213
wysoki stres, 90 min          0.097 0.064 0.146
wysoki stres, 90 min, sport   0.182 0.116 0.270
AME_sport     dolna     gorna
     14.1       5.9      22.4
             bardzo zła  zła przeciętna dobra bardzo dobra
obserwowane        11.6 23.4       30.3  26.6          8.1
przewidywane       11.7 23.3       30.1  26.7          8.2
3. Założenie proporcjonalnych szans: osobne regresje i test Branta
R
# Założenie proporcjonalnych szans: osobne regresje logistyczne dla progów i test Branta (kontynuacja: dane, m1)
# Pakietu brant nie ma w środowisku, więc test liczymy ze wzorów Branta (1990).
options(width = 110)
X <- cbind(1, as.matrix(dane[, c("stres", "ekran30", "sport")]))
J <- 5; K <- J - 1; p <- ncol(X) - 1
fity <- lapply(1:K, function(j) glm(I(dane$sen > j) ~ stres + ekran30 + sport, data = dane, family = binomial))
B <- sapply(fity, coef)                          # kolumny: progi Y > 1, Y > 2, Y > 3, Y > 4
PI <- sapply(fity, fitted)
OR_progi <- exp(B[-1, ]); colnames(OR_progi) <- c(">bardzo zła", ">zła", ">przeciętna", ">dobra")
print(round(cbind(OR_progi, wspolny_OR = exp(coef(m1))), 2))
SE_progi <- sapply(fity, function(f) sqrt(diag(vcov(f)))[-1])

# Macierz kowariancji oszacowań ze wszystkich K regresji (Brant, 1990)
V <- matrix(0, K * (p + 1), K * (p + 1))
for (j in 1:K) for (l in j:K) {
  Wjl <- PI[, l] - PI[, j] * PI[, l]             # dla j <= l: P(Y > l) − P(Y > j) P(Y > l)
  Ajj <- solve(t(X) %*% (X * (PI[, j] * (1 - PI[, j]))))
  All <- solve(t(X) %*% (X * (PI[, l] * (1 - PI[, l]))))
  blok <- Ajj %*% (t(X) %*% (X * Wjl)) %*% All
  ij <- (j - 1) * (p + 1) + 1:(p + 1); il <- (l - 1) * (p + 1) + 1:(p + 1)
  V[ij, il] <- blok; V[il, ij] <- t(blok)
}
bez_stalej <- as.vector(sapply(0:(K - 1), function(j) j * (p + 1) + 2:(p + 1)))
Vb <- V[bez_stalej, bez_stalej]; b <- as.vector(B[-1, ])
brant_test <- function(zm) {                     # zm = numery predyktorów (1..p)
  idx <- as.vector(sapply(0:(K - 1), function(j) j * p + zm))
  bb <- b[idx]; VV <- Vb[idx, idx]; q <- length(zm)
  D <- do.call(rbind, lapply(2:K, function(k) { r <- matrix(0, q, q * K); r[, 1:q] <- diag(q)
    r[, (k - 1) * q + 1:q] <- -diag(q); r }))
  chi <- as.numeric(t(D %*% bb) %*% solve(D %*% VV %*% t(D)) %*% (D %*% bb))
  c(chi2 = chi, df = nrow(D), p = pchisq(chi, nrow(D), lower.tail = FALSE))
}
print(round(rbind(globalnie = brant_test(1:p), stres = brant_test(1), ekran30 = brant_test(2), sport = brant_test(3)), 3))
Wynik w R
        >bardzo zła >zła >przeciętna >dobra wspolny_OR
stres          0.28 0.31        0.31   0.21       0.30
ekran30        0.70 0.82        0.73   0.89       0.76
sport          1.53 1.97        2.27   2.51       2.08
           chi2 df     p
globalnie 5.160  9 0.820
stres     1.245  3 0.742
ekran30   2.994  3 0.393
sport     0.867  3 0.834
4. Pseudo-R² i porównanie z regresją liniową oraz dychotomizacją
R
# Ocena modelu: pseudo-R², porównanie z regresją liniową i z dychotomizacją wyniku (kontynuacja: dane, m0, m1)
options(width = 110)
ll0 <- as.numeric(logLik(m0)); ll1 <- as.numeric(logLik(m1)); n <- nrow(dane)
cox_snell <- 1 - exp(2 * (ll0 - ll1) / n)
round(c(McFadden = 1 - ll1 / ll0, Cox_Snell = cox_snell, Nagelkerke = cox_snell / (1 - exp(2 * ll0 / n))), 3)
c(AIC_m1 = round(AIC(m1), 2), n_parametrow = length(coef(m1)) + length(m1$zeta))

# Dla porównania: regresja liniowa na kodach 1–5 i regresja logistyczna po podziale "dobra lub bardzo dobra"
m_lin <- lm(sen ~ stres + ekran30 + sport, data = dane)
m_bin <- glm(I(sen >= 4) ~ stres + ekran30 + sport, data = dane, family = binomial)
z_ord <- coef(m1) / sqrt(diag(vcov(m1)))[1:3]
z_lin <- coef(summary(m_lin))[-1, "t value"]
z_bin <- coef(summary(m_bin))[-1, "z value"]
print(round(cbind(z_porzadkowa = z_ord, t_liniowa = z_lin, z_po_podziale = z_bin), 2))
round(c(proc_dobra_lub_bardzo_dobra = 100 * mean(dane$sen >= 4)), 1)
# Przewidywania regresji liniowej poza zakresem skali 1–5?
round(range(fitted(m_lin)), 2)
Wynik w R
  McFadden  Cox_Snell Nagelkerke
     0.098      0.256      0.269
      AIC_m1 n_parametrow
      884.02         7.00
        z_porzadkowa t_liniowa z_po_podziale
stres          -7.82     -8.68         -5.83
ekran30        -3.06     -2.94         -2.54
sport           3.35      3.37          3.11
proc_dobra_lub_bardzo_dobra
                       34.7
[1] 1.58 4.41
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
Najczęstsze błędy w regresji porządkowej
- Odwrócony kierunek interpretacji. Programy różnie zapisują model (τ − bX albo τ + bX). Zanim napiszesz, że stres „zwiększa” albo „zmniejsza” szanse, sprawdź na tabeli krzyżowej lub prawdopodobieństwach przewidywanych, czy kierunek się zgadza.
- Kategorie w złej kolejności. Jeśli zmienna w R jest zwykłym czynnikiem, kolejność poziomów bywa alfabetyczna („bardzo dobra”, „bardzo zła”, „dobra”…). Zawsze ustaw poziomy jawnie, tak jak w przepisie 1.
- OR czytany jak zmiana prawdopodobieństwa jednej odpowiedzi. OR dotyczy szans skumulowanych. Dla konkretnych odpowiedzi podaj prawdopodobieństwa przewidywane albo AME.
- Pominięcie założenia proporcjonalnych szans albo ocena go wyłącznie na podstawie p. Pokaż osobne OR dla progów i przemyśl wielkość różnic.
- Łączenie kategorii po obejrzeniu wyników, „żeby wyszło”. Decyzję o łączeniu rzadkich odpowiedzi podejmij przed analizą i opisz ją.
- Dychotomizacja wyniku bez powodu. Tracisz informację i moc (w przykładzie z dla stresu spadło z −7.82 do −5.83).
- Regresja porządkowa na sumie wielu pozycji z kilkudziesięcioma możliwymi wartościami. Model zadziała, ale progów będzie bardzo dużo; przy wyniku skali zwykle wystarcza regresja liniowa, a model porządkowy jest najbardziej naturalny dla pojedynczego pytania.
- Brak informacji o modelu w pracy. Samo „przeprowadzono regresję porządkową” nie wystarcza: podaj funkcję łączącą (logit), kodowanie i kierunek współczynników, sposób liczenia przedziałów i wynik sprawdzenia założenia. Jeśli porównujesz grupy bez predyktorów ciągłych, prostszą alternatywą bywa test Manna–Whitneya – zob. testy nieparametryczne krok po kroku.
Gdy potrzebujesz pełniejszego przeglądu metod, sięgnij po podręcznik Agrestiego (2010), który omawia analizę uporządkowanych danych kategorialnych od metod opisowych po modele regresji, z naciskiem na interpretację wyników.
Najczęstsze pytania
Jak opisać iloraz szans z regresji porządkowej w pracy dyplomowej?
OR = eb mówi, ile razy zmieniają się szanse odpowiedzi wyższej niż dowolny próg wobec odpowiedzi na progu lub niższej, gdy predyktor rośnie o jednostkę. Przykładowo OR = 2.08 dla aktywności fizycznej oznacza około dwukrotnie większe szanse lepszej oceny snu, bez względu na to, czy granicą jest „zła”, czy „dobra” jakość. OR nie mówi wprost, o ile zmieni się prawdopodobieństwo jednej konkretnej odpowiedzi – do tego służą prawdopodobieństwa przewidywane.
Co oznaczają progi (intercepts) w wydruku regresji porządkowej?
Progi τ to punkty na skali logitu, w których model „tnie” ukrytą zmienną ciągłą na obserwowane kategorie; przy k kategoriach jest ich k − 1. Potrzebujesz ich do liczenia prawdopodobieństw przewidywanych i podajesz je w tabeli, ale zwykle nie są przedmiotem hipotez. Muszą rosnąć, a bardzo bliskie progi sygnalizują rzadko wybieraną kategorię.
Jak sprawdzić założenie proporcjonalnych szans w R bez pakietu brant?
Dopasuj osobne regresje logistyczne dla każdego podziału „powyżej progu” wobec reszty i porównaj ich ilorazy szans ze wspólnym OR z MASS::polr(). Formalny test Branta można policzyć ze wzorów w kilkunastu linijkach kodu, tak jak w przepisie 3 tego poradnika. Oceniaj nie tylko p, ale też to, jak bardzo różnią się OR dla progów.
Czy przy skali Likerta lepsza jest regresja porządkowa czy liniowa?
Gdy zmienną zależną jest jedno pytanie z kilkoma odpowiedziami, naturalnym wyborem jest regresja porządkowa, bo nie zakłada równych odstępów między kategoriami i przewiduje rozkład odpowiedzi. Gdy zmienną zależną jest suma lub średnia wielu pozycji, regresja liniowa zwykle wystarcza. Na danych z pojedynczej pozycji model liniowy bywa zgodny z porządkowym, ale może też prowadzić do błędnych wniosków.
Model proporcjonalnych szans nie pasuje – jakiego modelu użyć zamiast niego?
Najpierw oceń, czy różnice między OR dla progów są duże i merytorycznie ważne. Jeśli tak, użyj modelu częściowo proporcjonalnych szans, w którym tylko predyktor naruszający założenie ma osobne współczynniki dla progów, albo modelu sekwencyjnego lub kategorii przyległych. Wielomianowa regresja logistyczna to ostateczność, bo pomija kolejność kategorii.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Masz w pracy pytania z odpowiedziami od „zdecydowanie nie” do „zdecydowanie tak”?
Dobierzemy model do Twojej zmiennej, sprawdzimy założenie proporcjonalnych szans i wyjaśnimy wyniki tak, abyś umiał(a) samodzielnie obronić je przed promotorem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A. (2010). Analysis of ordinal categorical data (2nd ed.). Wiley. https://doi.org/10.1002/9780470594001
- Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171–1178. https://doi.org/10.2307/2532457
- Bürkner, P.-C., & Vuorre, M. (2019). Ordinal regression models in psychology: A tutorial. Advances in Methods and Practices in Psychological Science, 2(1), 77–101. https://doi.org/10.1177/2515245918823199 ● Otwarty dostęp: pełny tekst
- Fullerton, A. S. (2009). A conceptual framework for ordered logistic regression models. Sociological Methods & Research, 38(2), 306–347. https://doi.org/10.1177/0049124109346162
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Peterson, B., & Harrell, F. E., Jr. (1990). Partial proportional odds models for ordinal response variables. Applied Statistics, 39(2), 205–217. https://doi.org/10.2307/2347760
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@book{agresti2010analysis, author={Agresti, Alan}, title={{Analysis of ordinal categorical data (2nd ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470594001}}@article{brant1990assessing, author={Brant, Rollin}, title={{Assessing proportionality in the proportional odds model for ordinal logistic regression}}, journal={Biometrics}, year={1990}, volume={46}, number={4}, pages={1171--1178}, doi={10.2307/2532457}}@article{burkner2019ordinal, author={Bürkner, Paul-Christian and Vuorre, Matti}, title={{Ordinal regression models in psychology: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={77--101}, doi={10.1177/2515245918823199}}@article{fullerton2009conceptual, author={Fullerton, Andrew S.}, title={{A conceptual framework for ordered logistic regression models}}, journal={Sociological Methods \& Research}, year={2009}, volume={38}, number={2}, pages={306--347}, doi={10.1177/0049124109346162}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{mccullagh1980regression, author={McCullagh, Peter}, title={{Regression models for ordinal data}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1980}, volume={42}, number={2}, pages={109--127}, doi={10.1111/j.2517-6161.1980.tb01109.x}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{peterson1990partial, author={Peterson, Bercedis and Harrell, Jr., Frank E.}, title={{Partial proportional odds models for ordinal response variables}}, journal={Applied Statistics}, year={1990}, volume={39}, number={2}, pages={205--217}, doi={10.2307/2347760}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}