Co to jest iloraz szans?
Iloraz szans (ang. odds ratio, OR) to miara związku między dwiema zmiennymi dychotomicznymi, najczęściej między czynnikiem (ekspozycją) a wynikiem. Porównuje szanse wystąpienia wyniku w grupie z czynnikiem i w grupie bez niego (Szumilas, 2010). OR = 1 oznacza brak związku, OR > 1 – wyższe szanse wyniku w grupie z czynnikiem, a OR < 1 – niższe.
W psychologii iloraz szans pojawia się przy analizie tabel krzyżowych 2 × 2 (np. terapia a remisja objawów), w regresji logistycznej i w metaanalizach. Bland i Altman (2000) wyjaśniają jego popularność trzema zaletami: opisuje związek dwóch zmiennych dychotomicznych wraz z przedziałem ufności, pozwala uwzględniać inne zmienne w regresji logistycznej i ma wygodną interpretację w badaniach kliniczno-kontrolnych.
Szansa a prawdopodobieństwo
Szansa (ang. odds) to stosunek prawdopodobieństwa zajścia zdarzenia do prawdopodobieństwa jego niezajścia (Bland i Altman, 2000):
gdzie π to prawdopodobieństwo (odsetek) zdarzenia. Prawdopodobieństwo mieści się między 0 a 1, a szansa – między 0 a nieskończonością. „Szansa 0.25” to więc nie to samo co „prawdopodobieństwo 25%”:
| Prawdopodobieństwo | Szansa | Zapis „jak u bukmachera” |
|---|---|---|
| 10% | 0.11 | 1 : 9 |
| 20% | 0.25 | 1 : 4 |
| 25% | 0.33 | 1 : 3 |
| 50% | 1.00 | 1 : 1 |
| 75% | 3.00 | 3 : 1 |
| 90% | 9.00 | 9 : 1 |
Przy rzadkich zdarzeniach szansa i prawdopodobieństwo są prawie równe (10% i 0.11), przy częstych – rozjeżdżają się (75% i 3.00). Ta prosta obserwacja tłumaczy, dlaczego iloraz szans i ryzyko względne dają czasem bardzo różne liczby.
Wzór na iloraz szans i przedział ufności
W tabeli 2 × 2 oznaczmy liczebności literami: a i b – osoby z czynnikiem z wynikiem i bez wyniku, c i d – osoby bez czynnika z wynikiem i bez wyniku. Wtedy:
Rozkład OR jest prawoskośny (od 0 do nieskończoności, z wartością neutralną 1), dlatego przedział ufności liczy się na skali logarytmicznej i dopiero potem przelicza z powrotem:
Przedział jest więc niesymetryczny wokół OR. Jeśli nie obejmuje 1, związek jest istotny na poziomie α = .05. Szumilas (2010) podkreśla, że o istotności świadczą przedział ufności i wartość p, a nie sama wielkość OR. Gdy któraś komórka ma liczebność 0, wzór nie działa – zwykle dodaje się wtedy 0.5 do każdej komórki.
Przykład: praca zarobkowa a wypalenie akademickie
W badaniu 300 studentów (dane symulowane) 120 osób pracowało zarobkowo ponad 20 godzin tygodniowo, a 180 nie pracowało. Wysoki poziom wypalenia akademickiego stwierdzono u 53 osób pracujących (44.2%) i u 44 niepracujących (24.4%):
| Praca > 20 h tygodniowo | Wypalenie: tak | Wypalenie: nie | Razem | Szansa wypalenia |
|---|---|---|---|---|
| Tak | a = 53 | b = 67 | 120 | 53 / 67 = 0.79 |
| Nie | c = 44 | d = 136 | 180 | 44 / 136 = 0.32 |
Przedział ufności: ln(2.45) = 0.894, SE = √(1/53 + 1/67 + 1/44 + 1/136) = 0.253, więc 95% CI = exp(0.894 ± 1.96 × 0.253) = [1.49, 4.01]. Przedział nie obejmuje 1 (z = 0.894 / 0.253 = 3.54, p < .001); ten sam wniosek daje test chi-kwadrat, χ²(1, N = 300) = 12.80, p < .001. Szanse wysokiego wypalenia były u pracujących 2.45 raza większe niż u niepracujących.
Kierunek OR zależy od kodowania. Gdyby grupą odniesienia byli pracujący, OR = 1 / 2.45 = 0.41 – to ten sam związek opisany „od drugiej strony”. Dlatego zawsze napisz, która grupa jest grupą odniesienia (zob. dummy coding).
Iloraz szans a ryzyko względne
Ryzyko względne (ang. relative risk, RR) to iloraz prawdopodobieństw, a nie szans: RR = 44.2% / 24.4% = 1.81, 95% CI [1.30, 2.50]. Prawdopodobieństwo wypalenia było więc u pracujących 1.81 raza większe, a szansa – 2.45 raza. Obie miary łączy wzór:
gdzie π0 i π1 to ryzyko w grupie odniesienia i w grupie z czynnikiem. Gdy wynik jest rzadki, oba nawiasy są bliskie 1 i OR ≈ RR. Davies, Crombie i Tavakoli (1998) pokazują, że iloraz szans interpretowany jak ryzyko względne zawsze zawyża wielkość efektu, a rozbieżność rośnie wraz z częstością wyniku – OR dobrze przybliża RR tylko przy rzadkim wyniku. Rysunek 1 pokazuje to na obliczonych krzywych.
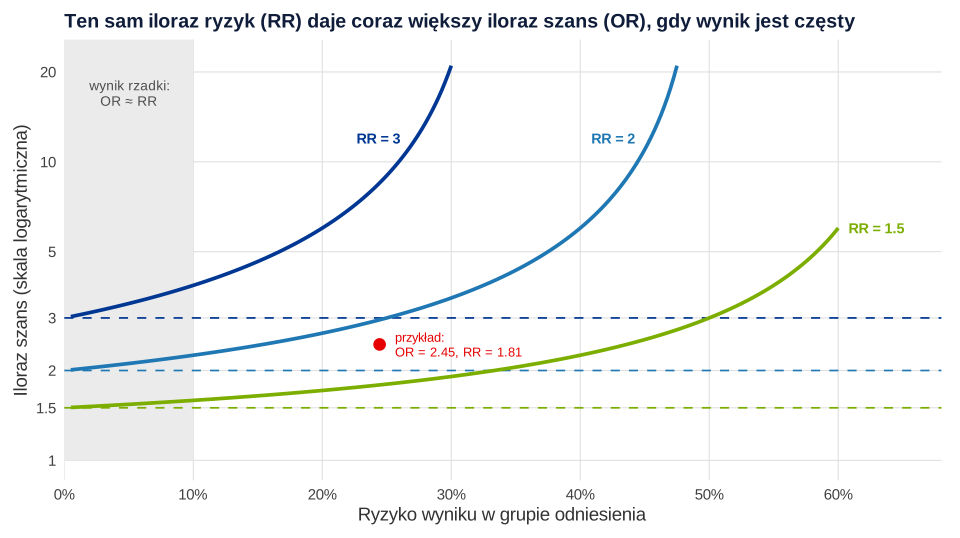
Przy RR = 2 iloraz szans wynosi 2.02, gdy wynik ma 1% osób w grupie odniesienia, ale 2.67 przy 20%, 3.50 przy 30% i 6.00 przy 40%. W badaniach psychologicznych wynik bywa częsty (np. przekroczenie progu objawów w próbie studenckiej), a wtedy różnica ma praktyczne znaczenie. W badaniach kliniczno-kontrolnych, w których dobiera się osoby według wyniku, ryzyka nie da się w ogóle policzyć – iloraz szans tak.
Jak duży jest „duży” OR? Iloraz szans jest miarą wielkości efektu, ale nie ma jednej skali interpretacji. Chen, Cohen i Chen (2010) obliczyli, że przy częstości choroby 1% w grupie nieeksponowanej OR = 1.68, 3.47 i 6.71 odpowiadają d Cohena równemu 0.2, 0.5 i 0.8. Te progi zależą jednak od częstości wyniku, więc traktuj je orientacyjnie i interpretuj OR w kontekście ryzyka bazowego.
Iloraz szans w regresji logistycznej
Regresja logistyczna modeluje logarytm szansy wyniku, więc jej współczynnik b to zmiana logarytmu szansy, a exp(b) – iloraz szans. Model z jednym predyktorem „praca” daje dokładnie ten sam wynik co tabela: exp(b) = 2.45, 95% CI [1.49, 4.01]. Wyraz wolny po przekształceniu, exp(b0) = 0.32, to szansa wypalenia w grupie odniesienia.
Przewaga regresji polega na tym, że można uwzględnić inne zmienne (Bland i Altman, 2000). Pracujący spali przeciętnie krócej (6.27 wobec 6.91 godziny na dobę), a sen wiązał się z wypaleniem. Po dodaniu liczby godzin snu do modelu iloraz szans dla pracy zmalał do 2.02, 95% CI [1.20, 3.40], p = .008. To skorygowany iloraz szans (ang. adjusted OR). Dla snu OR = 0.72, 95% CI [0.54, 0.94]: każda dodatkowa godzina snu wiązała się z szansą wypalenia mniejszą o około 28% (1 − 0.72). Przy predyktorach ilościowych OR zależy od jednostki – na godzinę, punkt skali lub odchylenie standardowe – więc zawsze ją podaj. Więcej o modelu w poradniku regresja logistyczna: założenia i interpretacja.
Jak opisać wynik w pracy (APA)
Podaj odsetki w obu grupach, iloraz szans z 95% przedziałem ufności (OR zapisuje się z zerem przed kropką, bo może przekraczać 1) i informację, która grupa jest grupą odniesienia. Przykładowy opis:
Wyniki modelu z kilkoma predyktorami przedstaw w tabeli – wzór znajdziesz w haśle tabela regresji logistycznej w APA, a więcej gotowych zdań w poradniku jak opisać wyniki w stylu APA.
Iloraz szans w R
Kod tworzy dane z przykładu, liczy szanse w grupach, iloraz szans z 95% przedziałem ufności, ryzyko względne oraz OR z regresji logistycznej – bez i z korektą o liczbę godzin snu. W SPSS iloraz szans i ryzyko względne z przedziałami ufności poda okno Analiza → Opis statystyczny → Tabele krzyżowe → Statystyki → Ryzyko, a w regresji logistycznej (Analiza → Regresja → Logistyczna) zaznacz w Opcjach przedział ufności dla Exp(B).
OR z tabeli 2 × 2 i z regresji logistycznej
R
set.seed(13)
praca <- rep(c(1, 0), c(120, 180))                          # 1 = praca > 20 h tygodniowo
sen <- round(rnorm(300, ifelse(praca == 1, 6.3, 7.0), 0.9), 1)    # godziny snu na dobę
wypalenie <- rbinom(300, 1, plogis(qlogis(.25) + log(1.8) * praca - 0.5 * (sen - 7)))
tab <- table(praca = factor(praca, 1:0, c("tak", "nie")),
             wypalenie = factor(wypalenie, 1:0, c("tak", "nie")))
tab
szanse <- tab[, "tak"] / tab[, "nie"]                       # szanse wypalenia w grupach
round(szanse, 3)
OR <- unname(szanse[1] / szanse[2])
se <- sqrt(sum(1 / tab))                                    # SE logarytmu OR
round(c(OR = OR, dolna = exp(log(OR) - 1.96 * se), gorna = exp(log(OR) + 1.96 * se)), 2)
ryzyko <- tab[, "tak"] / rowSums(tab)
round(unname(ryzyko[1] / ryzyko[2]), 2)                     # ryzyko względne (RR)
m1 <- glm(wypalenie ~ praca, family = binomial)
round(exp(cbind(OR = coef(m1), confint.default(m1))), 2)    # OR = exp(b) z 95% CI
m2 <- glm(wypalenie ~ praca + sen, family = binomial)
round(exp(cbind(OR = coef(m2), confint(m2))), 2)            # OR skorygowany o sen
Wynik w R
     wypalenie
praca tak nie
  tak  53  67
  nie  44 136
  tak   nie
0.791 0.324
   OR dolna gorna
 2.45  1.49  4.01
[1] 1.81
              OR 2.5 % 97.5 %
(Intercept) 0.32  0.23   0.45
praca       2.45  1.49   4.01
Waiting for profiling to be done...
              OR 2.5 % 97.5 %
(Intercept) 3.19  0.49  21.45
praca       2.02  1.20   3.40
sen         0.72  0.54   0.94
Przedział z confint.default() (metoda Walda) jest identyczny z przedziałem ze wzoru na skali logarytmicznej. Funkcja confint() liczy przedział z profilu wiarygodności, a fisher.test(tab) podaje warunkowy estymator OR (tu 2.44), dlatego wyniki mogą się nieznacznie różnić.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „OR = 2.45, czyli wynik jest 2.45 raza bardziej prawdopodobny”. To zdanie opisuje ryzyko względne, które tu wynosi 1.81. Przy częstym wyniku OR zawyża efekt (Davies i in., 1998).
- Brak informacji o grupie odniesienia – bez niej nie wiadomo, czy OR = 2.45 i OR = 0.41 to różne wyniki, czy ten sam.
- Symetryczny przedział „OR ± 1.96 × SE” zamiast przedziału liczonego na skali logarytmicznej.
- Ocena istotności po samej wartości OR – nawet OR = 3 może być nieistotny przy małej próbie; patrz na przedział ufności (Szumilas, 2010).
- Porównywanie OR dla predyktorów w różnych jednostkach (godzina snu a punkt w kwestionariuszu) bez standaryzacji.
- Skorygowany OR jako dowód przyczynowości. Korekta o wybrane zmienne nie usuwa wpływu zmiennych zakłócających, których nie zmierzono.
Najczęstsze pytania
Co to jest iloraz szans?
Iloraz szans (OR) to stosunek szans wystąpienia wyniku w grupie z czynnikiem do szans w grupie bez czynnika. Szansa to prawdopodobieństwo zdarzenia podzielone przez prawdopodobieństwo jego niezajścia, np. 20% / 80% = 0.25. OR = 1 oznacza brak związku, OR > 1 – wyższe szanse w grupie z czynnikiem, a OR < 1 – niższe.
Jak interpretować iloraz szans?
OR = 2.45 oznacza, że szanse wyniku są w danej grupie 2.45 raza większe niż w grupie odniesienia. Nie oznacza, że wynik jest 2.45 raza bardziej prawdopodobny – to opisuje ryzyko względne. OR = 0.41 oznacza szanse mniejsze o 59%. Zawsze podaj grupę odniesienia i 95% przedział ufności.
Czym różni się iloraz szans od ryzyka względnego?
Ryzyko względne (RR) to iloraz prawdopodobieństw, a iloraz szans – iloraz szans. Przy rzadkim wyniku obie miary są prawie równe, ale przy częstym OR jest wyraźnie dalej od 1 niż RR. W przykładzie z tego hasła ryzyko wynosiło 44.2% wobec 24.4%: RR = 1.81, a OR = 2.45.
Jak obliczyć przedział ufności dla ilorazu szans?
Policz ln(OR) i błąd standardowy SE = √(1/a + 1/b + 1/c + 1/d), a następnie granice exp(ln OR ± 1.96 × SE). Dla OR = 2.45 i SE = 0.253 daje to 95% CI [1.49, 4.01]. Przedział jest niesymetryczny wokół OR; jeśli nie obejmuje 1, związek jest istotny na poziomie α = .05.
Jak interpretować iloraz szans w regresji logistycznej?
W regresji logistycznej exp(b) to iloraz szans dla wzrostu predyktora o jedną jednostkę przy stałych pozostałych zmiennych. Na przykład OR = 0.72 dla godzin snu oznacza, że każda dodatkowa godzina snu wiąże się z szansą wyniku mniejszą o około 28%. Dla predyktora dychotomicznego OR porównuje kategorię 1 z kategorią odniesienia.
Kiedy iloraz szans jest istotny statystycznie?
Gdy jego 95% przedział ufności nie obejmuje 1, co odpowiada p < .05 w teście Walda. Sama wartość OR nie rozstrzyga o istotności: przy małej próbie nawet duży iloraz szans może mieć szeroki przedział ufności obejmujący 1.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikWielkość efektu: jak ocenić znaczenie wyniku poza wartością p
Wielkość efektu wyjaśniona praktycznie: Cohen d, Hedges g, r, R², iloraz szans, eta², przedziały ufności i znaczenie praktyczne.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Chen, H., Cohen, P., & Chen, S. (2010). How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies. Communications in Statistics—Simulation and Computation, 39(4), 860–864. https://doi.org/10.1080/03610911003650383
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Szumilas, M. (2010). Explaining odds ratios. Journal of the Canadian Academy of Child and Adolescent Psychiatry, 19(3), 227–229. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/ ● Otwarty dostęp
Cytowania BibTeX
@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{chen2010how, author={Chen, Henian and Cohen, Patricia and Chen, Sophie}, title={{How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies}}, journal={Communications in Statistics—Simulation and Computation}, year={2010}, volume={39}, number={4}, pages={860--864}, doi={10.1080/03610911003650383}}@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{szumilas2010explaining, author={Szumilas, Magdalena}, title={{Explaining odds ratios}}, journal={Journal of the Canadian Academy of Child and Adolescent Psychiatry}, year={2010}, volume={19}, number={3}, pages={227--229}, url={https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/}}