Kim byli Nathan Mantel i William Haenszel?
Nathan Mantel (1919–2002) urodził się 16 lutego 1919 r. w Nowym Jorku. Licencjat ze statystyki uzyskał w 1939 r. w City College of New York, a magisterium – dopiero w 1956 r. w American University (Gail, 1997). W latach 1942–1946 służył w armii USA (Wynn i in., 2016). Od 1947 do 1974 r. pracował w National Institutes of Health, przez cały ten czas jako statystyk matematyczny w National Cancer Institute (NCI). Potem uczył w George Washington University i American University (Gail, 1997). Zmarł w 2002 r. (Mannocci, 2009).
William M. Haenszel (1910–1998) urodził się 19 czerwca 1910 r. w Rochester w stanie Nowy Jork. Licencjat (1931) i magisterium (1932) zdobył w University of Buffalo. W latach 1952–1976 kierował w NCI sekcją biometrii, a następnie całym działem biometrii (Biometry Branch). Później był profesorem epidemiologii University of Illinois i konsultantem Światowej Organizacji Zdrowia (Hankey, 1997). Był socjologiem, matematykiem i statystykiem (Mannocci, 2009). Zmarł w 1998 r. (Mannocci, 2009).
Najważniejsze pomysły
- Procedura Mantela–Haenszela (1959). W „Journal of the National Cancer Institute” Mantel i Haenszel (1959) opisali analizę badań retrospektywnych, czyli badań kliniczno-kontrolnych. Dane dzieli się na warstwy według czynników, które trzeba kontrolować. Test chi-kwadrat sprawdza związek narażenia z chorobą łącznie we wszystkich warstwach. Zbiorczy iloraz szans uśrednia wyniki z warstw. Dziś to test Cochrana–Mantela–Haenszela i wspólny OR Mantela–Haenszela.
- Rozszerzenia. W 1963 r. Mantel uogólnił procedurę na inne testy chi-kwadrat z jednym stopniem swobody, a w 1966 r. zastosował ją do danych o przeżyciu (Mantel, 1981). Ta sama idea – osobna tabela 2 × 2 w każdej chwili zdarzenia – stoi za testem log-rank.
- Test Mantela (1967). W „Cancer Research” Mantel zaproponował sposób wykrywania skupień zachorowań w czasie i przestrzeni. Statystykę tworzy się z dwóch macierzy różnic między przypadkami (w przestrzeni i w czasie); przykładem była białaczka. Dziś test Mantela porównuje dowolne dwie macierze odległości, także w ekologii i genetyce populacji (Wynn i in., 2016).
- Epidemiologia raka. Haenszel w NCI zajmował się m.in. interpretacją badań kliniczno-kontrolnych nad paleniem tytoniu i rakiem płuca. Właśnie z tymi danymi zwrócił się o pomoc do Mantela (Mannocci, 2009).
Ciekawostka
Metoda nosi nazwę „Mantela–Haenszela”, choć według samego Mantela pomysł był Haenszela. W komentarzu z 1981 r. do serii „Citation Classic” Mantel wspomina, że artykuł był pomysłem drugiego z autorów, czyli Haenszela (Mantel, 1981). Haenszel znał z praktyki badania retrospektywne, Mantel – głównie statystykę badań laboratoryjnych. Haenszel poprosił go, żeby dołożył pojęcia statystyczne, jakie uzna za stosowne. Artykuł połączył praktyczne pomysły Haenszela z ideami Mantela. Haenszel – jak pisze Mantel, z hojności – zaproponował odwrócenie kolejności autorów.
W tym samym tekście Mantel z humorem wylicza powody, dla których praca była cytowana – według indeksu SCI ponad 815 razy od 1961 r. Obok testu, miary ryzyka i analizy warstwowej wymienia też cytowanie bez żadnego powodu, który potrafiłby dostrzec (Mantel, 1981).
Przykład na danych z pakietu R
Zbiór infert z pakietu datasets to według pliku pomocy dobrane w zestawy badanie kliniczno-kontrolne o niepłodności po poronieniach, pochodzące – jak zaznacza plik pomocy – sprzed czasów warunkowej regresji logistycznej; źródłem jest praca Trichopoulosa i współpracowników z 1976 r. Obejmuje 248 kobiet: 83 przypadki i ich kontrole w 83 zestawach (82 zestawy trzyosobowe, jeden dwuosobowy). Narażeniem jest co najmniej jedno wcześniejsze poronienie samoistne.
W tabeli łącznej narażonych było 55 z 83 przypadków i 52 ze 165 kontroli, co daje surowy OR = 4.27, 95% CI [2.44, 7.48]. Takie porównanie ignoruje jednak dobór w zestawy, więc każdy zestaw traktujemy jako osobną tabelę 2 × 2. W żadnym z 83 zestawów nie da się policzyć skończonego, dodatniego OR, bo każda tabela ma zero w którejś komórce. Mimo to wzór Mantela–Haenszela działa. Licznik Σad/n wynosi 25, mianownik Σbc/n wynosi 6, więc ORMH = 25/6 = 4.17, 95% CI [2.25, 7.73]. Test liczony ręcznie zestawia 55 narażonych przypadków z 36 oczekiwanymi przy braku związku. Wariancja z rozkładu hipergeometrycznego wynosi 12.22, co daje χ²(1) = 29.54, p < .001 – tyle samo co mantelhaen.test() bez poprawki na ciągłość. Warunkowa regresja logistyczna z tymi samymi zestawami daje OR = 5.23 [2.72, 10.06].
Na rysunku
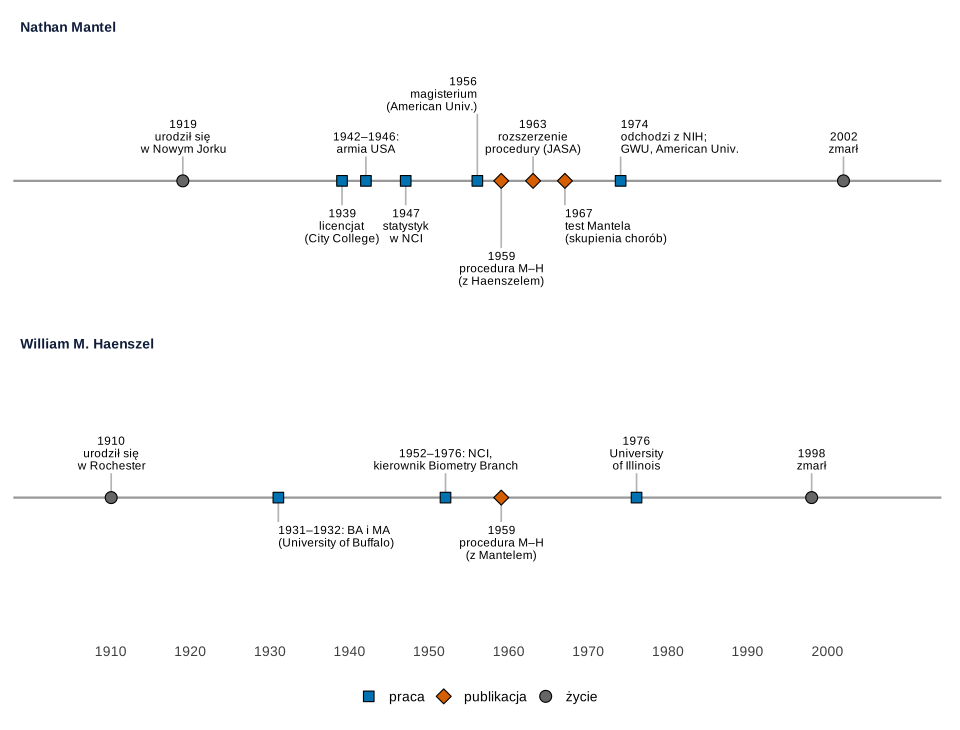
Co widać. Obaj trafili do biometrii NCI po wojnie; najważniejsze prace Mantela powstały w ciągu ośmiu lat po artykule z 1959 r.
Na co uważać. Dla Haenszela źródło podaje tylko okres 1952–1976 w NIH, bez dat kolejnych stanowisk.
Podpis do pracy:
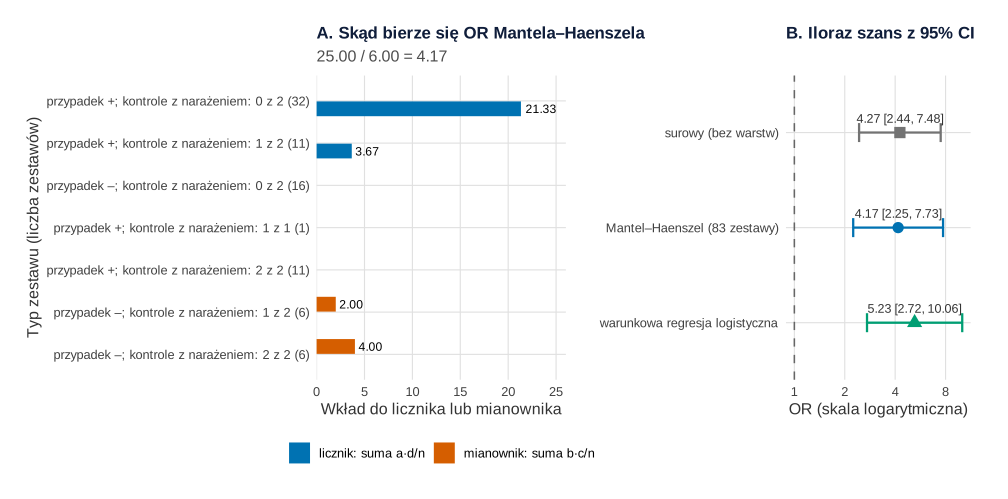
datasets::infert, narażenie – co najmniej jedno poronienie samoistne. Obliczenia i rysunek: R, pakiety survival, ggplot2 i patchwork (bez losowania).Co widać. Wspólny OR to iloraz dwóch sum, a każdy zestaw dokłada do nich małą cząstkę. Licznik tworzą zestawy, w których przypadek był narażony, a któraś kontrola nie; mianownik – zestawy odwrotne. Zestawy zgodne (wszyscy narażeni albo nikt) nic nie wnoszą: to 28 z 83 zestawów. W panelu B wspólny OR Mantela–Haenszela leży blisko surowego, a warunkowa regresja logistyczna daje wyższą wartość z szerszym przedziałem.
Na co uważać. Bliskość OR surowego i Mantela–Haenszela to tu przypadek – w innych danych warstwy mogą odwrócić wynik, jak w paradoksie Simpsona. Mantel–Haenszel i warunkowa regresja logistyczna inaczej ważą zestawy, więc wyniki nie muszą się zgadzać. Przedział Mantela–Haenszela pochodzi z estymatora wariancji Robinsa, Breslowa i Greenlanda, którego używa mantelhaen.test().
Podpis do pracy:
Gdzie spotkasz Mantela i Haenszela w swojej pracy
Wszędzie tam, gdzie związek dwóch zmiennych dwuwartościowych trzeba ocenić w podgrupach.:
- w tabelach krzyżowych z warstwami, np. według ośrodka lub grupy wieku. Przed połączeniem warstw sprawdź, czy OR są podobne, np. testem Breslowa–Daya; po co w ogóle warstwować, wyjaśnia hasło o zmiennej zakłócającej;
- w psychometrii, przy badaniu stronniczości pozycji testu: DIF metodą Mantela–Haenszela, w której warstwami są poziomy wyniku ogólnego (zob. DIF krok po kroku);
- w metaanalizie wyników dwuwartościowych, gdzie warstwami są badania;
Spory, mity i trudne strony
- Czyja to metoda? Mantel (1981) sam przyznaje, że rozwinęli wcześniejsze pomysły Jerome’a Cornfielda. Cornfield ilustrował swoje pomysły na jednej warstwie, choć pisał też o przypadku wielu warstw; Mantel i Haenszel opracowali ten drugi przypadek dokładniej i bardziej formalnie. Nazwę „test Cochrana–Mantela–Haenszela” wyjaśnia hasło o Williamie Cochranie. Od czyjej pracy zaczyna się artykuł z 1959 r., opisuje hasło o Janet Lane-Claypon.
- „Test Mantela” to nie test Mantela–Haenszela. Pierwszy porównuje macierze odległości, drugi łączy tabele 2 × 2.
- Krytyka. Mantel (1981) odnotował, że wśród cytowań pracy z 1959 r. krytyczne wcale nie są rzadkie. Test Mantela z 1967 r. krytykuje się za małą moc i zawyżony błąd I rodzaju, gdy dane łamią jego założenia (Wynn i in., 2016).
Iloraz szans Mantela–Haenszela w R
Kod wczytuje dane infert, liczy surowy OR, rozpisuje 83 zestawy na tabele 2 × 2, liczy ręcznie estymator i test Mantela–Haenszela, porównuje je z mantelhaen.test() i warunkową regresją logistyczną i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Estymator i test Mantela–Haenszela ręcznie: rysunek 2
Kod R rysunku 2
# Mantel i Haenszel: wspólny iloraz szans z 83 małych warstw, liczony ręcznie (datasets::infert)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(survival)})
kol <- c(licznik = "#0072B2", mianownik = "#D55E00", surowy = "grey45", mh = "#0072B2", clogit = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(infert, package = "datasets")
# case – przypadek (1) lub kontrola (0); spontaneous – liczba wcześniejszych poronień samoistnych (0, 1, 2 i więcej);
# stratum – numer zestawu dopasowanego (1–83); narażenie: co najmniej jedno poronienie samoistne
infert$poronienie <- as.integer(infert$spontaneous > 0)
c(osoby = nrow(infert), przypadki = sum(infert$case), zestawy = length(unique(infert$stratum)))
table(liczba_osob_w_zestawie = table(infert$stratum))

# 1. Tabela łączna bez warstw i surowy OR
tab <- with(infert, table(przypadek = factor(case, 1:0), poronienie = factor(poronienie, 1:0)))
tab
OR_surowy <- (tab[1, 1] * tab[2, 2]) / (tab[1, 2] * tab[2, 1])

# 2. Każdy zestaw to osobna tabela 2 × 2: a, b – przypadek z narażeniem / bez; c, d – kontrole z narażeniem / bez
w <- with(infert, table(factor(case, 1:0), factor(poronienie, 1:0), stratum))
a <- w[1, 1, ]; b <- w[1, 2, ]; c <- w[2, 1, ]; d <- w[2, 2, ]; n <- a + b + c + d
c(zestawy_z_OR_skonczonym_i_dodatnim = sum(a * d > 0 & b * c > 0),
  zestawy_bez_wkladu = sum(a * d == 0 & b * c == 0))

# 3. Estymator Mantela–Haenszela ręcznie: suma(a·d/n) / suma(b·c/n)
R <- a * d / n; S <- b * c / n
OR_MH <- sum(R) / sum(S)
round(c(suma_R = sum(R), suma_S = sum(S), OR_MH = OR_MH, OR_surowy = OR_surowy), 3)

# 4. Test Mantela–Haenszela ręcznie: obserwowane a minus oczekiwane, wariancja z rozkładu hipergeometrycznego
E <- (a + b) * (a + c) / n
V <- (a + b) * (c + d) * (a + c) * (b + d) / (n^2 * (n - 1))
chi2_MH <- (sum(a) - sum(E))^2 / sum(V)
round(c(suma_a = sum(a), suma_E = sum(E), suma_V = sum(V), chi2_MH = chi2_MH), 4)
c(p = signif(pchisq(chi2_MH, df = 1, lower.tail = FALSE), 3))

# 5. To samo funkcją mantelhaen.test() (bez poprawki na ciągłość) i warunkowa regresja logistyczna
mh <- mantelhaen.test(w, correct = FALSE)
round(c(chi2 = unname(mh$statistic), OR_MH = unname(mh$estimate), dolna = mh$conf.int[1], gorna = mh$conf.int[2]), 4)
c(p = signif(mh$p.value, 3))
cl <- clogit(case ~ poronienie + strata(stratum), data = infert)
round(c(OR_warunkowy = exp(unname(coef(cl))), dolna = exp(confint(cl))[1], gorna = exp(confint(cl))[2]), 3)
se_s <- sqrt(sum(1 / tab)); ci_s <- exp(log(OR_surowy) + c(-1, 1) * qnorm(0.975) * se_s)   # przedział Woolfa
round(c(OR_surowy = OR_surowy, dolna = ci_s[1], gorna = ci_s[2]), 3)

# 6. Wkład typów zestawów do licznika i mianownika (wzór narażenia: przypadek / liczba kontroli z narażeniem)
typ <- sprintf("przypadek %s; kontrole z narażeniem: %d z %d", ifelse(a == 1, "+", "–"), c, c + d)
wklad <- aggregate(cbind(zestawy = 1, R = R, S = S) ~ typ, data = data.frame(typ, R, S), FUN = sum)
wklad[, c("R", "S")] <- round(wklad[, c("R", "S")], 2)
wklad[order(-wklad$R, wklad$S), ]

# Rysunek: A – wkład zestawów do licznika i mianownika; B – trzy oszacowania OR z 95% CI
wklad$typ <- sprintf("%s (%d)", wklad$typ, wklad$zestawy)                   # w nawiasie: liczba zestawów
wklad$typ <- factor(wklad$typ, levels = rev(wklad$typ[order(-wklad$R, wklad$S)]))
wdl <- rbind(data.frame(typ = wklad$typ, wartosc = wklad$R, czesc = "licznik: suma a·d/n"),
             data.frame(typ = wklad$typ, wartosc = wklad$S, czesc = "mianownik: suma b·c/n"))
pA <- ggplot(wdl, aes(wartosc, typ, fill = czesc)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = ifelse(wartosc > 0, sprintf("%.2f", wartosc), "")), position = position_dodge(width = 0.75),
            hjust = -0.15, size = 3.2) +
  scale_fill_manual(values = c(kol[["licznik"]], kol[["mianownik"]]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.22))) +
  labs(title = "A. Skąd bierze się OR Mantela–Haenszela",
       subtitle = sprintf("%.2f / %.2f = %.2f", sum(R), sum(S), OR_MH),
       x = "Wkład do licznika lub mianownika", y = "Typ zestawu (liczba zestawów)") +
  motyw
est <- data.frame(metoda = c("surowy (bez warstw)", "Mantel–Haenszel (83 zestawy)", "warunkowa regresja logistyczna"),
                  OR = c(OR_surowy, unname(mh$estimate), exp(unname(coef(cl)))),
                  dolna = c(ci_s[1], mh$conf.int[1], exp(confint(cl))[1]),
                  gorna = c(ci_s[2], mh$conf.int[2], exp(confint(cl))[2]))
est$metoda <- factor(est$metoda, levels = rev(est$metoda))
pB <- ggplot(est, aes(OR, metoda, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 1, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.8, orientation = "y") +
  geom_point(size = 3.6) +
  geom_text(aes(label = sprintf("%.2f [%.2f, %.2f]", OR, dolna, gorna)), vjust = -1.1, size = 3.3, colour = "grey20") +
  scale_x_log10(breaks = c(1, 2, 4, 8, 16)) +
  scale_colour_manual(values = c(kol[["clogit"]], kol[["mh"]], kol[["surowy"]]), guide = "none") +
  scale_shape_manual(values = c(17, 16, 15), guide = "none") +
  labs(title = "B. Iloraz szans z 95% CI", x = "OR (skala logarytmiczna)", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.35, 1))
p2
Wynik w R
    osoby przypadki   zestawy
      248        83        83
liczba_osob_w_zestawie
 2  3
 1 82
         poronienie
przypadek   1   0
        1  55  28
        0  52 113
zestawy_z_OR_skonczonym_i_dodatnim                 zestawy_bez_wkladu
                                 0                                 28
   suma_R    suma_S     OR_MH OR_surowy
   25.000     6.000     4.167     4.269
 suma_a  suma_E  suma_V chi2_MH
55.0000 36.0000 12.2222 29.5364
       p
5.49e-08
   chi2   OR_MH   dolna   gorna
29.5364  4.1667  2.2461  7.7294
       p
5.49e-08
OR_warunkowy        dolna        gorna
       5.227        2.716       10.061
OR_surowy     dolna     gorna
    4.269     2.435     7.482
                                        typ zestawy     R S
4 przypadek +; kontrole z narażeniem: 0 z 2      32 21.33 0
6 przypadek +; kontrole z narażeniem: 1 z 2      11  3.67 0
1 przypadek –; kontrole z narażeniem: 0 z 2      16  0.00 0
5 przypadek +; kontrole z narażeniem: 1 z 1       1  0.00 0
7 przypadek +; kontrole z narażeniem: 2 z 2      11  0.00 0
2 przypadek –; kontrole z narażeniem: 1 z 2       6  0.00 2
3 przypadek –; kontrole z narażeniem: 2 z 2       6  0.00 4
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Nathan Mantel (1919–2002) i William M. Haenszel (1910–1998) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1919, 1939, 1942, 1947, 1956, 1959, 1963, 1967, 1974, 2002,
          1910, 1931, 1952, 1959, 1976, 1998),
  osoba = c(rep("Nathan Mantel", 10), rep("William M. Haenszel", 6)),
  opis = c("urodził się\nw Nowym Jorku", "licencjat\n(City College)", "1942–1946:\narmia USA", "statystyk\nw NCI",
           "magisterium\n(American Univ.)", "procedura M–H\n(z Haenszelem)", "rozszerzenie\nprocedury (JASA)",
           "test Mantela\n(skupienia chorób)", "odchodzi z NIH;\nGWU, American Univ.", "zmarł",
           "urodził się\nw Rochester", "1931–1932: BA i MA\n(University of Buffalo)", "1952–1976: NCI,\nkierownik Biometry Branch",
           "procedura M–H\n(z Mantelem)", "University\nof Illinois", "zmarł"),
  rodzaj = c("życie", "praca", "praca", "praca", "praca", "publikacja", "publikacja", "publikacja", "praca", "życie",
             "życie", "praca", "praca", "publikacja", "praca", "życie"),
  poziom = c(0.4, -0.4, 0.4, -0.4, 1.1, -1.1, 0.4, -0.4, 0.4, 0.4,
             0.4, -0.4, 0.4, -0.4, 0.4, 0.4),     # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 1, 0.5, 0.5, 0, 0, 0.5,
                 0.5, 0, 0.5, 0.5, 0.5, 0.5))     # rozsunięcie bliskich etykiet
dwuletnie <- grepl("^19[0-9]{2}–", zdarzenia$opis)
zdarzenia$etykieta <- ifelse(dwuletnie, zdarzenia$opis, paste0(zdarzenia$rok, "\n", zdarzenia$opis))
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Nathan Mantel", "William M. Haenszel"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1903, 2009), breaks = seq(1910, 2000, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test i wspólny OR – mantelhaen.test() z pakietu stats; warunkowa regresja logistyczna – clogit() z pakietu survival; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Nathan Mantel i William Haenszel?
Statystykami z National Cancer Institute w USA. Mantel (1919–2002) urodził się w Nowym Jorku, pracował w NCI w latach 1947–1974, potem uczył w George Washington University i American University. Haenszel (1910–1998) urodził się w Rochester, w latach 1952–1976 kierował biometrią NCI, a później był profesorem epidemiologii University of Illinois.
Dlaczego metoda nazywa się Mantela–Haenszela, skoro pomysł był Haenszela?
Według wspomnienia Mantela z 1981 r. artykuł był pomysłem Haenszela, który znał praktyczne problemy badań retrospektywnych, a Mantel dołożył statystykę. To Haenszel zaproponował, żeby nazwisko Mantela stało w tytule pracy jako pierwsze – i tak utrwaliła się nazwa metody.
Czym test Mantela różni się od testu Mantela–Haenszela?
Test Mantela (1967) sprawdza zgodność dwóch macierzy odległości, np. odległości w przestrzeni i w czasie między przypadkami choroby; dziś używa się go m.in. w ekologii i genetyce populacji. Test Mantela–Haenszela (1959) łączy tabele 2 × 2 z warstw i sprawdza, czy wspólny iloraz szans różni się od 1.
Czy OR Mantela–Haenszela da się policzyć, gdy w warstwach są zera?
Tak – i to jego duża zaleta. W przykładzie z 83 zestawami badania kliniczno-kontrolnego żadna warstwa nie ma skończonego, dodatniego OR, a wspólny OR Mantela–Haenszela wynosi 25/6 = 4.17, 95% CI [2.25, 7.73], bo zera w poszczególnych tabelach nie przeszkadzają w sumowaniu licznika i mianownika.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gail, M. H. (1997). A conversation with Nathan Mantel. Statistical Science, 12(2), 88–97. https://doi.org/10.1214/ss/1029963424
- Hankey, B. (1997). A conversation with William M. Haenszel. Statistical Science, 12(2), 108–112. https://doi.org/10.1214/ss/1029963427 ● Otwarty dostęp
- Mannocci, A. (2009). The Mantel-Haenszel procedure. 50 years of the statistical method for confounders control. Italian Journal of Public Health, 6(4). https://doi.org/10.2427/5765 ● Otwarty dostęp: pełny tekst
- Mantel, N. (1981). This week’s citation classic: Mantel N & Haenszel W. Statistical aspects of the analysis of data from retrospective studies of disease. Current Contents/Life Sciences, 24(26), 19. https://garfield.library.upenn.edu/classics1981/A1981LT86500002.pdf ● Otwarty dostęp
- Mantel, N., & Haenszel, W. (1959). Statistical aspects of the analysis of data from retrospective studies of disease. Journal of the National Cancer Institute, 22(4), 719–748. https://doi.org/10.1093/jnci/22.4.719
- Wynn, M. L., Kidwell, K. M., & Merajver, S. D. (2016). The impact of Nathan Mantel’s “The detection of disease clustering and a generalized regression approach”. Cancer Research, 76(9), 2495–2496. https://doi.org/10.1158/0008-5472.can-16-0883
Cytowania BibTeX
@article{gail1997conversation, author={Gail, Mitchell H.}, title={{A conversation with Nathan Mantel}}, journal={Statistical Science}, year={1997}, volume={12}, number={2}, pages={88--97}, doi={10.1214/ss/1029963424}}@article{hankey1997conversation, author={Hankey, Benjamin}, title={{A conversation with William M. Haenszel}}, journal={Statistical Science}, year={1997}, volume={12}, number={2}, pages={108--112}, doi={10.1214/ss/1029963427}}@article{mannocci2009mantel, author={Mannocci, Alice}, title={{The Mantel-Haenszel procedure. 50 years of the statistical method for confounders control}}, journal={Italian Journal of Public Health}, year={2009}, volume={6}, number={4}, doi={10.2427/5765}}@article{mantel1981citation, author={Mantel, Nathan}, title={{This week’s citation classic: Mantel N \& Haenszel W. Statistical aspects of the analysis of data from retrospective studies of disease}}, journal={Current Contents/Life Sciences}, year={1981}, volume={24}, number={26}, pages={19}, publisher={Institute for Scientific Information}, url={https://garfield.library.upenn.edu/classics1981/A1981LT86500002.pdf}}@article{mantel1959statistical, author={Mantel, Nathan and Haenszel, William}, title={{Statistical aspects of the analysis of data from retrospective studies of disease}}, journal={Journal of the National Cancer Institute}, year={1959}, volume={22}, number={4}, pages={719--748}, doi={10.1093/jnci/22.4.719}}@article{wynn2016impact, author={Wynn, Michelle L. and Kidwell, Kelley M. and Merajver, Sofia D.}, title={{The impact of Nathan Mantel’s “The detection of disease clustering and a generalized regression approach”}}, journal={Cancer Research}, year={2016}, volume={76}, number={9}, pages={2495--2496}, doi={10.1158/0008-5472.can-16-0883}}