Co to jest warunkowa regresja logistyczna?
Warunkowa regresja logistyczna (ang. conditional logistic regression) to wersja regresji logistycznej dla danych dobranych w zestawy – pary albo zestawy jeden przypadek i kilka kontroli. Wiarygodność liczy się warunkowo, przy znanej liczbie przypadków w każdym zestawie, więc osobne wyrazy wolne zestawów znikają z obliczeń i nie trzeba ich szacować. Breslow i in. (1978) zaadaptowali model logistyczny do planów, w których każdy przypadek dobrano z R kontrolami, co pozwala analizować naraz wiele czynników ryzyka, ciągłych i dyskretnych, oraz ich interakcje z czynnikami doboru.
Kiedy ją stosować
Typowe zastosowanie to badanie kliniczno-kontrolne z indywidualnym doborem, np. kontrole w tym samym wieku i z tej samej przychodni. Wynikiem jest iloraz szans dla ekspozycji. Informację o efekcie niosą tylko zestawy niezgodne: w parach 1:1 z ekspozycją binarną OR to iloraz dwóch rodzajów par niezgodnych, czyli ta sama informacja, której używa test McNemara. W R służy do tego survival::clogit().
Pearce (2016) przypomina, że sam dobór nie usuwa zakłócenia przez czynniki doboru, więc trzeba je uwzględnić w analizie – ale gdy nie ma problemu rzadkich danych, wystarczy zwykła regresja z tymi czynnikami jako kowariantami. Kuo i in. (2018) w symulacjach pokazali, że przy luźnym doborze (np. tylko wiek) model bezwarunkowy jest dobrą alternatywą, choć model warunkowy lepiej znosi zniekształcenia wprowadzone przez sam dobór.
Przykład
W symulowanych danych 150 par (przypadek i kontrola dobrana wiekiem) eksponowany był tylko przypadek w 46 parach, a tylko kontrola w 19. Warunkowa regresja logistyczna dała OR = 2.42, 95% CI [1.42, 4.13], czyli dokładnie 46/19. Zwykła regresja bez uwzględnienia par dała 2.19, a regresja z osobną zmienną zero-jedynkową dla każdej pary – zawyżone 5.86, mniej więcej kwadrat poprawnego wyniku.
Na rysunku
Pojedynczy przykład może być przypadkiem, więc ten sam plan powtórzono w 1000 symulowanych badaniach: w każdym 150 par przypadek–kontrola dobranych wiekiem i prawdziwy OR = 2. Każde badanie analizowano trzema sposobami jak w przykładzie. Rysunek pokazuje rozkłady oszacowanych ilorazów szans jako wykres skrzypcowy z wykresem pudełkowym w środku.
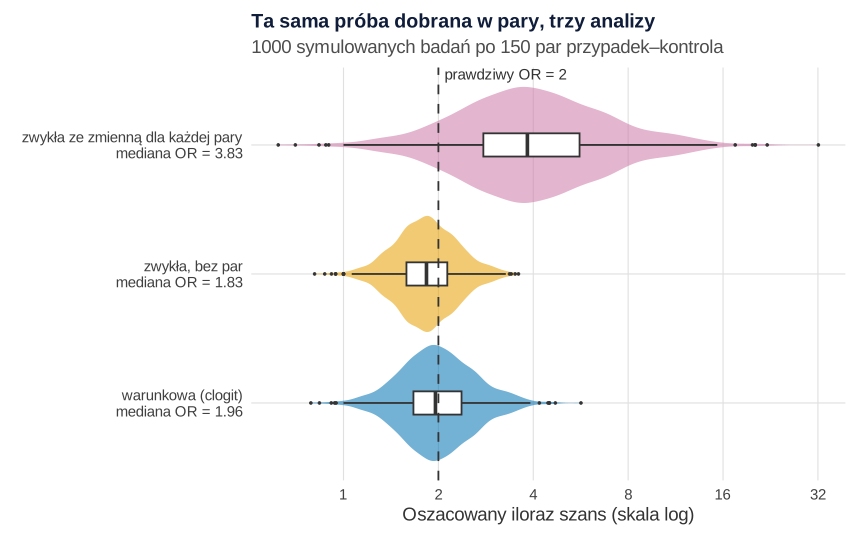
set.seed(5990)).Co widać. Warunkowa regresja logistyczna trafia w cel: mediana OR = 1.96, obciążenie logarytmu OR −0.004 (błąd MC 0.009), a 95% przedziały ufności objęły prawdziwą wartość w 95.0% badań (błąd MC 0.7 pp). Zwykła regresja bez par zaniża efekt (mediana 1.83, obciążenie −0.089, błąd MC 0.007), bo dobór według wieku, związanego z ekspozycją, upodabnia kontrole do przypadków. Regresja ze zmienną dla każdej pary podwaja logarytm OR: mediana 3.83, czyli blisko 2² = 4, a pokrycie przedziałów spada do 54.8% (błąd MC 1.6 pp).
Na co uważać. Obciążenie analizy bez par jest tu małe, bo wiek słabo wiąże się z ekspozycją; przy silniejszym związku czynnika doboru z ekspozycją rośnie. Rysunek dotyczy par 1:1 – przy kilku kontrolach na przypadek zawyżenie w modelu ze zmiennymi dla zestawów jest mniejsze, ale nie znika. Wykres nie pokazuje też, co się dzieje przy rzadkich ekspozycjach i małej liczbie par niezgodnych. Jak czytać ilorazy szans z regresji logistycznej, pokazuje wpis Regresja logistyczna w obrazkach.
Podpis do pracy:
Parametry pojedynczego badania (150 par, OR = 2, związek wieku z ekspozycją) są te same co w przykładzie i zostały ustalone ręcznie; symulacja ma własne ziarno 5990, ustalone raz i niezmieniane. Obliczenie trwa około pół minuty. Rysunek na stronie różni się od wyniku kodu tylko motywem (krój i kolor czcionki, siatka).
R – kod rysunku
# Rysunek 1. OR z warunkowej i ze zwykłej regresji logistycznej w 1000 symulowanych badaniach
# Każde badanie jak w przykładzie hasła: 150 par przypadek–kontrola dobranych wiekiem, prawdziwy OR = 2
library(ggplot2)
suppressPackageStartupMessages(library(survival))
jedno_badanie <- function(pary = 150, OR = 2) {
  wiek <- rnorm(pary, 50, 10)
  p0 <- plogis(-1 + 0.08 * (wiek - 50))            # ekspozycja zależy od wieku (czynnika doboru)
  d <- data.frame(para = rep(1:pary, each = 2), przypadek = rep(1:0, pary))
  d$ekspozycja <- rbinom(2 * pary, 1, ifelse(d$przypadek == 1,
                         plogis(qlogis(rep(p0, each = 2)) + log(OR)), rep(p0, each = 2)))
  m <- list(clogit = clogit(przypadek ~ ekspozycja + strata(para), data = d),
            glm_bez_par = glm(przypadek ~ ekspozycja, family = binomial, data = d),
            glm_z_parami = glm(przypadek ~ ekspozycja + factor(para), family = binomial, data = d))
  t(sapply(m, function(f) c(b = coef(f)[["ekspozycja"]],
                            se = sqrt(vcov(f)["ekspozycja", "ekspozycja"]))))
}
set.seed(5990)
R <- 1000
wyn <- replicate(R, jedno_badanie())   # tablica 3 metody × (b, se) × R
b <- t(wyn[, "b", ]); se <- t(wyn[, "se", ])
pokrycie <- colMeans(b - 1.96 * se < log(2) & b + 1.96 * se > log(2))
podsum <- data.frame(metoda = colnames(b),
                     mediana_OR = round(apply(exp(b), 2, median), 2),
                     obc_logOR = round(colMeans(b) - log(2), 3),
                     MC_SE_obc = round(apply(b, 2, sd) / sqrt(R), 3),
                     pokrycie_95 = round(pokrycie, 3),
                     MC_SE_pokr = round(sqrt(pokrycie * (1 - pokrycie) / R), 3))
print(podsum, row.names = FALSE)

etyk <- c(clogit = "warunkowa (clogit)", glm_bez_par = "zwykła, bez par",
          glm_z_parami = "zwykła ze zmienną dla każdej pary")
etyk <- setNames(sprintf("%s\nmediana OR = %.2f", etyk, podsum$mediana_OR), names(etyk))
dl <- data.frame(metoda = factor(rep(etyk[colnames(b)], each = R), levels = etyk),
                 OR = as.vector(exp(b)))
kol <- c("#0072B2", "#E69F00", "#CC79A7")                 # Okabe–Ito
motyw <- theme_minimal(base_size = 14) + theme(legend.position = "none", panel.grid.minor = element_blank())
p1 <- ggplot(dl, aes(x = OR, y = metoda, fill = metoda)) +
  geom_violin(colour = NA, alpha = 0.55, scale = "width") +
  geom_boxplot(width = 0.18, outlier.size = 0.6, fill = "white") +
  geom_vline(xintercept = 2, linetype = "dashed", colour = "grey20") +
  annotate("text", x = 2, y = 3.55, label = "prawdziwy OR = 2", hjust = -0.05, size = 4, colour = "grey20") +
  scale_x_log10(breaks = c(0.5, 1, 2, 4, 8, 16, 32)) +
  scale_fill_manual(values = kol, guide = "none") +
  labs(x = "Oszacowany iloraz szans (skala log)", y = NULL,
       title = "Ta sama próba dobrana w pary, trzy analizy",
       subtitle = sprintf("%d symulowanych badań po 150 par przypadek–kontrola", R)) +
  motyw
p1   # zapis: ggsave("warunkowa-regresja-logistyczna-or-symulacja.svg", p1, width = 9, height = 5.6)
Wynik w R
       metoda mediana_OR obc_logOR MC_SE_obc pokrycie_95 MC_SE_pokr
       clogit       1.96    -0.004     0.009       0.950      0.007
  glm_bez_par       1.83    -0.089     0.007       0.950      0.007
 glm_z_parami       3.83     0.684     0.017       0.548      0.016
Jak opisać w pracy
Na co uważać
- Nie dodawaj par jako zmiennych zero-jedynkowych do zwykłego modelu – przy małych zestawach OR jest silnie zawyżony.
- Efektu czynnika doboru nie da się oszacować; można badać tylko jego interakcję z ekspozycją.
- Dobór w badaniu kliniczno-kontrolnym to co innego niż dopasowanie w badaniu kohortowym, np. po propensity score.
Warunkowa regresja logistyczna w R
Kod symuluje 150 par z doborem według wieku, wypisuje tablicę par zgodnych i niezgodnych oraz porównuje clogit() z pakietu survival z dwiema błędnymi analizami w glm(): bez uwzględnienia par oraz z osobną zmienną dla każdej pary.
clogit() a zwykła regresja logistyczna dla danych dobranych w pary
R
library(survival)
set.seed(599)                                      # 150 par: przypadek + kontrola dobrana wiekiem
pary <- 150; OR <- 2
wiek <- rnorm(pary, 50, 10)
p0 <- plogis(-1 + 0.08 * (wiek - 50))              # ekspozycja zależy od wieku (czynnika doboru)
d <- data.frame(para = rep(1:pary, each = 2), przypadek = rep(1:0, pary),
                wiek = rep(wiek, each = 2))
d$ekspozycja <- rbinom(2 * pary, 1, ifelse(d$przypadek == 1,
                       plogis(qlogis(rep(p0, each = 2)) + log(OR)), rep(p0, each = 2)))
tab <- table(przypadek = d$ekspozycja[d$przypadek == 1], kontrola = d$ekspozycja[d$przypadek == 0])
tab                                                # pary zgodne i niezgodne
warunkowa <- clogit(przypadek ~ ekspozycja + strata(para), data = d)
zwykla <- glm(przypadek ~ ekspozycja, family = binomial, data = d)
z_parami <- glm(przypadek ~ ekspozycja + factor(para), family = binomial, data = d)
round(c(niezgodne_10_01 = tab["1", "0"] / tab["0", "1"],
        clogit = exp(coef(warunkowa))[["ekspozycja"]],
        glm_bez_par = exp(coef(zwykla))[["ekspozycja"]],
        glm_z_parami = exp(coef(z_parami))[["ekspozycja"]]), 2)
round(exp(confint(warunkowa)), 2)                 # 95% CI dla OR z clogit
Wynik w R
         kontrola
przypadek  0  1
        0 62 19
        1 46 23
niezgodne_10_01          clogit     glm_bez_par    glm_z_parami
           2.42            2.42            2.19            5.86
           2.5 % 97.5 %
ekspozycja  1.42   4.13
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: clogit()); rysunki narysowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy dobór par zawsze wymaga warunkowej regresji logistycznej?
Nie zawsze. Czynniki doboru trzeba uwzględnić w analizie, ale przy luźnym doborze, np. tylko według wieku, wystarczy zwykła regresja z nimi jako kowariantami. Przy ścisłym doborze w pary bezpieczniejszy jest model warunkowy.
Dlaczego pary zgodne nie wpływają na wynik warunkowej regresji logistycznej?
Gdy w parze oba lub żaden z uczestników nie byli eksponowani, para nie mówi nic o tym, czy ekspozycja odróżnia przypadek od kontroli. W przykładzie OR = 46/19 = 2.42.
Jak policzyć warunkową regresję logistyczną w R?
Funkcją clogit() z pakietu survival: clogit(przypadek ~ ekspozycja + strata(para)). Iloraz szans daje exp(coef()), a przedział ufności exp(confint()).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Badanie kliniczno-kontrolne krok po kroku
Definicja przypadku, baza źródłowa, dobór kontroli i nadmierne dopasowanie, regresja warunkowa a zwykła, liczebność i opis wg STROBE – z symulacją w R.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Breslow, N. E., Day, N. E., Halvorsen, K. T., Prentice, R. L., & Sabai, C. (1978). Estimation of multiple relative risk functions in matched case-control studies. American Journal of Epidemiology, 108(4), 299–307. https://doi.org/10.1093/oxfordjournals.aje.a112623
- Kuo, C.-L., Duan, Y., & Grady, J. (2018). Unconditional or conditional logistic regression model for age-matched case–control data? Frontiers in Public Health, 6, Article 57. https://doi.org/10.3389/fpubh.2018.00057 ● Otwarty dostęp
- Pearce, N. (2016). Analysis of matched case-control studies. BMJ, 352, Article i969. https://doi.org/10.1136/bmj.i969 ● Otwarty dostęp
Cytowania BibTeX
@article{breslow1978estimation, author={Breslow, N. E. and Day, N. E. and Halvorsen, K. T. and Prentice, R. L. and Sabai, C.}, title={{Estimation of multiple relative risk functions in matched case-control studies}}, journal={American Journal of Epidemiology}, year={1978}, volume={108}, number={4}, pages={299--307}, doi={10.1093/oxfordjournals.aje.a112623}}@article{kuo2018unconditional, author={Kuo, Chia-Ling and Duan, Yinghui and Grady, James}, title={{Unconditional or conditional logistic regression model for age-matched case–control data?}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={57}, doi={10.3389/fpubh.2018.00057}}@article{pearce2016analysis, author={Pearce, Neil}, title={{Analysis of matched case-control studies}}, journal={BMJ}, year={2016}, volume={352}, eid={i969}, doi={10.1136/bmj.i969}}