Badanie, które zaczyna się od wyniku
W badaniu kliniczno-kontrolnym wychodzisz od osób, u których zdarzenie już wystąpiło, dobierasz osoby bez tego zdarzenia i sprawdzasz wstecz, czy były narażone na badany czynnik. Definicję, przykład i powód, dla którego nie liczy się tu ryzyka, znajdziesz w haśle słownika. Ten wpis zajmuje się tym, na czym prace dyplomowe najczęściej się potykają: skąd wziąć kontrole, po czym je dobierać i jak policzyć dane po doborze.
Schulz i Grimes (2002) podsumowują ten schemat krótko: jest szybszy i tańszy od innych badań porównawczych, ale też łatwiej go zrobić źle. Dlatego decyzje podejmujesz przed zebraniem danych, a nie przy analizie. Jeśli możesz śledzić osoby w czasie, porównaj to z badaniem kohortowym; wybór miary dla obu schematów opisuje wpis ryzyko względne, iloraz szans i NNT.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa bada na czterech oddziałach, czy upadek pacjenta w wieku 65+ wiąże się z podaniem leku nasennego w ciągu 24 godzin przed upadkiem. Ma 161 przypadków i 322 kontrole. Liczby nie mówią nic o działaniu jakiegokolwiek rzeczywistego leku; służą wyłącznie do pokazania metody. Dane możesz pobrać: upadki-kontrole-dobrane.csv.
Krok 1. Zdefiniuj przypadek
Definicja przypadku ma być tak jasna, żeby dwie osoby czytające tę samą dokumentację zaklasyfikowały pacjenta tak samo. Schulz i Grimes (2002) wymieniają jawne kryteria rozpoznania i włączenia jako pierwszą zasadę tego schematu. Zapisz:
- co jest zdarzeniem – np. „upadek odnotowany w karcie zdarzeń, pierwszy w czasie danej hospitalizacji”;
- kiedy i gdzie – okres badania i oddziały;
- kto może być przypadkiem – kryteria włączenia i wyłączenia identyczne dla przypadków i kontroli (poza samym zdarzeniem);
- nowe czy istniejące przypadki – bierz nowe. Osoby chorujące od dawna mówią też o tym, kto przeżył i z chorobą pozostał, a to miesza zapadalność z chorobowością.
Bierz wszystkie kolejne przypadki z okresu, a nie te „najłatwiej dostępne”. Jeśli dane pochodzą z historii choroby, kartę ekstrakcji i zgodność dwóch osób opisuje wpis o analizie dokumentacji medycznej. Nie będziemy tego powtarzać.
Krok 2. Nazwij bazę źródłową
Baza źródłowa to populacja, z której wyłoniły się przypadki: każda osoba z bazy, gdyby doszło u niej do zdarzenia, trafiłaby do Twojej próby jako przypadek. Wacholder i in. (1992) opierają dobór kontroli na trzech zasadach: porównania w obrębie tej samej bazy, brak zniekształcenia przez inne czynniki i jednakowa dokładność pomiaru narażenia w obu grupach. Spory o kontrole to według nich zwykle kompromisy między tymi zasadami a kosztem.
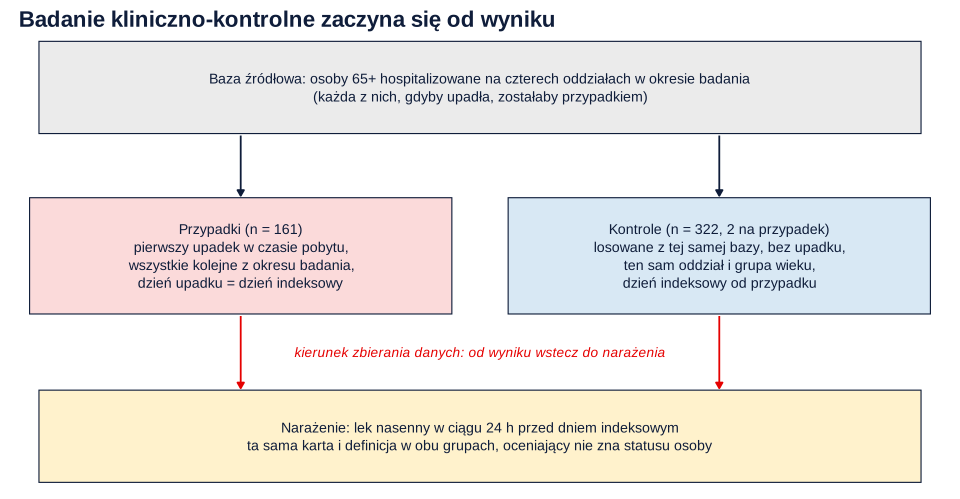
U kontroli nie ma daty zdarzenia, więc potrzebujesz dnia indeksowego: daty, wobec której mierzysz narażenie. W przykładzie kontrola dziedziczy go od swojego przypadku, np. ten sam dzień pobytu lub data kalendarzowa. Bez tego okno 24 godzin znaczy co innego u przypadków i kontroli.
Sposób losowania kontroli decyduje też o tym, co szacuje iloraz szans (OR). Pearce (1993) pokazuje, że przy kontrolach losowanych z osobolat zagrożenia OR szacuje iloraz zapadalności, przy losowaniu z osób zagrożonych na początku obserwacji – iloraz ryzyk, a przy losowaniu spośród osób wolnych od zdarzenia na końcu – iloraz szans, i że nie wymaga to założenia o rzadkości choroby. Odmiana z kontrolami losowanymi w czasie to zagnieżdżone badanie kliniczno-kontrolne.
Krok 3. Wybierz źródło kontroli
Grimes i Schulz (2005) rozróżniają dwie sytuacje. Gdy populacja jest znana (jest lista), kontrole losujesz z tej listy. Gdy nie jest znana, korzystasz z zastępczych grup: pacjentów tego samego szpitala, sąsiadów albo znajomych i krewnych. Ideału nie ma, a jedna dobrze wybrana grupa jest zwykle lepsza niż dwie lub więcej.
| Źródło kontroli | Kiedy ma sens | Główne ryzyko |
|---|---|---|
| Losowanie z listy bazy (księga oddziału, rejestr, baza przychodni) | Baza jest znana – typowa sytuacja w jednym szpitalu | Braki w dokumentacji; ktoś musi dać dostęp do listy |
| Pacjenci tego samego szpitala z innym rozpoznaniem | Baza nieznana, przypadki z jednego ośrodka | Powód przyjęcia kontroli bywa związany z narażeniem |
| Sąsiedzi | Rekrutacja w społeczności | Podobieństwo środowiska zaniża różnice w narażeniu |
| Znajomi i krewni wskazani przez przypadek | Niewielkie badania, trudna rekrutacja | Podobne nawyki; przypadek wybiera kontrolę sam |
Dwie reguły są nienegocjowalne (Schulz i Grimes, 2002): kontrole pochodzą z tej samej populacji co przypadki, a o ich włączeniu nie decyduje narażenie. Znajomi z grupy na studiach to dobór wygodny, a nie grupa kontrolna.
Krok 4. Zdecyduj, czy i jak dobierać
Dobór (ang. matching) służy upodobnieniu kontroli do przypadków pod względem silnego zakłócacza. Ma dwie odmiany:
| Dobór częstościowy | Dobór indywidualny | |
|---|---|---|
| Na czym polega | Kontrole mają taki sam rozkład cechy jak przypadki (np. tyle samo osób w każdej grupie wieku) | Każdy przypadek ma własne kontrole, np. ten sam oddział i przedział wieku (zestaw 1:2) |
| Dane | Dwie grupy, bez identyfikatora zestawu | Kolumna z numerem zestawu |
| Analiza | Regresja logistyczna z czynnikami doboru | Regresja warunkowa albo logistyczna z czynnikami doboru, jeśli cecha ma kategorie |
| Typowe cechy | Wiek, płeć | Sąsiedztwo, rodzeństwo, dzień przyjęcia |
Najważniejsza wiadomość jest nieintuicyjna: w badaniu kliniczno-kontrolnym sam dobór nie usuwa zakłócenia. Pearce (2016) wyjaśnia, że może je wręcz wprowadzić, nawet jeśli w bazie go nie było, dlatego czynniki doboru trzeba uwzględnić w analizie. Mansournia i in. (2013) pokazują to na grafach przyczynowych: inaczej niż w kohorcie, dobór przypadków i kontroli zwykle nie zapobiega zakłóceniu przez czynniki doboru. Graf przydaje się też przy wyborze zmiennych do kontroli (zob. grafy przyczynowe). Dobór w tym schemacie to co innego niż dopasowanie po propensity score w badaniach obserwacyjnych z grupą porównawczą.
Zysk z doboru polega na precyzji: w każdej warstwie masz i przypadki, i kontrole. Czynnika doboru nie zbadasz już jako czynnika ryzyka, bo sam ustaliłeś(-aś) jego rozkład w grupach.
Krok 5. Policz dane po doborze
W przykładzie dobrano po dwie kontrole z tego samego oddziału i pięcioletniej grupy wieku. Lek otrzymało 59.0% przypadków i 39.8% kontroli. Średni wiek jest prawie równy (82.9 i 82.2 roku), bo o to chodziło w doborze. Zaburzenia poznawcze, których nie uwzględniono w doborze, były częstsze u przypadków (38.5% wobec 25.8%), więc trzeba je skontrolować w modelu.
Spośród 161 zestawów 56 było zgodnych (w 32 nikt nie dostał leku, w 24 dostali wszyscy). Takie zestawy nie niosą informacji o związku z lekiem; wynik opiera się na pozostałych 105. To ta sama logika co w teście McNemara dla par. Do analizy służy warunkowa regresja logistyczna, w R: clogit(przypadek ~ lek + zab_pozn + strata(zestaw), data = d) z pakietu survival.
| Analiza 161 zestawów | OR dla leku | 95% CI |
|---|---|---|
| Regresja warunkowa: tylko lek | 2.49 | [1.62, 3.81] |
| Regresja warunkowa: lek + zaburzenia poznawcze | 2.29 | [1.47, 3.54] |
| Zwykła regresja bez czynników doboru: tylko lek | 2.18 | [1.48, 3.21] |
| Zwykła regresja bez czynników doboru: lek + zaburzenia poznawcze | 2.00 | [1.34, 2.97] |
| Zwykła regresja z czynnikami doboru i zaburzeniami poznawczymi | 2.27 | [1.48, 3.47] |
Jeden zbiór nie wystarcza do oceny metody, dlatego powtórzyliśmy cały proces 1000 razy (prawdziwy OR = 2, korygowany o wiek, oddział i zaburzenia poznawcze). W każdym powtórzeniu powstaje nowa baza i dwa zestawy kontroli: losowe i dobrane.
| Sposób | OR (śr. geom.) | SD log OR | Pokrycie 95% CI | Moc |
|---|---|---|---|---|
| A. Losowe kontrole, bez korekty | 4.08 | 0.196 | 4.4% | – |
| B. Losowe kontrole, regresja z korektą | 2.08 | 0.237 | 94.6% | 87.6% |
| C. Dobrane, zwykła regresja bez czynników doboru | 1.75 | 0.197 | 91.1% | 79.8% |
| D. Dobrane, regresja warunkowa | 2.07 | 0.226 | 95.3% | 90.8% |
| E. Dobrane, zwykła regresja z czynnikami doboru | 2.09 | 0.224 | 93.9% | 91.8% |
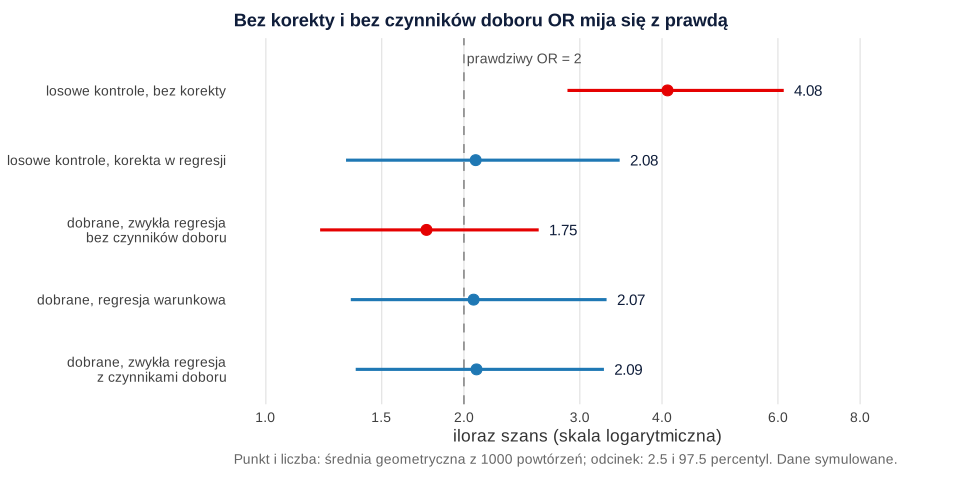
Z tabeli i rysunku wynikają cztery wnioski:
- Bez korekty losowe kontrole są mylące: wiek i zaburzenia poznawcze wiążą się z lekiem i z upadkiem, więc OR wynosi 4.08 zamiast 2.
- Dobór bez uwzględnienia go w analizie obciąża wynik: sposób C daje 1.75. Vandenbroucke i in. (2007) wskazują, że analiza ignorująca dobór zwykle przesuwa OR ku jedności.
- Regresja warunkowa nie jest jedyną poprawną drogą: D i E dają podobne wyniki. Pearce (2016) wyjaśnia, że bez problemu rzadkich danych standardowa analiza z czynnikami doboru jest poprawna i bywa precyzyjniejsza. Gdy dobór oparto na cechach takich jak wiek i płeć, wystarczą ich kategorie; przy sąsiedztwie czy rodzeństwie każdy zestaw trzeba traktować jak odrębną warstwę (Vandenbroucke i in., 2007).
- Dobór dał tu niewielki zysk: SD log OR spadło z 0.237 (B) do 0.226 (D), a moc wzrosła z 87.6% do 90.8%. Zysk zależy od siły związku cechy doboru z wynikiem i narażeniem.
Nie dodawaj numerów zestawów jako osobnych zmiennych zero-jedynkowych do zwykłej regresji. Dlaczego i o ile to zawyża wynik, pokazuje hasło o regresji warunkowej. Interpretację współczynników zwykłej regresji znajdziesz w poradniku o regresji logistycznej; tabelę 2×2 bez doboru policzysz kalkulatorem.
Krok 6. Skontroluj zakłócacze, ale z planem
OR z modelu z zaburzeniami poznawczymi to 2.29, wobec 2.49 bez nich. Zmienne do modelu wybierz przed analizą na podstawie wiedzy o tym, co wpływa jednocześnie na narażenie i wynik, a nie na podstawie wartości p. Zasady są opisane we wpisie czy kontrolować wiek i płeć. Liczbę zmiennych dopasuj do liczby przypadków i zestawów niezgodnych, a w tekście opisuj tylko OR dla narażenia: OR dla zmiennej kontrolnej, tu zaburzeń poznawczych, to nie to samo pytanie badawcze (zob. błąd tabeli 2).
Krok 7. Unikaj nadmiernego dopasowania
Dobór po niewłaściwej cesze szkodzi na dwa różne sposoby. Pokazuje to kolejna symulacja (1000 powtórzeń, średnio 146 przypadków, prawdziwy łączny OR = 2.10):
- Cecha związana tylko z narażeniem, np. lekarz zlecający, który nie ma wpływu na upadek inaczej niż przez zlecenie. Zestawy stają się podobne pod względem narażenia, więc mniej z nich niesie informację. OR jest poprawny (2.14), ale SD log OR rośnie z 0.206 do 0.244, a moc spada z 95.1% do 86.7%. Dla tej samej precyzji potrzeba 1.40 razy większej próby.
- Cecha leżąca na drodze przyczynowej, np. senność po leku. Mansournia i in. (2013) wskazują, że dobór po zmiennych pośredniczących między narażeniem a wynikiem zwykle daje obciążenie, którego nie da się usunąć w analizie. Tu OR spada do 1.50 – zostaje tylko efekt bezpośredni – a moc do 42.1%.
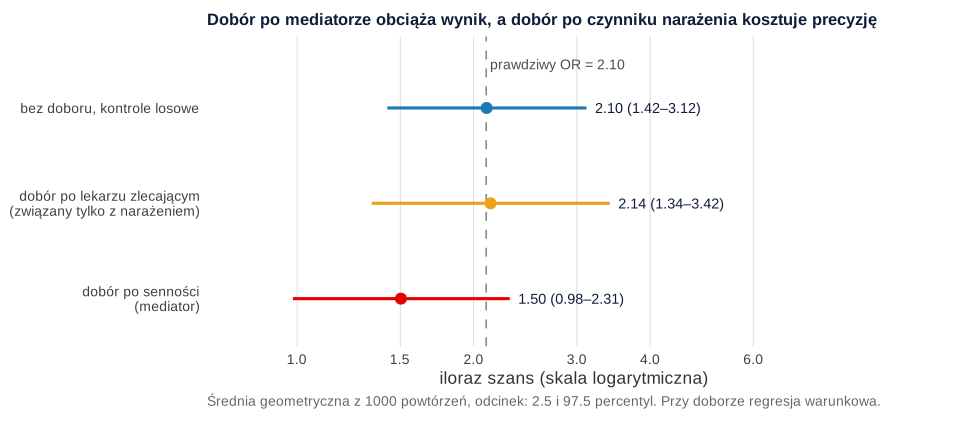
Prosta reguła: dobieraj tylko po cechach, które są silnymi przyczynami wyniku i mogą zakłócać związek z narażeniem, i nigdy po czymś, co mogło być skutkiem narażenia. Każdą taką cechę uzasadnij przed zebraniem danych.
Błąd przypominania i błąd selekcji w liczbach
Błąd przypominania dotyczy narażenia raportowanego z pamięci, np. pytania w ankiecie o nawyki sprzed choroby. Coughlin (1990) rozróżnia pamięć zwyczajnie niedokładną od stronniczej i zauważa, że na technikę wywiadu i konstrukcję kwestionariusza badacz ma wpływ. Przy prawdziwym OR = 2 i narażeniu 30% wśród kontroli:
| Sytuacja | Obserwowany OR |
|---|---|
| Niedokładność jednakowa w obu grupach (czułość .80, swoistość .95) | 1.73 – osłabienie |
| Przypadki pamiętają lepiej (czułość .95 u przypadków, .75 u kontroli) | 2.69 – zawyżenie |
| Jak wyżej, ale prawdziwego związku nie ma (OR = 1) | 1.37 – pozorny związek |
| Narażeni chętniej trafiają do kontroli (współczynnik 1.5) | 1.33 – zaniżenie |
| Narażeni rzadziej trafiają do kontroli (współczynnik 0.7) | 2.86 – zawyżenie |
Pierwsze trzy wiersze to błąd pomiaru, a ostatnie dwa – błąd selekcji. Tym drugim nie zaradzisz w analizie, jeśli nie znasz mechanizmu doboru. Zabezpiecz się na etapie planowania: to samo narzędzie i ten sam tryb u przypadków i kontroli, pomoce pamięciowe, osoby zbierające dane nieznające statusu uczestnika albo przynajmniej hipotezy (zaślepienie; Schulz i Grimes, 2002). Jeśli to możliwe, sprawdź narażenie w dokumentacji powstałej przed zdarzeniem.
Ile osób potrzeba
Dla doboru bez par przelicz OR na dwa odsetki. Przy narażeniu 30% wśród kontroli i OR = 2 u przypadków wyniesie ono 46.2%, a zwykły wzór na dwie proporcje (α = .05, moc 80%) daje 141 przypadków i 141 kontroli.
| Kontrole na przypadek | Przypadki | Kontrole | Razem |
|---|---|---|---|
| 1 | 141 | 141 | 282 |
| 2 | 106 | 212 | 318 |
| 3 | 94 | 282 | 376 |
| 4 | 89 | 356 | 445 |
| 5 | 85 | 425 | 510 |
Więcej kontroli pomaga, gdy przypadków jest mało (Grimes i Schulz, 2005), ale zysk szybko maleje: z czterech kontroli na pięć oszczędzasz cztery przypadki kosztem 69 dodatkowych kontroli. W parach 1:1 liczy się liczba par niezgodnych: dla OR = 2 potrzeba ich 69. Jeśli niezgodnych jest 45% par, to 154 pary; przy 35% – 198; przy 25% – 276. Dupont (1988) pokazuje, że im silniejsza korelacja narażenia w zestawach, tym większa strata mocy, a wymagana liczebność rośnie też, gdy narażenie jest bardzo rzadkie albo bardzo częste. Przy planowaniu opieraj się na danych pilotażowych o narażeniu. Więcej o uzasadnianiu liczebności przeczytasz w poradniku o doborze liczebności próby.
Jak opisać badanie (STROBE)
Lista STROBE w wersji kliniczno-kontrolnej wymaga m.in. podania źródeł i sposobu ustalania przypadków, wyboru kontroli i uzasadnienia tego wyboru (punkt 6a), a przy doborze – kryteriów doboru i liczby kontroli na przypadek (6b) oraz wyjaśnienia, jak uwzględniono dobór w analizie (12d) (Vandenbroucke i in., 2007). Jakość takich badań w przeglądach ocenia się m.in. skalą Newcastle–Ottawa, warto więc znać jej pytania o dobór grup.
Najczęstsze błędy
- Kontrole spoza bazy. Przypadki z oddziału, a kontrole ze znajomych z pracy.
- Różny pomiar w grupach, np. karta dla przypadków, a ankieta dla kontroli.
- Brak dnia indeksowego, przez co okno narażenia ma różną długość.
- Liczenie RR lub ryzyka z tabeli, w której liczbę kontroli ustaliłeś(-aś) sam(a). Właściwa miara to OR.
- Dobór bez uwzględnienia w analizie albo przekonanie, że dobór „załatwił” zakłócanie.
- Dobór po cesze będącej skutkiem narażenia albo po cesze związanej tylko z narażeniem.
- Interpretowanie OR jako dowodu przyczynowości. To wciąż schemat obserwacyjny.
Badanie kliniczno-kontrolne w R
Cztery przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy dane i zapisuje plik CSV; pozostałe są niezależne. Rysunki powstały w osobnym skrypcie na wynikach tych przepisów. Dane możesz pobrać: upadki-kontrole-dobrane.csv (161 zestawów, 483 osoby: numer zestawu, przypadek 1/0, wiek, grupa wieku, oddział, zaburzenia poznawcze 0/1, lek 0/1).
Dane, dobór kontroli i analiza
R
# B451 – badanie kliniczno-kontrolne: upadek w szpitalu a lek nasenny (dane symulowane)
# Przypadek = upadek w czasie hospitalizacji; kontrole dobrane 2:1 według oddziału i grupy wieku.
library(survival)
set.seed(4511)

# 1. Baza źródłowa: hospitalizacje osób w wieku 65+ (w prawdziwym badaniu jej nie obserwujesz w całości)
generuj_baze <- function(N = 12000) {
  wiek <- pmin(95, 65 + rexp(N, rate = 1 / 10))
  oddzial <- sample(c("interna", "neurologia", "ortopedia", "chirurgia"), N, replace = TRUE)
  zab_pozn <- rbinom(N, 1, plogis(-1.8 + .07 * (wiek - 75)))
  ef_lek <- c(interna = 0, neurologia = .5, ortopedia = -.4, chirurgia = -.2)[oddzial]
  ef_upadek <- c(interna = 0, neurologia = .6, ortopedia = .3, chirurgia = -.3)[oddzial]
  lek <- rbinom(N, 1, plogis(-1.3 + .07 * (wiek - 75) + ef_lek + .9 * zab_pozn))
  upadek <- rbinom(N, 1, plogis(-5.2 + log(2) * lek + .06 * (wiek - 75) + ef_upadek + 1.0 * zab_pozn))
  data.frame(wiek = round(wiek, 1),
             wiek_gr = cut(wiek, c(65, 70, 75, 80, 85, Inf), right = FALSE,
                           labels = c("65-69", "70-74", "75-79", "80-84", "85+")),
             oddzial, zab_pozn, lek, upadek)
}

# 2. Dobór: każdemu przypadkowi losujemy m kontroli z tego samego oddziału i grupy wieku
dobierz <- function(baza, m = 2) {
  przypadki <- which(baza$upadek == 1)
  wolne <- rep(TRUE, nrow(baza))
  wolne[przypadki] <- FALSE
  klucz <- paste(baza$oddzial, baza$wiek_gr)
  wynik <- vector("list", length(przypadki))
  for (i in seq_along(przypadki)) {
    p <- przypadki[i]
    kand <- which(wolne & klucz == klucz[p])
    k <- if (length(kand) > m) sample(kand, m) else kand
    wolne[k] <- FALSE
    wynik[[i]] <- cbind(baza[c(p, k), ], zestaw = i, przypadek = c(1, rep(0, length(k))))
  }
  do.call(rbind, wynik)
}

baza <- generuj_baze()
d <- dobierz(baza, m = 2)
rownames(d) <- NULL
write.csv(d[, c("zestaw", "przypadek", "wiek", "wiek_gr", "oddzial", "zab_pozn", "lek")],
          "../upadki-kontrole-dobrane.csv", row.names = FALSE, fileEncoding = "UTF-8")

cat("Baza źródłowa:", nrow(baza), "hospitalizacji, upadki:", sum(baza$upadek),
    sprintf("(%.2f%%)\n", 100 * mean(baza$upadek)))
cat("Próba: przypadki =", sum(d$przypadek), ", kontrole =", sum(!d$przypadek), "\n")
print(table(rozmiar_zestawu = table(d$zestaw)))

# 3. Opis grup
tab <- table(grupa = ifelse(d$przypadek == 1, "przypadek", "kontrola"), lek = d$lek)
print(tab)
cat(sprintf("Lek nasenny: przypadki %.1f%%, kontrole %.1f%%\n",
            100 * mean(d$lek[d$przypadek == 1]), 100 * mean(d$lek[d$przypadek == 0])))
cat(sprintf("Zaburzenia poznawcze: przypadki %.1f%%, kontrole %.1f%%\n",
            100 * mean(d$zab_pozn[d$przypadek == 1]), 100 * mean(d$zab_pozn[d$przypadek == 0])))
cat(sprintf("Średni wiek: przypadki %.1f, kontrole %.1f (dobór działa)\n",
            mean(d$wiek[d$przypadek == 1]), mean(d$wiek[d$przypadek == 0])))

# Ile zestawów niesie informację o leku: narażenie przypadku × liczba narażonych kontroli
z <- do.call(rbind, lapply(split(d, d$zestaw), function(x)
  data.frame(przypadek_lek = x$lek[x$przypadek == 1], kontrole_lek = sum(x$lek[x$przypadek == 0]))))
print(table(przypadek_lek = z$przypadek_lek, kontrole_z_lekiem = z$kontrole_lek))
zgodne <- sum(z$przypadek_lek == 1 & z$kontrole_lek == 2) + sum(z$przypadek_lek == 0 & z$kontrole_lek == 0)
cat("Zestawy zgodne (bez informacji):", zgodne, "z", nrow(z), "\n")

# 4. Analizy
opis <- function(m, nazwa, wsp = "lek") {
  s <- summary(m)$coefficients
  b <- s[wsp, 1]
  se <- if ("se(coef)" %in% colnames(s)) s[wsp, "se(coef)"] else s[wsp, "Std. Error"]
  sprintf("%-50s OR = %.2f, 95%% CI [%.2f, %.2f], SE(log OR) = %.3f",
          nazwa, exp(b), exp(b - 1.96 * se), exp(b + 1.96 * se), se)
}
m1 <- clogit(przypadek ~ lek + strata(zestaw), data = d)
m2 <- clogit(przypadek ~ lek + zab_pozn + strata(zestaw), data = d)
m3 <- glm(przypadek ~ lek, data = d, family = binomial)
m4 <- glm(przypadek ~ lek + zab_pozn, data = d, family = binomial)
m5 <- glm(przypadek ~ lek + zab_pozn + wiek_gr + oddzial, data = d, family = binomial)

cat(opis(m1, "clogit: tylko lek"), "\n")
cat(opis(m2, "clogit: lek + zaburzenia poznawcze"), "\n")
cat(opis(m3, "glm bez czynników doboru: tylko lek"), "\n")
cat(opis(m4, "glm bez czynników doboru: lek + zab. pozn."), "\n")
cat(opis(m5, "glm z czynnikami doboru: lek + zab. + wiek + oddz."), "\n")
cat(opis(m2, "OR dla zaburzeń poznawczych (clogit)", "zab_pozn"), "\n")
Wynik w R
Baza źródłowa: 12000 hospitalizacji, upadki: 161 (1.34%)
Próba: przypadki = 161 , kontrole = 322
rozmiar_zestawu
  3
161
           lek
grupa         0   1
  kontrola  194 128
  przypadek  66  95
Lek nasenny: przypadki 59.0%, kontrole 39.8%
Zaburzenia poznawcze: przypadki 38.5%, kontrole 25.8%
Średni wiek: przypadki 82.9, kontrole 82.2 (dobór działa)
             kontrole_z_lekiem
przypadek_lek  0  1  2
            0 32 29  5
            1 30 41 24
Zestawy zgodne (bez informacji): 56 z 161
clogit: tylko lek                                  OR = 2.49, 95% CI [1.62, 3.81], SE(log OR) = 0.218
clogit: lek + zaburzenia poznawcze                 OR = 2.29, 95% CI [1.47, 3.54], SE(log OR) = 0.224
glm bez czynników doboru: tylko lek               OR = 2.18, 95% CI [1.48, 3.21], SE(log OR) = 0.197
glm bez czynników doboru: lek + zab. pozn.        OR = 2.00, 95% CI [1.34, 2.97], SE(log OR) = 0.202
glm z czynnikami doboru: lek + zab. + wiek + oddz. OR = 2.27, 95% CI [1.48, 3.47], SE(log OR) = 0.217
OR dla zaburzeń poznawczych (clogit)              OR = 1.60, 95% CI [1.03, 2.48], SE(log OR) = 0.225
Pięć sposobów analizy w 1000 powtórzeń
R
# B451 – 1000 powtórzeń: te same dane analizowane pięcioma sposobami (prawdziwy OR = 2)
library(survival)
set.seed(4512)
R <- 1000
options(width = 110)

generuj_baze <- function(N = 12000) {
  wiek <- pmin(95, 65 + rexp(N, rate = 1 / 10))
  oddzial <- sample(c("interna", "neurologia", "ortopedia", "chirurgia"), N, replace = TRUE)
  zab_pozn <- rbinom(N, 1, plogis(-1.8 + .07 * (wiek - 75)))
  ef_lek <- c(interna = 0, neurologia = .5, ortopedia = -.4, chirurgia = -.2)[oddzial]
  ef_upadek <- c(interna = 0, neurologia = .6, ortopedia = .3, chirurgia = -.3)[oddzial]
  lek <- rbinom(N, 1, plogis(-1.3 + .07 * (wiek - 75) + ef_lek + .9 * zab_pozn))
  upadek <- rbinom(N, 1, plogis(-5.2 + log(2) * lek + .06 * (wiek - 75) + ef_upadek + 1.0 * zab_pozn))
  data.frame(wiek, wiek_gr = cut(wiek, c(65, 70, 75, 80, 85, Inf), right = FALSE),
             oddzial, zab_pozn, lek, upadek)
}

dobierz <- function(baza, m = 2) {
  przypadki <- which(baza$upadek == 1)
  wolne <- rep(TRUE, nrow(baza)); wolne[przypadki] <- FALSE
  klucz <- paste(baza$oddzial, baza$wiek_gr)
  wynik <- vector("list", length(przypadki))
  for (i in seq_along(przypadki)) {
    p <- przypadki[i]
    kand <- which(wolne & klucz == klucz[p])
    k <- if (length(kand) > m) sample(kand, m) else kand
    wolne[k] <- FALSE
    wynik[[i]] <- cbind(baza[c(p, k), ], zestaw = i, przypadek = c(1, rep(0, length(k))))
  }
  do.call(rbind, wynik)
}

wsp <- function(m) { s <- summary(m)$coefficients; c(s["lek", 1], s["lek", if (inherits(m, "glm")) 2 else 3]) }

jeden <- function() {
  baza <- generuj_baze()
  przyp <- which(baza$upadek == 1)
  los <- baza[c(przyp, sample(which(baza$upadek == 0), 2 * length(przyp))), ]   # kontrole losowe
  los$przypadek <- los$upadek
  d <- dobierz(baza)                                                            # kontrole dobrane
  rbind(A = wsp(glm(przypadek ~ lek, data = los, family = binomial)),
        B = wsp(glm(przypadek ~ lek + zab_pozn + wiek_gr + oddzial, data = los, family = binomial)),
        C = wsp(glm(przypadek ~ lek + zab_pozn, data = d, family = binomial)),
        D = wsp(clogit(przypadek ~ lek + zab_pozn + strata(zestaw), data = d)),
        E = wsp(glm(przypadek ~ lek + zab_pozn + wiek_gr + oddzial, data = d, family = binomial)))
}

wyn <- replicate(R, jeden())           # tablica: metoda × (b, se) × powtórzenie
nazwy <- c(A = "losowe kontrole, bez korekty",
           B = "losowe kontrole, regresja z korektą",
           C = "dobrane, zwykła regresja bez czynników doboru",
           D = "dobrane, warunkowa (clogit)",
           E = "dobrane, zwykła regresja z czynnikami doboru")
tab <- data.frame(metoda = nazwy,
  OR = round(exp(apply(wyn[, 1, ], 1, mean)), 2),
  SD_log = round(apply(wyn[, 1, ], 1, sd), 3),
  sr_SE = round(apply(wyn[, 2, ], 1, mean), 3),
  pokrycie = round(100 * rowMeans(wyn[, 1, ] - 1.96 * wyn[, 2, ] < log(2) &
                                  wyn[, 1, ] + 1.96 * wyn[, 2, ] > log(2)), 1),
  moc = round(100 * rowMeans(wyn[, 1, ] - 1.96 * wyn[, 2, ] > 0), 1), row.names = NULL)
print(tab, right = FALSE)

odch <- data.frame(metoda = rep(names(nazwy), R), or = exp(as.vector(wyn[, 1, ])))
write.csv(odch, "b451-symulacja-doboru.csv", row.names = FALSE)
Wynik w R
  metoda                                        OR   SD_log sr_SE pokrycie moc
1 losowe kontrole, bez korekty                  4.08 0.196  0.202  4.4     100.0
2 losowe kontrole, regresja z korektą           2.08 0.237  0.239 94.6      87.6
3 dobrane, zwykła regresja bez czynników doboru 1.75 0.197  0.205 91.1      79.8
4 dobrane, warunkowa (clogit)                   2.07 0.226  0.227 95.3      90.8
5 dobrane, zwykła regresja z czynnikami doboru  2.09 0.224  0.221 93.9      91.8
Nadmierne dopasowanie
R
# B451 – nadmierne dopasowanie: dobór po czynniku związanym tylko z narażeniem i po mediatorze
library(survival)
set.seed(4513)
R <- 1000
options(width = 110)

baza_nd <- function(N) {
  lekarz <- sample(1:8, N, replace = TRUE)                  # lekarz zlecający: wpływa tylko na narażenie
  ef <- c(-2, -1.4, -.8, -.3, .3, .8, 1.4, 2)[lekarz]
  lek <- rbinom(N, 1, plogis(-.4 + ef))
  sennosc <- rbinom(N, 1, plogis(-1.6 + 1.6 * lek))         # mediator: skutek leku, przyczyna upadku
  upadek <- rbinom(N, 1, plogis(-5 + log(1.5) * lek + log(2.5) * sennosc))
  data.frame(lekarz, lek, sennosc, upadek)
}

# Prawdziwy efekt łączny leku (bez warunkowania na senności) z bardzo dużej populacji
duza <- baza_nd(3e6)
or_prawdziwy <- with(duza, (mean(upadek[lek == 1]) / (1 - mean(upadek[lek == 1]))) /
                           (mean(upadek[lek == 0]) / (1 - mean(upadek[lek == 0]))))
cat(sprintf("Prawdziwy łączny OR leku w populacji: %.2f\n", or_prawdziwy))

dobor <- function(baza, zm, m = 2) {
  przyp <- which(baza$upadek == 1)
  wolne <- rep(TRUE, nrow(baza)); wolne[przyp] <- FALSE
  wynik <- vector("list", length(przyp))
  for (i in seq_along(przyp)) {
    kand <- which(wolne & baza[[zm]] == baza[[zm]][przyp[i]])
    k <- sample(kand, m); wolne[k] <- FALSE
    wynik[[i]] <- cbind(baza[c(przyp[i], k), ], zestaw = i, przypadek = c(1, 0, 0))
  }
  do.call(rbind, wynik)
}

jeden <- function() {
  b <- baza_nd(12000)
  pr <- which(b$upadek == 1)
  los <- b[c(pr, sample(which(b$upadek == 0), 2 * length(pr))), ]
  m0 <- summary(glm(upadek ~ lek, data = los, family = binomial))$coefficients["lek", 1:2]
  ml <- summary(clogit(przypadek ~ lek + strata(zestaw), data = dobor(b, "lekarz")))$coefficients["lek", c(1, 3)]
  ms <- summary(clogit(przypadek ~ lek + strata(zestaw), data = dobor(b, "sennosc")))$coefficients["lek", c(1, 3)]
  c(m0, ml, ms, n = length(pr))
}

w <- t(replicate(R, jeden()))
scen <- c("bez doboru, kontrole losowe", "dobór po lekarzu (związany tylko z narażeniem)", "dobór po senności (mediator)")
b <- w[, c(1, 3, 5)]; se <- w[, c(2, 4, 6)]
tab <- data.frame(scenariusz = scen,
  OR = round(exp(colMeans(b)), 2),
  SD_log = round(apply(b, 2, sd), 3),
  sr_SE = round(colMeans(se), 3),
  moc = round(100 * colMeans(b - 1.96 * se > 0), 1), row.names = NULL)
print(tab, right = FALSE)
cat(sprintf("Średnia liczba przypadków: %.0f\n", mean(w[, "n"])))
cat(sprintf("Ile razy większa próba jest potrzebna przy doborze po lekarzu: %.2f\n",
            (tab$SD_log[2] / tab$SD_log[1])^2))

write.csv(data.frame(scen = rep(scen, each = R), or = exp(as.vector(b))),
          "b451-nadmierne-dopasowanie.csv", row.names = FALSE, fileEncoding = "UTF-8")
write.csv(data.frame(or_prawdziwy = or_prawdziwy), "b451-or-prawdziwy.csv", row.names = FALSE)
Wynik w R
Prawdziwy łączny OR leku w populacji: 2.10
  scenariusz                                     OR   SD_log sr_SE moc
1 bez doboru, kontrole losowe                    2.10 0.206  0.208 95.1
2 dobór po lekarzu (związany tylko z narażeniem) 2.14 0.244  0.250 86.7
3 dobór po senności (mediator)                   1.50 0.217  0.225 42.1
Średnia liczba przypadków: 146
Ile razy większa próba jest potrzebna przy doborze po lekarzu: 1.40
Liczebność próby i rachunek błędów
R
# B451 – liczebność próby i rachunek błędów selekcji i przypominania (bez losowania)

# 1. Dobór bez parowania: narażenie wśród kontroli 30%, szukany OR = 2, alfa = .05, moc 80%
p0 <- .30; or <- 2
p1 <- or * p0 / (1 + p0 * (or - 1))
n11 <- ceiling(power.prop.test(p1 = p1, p2 = p0, power = .80)$n)
cat(sprintf("Narażenie wśród przypadków przy OR = 2: %.1f%%\n", 100 * p1))
wiele <- data.frame(kontroli_na_przypadek = 1:5)
wiele$przypadki <- ceiling(n11 * (1 + 1 / wiele$kontroli_na_przypadek) / 2)
wiele$kontrole <- wiele$przypadki * wiele$kontroli_na_przypadek
wiele$razem <- wiele$przypadki + wiele$kontrole
print(wiele, row.names = FALSE)

# 2. Pary 1:1: liczy się liczba par niezgodnych (test McNemara: H1 – udział par „przypadek narażony” = OR / (1 + OR))
pr <- or / (1 + or)
d <- ceiling((qnorm(.975) * .5 + qnorm(.80) * sqrt(pr * (1 - pr)))^2 / (pr - .5)^2)
cat(sprintf("Potrzebne pary niezgodne przy OR = 2: %d\n", d))
for (udzial in c(.45, .35, .25))
  cat(sprintf("Gdy niezgodnych jest %.0f%% par: potrzeba %d par\n", 100 * udzial, ceiling(d / udzial)))

# 3. Wpływ błędu selekcji i pomiaru na OR
or_z <- function(a, b) (a / (1 - a)) / (b / (1 - b))
cat(sprintf("Prawdziwy OR: %.2f\n", or_z(p1, p0)))
for (s in c(1.5, 0.7)) {
  odds <- p0 / (1 - p0) * s
  cat(sprintf("Narażeni %.1f razy tak chętnie wchodzą do kontroli: OR = %.2f\n", s, (p1 / (1 - p1)) / odds))
}
zgl <- function(p, czul, swoist) p * czul + (1 - p) * (1 - swoist)
cat(sprintf("Niezróżnicowany (czułość .80, swoistość .95 w obu grupach): OR = %.2f\n",
            or_z(zgl(p1, .80, .95), zgl(p0, .80, .95))))
cat(sprintf("Zróżnicowany (czułość .95 u przypadków, .75 u kontroli, swoistość 1): OR = %.2f\n",
            or_z(zgl(p1, .95, 1), zgl(p0, .75, 1))))
cat(sprintf("Zróżnicowany przy braku związku (30%%, 30%%): OR = %.2f\n",
            or_z(zgl(p0, .95, 1), zgl(p0, .75, 1))))
Wynik w R
Narażenie wśród przypadków przy OR = 2: 46.2%
 kontroli_na_przypadek przypadki kontrole razem
                     1       141      141   282
                     2       106      212   318
                     3        94      282   376
                     4        89      356   445
                     5        85      425   510
Potrzebne pary niezgodne przy OR = 2: 69
Gdy niezgodnych jest 45% par: potrzeba 154 par
Gdy niezgodnych jest 35% par: potrzeba 198 par
Gdy niezgodnych jest 25% par: potrzeba 276 par
Prawdziwy OR: 2.00
Narażeni 1.5 razy tak chętnie wchodzą do kontroli: OR = 1.33
Narażeni 0.7 razy tak chętnie wchodzą do kontroli: OR = 2.86
Niezróżnicowany (czułość .80, swoistość .95 w obu grupach): OR = 1.73
Zróżnicowany (czułość .95 u przypadków, .75 u kontroli, swoistość 1): OR = 2.69
Zróżnicowany przy braku związku (30%, 30%): OR = 1.37
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem survival; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8-6): Therneau, T. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed zebraniem danych sprawdź…
- Czy przypadek ma pisemną definicję, a Ty masz listę wszystkich kolejnych przypadków z okresu?
- Czy potrafisz nazwać bazę źródłową i wskazać, skąd losujesz kontrole?
- Czy o włączeniu kontroli nie decyduje narażenie?
- Czy jest dzień indeksowy i jedna definicja okna narażenia?
- Czy każda cecha doboru jest uzasadniona i nie jest skutkiem narażenia?
- Czy w planie analizy są czynniki doboru i lista zakłócaczy wybranych przed analizą?
- Czy narażenie mierzysz tak samo, a oceniający nie zna statusu osoby?
- Czy masz zgodę na dostęp do dokumentacji, jeśli wymaga jej uczelnia lub szpital?
Najczęstsze pytania
Czy po doborze kontroli trzeba użyć warunkowej regresji logistycznej?
Nie zawsze, ale czynniki doboru muszą być w analizie. Jeśli dobierano po cechach takich jak wiek i płeć, a dane nie są rzadkie, wystarczy zwykła regresja logistyczna z tymi cechami. Przy doborze po sąsiedztwie czy rodzinie zestaw trzeba traktować jak warstwę, a do tego służy regresja warunkowa. W symulacji obie poprawne analizy dały OR 2.07 i 2.09 przy prawdziwym 2.
Czym różni się dobór częstościowy od indywidualnego?
W doborze częstościowym grupy mają taki sam rozkład cechy, np. tyle samo osób w każdej grupie wieku, i nie ma numerów zestawów. W indywidualnym każdy przypadek ma własne kontrole i w danych jest kolumna z numerem zestawu. W obu wariantach czynnik doboru trzeba uwzględnić w analizie.
Skąd wziąć grupę kontrolną do pracy magisterskiej z pielęgniarstwa?
Najlepiej z tej samej bazy co przypadki: losuj z listy pacjentów tych samych oddziałów i okresu. Gdy listy nie ma, użyj pacjentów tego samego szpitala z rozpoznaniem niezwiązanym z narażeniem, zachowując ostrożność. Znajomi z grupy to dobór wygodny, a nie kontrole.
Co to jest nadmierne dopasowanie (overmatching)?
To dobór po cesze, po której nie należało dobierać. Dobór po cesze związanej tylko z narażeniem kosztuje precyzję: w symulacji do tej samej dokładności potrzeba 1.40 razy większej próby. Dobór po zmiennej pośredniczącej obciąża wynik: OR spadł z 2.10 do 1.50 i analiza tego nie naprawia.
Ile przypadków potrzeba do badania kliniczno-kontrolnego w pracy dyplomowej?
Dla OR = 2 i narażenia 30% wśród kontroli potrzeba około 141 przypadków i 141 kontroli (α = .05, moc 80%), a przy dwóch kontrolach na przypadek 106 przypadków i 212 kontroli. Dodawanie kontroli powyżej czterech daje już niewiele. W parach liczy się liczba par niezgodnych: dla OR = 2 potrzeba ich 69.
Powiązane hasła
Przeczytaj też
Porównanie grup istniejących
Pacjenci i osoby bez choroby, zawody, płeć: źródło każdej grupy, dobór grupy porównawczej, standaryzowane różnice, ANCOVA ostrożnie i gotowa metoda – z kodem R.
Czytaj →PoradnikRR, OR i NNT w pracy dyplomowej
Która miara do którego schematu badania, dlaczego OR różni się od RR przy częstym zdarzeniu, przedziały ufności i NNT przez nieskończoność – z gotowymi zdaniami i przykładem w R.
Czytaj →PoradnikAnaliza dokumentacji medycznej – badanie retrospektywne
Pytanie, kryteria, karta zbierania danych, „brak wpisu” ≠ „nie”, kappa na podpróbie kart, braki, zgody, STROBE i RECORD – z przykładem w R.
Czytaj →PoradnikBadanie kohortowe w pracy dyplomowej
Czas zero, czas obserwacji, osobolata, RR i IRR z regresji Poissona z offsetem oraz analiza utraty z obserwacji – na przykładzie 400 pacjentów w R.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →Planujesz badanie kliniczno-kontrolne do pracy?
Pomożemy zdefiniować bazę źródłową, ustalić, po czym dobierać kontrole, i policzyć dane w regresji warunkowej w R lub SPSS – z wyjaśnieniem, które pozwoli Ci samodzielnie obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Coughlin, S. S. (1990). Recall bias in epidemiologic studies. Journal of Clinical Epidemiology, 43(1), 87–91. https://doi.org/10.1016/0895-4356(90)90060-3
- Dupont, W. D. (1988). Power calculations for matched case-control studies. Biometrics, 44(4), 1157–1168. https://doi.org/10.2307/2531743
- Grimes, D. A., & Schulz, K. F. (2005). Compared to what? Finding controls for case-control studies. The Lancet, 365(9468), 1429–1433. https://doi.org/10.1016/s0140-6736(05)66379-9
- Mansournia, M. A., Hernán, M. A., & Greenland, S. (2013). Matched designs and causal diagrams. International Journal of Epidemiology, 42(3), 860–869. https://doi.org/10.1093/ije/dyt083 ● Otwarty dostęp: pełny tekst
- Pearce, N. (1993). What does the odds ratio estimate in a case-control study? International Journal of Epidemiology, 22(6), 1189–1192. https://doi.org/10.1093/ije/22.6.1189
- Pearce, N. (2016). Analysis of matched case-control studies. BMJ, 352, Article i969. https://doi.org/10.1136/bmj.i969 ● Otwarty dostęp
- Schulz, K. F., & Grimes, D. A. (2002). Case-control studies: Research in reverse. The Lancet, 359(9304), 431–434. https://doi.org/10.1016/s0140-6736(02)07605-5
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
- Wacholder, S., McLaughlin, J. K., Silverman, D. T., & Mandel, J. S. (1992). Selection of controls in case-control studies: I. Principles. American Journal of Epidemiology, 135(9), 1019–1028. https://doi.org/10.1093/oxfordjournals.aje.a116396
Cytowania BibTeX
@article{coughlin1990recall, author={Coughlin, Steven S.}, title={{Recall bias in epidemiologic studies}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={1}, pages={87--91}, doi={10.1016/0895-4356(90)90060-3}}@article{dupont1988power, author={Dupont, William D.}, title={{Power calculations for matched case-control studies}}, journal={Biometrics}, year={1988}, volume={44}, number={4}, pages={1157--1168}, doi={10.2307/2531743}}@article{grimes2005compared, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Compared to what? Finding controls for case-control studies}}, journal={The Lancet}, year={2005}, volume={365}, number={9468}, pages={1429--1433}, doi={10.1016/s0140-6736(05)66379-9}}@article{mansournia2013matched, author={Mansournia, Mohammad Ali and Hernán, Miguel A. and Greenland, Sander}, title={{Matched designs and causal diagrams}}, journal={International Journal of Epidemiology}, year={2013}, volume={42}, number={3}, pages={860--869}, doi={10.1093/ije/dyt083}}@article{pearce1993what, author={Pearce, Neil}, title={{What does the odds ratio estimate in a case-control study?}}, journal={International Journal of Epidemiology}, year={1993}, volume={22}, number={6}, pages={1189--1192}, doi={10.1093/ije/22.6.1189}}@article{pearce2016analysis, author={Pearce, Neil}, title={{Analysis of matched case-control studies}}, journal={BMJ}, year={2016}, volume={352}, eid={i969}, doi={10.1136/bmj.i969}}@article{schulz2002case, author={Schulz, Kenneth F. and Grimes, David A.}, title={{Case-control studies: Research in reverse}}, journal={The Lancet}, year={2002}, volume={359}, number={9304}, pages={431--434}, doi={10.1016/s0140-6736(02)07605-5}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}@article{wacholder1992selection, author={Wacholder, Sholom and McLaughlin, Joseph K. and Silverman, Debra T. and Mandel, Jack S.}, title={{Selection of controls in case-control studies: I. Principles}}, journal={American Journal of Epidemiology}, year={1992}, volume={135}, number={9}, pages={1019--1028}, doi={10.1093/oxfordjournals.aje.a116396}}