Czym jest błąd tabeli 2
W wielu pracach dyplomowych pierwsza tabela opisuje próbę (zob. Tabela 1 – charakterystyka próby), a druga pokazuje wyniki regresji. W tej drugiej jest jedna ekspozycja, czyli zmienna, o którą pyta hipoteza, i kilka zmiennych kontrolnych. Potem w rozdziale wyników pojawia się opis każdego wiersza: „palenie zwiększa ryzyko udaru o 5.6 punktu procentowego, każde 10 lat życia o 3.0 punktu, a wyższe wykształcenie chroni przed udarem”. Pierwsze zdanie może być prawdziwe. Dwa kolejne prawie na pewno nie znaczą tego, co sugerują.
Westreich i Greenland (2013) nazwali ten błąd błędem tabeli 2 (ang. Table 2 fallacy). Model, w którym zmienne kontrolne dobrano pod jedną ekspozycję, daje oszacowanie efektu tej ekspozycji. Współczynniki zmiennych kontrolnych łatwo wtedy wziąć za efekty całkowite. W rzeczywistości są to zwykle efekty bezpośrednie, a do tego mogą być zakłócone, nawet gdy efekt ekspozycji jest oszacowany poprawnie. Keele i in. (2020) dodają, że każdy współczynnik, któremu chcesz nadać sens przyczynowy, wymaga osobnego uzasadnienia. To, że jeden z nich je ma, nie przenosi się na pozostałe.
Ten wpis zakłada, że wiesz już, jak dobrać zmienne kontrolne. Procedurę opisuje wpis grafy przyczynowe (DAG), a krótszą wersję dla prac dyplomowych – czy kontrolować wiek i płeć. Tu zajmujemy się kolejnym krokiem: co wolno napisać o liczbach, które są już w tabeli.
Przykład: palenie, nadciśnienie i udar
Studentka zdrowia publicznego analizuje dane z badania kohortowego: 6000 osób w wieku 40–79 lat (M = 59.9) obserwowano przez 10 lat. Pytanie badawcze brzmi: o ile palenie tytoniu zwiększa ryzyko udaru mózgu? Paliło 29.5% osób, wyższe wykształcenie miało 36.5%, nadciśnienie 35.4%, a udar przeszło 13.4%. Dane są symulowane, więc znamy prawdziwe efekty. Można je pobrać w pliku CSV, a wszystkie liczby pochodzą z kodu na końcu wpisu.
Rysunek 1 pokazuje założony graf przyczynowy. Wiek i wykształcenie wpływają na palenie i na udar, więc są zmiennymi zakłócającymi. Nadciśnienie leży na drodze od palenia do udaru, czyli jest mediatorem. Jest też zmienna, której badaczka nie zmierzyła: niekorzystne warunki w dzieciństwie (U). Obniżają szansę na wyższe wykształcenie i same zwiększają ryzyko udaru.
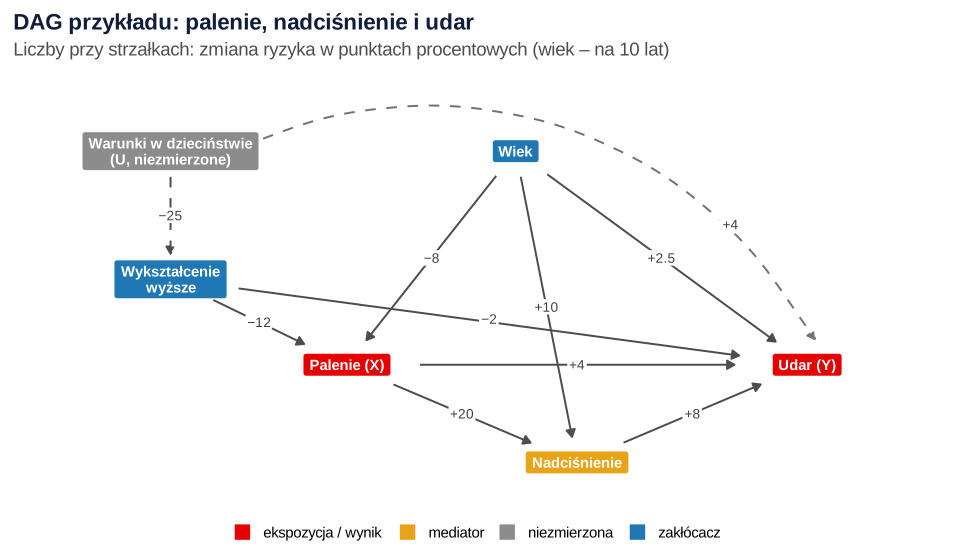
Z grafu wynikają prawdziwe efekty palenia. Efekt bezpośredni wynosi 4 punkty procentowe (pp). Do tego dochodzi droga przez nadciśnienie: palenie podnosi ryzyko nadciśnienia o 20 pp, a nadciśnienie ryzyko udaru o 8 pp, czyli 0.20 × 8 = 1.6 pp. Efekt całkowity palenia to więc 5.6 pp. Zgodnie z kryterium tylnych drzwi do jego oszacowania trzeba kontrolować wiek i wykształcenie, a nie wolno kontrolować nadciśnienia.
Udar to zmienna 0/1. Żeby współczynniki dało się wprost porównać z prawdziwymi efektami, liczymy model liniowy prawdopodobieństwa. Współczynnik jest wtedy różnicą ryzyka, którą podajemy w punktach procentowych. Wariancja wyniku 0/1 zależy od przewidywanego ryzyka, dlatego przedziały ufności liczymy z odpornych błędów standardowych HC3. W pracy częściej zobaczysz regresję logistyczną. Logika błędu tabeli 2 jest w niej taka sama.
Typowa tabela 2 i co znaczy każdy jej wiersz
Bez żadnej kontroli palacze mieli ryzyko udaru 16.46%, a niepalący 12.15%, czyli różnica wyniosła 4.31 pp, 95% CI [2.32, 6.30]. Zakłócenie przez wiek zaniża tu efekt, bo palą częściej osoby młodsze, a one rzadziej mają udar. Zakłócenie przez wykształcenie działa odwrotnie, ale słabiej. Model 1 zawiera palenie, wiek i wykształcenie, czyli dokładnie to, czego wymaga graf. Tabela pokazuje, co oznacza każdy jego współczynnik. Ostatnia kolumna to średnia z 1000 symulowanych powtórzeń badania. Pokazuje, wokół jakiej wartości układa się oszacowanie, gdy usuniemy przypadek.
| Wiersz tabeli | b [95% CI], pp | Co naprawdę szacuje | Prawdziwy efekt całkowity | Średnia z 1000 badań |
|---|---|---|---|---|
| Palenie (ekspozycja) | 5.56 [3.51, 7.60] | efekt całkowity palenia | 5.60 | 5.65 |
| Wiek (na 10 lat) | 3.04 [2.29, 3.79] | efekt wieku z pominięciem drogi przez palenie (3.30) | 2.85 | 3.32 |
| Wykształcenie wyższe | −2.89 [−4.64, −1.15] | efekt bezpośredni (−2.00) zniekształcony przez niezmierzone U | −2.67 | −2.89 |
Palenie. Współczynnik 5.56 pp trafia w efekt całkowity, bo zmienne kontrolne zamknęły wszystkie ścieżki zakłócające, a mediator został poza modelem. To jedyny wiersz, który odpowiada na pytanie badawcze.
Wiek. Współczynnik 3.04 pp to nie jest efekt całkowity starzenia się. Starsze osoby rzadziej palą, a palenie jest w modelu. Współczynnik wieku pokazuje więc różnicę ryzyka między osobami w różnym wieku, ale o tym samym statusie palenia. Odcina część efektu wieku, która biegnie przez palenie. Zostaje efekt bezpośredni i droga przez nadciśnienie, razem 3.30 pp. Średnia z symulacji (3.32) leży właśnie przy tej wartości, a nie przy efekcie całkowitym 2.85 pp. To dokładnie problem opisany przez Westreicha i Greenlanda (2013): w modelu ekspozycji współczynnik zmiennej zakłócającej jest efektem bezpośrednim.
Wykształcenie. Tu jest gorzej. Model zamyka ścieżki zakłócające palenia, ale nikt nie zadbał o zmienne zakłócające wykształcenia. Niezmierzone warunki w dzieciństwie wpływają i na wykształcenie, i na udar. Dlatego −2.89 pp nie jest ani efektem bezpośrednim (−2.00), ani całkowitym (−2.67). Osoby z wyższym wykształceniem częściej miały też lepsze warunki w dzieciństwie, więc wykształcenie „przejmuje” część ich ochronnego wpływu. Zdanie „wyższe wykształcenie chroni przed udarem o 2.9 pp” byłoby wnioskiem przyczynowym bez podstaw.
Współczynniki zmiennych kontrolnych mogą też wpływać na Twój wybór zmiennych. Nie usuwaj zmiennej z modelu tylko dlatego, że jej współczynnik jest „nieistotny” albo ma „dziwny” znak. Według grafu wiek i wykształcenie muszą zostać, bo bez nich efekt palenia byłby obciążony. Dobór zmiennych kontrolnych uzasadnia się założoną strukturą przyczynową (Wysocki i in., 2022), a nie wartością p.
Gdy do modelu trafia wszystko
Częsta pokusa to dodać do tabeli wszystkie zmienne z bazy. Model 2 zawiera dodatkowo nadciśnienie. Wynik palenia spada do 4.17 pp, 95% CI [2.10, 6.23]. To już nie jest efekt całkowity, tylko oszacowanie efektu bezpośredniego, którego prawdziwa wartość to 4.00 pp (średnia z symulacji 4.04). Kontrola mediatora odcięła drogę przez nadciśnienie. Schisterman i in. (2009) nazywają to błędem nadmiernej kontroli (ang. overadjustment bias) i podkreślają, że nie znika on w dużych próbach. Współczynnik wieku spadł do 2.30 pp, bo teraz odcięte są obie drogi pośrednie: przez palenie i przez nadciśnienie. Średnia z symulacji (2.51) odpowiada efektowi bezpośredniemu wieku, czyli 2.50 pp.
Paradoksalnie w modelu 2 najlepiej wypada wiersz zmiennej, która miała być tylko „kontrolą”. Współczynnik nadciśnienia (7.72 pp, 95% CI [5.72, 9.72]) dobrze szacuje jego prawdziwy efekt 8 pp. Zmienne zakłócające nadciśnienia to wiek i palenie, a obie są w modelu. Ta sama tabela daje więc poprawny efekt nadciśnienia i obciążony efekt palenia. Cinelli i in. (2024) opisują to ogólnie: dodanie zmiennej do regresji może sprawić, że współczynnik przestaje odpowiadać efektowi, który miał reprezentować. Znaczenie współczynnika zależy od tego, jakie inne zmienne są w modelu, a nie od jego miejsca w tabeli.
Osobny model dla każdej ekspozycji
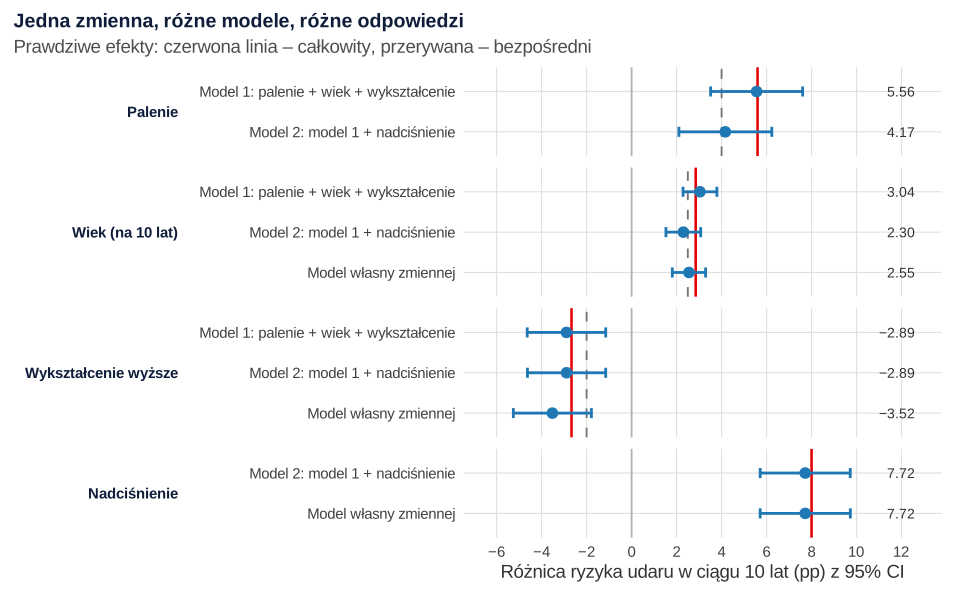
Jeśli chcesz odpowiedzieć na kilka pytań przyczynowych, każde potrzebuje własnego modelu i własnego zbioru zmiennych kontrolnych (Westreich i Greenland, 2013). Rysunek 2 pokazuje, co z tego wychodzi w przykładzie:
- Wiek. Na wiek nic w grafie nie wpływa, więc model ma tylko wiek. Wynik 2.55 pp, 95% CI [1.81, 3.29], odpowiada efektowi całkowitemu (2.85 pp; średnia z symulacji 2.86).
- Nadciśnienie. Zmiennymi zakłócającymi są wiek i palenie. Wynik 7.72 pp, 95% CI [5.72, 9.72], średnia z symulacji 8.02.
- Wykształcenie. Zmienną zakłócającą są warunki w dzieciństwie, których nie zmierzono. Model z samym wykształceniem daje −3.52 pp (średnia z symulacji −3.56), czyli związek wyraźnie silniejszy niż prawdziwe −2.67 pp. Z tych danych nie da się poprawnie oszacować efektu wykształcenia. Uczciwa odpowiedź to napisać to wprost albo przeprowadzić analizę wrażliwości.
Pojęcia efektu całkowitego i bezpośredniego są te same co w mediacji – zob. efekt całkowity i efekt bezpośredni. Jeśli w pracy naprawdę pytasz o efekt bezpośredni palenia, potrzebujesz analizy mediacji z jej własnymi założeniami, a nie po prostu dodatkowej zmiennej kontrolnej.
Jak opisać tabelę w pracy
Hünermund i Louw (2025) zalecają, by współczynników zmiennych kontrolnych nie interpretować, a w tabelach wyraźnie oznaczać je jako pozbawione interpretacji przyczynowej albo w ogóle je pomijać. Masz trzy uczciwe rozwiązania:
- Tylko ekspozycja. W tabeli podaj efekt palenia bez kontroli i z kontrolą, a w nocie wymień zmienne kontrolne. To najprostsza i najczystsza forma.
- Pełna tabela z notą. Gdy promotor chce zobaczyć wszystkie współczynniki, podaj je (wzór układu: tabela regresji w APA). W nocie napisz, że współczynniki zmiennych kontrolnych nie mają interpretacji przyczynowej, i nie opisuj ich w tekście.
- Osobne modele. Gdy masz kilka pytań, każdą ekspozycję oszacuj we własnym modelu i zbierz wyniki w jednej tabeli, jak niżej.
Becker (2005) zwrócił uwagę, że autorzy często nie uzasadniają włączenia zmiennych kontrolnych i niepełnie raportują wyniki. Dlatego w części metodologicznej podaj powód włączenia każdej zmiennej i zmienne celowo pominięte.
Tak może wyglądać tabela w wariancie z osobnymi modelami. Wiersz wykształcenia zostaje, ale bez liczby i z wyjaśnieniem.
Tabela 2
Efekty czynników na 10-letnie ryzyko udaru mózgu, każdy z osobnego modelu
| Czynnik | Zmienne kontrolne | Różnica ryzyka (pp) | 95% CI | p |
|---|---|---|---|---|
| Palenie (tak vs nie) | wiek, wykształcenie | 5.56 | [3.51, 7.60] | < .001 |
| Wiek (na 10 lat) | brak | 2.55 | [1.81, 3.29] | < .001 |
| Nadciśnienie (tak vs nie) | wiek, palenie | 7.72 | [5.72, 9.72] | < .001 |
| Wykształcenie wyższe | nie oszacowano – brak pomiaru zmiennej zakłócającej (warunki w dzieciństwie)a | |||
Uwaga. N = 6000. Modele liniowe prawdopodobieństwa, 95% CI z odpornych błędów standardowych HC3. Zmienne kontrolne dla każdego czynnika wyprowadzono z grafu przyczynowego (Rysunek 1). Dane symulowane.
a Model bez tej zmiennej dałby oszacowanie obciążone.
Jak opisać pozostałe elementy modelu (R², test całego modelu, założenia), pokazuje wpis regresja wieloraka krok po kroku. Jak przełożyć wyniki na wnioski bez przesady, pokazuje wpis jak napisać dyskusję wyników.
Najczęstsze błędy
- Opis każdego wiersza tabeli jak osobnego odkrycia. Zdania „wiek zwiększa ryzyko”, „wykształcenie chroni” w rozdziale wyników to klasyczny błąd tabeli 2.
- „Efekt niezależny od pozostałych zmiennych”. To sformułowanie brzmi ostrożnie, ale dla zmiennej kontrolnej zwykle oznacza efekt bezpośredni, a nie całkowity. Jeśli nie wiesz, który to efekt, nie pisz o efekcie.
- Mediator jako zmienna kontrolna. Dodanie nadciśnienia „dla pewności” zmniejszyło efekt palenia z 5.56 do 4.17 pp.
- Porównywanie siły predyktorów. Ranking standaryzowanych beta z jednego modelu porównuje wielkości, które odpowiadają na różne pytania (zob. współczynniki standaryzowane czy niestandaryzowane).
- Dobór zmiennych metodą krokową. Metoda krokowa wybiera zmienne według p, więc nie odróżni zmiennej zakłócającej od mediatora ani od zmiennej zderzeniowej.
- Mylenie zakłócania z modyfikacją efektu. Jeśli pytasz, czy efekt palenia jest inny u kobiet i mężczyzn, potrzebujesz interakcji, a nie kolejnej zmiennej kontrolnej (zob. czynnik zakłócający a modyfikator efektu).
Rohrer (2018) przypomina, że wnioski przyczynowe z danych obserwacyjnych zawsze zależą od założeń opartych na wiedzy dziedzinowej. Napisz więc w ograniczeniach badania, czego graf może nie uwzględniać. Podobne zniekształcenia powstają przy doborze próby – opisujemy je we wpisie błąd selekcji i zmienna zderzeniowa w praktyce. Jeśli promotor prosi o interpretację wszystkich współczynników, możemy w ramach pomocy w analizie dla studentów wspólnie przejść przez graf i przygotować argumenty.
Błąd tabeli 2 w R: kod i wynik
Przepis tworzy dane, zapisuje plik CSV i liczy wszystkie wyniki z tekstu i tabel. Uruchom go z folderu, w którym ma powstać podfolder z danymi (plik trafia do folderu nadrzędnego, ../). Rysunki powstały w osobnym skrypcie na tych samych danych.
Prawdziwe efekty, modele z różnymi zmiennymi kontrolnymi i 1000 powtórzeń
R
# B350 – błąd tabeli 2: palenie, nadciśnienie i udar mózgu (dane symulowane)
# Kohorta 6000 osób w wieku 40–79 lat obserwowanych przez 10 lat; wynik: udar (0/1).
# Model liniowy prawdopodobieństwa: współczynnik = różnica ryzyka (tu w punktach procentowych).
suppressPackageStartupMessages({ library(sandwich); library(lmtest) })
set.seed(3519)
N <- 6000

# Mechanizm generujący dane (DAG z Rysunku 1); U = niekorzystne warunki w dzieciństwie – NIEZMIERZONE
generuj <- function(N) {
  wiek <- round(runif(N, 40, 80), 1)
  wiek10 <- (wiek - 60) / 10                                   # wiek w dekadach, 0 = 60 lat
  U <- rbinom(N, 1, 0.30)
  wyzsze <- rbinom(N, 1, 0.45 - 0.25 * U)                       # wykształcenie wyższe (0/1)
  palenie <- rbinom(N, 1, 0.32 - 0.08 * wiek10 - 0.12 * wyzsze)
  nadcisnienie <- rbinom(N, 1, 0.30 + 0.10 * wiek10 + 0.20 * palenie)
  udar <- rbinom(N, 1, 0.08 + 0.025 * wiek10 + 0.04 * palenie + 0.08 * nadcisnienie -
                       0.02 * wyzsze + 0.04 * U)
  data.frame(wiek, wiek10, wyzsze, palenie, nadcisnienie, udar)
}
dane <- generuj(N)
write.csv(dane[, c("wiek", "wyzsze", "palenie", "nadcisnienie", "udar")], "../blad-tabeli-2-dane.csv",
          row.names = FALSE, fileEncoding = "UTF-8")

# Prawdziwe efekty wynikające z równań powyżej (punkty procentowe)
prawda <- c(palenie_calkowity = 100 * (0.04 + 0.20 * 0.08), palenie_bezposredni = 100 * 0.04,
            nadcisnienie_calkowity = 100 * 0.08,
            wiek_calkowity = 100 * (0.025 + 0.10 * 0.08 - 0.08 * (0.04 + 0.20 * 0.08)),
            wiek_bez_drogi_przez_palenie = 100 * (0.025 + 0.10 * 0.08), wiek_bezposredni = 100 * 0.025,
            wyzsze_calkowity = 100 * (-0.02 - 0.12 * (0.04 + 0.20 * 0.08)), wyzsze_bezposredni = 100 * -0.02)
print(round(prawda, 2))

# Opis próby
cat(sprintf("N = %d; wiek M = %.1f; palacze %.1f%%; wyższe %.1f%%; nadciśnienie %.1f%%; udar %.1f%%\n", nrow(dane),
            mean(dane$wiek), 100 * mean(dane$palenie), 100 * mean(dane$wyzsze),
            100 * mean(dane$nadcisnienie), 100 * mean(dane$udar)))
print(round(100 * tapply(dane$udar, dane$palenie, mean), 2))

# Pomocnik: współczynniki w pp z odpornym SE (HC3) i 95% CI
tabela <- function(model) {
  V <- vcovHC(model, type = "HC3"); ct <- coeftest(model, vcov. = V); ci <- coefci(model, vcov. = V)
  out <- data.frame(b = 100 * ct[, 1], SE = 100 * ct[, 2], dol = 100 * ci[, 1], gor = 100 * ci[, 2], p = ct[, 4])
  round(out[-1, ], 3)
}
modele <- list(
  M0_surowy      = udar ~ palenie,
  M1_dla_palenia = udar ~ palenie + wiek10 + wyzsze,
  M2_wszystko    = udar ~ palenie + wiek10 + wyzsze + nadcisnienie,
  M3_dla_wieku   = udar ~ wiek10,
  M4_dla_nadcisnienia = udar ~ nadcisnienie + palenie + wiek10,
  M5_wyzsze_surowy    = udar ~ wyzsze)
for (m in names(modele)) { cat("\n==", m, "==\n"); print(tabela(lm(modele[[m]], data = dane))) }

# 1000 powtórzeń badania: średnie oszacowania (pp) z każdego modelu
R <- 1000
wyniki <- t(replicate(R, {
  d <- generuj(N)
  c(M1_palenie = coef(lm(modele$M1_dla_palenia, d))[["palenie"]],
    M1_wiek    = coef(lm(modele$M1_dla_palenia, d))[["wiek10"]],
    M1_wyzsze  = coef(lm(modele$M1_dla_palenia, d))[["wyzsze"]],
    M2_palenie = coef(lm(modele$M2_wszystko, d))[["palenie"]],
    M2_wiek    = coef(lm(modele$M2_wszystko, d))[["wiek10"]],
    M2_wyzsze  = coef(lm(modele$M2_wszystko, d))[["wyzsze"]],
    M2_nadcisnienie = coef(lm(modele$M2_wszystko, d))[["nadcisnienie"]],
    M3_wiek    = coef(lm(modele$M3_dla_wieku, d))[["wiek10"]],
    M4_nadcisnienie = coef(lm(modele$M4_dla_nadcisnienia, d))[["nadcisnienie"]],
    M5_wyzsze  = coef(lm(modele$M5_wyzsze_surowy, d))[["wyzsze"]])
}))
cat("\nŚrednie z", R, "powtórzeń (pp) i SD oszacowań:\n")
print(round(data.frame(srednia = 100 * colMeans(wyniki), SD = 100 * apply(wyniki, 2, sd)), 2))
Wynik w R
           palenie_calkowity          palenie_bezposredni
                        5.60                         4.00
      nadcisnienie_calkowity               wiek_calkowity
                        8.00                         2.85
wiek_bez_drogi_przez_palenie             wiek_bezposredni
                        3.30                         2.50
            wyzsze_calkowity           wyzsze_bezposredni
                       -2.67                        -2.00
N = 6000; wiek M = 59.9; palacze 29.5%; wyższe 36.5%; nadciśnienie 35.4%; udar 13.4%
    0     1
12.15 16.46

== M0_surowy ==
            b    SE   dol   gor p
palenie 4.314 1.015 2.323 6.304 0

== M1_dla_palenia ==
             b    SE    dol    gor     p
palenie  5.558 1.043  3.513  7.603 0.000
wiek10   3.039 0.384  2.287  3.792 0.000
wyzsze  -2.895 0.890 -4.640 -1.149 0.001

== M2_wszystko ==
                  b    SE    dol    gor     p
palenie       4.168 1.054  2.103  6.233 0.000
wiek10        2.300 0.394  1.529  3.072 0.000
wyzsze       -2.889 0.887 -4.629 -1.150 0.001
nadcisnienie  7.717 1.021  5.716  9.719 0.000

== M3_dla_wieku ==
           b    SE   dol  gor p
wiek10 2.551 0.377 1.811 3.29 0

== M4_dla_nadcisnienia ==
                 b    SE   dol   gor p
nadcisnienie 7.720 1.022 5.715 9.724 0
palenie      4.595 1.040 2.556 6.635 0
wiek10       2.321 0.394 1.549 3.093 0

== M5_wyzsze_surowy ==
           b    SE    dol    gor p
wyzsze -3.52 0.885 -5.255 -1.785 0

Średnie z 1000 powtórzeń (pp) i SD oszacowań:
                srednia   SD
M1_palenie         5.65 0.99
M1_wiek            3.32 0.37
M1_wyzsze         -2.89 0.84
M2_palenie         4.04 1.00
M2_wiek            2.51 0.38
M2_wyzsze         -2.89 0.84
M2_nadcisnienie    8.02 0.97
M3_wiek            2.86 0.37
M4_nadcisnienie    8.02 0.97
M5_wyzsze         -3.56 0.84
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami sandwich i lmtest; rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Co to jest błąd tabeli 2 (Table 2 fallacy)?
To interpretowanie wszystkich współczynników z jednej tabeli regresji jak efektów przyczynowych. Nazwę zaproponowali Westreich i Greenland (2013). Model z zmiennymi kontrolnymi dobranymi pod jedną ekspozycję szacuje efekt tej ekspozycji, a współczynniki zmiennych kontrolnych są zwykle efektami bezpośrednimi albo są zakłócone.
Czy w tabeli regresji trzeba podawać współczynniki zmiennych kontrolnych?
Nie ma takiego obowiązku. Możesz podać tylko efekt ekspozycji, a zmienne kontrolne wymienić w nocie. Jeśli promotor chce pełnej tabeli, podaj wszystkie współczynniki, ale w nocie napisz, że współczynniki zmiennych kontrolnych nie mają interpretacji przyczynowej, i nie opisuj ich w tekście (Hünermund i Louw, 2025).
Jak zinterpretować współczynnik zmiennej kontrolnej w regresji wielorakiej?
Najbezpieczniej opisowo: to różnica w wyniku między osobami, które różnią się tą zmienną, a mają takie same wartości pozostałych zmiennych w modelu. Nie nazywaj go efektem tej zmiennej. Jeśli inna zmienna w modelu leży na drodze od zmiennej kontrolnej do wyniku, współczynnik pomija tę drogę, a jeśli zmienna kontrolna ma własne niezmierzone zakłócenia, jest obciążony.
Dlaczego efekt głównej zmiennej zmalał po dodaniu kolejnej zmiennej kontrolnej?
Jedną z przyczyn jest kontrola mediatora, czyli zmiennej leżącej między ekspozycją a wynikiem. W przykładzie dodanie nadciśnienia zmniejszyło efekt palenia z 5.56 do 4.17 punktu procentowego, bo model przestał szacować efekt całkowity, a zaczął bezpośredni. To błąd nadmiernej kontroli (Schisterman i in., 2009).
Czy błąd tabeli 2 dotyczy też regresji logistycznej i ilorazów szans?
Tak. Westreich i Greenland (2013) opisali go właśnie na przykładzie ilorazów szans. W regresji logistycznej dochodzi jeszcze to, że iloraz szans może się zmienić po dodaniu zmiennej powiązanej z wynikiem nawet bez zakłócenia, więc porównywanie OR z różnych modeli wymaga dodatkowej ostrożności.
Powiązane hasła
Przeczytaj też
Kolejność pytań i post-treatment bias
Co mierzyć przed bodźcem, gdzie dać sprawdzenie manipulacji i dlaczego kontrola zmiennej po bodźcu może odwrócić znak efektu.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikCzy kontrolować wiek i płeć?
Kiedy wiek i płeć usuwają zakłócenie, kiedy tylko zwiększają precyzję, a kiedy szkodzą – z przykładem czterech modeli w R i wzorem opisu.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →Promotor chce interpretacji wszystkich współczynników?
Sprawdzimy graf przyczynowy i dobór zmiennych kontrolnych, wyjaśnimy, co znaczy każdy współczynnik, i pomożemy ułożyć tabelę oraz opis wyników tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Becker, T. E. (2005). Potential problems in the statistical control of variables in organizational research: A qualitative analysis with recommendations. Organizational Research Methods, 8(3), 274–289. https://doi.org/10.1177/1094428105278021
- Cinelli, C., Forney, A., & Pearl, J. (2024). A crash course in good and bad controls. Sociological Methods & Research, 53(3), 1071–1104. https://doi.org/10.1177/00491241221099552 ● Otwarty dostęp: pełny tekst
- Hünermund, P., & Louw, B. (2025). On the nuisance of control variables in causal regression analysis. Organizational Research Methods, 28(1), 138–151. https://doi.org/10.1177/10944281231219274 ● Otwarty dostęp
- Keele, L., Stevenson, R. T., & Elwert, F. (2020). The causal interpretation of estimated associations in regression models. Political Science Research and Methods, 8(1), 1–13. https://doi.org/10.1017/psrm.2019.31
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Schisterman, E. F., Cole, S. R., & Platt, R. W. (2009). Overadjustment bias and unnecessary adjustment in epidemiologic studies. Epidemiology, 20(4), 488–495. https://doi.org/10.1097/ede.0b013e3181a819a1 ● Otwarty dostęp: pełny tekst
- Westreich, D., & Greenland, S. (2013). The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients. American Journal of Epidemiology, 177(4), 292–298. https://doi.org/10.1093/aje/kws412 ● Otwarty dostęp
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{becker2005potential, author={Becker, Thomas E.}, title={{Potential problems in the statistical control of variables in organizational research: A qualitative analysis with recommendations}}, journal={Organizational Research Methods}, year={2005}, volume={8}, number={3}, pages={274--289}, doi={10.1177/1094428105278021}}@article{cinelli2024crash, author={Cinelli, Carlos and Forney, Andrew and Pearl, Judea}, title={{A crash course in good and bad controls}}, journal={Sociological Methods \& Research}, year={2024}, volume={53}, number={3}, pages={1071--1104}, doi={10.1177/00491241221099552}}@article{hunermund2025nuisance, author={H{\"u}nermund, Paul and Louw, Beyers}, title={{On the nuisance of control variables in causal regression analysis}}, journal={Organizational Research Methods}, year={2025}, volume={28}, number={1}, pages={138--151}, doi={10.1177/10944281231219274}}@article{keele2020causal, author={Keele, Luke and Stevenson, Randolph T. and Elwert, Felix}, title={{The causal interpretation of estimated associations in regression models}}, journal={Political Science Research and Methods}, year={2020}, volume={8}, number={1}, pages={1--13}, doi={10.1017/psrm.2019.31}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{schisterman2009overadjustment, author={Schisterman, Enrique F. and Cole, Stephen R. and Platt, Robert W.}, title={{Overadjustment bias and unnecessary adjustment in epidemiologic studies}}, journal={Epidemiology}, year={2009}, volume={20}, number={4}, pages={488--495}, doi={10.1097/ede.0b013e3181a819a1}}@article{westreich2013table, author={Westreich, Daniel and Greenland, Sander}, title={{The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients}}, journal={American Journal of Epidemiology}, year={2013}, volume={177}, number={4}, pages={292--298}, doi={10.1093/aje/kws412}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}