Co to jest metoda krokowa?
Metoda krokowa (regresja krokowa, selekcja krokowa, ang. stepwise regression, w SPSS opcja Stepwise) to automatyczna procedura doboru predyktorów w regresji wielorakiej, która w każdym kroku może zmienną dodać albo usunąć. Zaczyna od pustego modelu. Najpierw dodaje predyktor, który najbardziej poprawia dopasowanie, o ile spełnia kryterium wejścia. Potem sprawdza, czy któraś ze zmiennych już obecnych w modelu nie straciła znaczenia po dołączeniu nowej. Jeśli tak, usuwa ją.
Nazwa bywa używana szeroko – „krokowo” nazywa się czasem każdą automatyczną selekcję. W węższym, programowym znaczeniu metoda krokowa to połączenie selekcji postępującej (tylko dodawanie) i eliminacji wstecznej (tylko usuwanie). Nie myl jej z regresją hierarchiczną, w której kolejność bloków ustala badacz, a nie algorytm.
Dwa progi: wejście i usunięcie
Metoda krokowa potrzebuje dwóch kryteriów. W SPSS zmienna wchodzi do modelu, gdy p jej współczynnika jest mniejsze niż .05, a wypada, gdy p przekroczy .10. Próg usunięcia musi być łagodniejszy od progu wejścia. Gdyby oba były równe, zmienna o p tuż przy granicy mogłaby w kolejnych krokach na przemian wchodzić i wypadać. Zamiast wartości p można używać statystyki F (przy jednej zmiennej F = t²) albo kryterium informacyjnego. Funkcja step() w R dodaje lub usuwa zmienną wtedy, gdy obniża to AIC (zob. AIC i BIC). AIC to łagodniejsze kryterium niż p < .05, więc zwykle zostawia w modelu więcej zmiennych.
Usunięcie zmiennej wcześniej dodanej zdarza się, gdy predyktory są skorelowane. Zmienna A wchodzi jako pierwsza, bo najsilniej koreluje z wynikiem. Później wchodzą B i C, które razem przejmują wariancję wspólną z A. W modelu z B i C zmienna A traci istotność i procedura ją usuwa. To jedyna rzecz, której selekcja postępująca nie potrafi, ale nie rozwiązuje ona głównych problemów automatycznej selekcji.
Co jest nie tak z metodą krokową
Thompson (1995) wskazał trzy zasadnicze wady. Programy liczą stopnie swobody tak, jakby testowano tylko zmienne z modelu końcowego, a nie wszystkich kandydatów, co zwiększa szansę fałszywej istotności. Procedura nie znajduje najlepszego zestawu zmiennych danej wielkości, bo sprawdza tylko jedną ścieżkę dodawania i usuwania. Wreszcie wynik wykorzystuje przypadkowe cechy próby i słabo się replikuje. W haśle regresja hierarchiczna pokazujemy symulację: na danych bez żadnego związku selekcja w ponad połowie zbiorów „znalazła” istotny predyktor.
Mimo tej krytyki metoda jest wciąż popularna. Whittingham i in. (2006) ustalili, że w 57% z 65 artykułów z 2004 roku, w których stosowano regresję wielokrotną w trzech czołowych czasopismach ekologicznych i behawioralnych, użyto procedury krokowej. Na danych z czterech lat pokazali też, że modele krokowe wyraźnie różniły się między latami. Ten drugi problem – niestabilność wyboru – jest tematem przykładu poniżej.
Przykład: ta sama procedura, 99 różnych modeli
W badaniu 120 studentów (dane symulowane) wynikiem były objawy depresji (PHQ-9, 0–27). Kandydatów na predyktory było dziesięć: samotność, jakość snu, stres, ruminacje, aktywność fizyczna, czas przed ekranem, wsparcie społeczne, dochód, wiek i liczba rodzeństwa. W modelu, z którego wygenerowano dane, objawy zależały bezpośrednio od czterech zmiennych: samotności, jakości snu, stresu i aktywności fizycznej. Część pozostałych zmiennych korelowała z nimi przez wspólny czynnik obciążenia.
Metoda krokowa (wejście p < .05, usunięcie p > .10) wprowadziła w czterech krokach samotność, stres, jakość snu i wsparcie. Ostatnia z nich weszła z p = .046. Żadna zmienna nie została później usunięta. Model końcowy miał R² = .445 (skorygowane R² = .425):
| Predyktor | b | SE | t | p |
|---|---|---|---|---|
| Samotność | 1.72 | 0.34 | 5.04 | < .001 |
| Stres | 1.25 | 0.33 | 3.83 | < .001 |
| Jakość snu | −0.93 | 0.36 | −2.58 | .011 |
| Wsparcie społeczne | −0.59 | 0.29 | −2.01 | .046 |
Model wygląda przekonująco, ale zawiera jedną zmienną bez własnego efektu (wsparcie) i pomija jedną prawdziwą (aktywność fizyczną). Funkcja step() z kryterium AIC wybrała na tych samych danych sześć zmiennych: dodatkowo aktywność fizyczną i czas przed ekranem. Inna reguła dała więc inny model.
Ważniejsze jest to, co się dzieje przy niewielkiej zmianie danych. Powtórzyliśmy tę samą procedurę w 500 próbach bootstrap, czyli losowaniach ze zwracaniem ze 120 osób. Powstało 99 różnych modeli końcowych, a najczęstszy z nich (samotność, jakość snu, stres i wsparcie) wystąpił tylko w 8.6% prób. Samotność weszła do modelu w 100% prób, a stres – w 90%. Jakość snu wybrano jednak tylko w 58% prób, a aktywność fizyczną, która naprawdę wpływa na wynik, w 41%. Wsparcie i czas przed ekranem, bez własnego efektu, trafiały do modelu prawie równie często – w 48% i 40% prób (rysunek 1).
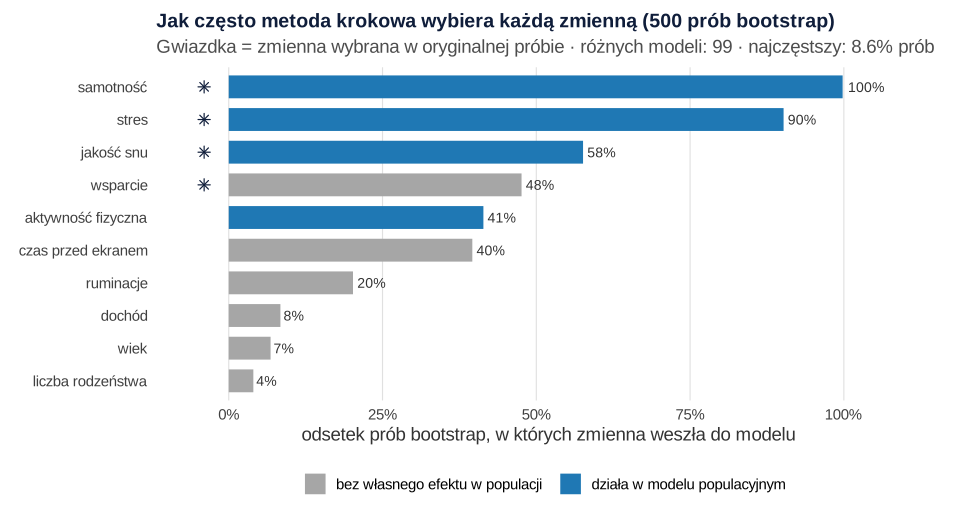
Wniosek praktyczny: pojedynczy model z metody krokowej jest jednym z wielu prawie równie prawdopodobnych wyników. Heinze i in. (2018) zalecają, by przy każdej selekcji raportować jej stabilność – częstość wyboru zmiennych w próbach bootstrap i częstość najczęstszych modeli – zamiast przedstawiać jeden model jako odkrycie.
Kiedy (wyjątkowo) i jak jej używać
- Do testowania hipotez – nie. Zaplanowane predyktory wprowadź naraz (metoda wprowadzania) albo blokami w kolejności wynikającej z teorii (regresja hierarchiczna).
- Do eksploracji – ostrożnie. Podaj liczbę kandydatów, oba progi, model końcowy i analizę stabilności. Wynik traktuj jako hipotezę do sprawdzenia w nowej próbie.
- Do predykcji – lepiej inaczej. Derksen i Keselman (1992) pokazali, że liczba zmiennych szumowych w modelu rośnie z liczbą kandydatów. Przy wielu kandydatach lepsze są metody z karaniem i walidacja krzyżowa (zob. data mining).
- Zawsze sprawdź współliniowość. To głównie ona decyduje o tym, która z podobnych zmiennych „wygra” w danej próbie.
Jak opisać metodę krokową w pracy
Napisz wprost, że dobór był automatyczny, podaj kryteria i liczbę kandydatów oraz dodaj zdanie o stabilności. Wzór dla przykładu:
Jak przygotować tabelę współczynników, pokazujemy w haśle tabela regresji w APA. Gdy recenzent zakwestionuje metodę krokową, pomogą wzory odpowiedzi z poradnika zarzuty recenzentów do statystyki.
Metoda krokowa i jej stabilność w R
Kod tworzy dane, wykonuje metodę krokową z progami jak w SPSS, porównuje wynik z step() (AIC) i powtarza selekcję w 500 próbach bootstrap. Obliczenia trwają kilka sekund.
Selekcja krokowa, AIC i analiza stabilności
R
# Dane symulowane: 120 studentów, objawy depresji (PHQ-9, 0–27) i 10 kandydatów na predyktory
# (wyniki standaryzowane; część kandydatów jest ze sobą skorelowana przez wspólny czynnik „obciążenie”).
set.seed(204)
N <- 120
obc <- rnorm(N)   # wspólny czynnik
kor <- function(w) w * obc + sqrt(1 - w^2) * rnorm(N)
dane <- data.frame(samotnosc = kor(.6), sen = -kor(.5), stres = kor(.7), ruminacje = kor(.7),
                   aktywnosc = -kor(.3), ekran = kor(.3), wsparcie = -kor(.4),
                   dochod = rnorm(N), wiek = rnorm(N), rodzenstwo = rnorm(N))
dane$depresja <- round(pmin(pmax(9 + 1.6 * dane$samotnosc - 1.3 * dane$sen + 1.2 * dane$stres -
                                   0.6 * dane$aktywnosc + rnorm(N, sd = 3.6), 0), 27))
kandydaci <- setdiff(names(dane), "depresja")
fp <- function(p) ifelse(p < .001, "< .001", paste("=", sub("^0", "", sprintf("%.3f", p))))

# Metoda krokowa jak w SPSS: wejście przy p < .05, usunięcie przy p > .10
krokowa <- function(dane, y, zmienne, p_wej = .05, p_usun = .10, pokaz = TRUE) {
  w <- character(0)
  for (i in 1:50) {
    reszta <- setdiff(zmienne, w); zmiana <- FALSE
    if (length(reszta) > 0) {
      p <- sapply(reszta, function(v) coef(summary(lm(reformulate(c(w, v), y), data = dane)))[v, 4])
      if (min(p) < p_wej) {
        w <- c(w, names(which.min(p))); zmiana <- TRUE
        if (pokaz) cat(sprintf("Krok %d: wchodzi %s (p %s)\n", i, names(which.min(p)), fp(min(p))))
      }
    }
    if (length(w) > 0) {
      pw <- coef(summary(lm(reformulate(w, y), data = dane)))[w, 4]
      if (max(pw) > p_usun) {
        if (pokaz) cat(sprintf("Krok %d: wypada %s (p %s)\n", i, names(which.max(pw)), fp(max(pw))))
        w <- setdiff(w, names(which.max(pw))); zmiana <- TRUE
      }
    }
    if (!zmiana) break
  }
  w
}

wybrane <- krokowa(dane, "depresja", kandydaci)
m <- lm(reformulate(wybrane, "depresja"), data = dane)
round(coef(summary(m)), 3)
round(c(R2 = summary(m)$r.squared, R2_skor = summary(m)$adj.r.squared), 3)

# Dla porównania: step() z kryterium AIC (start od pustego modelu, ruch w obie strony)
m_aic <- step(lm(depresja ~ 1, data = dane), scope = reformulate(kandydaci, "depresja"),
              direction = "both", trace = 0)
names(coef(m_aic))[-1]

# Stabilność selekcji: ta sama procedura w 500 próbach bootstrap
set.seed(2041)
B <- 500
wyniki <- replicate(B, {
  d <- dane[sample(N, replace = TRUE), ]
  paste(sort(krokowa(d, "depresja", kandydaci, pokaz = FALSE)), collapse = " + ")
})
czestosc <- sapply(kandydaci, function(v) mean(grepl(paste0("\\b", v, "\\b"), wyniki)))
round(sort(czestosc, decreasing = TRUE), 2)          # odsetek prób, w których zmienna weszła do modelu
length(unique(wyniki))                               # liczba różnych modeli końcowych
head(sort(table(wyniki), decreasing = TRUE), 5)      # najczęstsze modele
round(max(table(wyniki)) / B, 3)                     # udział najczęstszego modelu
Wynik w R
Krok 1: wchodzi samotnosc (p < .001)
Krok 2: wchodzi stres (p < .001)
Krok 3: wchodzi sen (p = .009)
Krok 4: wchodzi wsparcie (p = .046)
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    9.203      0.296  31.134    0.000
samotnosc      1.721      0.341   5.044    0.000
stres          1.252      0.327   3.831    0.000
sen           -0.927      0.359  -2.584    0.011
wsparcie      -0.591      0.293  -2.014    0.046
     R2 R2_skor
  0.445   0.425
[1] "samotnosc" "stres"     "sen"       "wsparcie"  "ekran"     "aktywnosc"
 samotnosc      stres        sen   wsparcie  aktywnosc      ekran  ruminacje
      1.00       0.90       0.58       0.48       0.41       0.40       0.20
    dochod       wiek rodzenstwo
      0.08       0.07       0.04
[1] 99
wyniki
            samotnosc + sen + stres + wsparcie
                                            43
                       samotnosc + sen + stres
                                            38
aktywnosc + samotnosc + sen + stres + wsparcie
                                            26
                 aktywnosc + samotnosc + stres
                                            24
                             samotnosc + stres
                                            24
[1] 0.086
SPSS
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 (funkcje bazowe i pakiet stats); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Najlepsze predyktory” w tytule wyników. Metoda krokowa nie znajduje najlepszego zestawu, tylko jeden z wielu, i to zależny od przypadku (Thompson, 1995).
- Interpretowanie, że zmienna pominięta „nie ma znaczenia”. W przykładzie aktywność fizyczna wpływała na wynik, a nie weszła do modelu. Gdy predyktory są skorelowane, o wyborze decyduje często przypadek.
- Brak informacji o kandydatach i progach – bez nich nie da się ocenić, ile testów wykonano po drodze.
- Stosowanie metody krokowej do zmiennych, które badacz chciał kontrolować. Zmienne kontrolne i zaplanowane predyktory wprowadź wymuszonym blokiem, a selekcję – jeśli w ogóle – stosuj tylko do reszty.
- Zestawienie metody krokowej z dowodem przyczynowym. Wybór zmiennej przez algorytm oznacza tylko, że w tej próbie poprawiała dopasowanie.
- Raportowanie R² modelu końcowego bez korekty. R² po selekcji jest zawyżone; podaj co najmniej skorygowane R², a najlepiej wynik walidacji.
Najczęstsze pytania
Na czym polega metoda krokowa w regresji?
Program zaczyna od pustego modelu i dodaje predyktor o najmniejszym p, jeśli spełnia kryterium wejścia (w SPSS p < .05). Po każdym dodaniu sprawdza, czy któraś zmienna w modelu nie przekroczyła progu usunięcia (p > .10), i ewentualnie ją usuwa. Kończy, gdy żadna zmiana nie jest możliwa.
Dlaczego w metodzie krokowej próg usunięcia jest wyższy niż próg wejścia?
Gdyby oba progi były równe, zmienna o p tuż przy granicy mogłaby w kolejnych krokach na przemian wchodzić do modelu i z niego wypadać. Łagodniejszy próg usunięcia (np. .10 przy wejściu .05) zapobiega takiemu zapętleniu.
Czy regresja krokowa jest dopuszczalna w pracy magisterskiej?
Do testowania hipotez – nie, bo zawyża istotność i daje modele, które słabo się replikują (Thompson, 1995). W eksploracji można ją zastosować, jeśli opiszesz kandydatów, progi i stabilność wyboru, a model nazwiesz eksploracyjnym. Bezpieczniej wprowadzić zaplanowane predyktory naraz albo blokami (regresja hierarchiczna).
Czym różni się step() w R od metody krokowej w SPSS?
SPSS dodaje i usuwa zmienne według progów p (domyślnie .05 i .10), a step() w R według kryterium AIC. AIC jest łagodniejsze, więc zwykle zostawia więcej zmiennych – w przykładzie na tej stronie sześć zamiast czterech.
Jak sprawdzić stabilność modelu z metody krokowej?
Powtórz całą procedurę w kilkuset próbach bootstrap i policz, jak często każda zmienna wchodzi do modelu oraz jak często pojawia się najczęstszy model. Jeśli zmienna jest wybierana w mniej niż połowie prób, jej obecność w modelu z oryginalnej próby jest w dużej mierze przypadkowa.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak wybrać zmienne do regresji
Dlaczego nie metoda krokowa i nie wybór według p: cel analizy, DAG, liczba predyktorów, LASSO z walidacją krzyżową i wzór opisu doboru zmiennych.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Derksen, S., & Keselman, H. J. (1992). Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables. British Journal of Mathematical and Statistical Psychology, 45(2), 265–282. https://doi.org/10.1111/j.2044-8317.1992.tb00992.x
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067 ● Otwarty dostęp
- Thompson, B. (1995). Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial. Educational and Psychological Measurement, 55(4), 525–534. https://doi.org/10.1177/0013164495055004001
- Whittingham, M. J., Stephens, P. A., Bradbury, R. B., & Freckleton, R. P. (2006). Why do we still use stepwise modelling in ecology and behaviour? Journal of Animal Ecology, 75(5), 1182–1189. https://doi.org/10.1111/j.1365-2656.2006.01141.x ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{derksen1992backward, author={Derksen, Shelley and Keselman, H. J.}, title={{Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables}}, journal={British Journal of Mathematical and Statistical Psychology}, year={1992}, volume={45}, number={2}, pages={265--282}, doi={10.1111/j.2044-8317.1992.tb00992.x}}@article{heinze2018variable, author={Heinze, Georg and Wallisch, Christine and Dunkler, Daniela}, title={{Variable selection – A review and recommendations for the practicing statistician}}, journal={Biometrical Journal}, year={2018}, volume={60}, number={3}, pages={431--449}, doi={10.1002/bimj.201700067}}@article{thompson1995stepwise, author={Thompson, Bruce}, title={{Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial}}, journal={Educational and Psychological Measurement}, year={1995}, volume={55}, number={4}, pages={525--534}, doi={10.1177/0013164495055004001}}@article{whittingham2006why, author={Whittingham, Mark J. and Stephens, Philip A. and Bradbury, Richard B. and Freckleton, Robert P.}, title={{Why do we still use stepwise modelling in ecology and behaviour?}}, journal={Journal of Animal Ecology}, year={2006}, volume={75}, number={5}, pages={1182--1189}, doi={10.1111/j.1365-2656.2006.01141.x}}