Co to jest metoda eliminacji wstecznej?
Metoda eliminacji wstecznej (eliminacja wsteczna, selekcja wsteczna, ang. backward elimination, w SPSS opcja Backward) to automatyczny sposób doboru predyktorów w regresji wielorakiej, który zaczyna od modelu ze wszystkimi kandydatami i usuwa je po jednym. W każdym kroku program szuka predyktora o najsłabszym wkładzie – największej wartości p (najmniejszym F usunięcia) – i wyrzuca go, jeśli przekracza ustalony próg. Potem szacuje model od nowa i powtarza sprawdzenie. Procedura kończy się, gdy wszystkie pozostałe predyktory spełniają kryterium pozostania.
To jedna z trzech klasycznych procedur automatycznej selekcji, obok selekcji postępującej, która idzie w przeciwną stronę, i metody krokowej, która łączy dodawanie z usuwaniem. Różni się od nich punktem startu: każda decyzja zapada w modelu, w którym są jeszcze pozostałe zmienne. Ta cecha jest jej główną zaletą i zarazem źródłem ograniczeń, które opisujemy niżej.
Jak działa algorytm krok po kroku
- Oszacuj model ze wszystkimi k kandydatami na predyktory.
- Dla każdego predyktora policz test jego wkładu przy kontroli pozostałych. Przy jednej zmiennej F usunięcia równa się kwadratowi statystyki t współczynnika, więc kryterium F i kryterium p prowadzą do tych samych decyzji.
- Jeśli najsłabszy predyktor ma p większe od progu usunięcia, usuń go. W SPSS domyślny próg usunięcia to p = .10; w R funkcja
step(..., direction = "backward")używa zamiast tego kryterium AIC (zob. AIC i BIC). - Oszacuj model bez tej zmiennej i wróć do punktu 2.
- Zatrzymaj się, gdy żadna zmienna nie przekracza progu.
Usunięta zmienna nie wraca już do modelu. Tym eliminacja wsteczna różni się od metody krokowej, która w każdym kroku sprawdza także, czy któraś z wcześniej odrzuconych zmiennych nie zasługuje na powrót.
W tym wzorze p oznacza liczbę predyktorów w bieżącym modelu. Licznik to spadek R² po usunięciu zmiennej Xj, czyli kwadrat jej korelacji semicząstkowej z wynikiem.
Dlaczego wsteczna, a nie postępująca? Zmienne, które działają razem
Mantel (1970) wskazywał zalety procedury, w której zmienne odrzuca się po jednej z pełnego zestawu, zamiast budować model od zera. Jedna z nich jest szczególnie ważna w psychologii: każda zmienna jest oceniana w obecności pozostałych. Ma to znaczenie, gdy dwie skorelowane zmienne działają w przeciwnych kierunkach. Każda z osobna słabo koreluje z wynikiem, ale razem wyjaśniają sporo wariancji – to klasyczna supresja. Selekcja postępująca ocenia zmienne pojedynczo, na początku nawet bez drugiej zmiennej z pary, więc może nie wpuścić żadnej z nich. Eliminacja wsteczna zaczyna z obiema zmiennymi w modelu i widzi ich łączny efekt.
Derksen i Keselman (1992) porównali w badaniu Monte Carlo selekcję wsteczną, postępującą i krokową. Odsetek prawdziwych predyktorów w modelu końcowym zależał przede wszystkim od korelacji między predyktorami, a liczba zmiennych szumowych w modelu – od liczby kandydatów. Wielkość próby miała dla trafnego wyboru mniejsze znaczenie praktyczne. Przewaga eliminacji wstecznej w scenariuszu z supresją nie zmienia więc wniosku ogólnego: żadna z trzech procedur nie gwarantuje wyboru właściwego zestawu zmiennych.
Przykład: zadowolenie z pracy i osiem kandydatów na predyktory
W badaniu 160 pracowników (dane symulowane) wynikiem było zadowolenie z pracy (1–7). Kandydatów na predyktory było osiem: stres w pracy, zaangażowanie, wsparcie przełożonego, autonomia, staż, wiek, czas dojazdu i liczba nadgodzin (wyniki standaryzowane). Stres i zaangażowanie korelowały ze sobą silnie, r = .77. Ich proste korelacje z zadowoleniem były jednak bliskie zera: −.06 i .10.
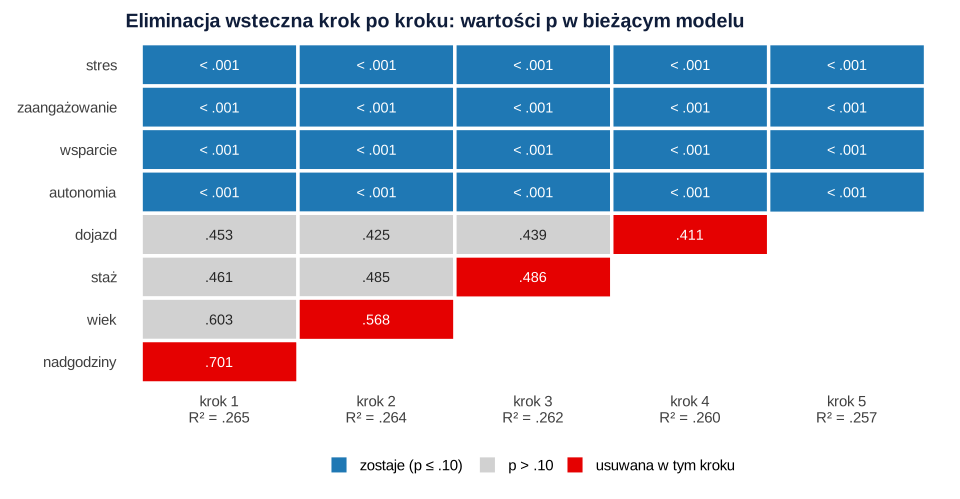
Eliminacja wsteczna z progiem p > .10 potrzebowała pięciu kroków (rysunek 1). Kolejno usunęła nadgodziny (p = .701), wiek (p = .568), staż (p = .486) i czas dojazdu (p = .411). W piątym kroku najsłabszy był stres, z p < .001, więc procedura się zatrzymała. R² spadło przy tym zaledwie z .265 do .257. W modelu końcowym zostały cztery zmienne:
| Predyktor | b | SE | t | p |
|---|---|---|---|---|
| Stres w pracy | −0.42 | 0.12 | −3.51 | < .001 |
| Zaangażowanie | 0.44 | 0.12 | 3.82 | < .001 |
| Wsparcie przełożonego | 0.34 | 0.07 | 4.71 | < .001 |
| Autonomia | 0.33 | 0.08 | 4.12 | < .001 |
Na tych samych danych selekcja postępująca (próg wejścia p < .05) wybrała tylko wsparcie i autonomię. W ostatnim kroku najlepszym kandydatem było zaangażowanie z p = .096, a stres miał p = .400. Model postępujący wyjaśniał 18.3% wariancji (R² = .183), a dodanie do niego pary stres–zaangażowanie istotnie go poprawiało, F(2, 155) = 7.67, p < .001. Skorygowane R² wzrosło z .173 do .237. Dane wygenerowano z modelu, w którym działały dokładnie te cztery zmienne, więc tu eliminacja wsteczna trafiła. Pamiętaj jednak, że to jeden zbiór danych dobrany do zilustrowania mechanizmu, a nie dowód, że metoda zawsze działa.
Czego eliminacja wsteczna nie naprawia
Start od pełnego modelu ma swoją cenę. Gdy kandydatów jest wielu w stosunku do liczby osób, pełny model jest niestabilny: błędy standardowe są duże, a współliniowość sprawia, że o tym, która z dwóch podobnych zmiennych odpadnie, decyduje przypadek. Przy większej liczbie kandydatów niż obserwacji modelu pełnego w ogóle nie da się oszacować. Babyak (2004) zalicza automatyczny dobór zmiennych do głównych źródeł przeuczenia (overfitting). Model dopasowuje się wtedy do szumu w próbie i gorzej przewiduje wyniki w nowych danych.
Heinze i in. (2018) przypominają, że wartości p i przedziały ufności z modelu końcowego są liczone tak, jakby zestaw zmiennych był znany z góry. Ignorują to, że zmienne przeszły przez sito – zostały tylko te, które w tej próbie wypadły dobrze. Współczynniki takich zmiennych są przeciętnie zawyżone, a p zbyt optymistyczne. Autorzy zalecają, by przy modelach wyjaśniających opierać wybór zmiennych na wiedzy merytorycznej. Jeśli selekcję jednak stosujesz, raportuj jej stabilność, na przykład częstość wyboru zmiennych w próbach bootstrap (przykład takiej analizy znajdziesz w haśle o metodzie krokowej).
| Sytuacja | Co zrobić |
|---|---|
| Testujesz hipotezy o konkretnych predyktorach | Nie usuwaj zmiennych automatycznie; wprowadź zaplanowany zestaw naraz (metoda wprowadzania) albo blokami (regresja hierarchiczna). |
| Chcesz sprawdzić, czy zestaw zmiennych (np. kilka zmiennych zero-jedynkowych) coś wnosi | Usuń cały zestaw jednym testem – tak działa metoda usuwania. |
| Cel eksploracyjny, mało kandydatów, duża próba, skorelowane predyktory | Eliminacja wsteczna jest rozsądniejsza niż postępująca, ale wynik traktuj jako hipotezę do sprawdzenia w nowych danych. |
| Cel predykcyjny, wielu kandydatów | Lepiej sprawdzają się metody z karaniem (np. lasso) i walidacja krzyżowa (zob. data mining). |
Jak opisać eliminację wsteczną w pracy
Recenzent musi wiedzieć, ilu było kandydatów, jakie kryterium usunięcia przyjęto i co zostało w modelu. Podaj też model pełny – w tabeli albo w aneksie – żeby czytelnik zobaczył zmienne, które odpadły. Wzór dla przykładu:
Tabelę współczynników przygotuj według wzoru tabeli regresji w APA. Szerszy kontekst – od założeń po interpretację – opisuje poradnik regresja wieloraka krok po kroku.
Eliminacja wsteczna w R
Kod tworzy dane z przykładu, wykonuje eliminację wsteczną z progiem p > .10 (jak w SPSS) i dla porównania selekcję postępującą z progiem p < .05. Wszystkie liczby z tekstu, tabeli i rysunku pochodzą z tego kodu.
Eliminacja wsteczna i porównanie z selekcją postępującą
R
# Dane symulowane: 160 pracowników, zadowolenie z pracy (1–7) i 8 kandydatów na predyktory.
# Stres i zaangażowanie są silnie skorelowane i działają w przeciwnych kierunkach (para supresyjna).
set.seed(223)
N <- 160
z <- rnorm(N)
dane <- data.frame(
  stres        = 0.88 * z + sqrt(1 - 0.88^2) * rnorm(N),
  zaangazowanie = 0.88 * z + sqrt(1 - 0.88^2) * rnorm(N),
  wsparcie     = rnorm(N), autonomia = rnorm(N), staz = rnorm(N),
  wiek         = rnorm(N), dojazd = rnorm(N), nadgodziny = rnorm(N))
dane$zadowolenie <- 4.5 - 0.40 * dane$stres + 0.40 * dane$zaangazowanie +
  0.30 * dane$wsparcie + 0.15 * dane$autonomia + rnorm(N, sd = 0.9)
dane$zadowolenie <- pmin(pmax(dane$zadowolenie, 1), 7)
round(cor(dane$stres, dane$zaangazowanie), 2)
round(cor(dane)[ "zadowolenie", 1:8], 2)        # korelacje proste z wynikiem

kandydaci <- names(dane)[1:8]
fp <- function(p) ifelse(p < .001, "< .001", paste("=", sub("^0", "", sprintf("%.3f", p))))   # zapis p w stylu APA

# Eliminacja wsteczna: start od modelu pełnego, usuwaj predyktor o największym p, dopóki p > .10
wsteczna <- function(dane, y, zmienne, p_usun = .10) {
  krok <- 0
  repeat {
    m <- lm(reformulate(zmienne, y), data = dane)
    p <- coef(summary(m))[zmienne, 4]
    krok <- krok + 1
    cat(sprintf("Krok %d: %d predyktorów, R2 %s, najsłabszy: %s (p %s)\n",
                krok, length(zmienne), fp(summary(m)$r.squared), names(which.max(p)), fp(max(p))))
    if (max(p) <= p_usun) break
    zmienne <- setdiff(zmienne, names(which.max(p)))
  }
  m
}

# Selekcja postępująca dla porównania: dodawaj predyktor o najmniejszym p, dopóki p < .05
postepujaca <- function(dane, y, zmienne, p_wej = .05) {
  wybrane <- character(0)
  repeat {
    reszta <- setdiff(zmienne, wybrane)
    p <- sapply(reszta, function(v) coef(summary(lm(reformulate(c(wybrane, v), y), data = dane)))[v, 4])
    cat(sprintf("Model z: %s | najlepszy kandydat: %s (p %s); stres p %s, zaangażowanie p %s\n",
                paste(c("stała", wybrane), collapse = " + "), names(which.min(p)), fp(min(p)),
                fp(p["stres"]), fp(p["zaangazowanie"])))
    if (min(p) >= p_wej) break
    wybrane <- c(wybrane, names(which.min(p)))
  }
  wybrane
}

m_wst <- wsteczna(dane, "zadowolenie", kandydaci)
round(coef(summary(m_wst)), 3)
round(summary(m_wst)$adj.r.squared, 3)

wyb_post <- postepujaca(dane, "zadowolenie", kandydaci)
wyb_post
m_post <- lm(reformulate(wyb_post, "zadowolenie"), data = dane)
round(c(R2 = summary(m_post)$r.squared, R2_skor = summary(m_post)$adj.r.squared), 3)
anova(m_post, m_wst)       # czy para stres + zaangażowanie poprawia model postępujący?
Wynik w R
[1] 0.77
        stres zaangazowanie      wsparcie     autonomia          staz
        -0.06          0.10          0.33          0.29          0.11
         wiek        dojazd    nadgodziny
        -0.07          0.07         -0.03
Krok 1: 8 predyktorów, R2 = .265, najsłabszy: nadgodziny (p = .701)
Krok 2: 7 predyktorów, R2 = .264, najsłabszy: wiek (p = .568)
Krok 3: 6 predyktorów, R2 = .262, najsłabszy: staz (p = .486)
Krok 4: 5 predyktorów, R2 = .260, najsłabszy: dojazd (p = .411)
Krok 5: 4 predyktorów, R2 = .257, najsłabszy: stres (p < .001)
              Estimate Std. Error t value Pr(>|t|)
(Intercept)      4.363      0.073  60.164    0.000
stres           -0.417      0.119  -3.513    0.001
zaangazowanie    0.440      0.115   3.817    0.000
wsparcie         0.341      0.072   4.714    0.000
autonomia        0.327      0.080   4.115    0.000
[1] 0.237
Model z: stała | najlepszy kandydat: wsparcie (p < .001); stres p = .468, zaangażowanie p = .191
Model z: stała + wsparcie | najlepszy kandydat: autonomia (p < .001); stres p = .568, zaangażowanie p = .092
Model z: stała + wsparcie + autonomia | najlepszy kandydat: zaangazowanie (p = .096); stres p = .400, zaangażowanie p = .096
[1] "wsparcie"  "autonomia"
     R2 R2_skor
  0.183   0.173
Analysis of Variance Table

Model 1: zadowolenie ~ wsparcie + autonomia
Model 2: zadowolenie ~ stres + zaangazowanie + wsparcie + autonomia
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    157 143.16
2    155 130.26  2    12.898 7.6736 0.0006641 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
To samo w SPSS i funkcją step()
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Traktowanie modelu końcowego jak testu hipotez. Wartości p zmiennych, które przetrwały selekcję, są zaniżone, a współczynniki – zawyżone. Opisz je jako wynik eksploracji.
- Pominięcie informacji o kandydatach. Zdanie „zastosowano regresję wsteczną” bez listy zmiennych startowych i progu usunięcia uniemożliwia ocenę ryzyka przypadkowych wyników.
- Usuwanie zmiennych kontrolnych. Zmienne, które kontrolujesz z powodów merytorycznych (np. zmienne zakłócające), zostaw w modelu niezależnie od ich p.
- Za dużo kandydatów na zbyt małą próbę. Pełny model z wieloma zmiennymi i kilkudziesięcioma osobami jest niestabilny, a „wybór” zmiennych staje się loterią.
- Usuwanie pojedynczych zmiennych zero-jedynkowych jednego czynnika. Zmienna kategorialna to zestaw zmiennych; oceniaj go łącznie (dummy coding).
- Mylenie eliminacji wstecznej z regresją hierarchiczną. W regresji hierarchicznej kolejność ustala badacz, a w eliminacji wstecznej – algorytm na podstawie danych.
Najczęstsze pytania
Jak działa eliminacja wsteczna w regresji?
Program szacuje model ze wszystkimi kandydatami, znajduje predyktor o największej wartości p i usuwa go, jeśli przekracza próg (w SPSS domyślnie .10). Następnie szacuje model od nowa i powtarza sprawdzenie, aż wszystkie pozostałe zmienne spełnią kryterium. Usunięta zmienna już nie wraca do modelu.
Czym różni się eliminacja wsteczna od selekcji postępującej?
Eliminacja wsteczna startuje od modelu pełnego i usuwa zmienne, a selekcja postępująca startuje od pustego modelu i je dodaje. Wsteczna ocenia każdą zmienną w obecności pozostałych, więc może zachować parę skorelowanych predyktorów działających tylko razem. W przykładzie na tej stronie para stres–zaangażowanie podniosła skorygowane R² z .173 do .237, a selekcja postępująca jej nie wybrała.
Dlaczego próg usunięcia w metodzie backward wynosi .10, a nie .05?
Łagodniejszy próg usunięcia zmniejsza ryzyko, że procedura wyrzuci zmienną o realnym, ale słabo oszacowanym efekcie. W SPSS domyślnie zmienna wypada przy p > .10, a w metodzie krokowej próg usunięcia musi być wyższy niż próg wejścia (.05), by procedura nie zapętliła się. Próg podaj w opisie metody.
Czy po eliminacji wstecznej mogę interpretować wartości p?
Tylko ostrożnie i opisowo. Zmienne przeszły przez selekcję, więc ich współczynniki są przeciętnie zawyżone, a wartości p i przedziały ufności zbyt optymistyczne (Heinze i in., 2018). Model z selekcji traktuj jako hipotezę do sprawdzenia w nowych danych.
Jak zrobić eliminację wsteczną w R?
Funkcja step(lm(y ~ ., data = dane), direction = "backward") usuwa zmienne, dopóki maleje AIC. Jeśli chcesz kryterium p jak w SPSS, napisz krótką pętlę z lm() i summary() – pełny kod jest w przykładzie na tej stronie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Babyak, M. A. (2004). What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models. Psychosomatic Medicine, 66(3), 411–421. https://doi.org/10.1097/01.psy.0000127692.23278.a9 ● Otwarty dostęp
- Derksen, S., & Keselman, H. J. (1992). Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables. British Journal of Mathematical and Statistical Psychology, 45(2), 265–282. https://doi.org/10.1111/j.2044-8317.1992.tb00992.x
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067 ● Otwarty dostęp
- Mantel, N. (1970). Why stepdown procedures in variable selection. Technometrics, 12(3), 621–625. https://doi.org/10.1080/00401706.1970.10488701
Cytowania BibTeX
@article{babyak2004what, author={Babyak, Michael A.}, title={{What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models}}, journal={Psychosomatic Medicine}, year={2004}, volume={66}, number={3}, pages={411--421}, doi={10.1097/01.psy.0000127692.23278.a9}}@article{derksen1992backward, author={Derksen, Shelley and Keselman, H. J.}, title={{Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables}}, journal={British Journal of Mathematical and Statistical Psychology}, year={1992}, volume={45}, number={2}, pages={265--282}, doi={10.1111/j.2044-8317.1992.tb00992.x}}@article{heinze2018variable, author={Heinze, Georg and Wallisch, Christine and Dunkler, Daniela}, title={{Variable selection – A review and recommendations for the practicing statistician}}, journal={Biometrical Journal}, year={2018}, volume={60}, number={3}, pages={431--449}, doi={10.1002/bimj.201700067}}@article{mantel1970why, author={Mantel, Nathan}, title={{Why stepdown procedures in variable selection}}, journal={Technometrics}, year={1970}, volume={12}, number={3}, pages={621--625}, doi={10.1080/00401706.1970.10488701}}