Co to jest metoda najmniejszych kwadratów?
Metoda najmniejszych kwadratów (MNK, ang. ordinary least squares, OLS) to sposób wyznaczania współczynników regresji liniowej: spośród wszystkich możliwych prostych (albo płaszczyzn – przy wielu predyktorach) wybiera się tę, dla której suma kwadratów reszt jest najmniejsza. Reszta to różnica między wynikiem obserwowanym a przewidywanym przez model. Tak liczy współczynniki funkcja lm() w R i procedura regresji liniowej w SPSS.
Metoda pochodzi z początku XIX wieku i wiąże się z najsłynniejszym sporem o pierwszeństwo w historii statystyki – między Legendre’em a Gaussem. Stigler (1981) przeanalizował nowe dowody i uznał (choć nie rozstrzygająco), że Gauss najpewniej znał metodę przed Legendre’em, ale nie zdołał jej przekazać współczesnym. Dziś MNK jest podstawą regresji prostej, regresji wielorakiej i – jako szczególnego przypadku modelu liniowego – analizy wariancji.
Co dokładnie minimalizuje MNK?
Dla regresji prostej Ŷ = b0 + b1X metoda szuka takich b0 i b1, przy których najmniejsza jest suma kwadratów reszt (SSE, ang. sum of squared errors):
Minimum ma jedno rozwiązanie, które można zapisać wzorami:
Licznik pierwszego wzoru to suma iloczynów odchyleń (po podzieleniu przez n − 1 – kowariancja), a mianownik – suma kwadratów odchyleń X (po podzieleniu przez n − 1 – wariancja). Z rozwiązania wynikają trzy własności, które warto znać: prosta MNK przechodzi przez punkt średnich (x̄, ȳ), reszty sumują się do zera i nie są skorelowane z predyktorem. Przy wielu predyktorach te same warunki zapisuje się macierzowo: b = (XᵀX)⁻¹Xᵀy.
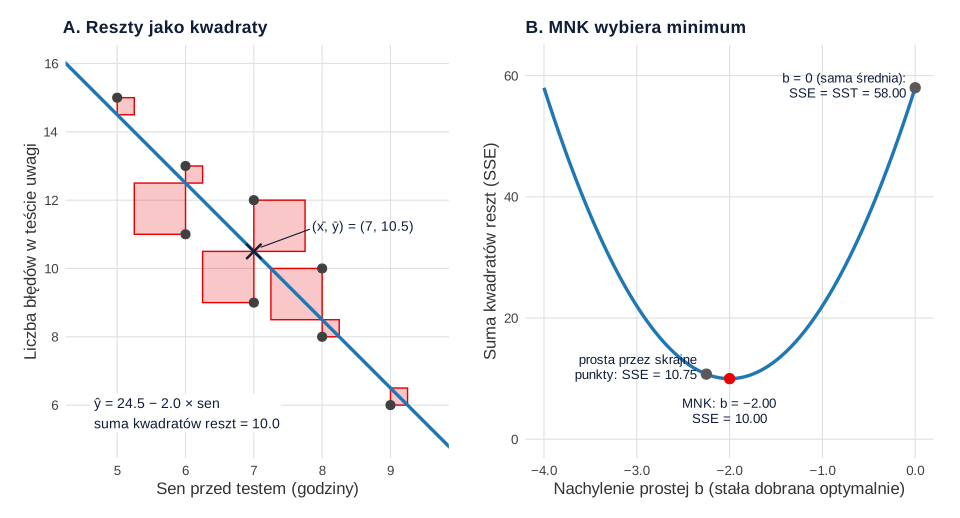
Dlaczego kwadraty, a nie wartości bezwzględne? Kwadrat sprawia, że dodatnie i ujemne reszty się nie znoszą, daje jedno rozwiązanie w prostej postaci i łączy MNK z wariancją: SSE podzielone przez stopnie swobody to wariancja reszt. Ceną jest to, że duże reszty ważą nieproporcjonalnie dużo – reszta 4 waży tyle co szesnaście reszt równych 1. Wrócimy do tego przy obserwacjach odstających.
Przykład krok po kroku: sen i błędy w teście uwagi
Ośmioro studentów (dane przykładowe) podało, ile godzin spało w nocy przed testem uwagi, a badacz policzył ich błędy w teście. Średnie wynoszą x̄ = 7.0 godziny i ȳ = 10.5 błędu. Tabela pokazuje wszystkie obliczenia.
| Osoba | Sen x | Błędy y | x − x̄ | y − ȳ | (x − x̄)(y − ȳ) | (x − x̄)² | ŷ | Reszta e | e² |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 5 | 15 | −2 | 4.5 | −9.0 | 4 | 14.5 | 0.5 | 0.25 |
| 2 | 6 | 13 | −1 | 2.5 | −2.5 | 1 | 12.5 | 0.5 | 0.25 |
| 3 | 6 | 11 | −1 | 0.5 | −0.5 | 1 | 12.5 | −1.5 | 2.25 |
| 4 | 7 | 12 | 0 | 1.5 | 0.0 | 0 | 10.5 | 1.5 | 2.25 |
| 5 | 7 | 9 | 0 | −1.5 | 0.0 | 0 | 10.5 | −1.5 | 2.25 |
| 6 | 8 | 8 | 1 | −2.5 | −2.5 | 1 | 8.5 | −0.5 | 0.25 |
| 7 | 8 | 10 | 1 | −0.5 | −0.5 | 1 | 8.5 | 1.5 | 2.25 |
| 8 | 9 | 6 | 2 | −4.5 | −9.0 | 4 | 6.5 | −0.5 | 0.25 |
| Suma | — | — | — | — | −24.0 | 12 | — | 0 | 10.00 |
Prosta MNK ma więc postać ŷ = 24.5 − 2.0 × sen: każda dodatkowa godzina snu wiąże się z dwoma błędami mniej. Suma kwadratów reszt wynosi SSE = 10.00, a całkowita suma kwadratów odchyleń wyników od średniej SST = 58.00, więc R² = 1 − 10/58 = .83. Żadna inna prosta nie da mniejszej sumy kwadratów: na przykład prosta poprowadzona „na oko” przez skrajne punkty (5; 15) i (9; 6), czyli ŷ = 26.25 − 2.25 × sen, daje SSE = 10.75. Rysunek 1 pokazuje reszty jako kwadraty i to, jak SSE zależy od wybranego nachylenia.
Kiedy MNK jest najlepsza: twierdzenie Gaussa–Markowa
Popularność MNK ma uzasadnienie teoretyczne. Twierdzenie Gaussa–Markowa mówi, że w modelu regresji liniowej MNK daje najlepsze liniowe nieobciążone estymatory (ang. best linear unbiased estimators, BLUE) – i to w bardzo ogólnych warunkach, które nie wymagają normalności rozkładu (Hallin, 2014). „Najlepsze” znaczy: o najmniejszej wariancji spośród wszystkich estymatorów liniowych i nieobciążonych. Warunki są następujące:
- model jest liniowy względem współczynników i poprawnie określony (zawiera potrzebne predyktory);
- błędy mają średnią zero i nie są skorelowane z predyktorami;
- błędy mają stałą wariancję (homoskedastyczność) i nie są skorelowane między sobą;
- żaden predyktor nie jest dokładną kombinacją liniową pozostałych (brak pełnej współliniowości).
Normalność błędów nie jest więc potrzebna do samego szacowania. Ma znaczenie dla dokładności testów t i F oraz przedziałów ufności, zwłaszcza w małych próbach – i dotyczy reszt, a nie surowych zmiennych (Williams i in., 2013). Gdy wariancja błędów nie jest stała, współczynniki MNK pozostają nieobciążone, ale ich błędy standardowe bywają obciążone, a testy – zbyt liberalne lub zbyt konserwatywne; Hayes i Cai (2007) zalecają wręcz rutynowe stosowanie w regresji MNK błędów standardowych odpornych na heteroskedastyczność (np. HC3). Jeśli błędy mają rozkład normalny, oszacowania MNK pokrywają się z oszacowaniami metody największej wiarygodności.
Wrażliwość na obserwacje odstające
Ponieważ MNK minimalizuje kwadraty, jedna duża reszta może zdominować wynik. Yu i Yao (2017) podkreślają, że estymatory MNK są bardzo wrażliwe na nietypowe wartości predyktorów i odstające wartości zmiennej zależnej – nawet jedna taka obserwacja może silnie zmienić oszacowania. Dodajmy do przykładu dziewiątą osobę: spała 9 godzin, ale popełniła 16 błędów (np. źle zrozumiała instrukcję).
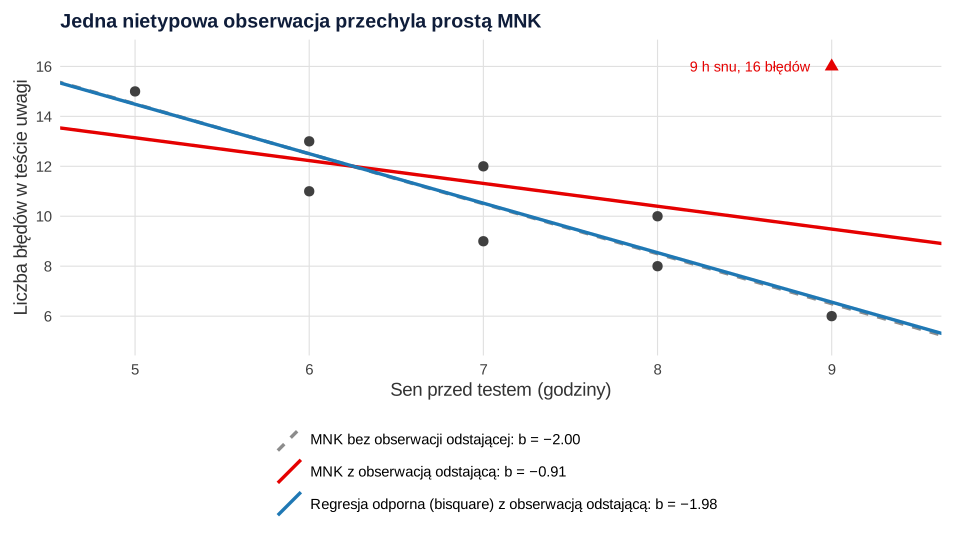
Nachylenie MNK zmieniło się z −2.00 na −0.91 – jedna osoba na dziewięć „zabrała” ponad połowę związku. Regresja odporna dała nachylenie −1.98, bo nietypowej osobie przypisała wagę 0.02, a pozostałym wagi od 0.96 do 1.00. Takie obserwacje wykrywa odległość Cooka – miara, którą Cook (1977) zaproponował do oceny wpływu każdej obserwacji na oszacowania najmniejszych kwadratów; łączy ona wielkość reszty z dźwignią obserwacji. Zanim usuniesz nietypową osobę, sprawdź, skąd się wzięła (zob. obserwacja odstająca i poradnik wartości odstające: jak je wykryć).
Alternatywy dla MNK
Gdy warunki MNK są wyraźnie naruszone, sięga się po inne metody szacowania. Regresja odporna (M- i MM-estymacja) zmniejsza wagę obserwacji o dużych resztach; Yu i Yao (2017) porównują takie metody pod względem punktu załamania i efektywności. Regresja medianowa (najmniejszych odchyleń bezwzględnych) minimalizuje sumę wartości bezwzględnych reszt i opisuje medianę zamiast średniej. Ważona MNK nadaje obserwacjom wagi odwrotnie proporcjonalne do wariancji błędu, a uogólniona MNK (GLS) uwzględnia dodatkowo korelacje błędów, np. w danych podłużnych. Dla wyników dwuwartościowych czy liczebności stosuje się modele szacowane metodą największej wiarygodności, takie jak regresja logistyczna.
Jak opisać metodę w pracy (APA)
W części o analizie danych wystarczy jedno–dwa zdania o metodzie szacowania i – jeśli ją przeprowadzono – o analizie wrażliwości. Wzór dla przykładu:
Pełny opis wyników regresji (z 95% CI, testem t i F) pokazujemy w hasłach regresja prosta i regresja wieloraka.
Przykład w R
Kod odtwarza obliczenia z tabeli, porównuje wynik ze wzorów z funkcją lm(), liczy SSE dla prostej „na oko” i pokazuje wpływ obserwacji odstającej na MNK oraz regresję odporną. Liczby w tekście i na rysunkach pochodzą z tego kodu.
MNK krok po kroku i regresja odporna
R
# Dane przykładowe: 8 studentów – sen w nocy przed testem (godziny) i liczba błędów w teście uwagi
sen   <- c(5, 6, 6, 7, 7, 8, 8, 9)
bledy <- c(15, 13, 11, 12, 9, 8, 10, 6)
dane  <- data.frame(sen, bledy)

# MNK krok po kroku: odchylenia od średnich, ich iloczyny i kwadraty
dx <- sen - mean(sen)
dy <- bledy - mean(bledy)
cbind(dane, dx, dy, iloczyn = dx * dy, dx2 = dx^2)
b1 <- sum(dx * dy) / sum(dx^2)         # nachylenie
b0 <- mean(bledy) - b1 * mean(sen)     # stała
c(M_x = mean(sen), M_y = mean(bledy), Sxy = sum(dx * dy), Sxx = sum(dx^2), b1 = b1, b0 = b0)

# To samo w lm(): wartości przewidywane, reszty i ich kwadraty
model <- lm(bledy ~ sen, data = dane)
coef(model)
cbind(dane, przewidywane = fitted(model), reszta = resid(model), kwadrat = resid(model)^2)
round(c(SSE = sum(resid(model)^2), suma_reszt = sum(resid(model)),
        SST = sum(dy^2), R2 = summary(model)$r.squared), 3)

# Każda inna prosta ma większą sumę kwadratów reszt, np. prosta przez skrajne punkty
sum((bledy - (26.25 - 2.25 * sen))^2)

# Jedna obserwacja odstająca: 9 godzin snu i 16 błędów
dane_o <- rbind(dane, data.frame(sen = 9, bledy = 16))
round(coef(lm(bledy ~ sen, data = dane_o)), 2)
library(MASS)                           # rlm(): regresja odporna (M-estymacja)
odporna <- rlm(bledy ~ sen, data = dane_o, psi = psi.bisquare)
round(coef(odporna), 2)
round(odporna$w, 2)                     # wagi obserwacji w regresji odpornej
Wynik w R
  sen bledy dx   dy iloczyn dx2
1   5    15 -2  4.5    -9.0   4
2   6    13 -1  2.5    -2.5   1
3   6    11 -1  0.5    -0.5   1
4   7    12  0  1.5     0.0   0
5   7     9  0 -1.5     0.0   0
6   8     8  1 -2.5    -2.5   1
7   8    10  1 -0.5    -0.5   1
8   9     6  2 -4.5    -9.0   4
  M_x   M_y   Sxy   Sxx    b1    b0
  7.0  10.5 -24.0  12.0  -2.0  24.5
(Intercept)         sen
       24.5        -2.0
  sen bledy przewidywane reszta kwadrat
1   5    15         14.5    0.5    0.25
2   6    13         12.5    0.5    0.25
3   6    11         12.5   -1.5    2.25
4   7    12         10.5    1.5    2.25
5   7     9         10.5   -1.5    2.25
6   8     8          8.5   -0.5    0.25
7   8    10          8.5    1.5    2.25
8   9     6          6.5   -0.5    0.25
       SSE suma_reszt        SST         R2
    10.000      0.000     58.000      0.828
[1] 10.75
(Intercept)         sen
      17.71       -0.91
(Intercept)         sen
      24.39       -1.98
[1] 0.99 1.00 0.96 0.96 0.96 0.99 0.96 0.99 0.02
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- „MNK wymaga normalności zmiennych”. Samo szacowanie MNK nie wymaga normalności; dla testów w małych próbach ważna jest normalność reszt, a nie zmiennych.
- Ignorowanie obserwacji wpływowych. Kwadraty sprawiają, że jedna nietypowa osoba może zmienić nachylenie – w przykładzie z −2.00 na −0.91. Zawsze obejrzyj wykres rozrzutu i odległość Cooka.
- Automatyczne usuwanie nietypowych obserwacji. Najpierw sprawdź, czy to błąd danych. Jeśli nie, raportuj wynik z obserwacją i bez niej albo użyj regresji odpornej.
- Traktowanie heteroskedastyczności jako problemu współczynników. Współczynniki MNK pozostają nieobciążone; obciążone bywają ich błędy standardowe – popraw je (HC3), zamiast zmieniać model.
- Mylenie dopasowania z trafnością. MNK zawsze znajdzie „najlepszą” prostą – także wtedy, gdy związek jest krzywoliniowy albo gdy model pomija ważny predyktor.
Najczęstsze pytania
Na czym polega metoda najmniejszych kwadratów?
Metoda wybiera takie współczynniki regresji, przy których suma kwadratów reszt – różnic między wynikami obserwowanymi a przewidywanymi – jest najmniejsza. W regresji prostej rozwiązaniem jest b1 = Σ(x − x̄)(y − ȳ)/Σ(x − x̄)² oraz b0 = ȳ − b1x̄. Tak liczą współczynniki lm() w R i regresja liniowa w SPSS.
Dlaczego w metodzie najmniejszych kwadratów reszty podnosi się do kwadratu?
Kwadrat usuwa znak reszt, daje jedno rozwiązanie w prostej postaci i wiąże metodę z wariancją. Skutkiem ubocznym jest duża waga dużych reszt: reszta 4 liczy się tak jak szesnaście reszt równych 1. Dlatego MNK jest wrażliwa na obserwacje odstające, a regresja medianowa, która minimalizuje wartości bezwzględne reszt, jest bardziej odporna.
Jakie założenia ma metoda najmniejszych kwadratów?
Do samego wyznaczenia prostej założenia nie są potrzebne. Aby oszacowania były najlepsze wśród liniowych nieobciążonych (twierdzenie Gaussa–Markowa), model musi być liniowy i poprawnie określony, a błędy mieć średnią zero, stałą wariancję i nie być ze sobą skorelowane. Normalność reszt jest potrzebna dopiero do dokładnych testów w małych próbach.
Co oznacza, że estymator MNK jest BLUE?
BLUE (best linear unbiased estimator) to najlepszy liniowy nieobciążony estymator: spośród wszystkich estymatorów liniowych, które średnio trafiają w prawdziwą wartość, ma najmniejszą wariancję. Twierdzenie Gaussa–Markowa gwarantuje tę własność MNK bez założenia o rozkładzie normalnym (Hallin, 2014).
Czy metoda najmniejszych kwadratów jest odporna na obserwacje odstające?
Nie. Ponieważ minimalizuje kwadraty reszt, jedna nietypowa obserwacja może wyraźnie zmienić współczynniki – w przykładzie z tej strony nachylenie zmieniło się z −2.00 na −0.91. Obserwacje wpływowe wykrywa się odległością Cooka, a gdy są prawdziwymi danymi, warto porównać wynik z regresją odporną.
Czym różni się metoda najmniejszych kwadratów od metody największej wiarygodności?
MNK minimalizuje sumę kwadratów reszt i nie wymaga założenia o rozkładzie. Metoda największej wiarygodności wybiera parametry, przy których obserwowane dane są najbardziej prawdopodobne przy założonym rozkładzie. Dla regresji liniowej z normalnymi błędami obie metody dają te same współczynniki; dla regresji logistycznej czy modeli SEM stosuje się metodę największej wiarygodności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikStatystyka dla psychologów
Co statystyka daje psychologii, gdzie ma granice i jak jej nie nadużywać: wartość p, moc, replikacje, braki danych, metody odporne i symulacja w R.
Czytaj →PoradnikKorelacja i regresja – zadania z rozwiązaniami
Dziesięć zadań: kowariancja, Pearson i Spearman, metoda najmniejszych kwadratów, R², przedział predykcji, reszty, punkt wpływowy, regresja wieloraka i kwartet Anscombe’a.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Hallin, M. (2014). Gauss–Markov theorem in statistics. In Wiley StatsRef: Statistics reference online. Wiley. https://doi.org/10.1002/9781118445112.stat07536
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/bf03192961 ● Otwarty dostęp
- Stigler, S. M. (1981). Gauss and the invention of least squares. The Annals of Statistics, 9(3), 465–474. https://doi.org/10.1214/aos/1176345451 ● Otwarty dostęp
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
- Yu, C., & Yao, W. (2017). Robust linear regression: A review and comparison. Communications in Statistics – Simulation and Computation, 46(8), 6261–6282. https://doi.org/10.1080/03610918.2016.1202271 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@incollection{hallin2014gauss, author={Hallin, Marc}, title={{Gauss–Markov theorem in statistics}}, booktitle={Wiley StatsRef: Statistics reference online}, year={2014}, publisher={Wiley}, doi={10.1002/9781118445112.stat07536}}@article{hayes2007using, author={Hayes, Andrew F. and Cai, Li}, title={{Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={4}, pages={709--722}, doi={10.3758/bf03192961}}@article{stigler1981gauss, author={Stigler, Stephen M.}, title={{Gauss and the invention of least squares}}, journal={The Annals of Statistics}, year={1981}, volume={9}, number={3}, pages={465--474}, doi={10.1214/aos/1176345451}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}@article{yu2017robust, author={Yu, Chun and Yao, Weixin}, title={{Robust linear regression: A review and comparison}}, journal={Communications in Statistics – Simulation and Computation}, year={2017}, volume={46}, number={8}, pages={6261--6282}, doi={10.1080/03610918.2016.1202271}}