Co to jest metoda selekcji postępującej?
Metoda selekcji postępującej (selekcja postępująca, regresja postępująca, ang. forward selection, w SPSS opcja Forward) to automatyczny sposób budowania modelu regresji wielorakiej od zera. Procedura zaczyna od modelu z samą stałą. W każdym kroku sprawdza wszystkich kandydatów spoza modelu i dodaje tego, który najbardziej poprawia dopasowanie – ma najmniejsze p (największe F wejścia) przy kontroli zmiennych już wybranych. Zatrzymuje się, gdy najlepszy z pozostałych kandydatów nie spełnia kryterium wejścia, w SPSS domyślnie p < .05.
Wprowadzona zmienna zostaje w modelu do końca, nawet jeśli po dodaniu kolejnych straci istotność. Tym selekcja postępująca różni się od metody krokowej, która po każdym dodaniu sprawdza też usunięcie. Kierunek jest odwrotny niż w eliminacji wstecznej, która zaczyna od pełnego modelu.
Kryterium wejścia i reguła zatrzymania
W kroku k dla każdego kandydata Xj liczy się przyrost R², jaki dałoby jego dodanie, i test tego przyrostu:
Program wybiera kandydata z największym F. Wartość p tego F nie jest jednak zwykłą wartością p. Wybrano ją jako najmniejszą spośród wielu testów, więc pod hipotezą zerową jest systematycznie zbyt mała. Wilkinson i Dallal (1981) wyznaczyli w symulacji, jak duże musi być R² modelu z selekcji postępującej, by uznać je za istotne przy braku związku w populacji. Przygotowali tablice zależne od liczby kandydatów i wielkości próby. Tablice uwzględniają to, że zmienne wybrano spośród wielu kandydatów, więc pozwalają ocenić R² po selekcji uczciwiej niż standardowy test F. Innymi słowy, istotność modelu z selekcji postępującej nie mówi tego, co zwykle sugeruje.
Klątwa zwycięzcy: dlaczego wybrane współczynniki są za duże
Zmienna wchodzi do modelu wtedy, gdy w tej konkretnej próbie jej efekt wypadł wystarczająco mocno. Prawdziwy, ale słaby efekt przekracza próg głównie wtedy, gdy los zawyżył oszacowanie. Odfiltrowanie prób z małymi oszacowaniami sprawia, że te, które przeszły, są przeciętnie za duże. To ten sam mechanizm, który zawyża efekty w literaturze przy efekcie szuflady, tyle że działa w obrębie jednej analizy.
Smith (2018) opisuje skutki: prawdziwe predyktory mogą wypaść jako nieistotne, a zmienne bez znaczenia – przypadkowo okazać się istotne. Model dobrze pasuje wtedy do próby, ale źle przewiduje nowe dane, i to tym gorzej, im więcej jest kandydatów. Derksen i Keselman (1992) pokazali, że to liczba kandydatów decyduje o tym, ile zmiennych szumowych trafi do modelu. Wykazali też, że R² w populacji lepiej szacuje statystyka skorygowana o liczbę wszystkich kandydatów niż o liczbę zmiennych w modelu końcowym.
Przykład: sen, nastrój i dziesięć zmiennych szumowych
Wyobraź sobie badanie 80 osób (dane symulowane), w którym wynikiem jest test pamięci, a kandydatów na predyktory jest 12. Wiemy, jak powstały dane: w populacji działają tylko dwie zmienne, długość snu i nastrój, obie ze współczynnikiem b = 0.25. Pozostałe dziesięć to szum. Maksymalne możliwe R² w populacji wynosi .111.
Jedna próba. Selekcja postępująca wykonała jeden krok: do modelu wszedł sen (p = .009) i na tym się skończyło. Nastrój, który działa tak samo silnie, nie przekroczył progu. Współczynnik snu wyniósł 0.32, SE = 0.12, czyli więcej niż prawdziwe 0.25. Model wyjaśniał 8.3% wariancji (skorygowane R² = .072). W nowej próbie 80 osób z tej samej populacji te same współczynniki dały R² = .035.
2000 prób. Żeby oddzielić regułę od przypadku, powtórzyliśmy badanie 2000 razy:
- Sen wszedł do modelu w 54.5% badań, a obie prawdziwe zmienne naraz – tylko w 31.9%.
- W 42.8% badań w modelu znalazła się co najmniej jedna zmienna szumowa.
- Gdy sen wszedł do modelu, jego średni współczynnik wynosił 0.325, czyli o 30% więcej niż prawdziwe 0.25. W modelu ze wszystkimi 12 zmiennymi, bez selekcji, średnia wynosiła 0.244 (rysunek 1A).
- Średnie R² wybranych modeli w próbie, na której wybierano, wynosiło .161 – więcej niż populacyjne .111. W nowych próbach średnie R² tych samych modeli spadło do −.014, a mediana do −.002 (rysunek 1B). Ujemne R² w nowej próbie znaczy, że model przewiduje gorzej niż sama średnia.
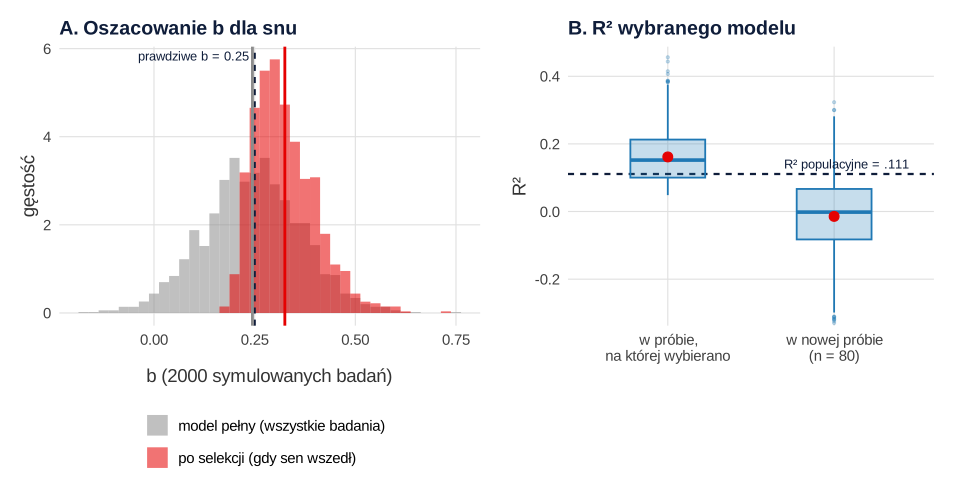
Steyerberg i in. (2001) opisują to samo zjawisko w modelach prognostycznych. Wydajność ocenianą na próbie, na której zbudowano model, zawyża się, dlatego trzeba ją sprawdzać metodami walidacji wewnętrznej. W ich porównaniu najlepiej wypadł bootstrap, który dawał stabilne oszacowania o małym obciążeniu, a podział próby na części – oszacowania zbyt pesymistyczne i zmienne. Gdy model powstał przez selekcję, każda próba bootstrap musi powtarzać całą procedurę, razem z doborem zmiennych.
Kiedy selekcja postępująca bywa używana
Ma jedną praktyczną zaletę: działa także wtedy, gdy kandydatów jest więcej niż obserwacji i modelu pełnego nie da się oszacować. Dlatego pojawia się w eksploracji dużych zbiorów zmiennych. Do takich zadań lepiej jednak nadają się metody z karaniem, np. lasso, z doborem parametru przez walidację krzyżową (zob. data mining). W pracy dyplomowej, w której testujesz hipotezy, wprowadź zaplanowane predyktory naraz (metoda wprowadzania) albo blokami (regresja hierarchiczna). Zestaw zmiennych sprawdzisz jednym testem dzięki metodzie usuwania. Liczbę osób zaplanuj z góry, korzystając z analizy mocy – przy małej próbie selekcja gubi prawdziwe efekty, jak nastrój w przykładzie.
Jak opisać selekcję postępującą w pracy
Opis musi pozwolić czytelnikowi ocenić, ile testów wykonano po drodze. Podaj liczbę kandydatów, kryterium wejścia, kolejność wejścia zmiennych i zastrzeżenie dotyczące wnioskowania. Wzór dla przykładu z jedną próbą:
Jeśli nie masz drugiej próby, opisz walidację bootstrap albo przynajmniej zaznacz brak walidacji jako ograniczenie. Szerzej o raportowaniu regresji piszemy w poradniku regresja wieloraka krok po kroku.
Selekcja postępująca i jej skutki w R
Kod definiuje selekcję postępującą z progiem p < .05, pokazuje jej przebieg w jednej próbie i powtarza ją w 2000 symulowanych badaniach (ok. 20 sekund). Wszystkie liczby z tekstu i rysunku pochodzą z tego kodu.
Jedna próba i symulacja 2000 badań
R
# Selekcja postępująca: dodawaj predyktor o najmniejszym p, dopóki p < .05 (jak metoda Forward w SPSS)
fp <- function(p) ifelse(p < .001, "< .001", paste("=", sub("^0", "", sprintf("%.3f", p))))
postepujaca <- function(dane, y, zmienne, p_wej = .05, pokaz = FALSE) {
  w <- character(0)
  repeat {
    reszta <- setdiff(zmienne, w)
    if (length(reszta) == 0) break
    p <- sapply(reszta, function(v) coef(summary(lm(reformulate(c(w, v), y), data = dane)))[v, 4])
    if (min(p) >= p_wej) break
    w <- c(w, names(which.min(p)))
    if (pokaz) cat(sprintf("Krok %d: wchodzi %s (p %s), R2 = %s\n", length(w), names(which.min(p)), fp(min(p)),
                           sub("^0", "", sprintf("%.3f", summary(lm(reformulate(w, y), data = dane))$r.squared))))
  }
  w
}

# Scenariusz: 80 osób, wynik testu pamięci (z), 12 kandydatów na predyktory.
# W populacji działają tylko dwa: sen (b = 0.25) i nastrój (b = 0.25); pozostałe 10 to szum.
generuj <- function(n) {
  X <- as.data.frame(matrix(rnorm(n * 12), n, 12))
  names(X) <- c("sen", "nastroj", paste0("szum", 1:10))
  X$pamiec <- 0.25 * X$sen + 0.25 * X$nastroj + rnorm(n)
  X
}
kandydaci <- c("sen", "nastroj", paste0("szum", 1:10))

# 1. Jeden zbiór danych krok po kroku
set.seed(205)
dane <- generuj(80)
wyb <- postepujaca(dane, "pamiec", kandydaci, pokaz = TRUE)
m <- lm(reformulate(wyb, "pamiec"), data = dane)
round(coef(summary(m)), 3)
nowe <- generuj(80)                                     # nowa próba z tej samej populacji
R2_nowe <- 1 - sum((nowe$pamiec - predict(m, nowe))^2) / sum((nowe$pamiec - mean(nowe$pamiec))^2)
round(c(R2_proba = summary(m)$r.squared, R2_skor = summary(m)$adj.r.squared, R2_nowa_proba = R2_nowe), 3)

# 2. Symulacja: 2000 badań z tej samej populacji
set.seed(2051)
sym <- t(replicate(2000, {
  d <- generuj(80); w <- postepujaca(d, "pamiec", kandydaci)
  b_pelny <- coef(lm(pamiec ~ ., data = d))["sen"]          # model ze wszystkimi 12 kandydatami
  n_szum <- sum(grepl("szum", w)); oba <- all(c("sen", "nastroj") %in% w)
  if (length(w) == 0) return(c(wybrany = 0, b_wyb = NA, b_pelny = b_pelny, R2 = 0, R2_nowe = NA, k = 0, n_szum = 0, oba = 0))
  mw <- lm(reformulate(w, "pamiec"), data = d); nd <- generuj(80)
  c(wybrany = "sen" %in% w, b_wyb = if ("sen" %in% w) coef(mw)["sen"] else NA, b_pelny = b_pelny,
    R2 = summary(mw)$r.squared,
    R2_nowe = 1 - sum((nd$pamiec - predict(mw, nd))^2) / sum((nd$pamiec - mean(nd$pamiec))^2),
    k = length(w), n_szum = n_szum, oba = oba)
}))
sym <- as.data.frame(sym); names(sym) <- c("wybrany", "b_wyb", "b_pelny", "R2", "R2_nowe", "k", "n_szum", "oba")
round(mean(sym$wybrany), 3)                      # jak często sen trafia do modelu (moc selekcji)
round(c(b_prawdziwe = 0.25, sr_b_gdy_wybrany = mean(sym$b_wyb, na.rm = TRUE),
        sr_b_model_pelny = mean(sym$b_pelny)), 3)
# R² modeli z co najmniej jednym predyktorem: w próbie selekcji i w nowej próbie
round(c(sr_R2_w_probie = mean(sym$R2[sym$k > 0]), sr_R2_w_nowej_probie = mean(sym$R2_nowe, na.rm = TRUE),
        mediana_R2_w_nowej_probie = median(sym$R2_nowe, na.rm = TRUE),
        R2_populacyjne = 0.125 / 1.125), 3)
table(sym$k)                                     # liczba zmiennych w modelu końcowym
round(c(oba_prawdziwe = mean(sym$oba), co_najmniej_jeden_szum = mean(sym$n_szum > 0)), 3)
Wynik w R
Krok 1: wchodzi sen (p = .009), R2 = .083
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   -0.089      0.105  -0.853    0.396
sen            0.316      0.119   2.665    0.009
     R2_proba       R2_skor R2_nowa_proba
        0.083         0.072         0.035
[1] 0.545
     b_prawdziwe sr_b_gdy_wybrany sr_b_model_pelny
           0.250            0.325            0.244
           sr_R2_w_probie      sr_R2_w_nowej_probie mediana_R2_w_nowej_probie
                    0.161                    -0.014                    -0.002
           R2_populacyjne
                    0.111

  0   1   2   3   4   5   6   7
238 651 738 305  55   9   3   1
         oba_prawdziwe co_najmniej_jeden_szum
                 0.319                  0.428
SPSS i step() w R
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Interpretowanie istotności modelu końcowego jak zwykłego testu F. Model wybrany z wielu kandydatów prawie zawsze „jest istotny”; właściwe wartości krytyczne są wyższe (Wilkinson i Dallal, 1981).
- Traktowanie współczynników wybranych zmiennych jak nieobciążonych. Selekcja faworyzuje próby, w których efekt wypadł za duży – w przykładzie średnio o 30%.
- Wniosek, że zmienna, która nie weszła, nie działa. Nastrój miał taki sam efekt jak sen, a trafił do modelu wraz z nim tylko w co trzecim badaniu.
- Raportowanie R² z próby selekcji jako miary trafności prognozy. W nowych danych model wypadł znacznie gorzej. Podaj co najmniej skorygowane R², a najlepiej wynik walidacji.
- Selekcja na małej próbie z wieloma kandydatami. Im więcej kandydatów na osobę, tym więcej zmiennych szumowych w modelu (Derksen i Keselman, 1992).
- Selekcja postępująca bez kontroli współliniowości. Przy skorelowanych kandydatach o kolejności wejścia decydują drobne różnice w próbie, a para zmiennych działających razem może nie wejść wcale.
Najczęstsze pytania
Na czym polega selekcja postępująca w regresji?
Procedura zaczyna od modelu bez predyktorów. W każdym kroku dodaje zmienną, która przy kontroli zmiennych już wybranych ma najmniejsze p, o ile jest ono niższe niż próg wejścia (w SPSS .05). Kończy, gdy żaden z pozostałych kandydatów nie spełnia kryterium; wprowadzonych zmiennych nie usuwa.
Czym różni się metoda forward od metody stepwise?
Selekcja postępująca (forward) tylko dodaje zmienne. Metoda krokowa (stepwise) po każdym dodaniu sprawdza także, czy któraś zmienna w modelu nie przekroczyła progu usunięcia, i może ją wyrzucić. Obie dzielą te same wady wnioskowania po selekcji.
Dlaczego współczynniki po selekcji postępującej są zawyżone?
Słaby, ale prawdziwy efekt przekracza próg wejścia głównie w próbach, w których los zawyżył jego oszacowanie. W symulacji na tej stronie współczynnik snu wynosił w populacji 0.25, a średnio 0.325 w badaniach, w których sen wszedł do modelu. W modelu ze wszystkimi zmiennymi, bez selekcji, średnia była bliska prawdziwej (0.244).
Czy istotny model z selekcji postępującej potwierdza hipotezę?
Nie. Model wybrany spośród wielu kandydatów łatwo osiąga istotność nawet przy braku związków w populacji, dlatego standardowy test F jest zbyt liberalny (Wilkinson i Dallal, 1981). Hipotezy testuj na zaplanowanym zestawie predyktorów, a wynik selekcji traktuj jako eksplorację.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Derksen, S., & Keselman, H. J. (1992). Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables. British Journal of Mathematical and Statistical Psychology, 45(2), 265–282. https://doi.org/10.1111/j.2044-8317.1992.tb00992.x
- Smith, G. (2018). Step away from stepwise. Journal of Big Data, 5(1), Article 32. https://doi.org/10.1186/s40537-018-0143-6 ● Otwarty dostęp
- Steyerberg, E. W., Harrell, F. E., Borsboom, G. J. J. M., Eijkemans, M. J. C., Vergouwe, Y., & Habbema, J. D. F. (2001). Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis. Journal of Clinical Epidemiology, 54(8), 774–781. https://doi.org/10.1016/s0895-4356(01)00341-9
- Wilkinson, L., & Dallal, G. E. (1981). Tests of significance in forward selection regression with an F-to-enter stopping rule. Technometrics, 23(4), 377–380. https://doi.org/10.1080/00401706.1981.10487682
Cytowania BibTeX
@article{derksen1992backward, author={Derksen, Shelley and Keselman, H. J.}, title={{Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables}}, journal={British Journal of Mathematical and Statistical Psychology}, year={1992}, volume={45}, number={2}, pages={265--282}, doi={10.1111/j.2044-8317.1992.tb00992.x}}@article{smith2018step, author={Smith, Gary}, title={{Step away from stepwise}}, journal={Journal of Big Data}, year={2018}, volume={5}, number={1}, eid={32}, doi={10.1186/s40537-018-0143-6}}@article{steyerberg2001internal, author={Steyerberg, Ewout W. and Harrell, Frank E. and Borsboom, Gerard J. J. M. and Eijkemans, Marinus J. C. and Vergouwe, Yvonne and Habbema, J. Dik F.}, title={{Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={8}, pages={774--781}, doi={10.1016/s0895-4356(01)00341-9}}@article{wilkinson1981tests, author={Wilkinson, Leland and Dallal, Gerard E.}, title={{Tests of significance in forward selection regression with an F-to-enter stopping rule}}, journal={Technometrics}, year={1981}, volume={23}, number={4}, pages={377--380}, doi={10.1080/00401706.1981.10487682}}