Randomizacja chroni tylko to, co było przed bodźcem
W eksperymencie ankietowym losowy przydział sprawia, że grupy różnią się przed bodźcem wyłącznie przypadkiem (zob. randomizacja). Do oszacowania efektu wystarcza wtedy porównanie średnich zmiennej zależnej. Ta gwarancja obejmuje jednak tylko zmienne, które istniały, zanim respondent zobaczył bodziec. Wszystko, co zmierzysz później – wiarygodność tekstu, zaufanie do nadawcy, emocje, uwagę, odpowiedź na sprawdzenie manipulacji – może być już skutkiem bodźca.
Montgomery, Nyhan i Torres (2018) wymieniają trzy sposoby, w jakie badacze warunkują na takich zmiennych: kontrolują je w modelu, usuwają obserwacje według kryterium zmierzonego po bodźcu albo analizują tylko podzbiór wyznaczony taką zmienną. Każdy z nich może obciążyć efekt przyczynowy. Autorzy pokazali też, że te praktyki są częste w eksperymentach publikowanych w czołowych czasopismach politologicznych. Problem nie jest nowy. Rosenbaum (1984) opisał konsekwencje korekty na zmienną towarzyszącą, na którą wpłynęło leczenie, już w latach 80.
Dlatego kolejność pytań w ankiecie eksperymentalnej to nie tylko kwestia efektu kolejności pytań. Decyduje też, których zmiennych wolno potem użyć w analizie. Ten wpis jest częścią serii o eksperymentach w ankiecie. Ogólny układ ankiety omawia przewodnik eksperyment w ankiecie online krok po kroku. Tu skupiamy się na dwóch pytaniach: co mierzyć przed bodźcem, a co po nim, i co się dzieje, gdy zmienną zmierzoną po bodźcu potraktujesz jak zmienną kontrolną.
Co mierzyć przed bodźcem, a co po nim
Najprostsza zasada brzmi: zmienne, których chcesz użyć jako kowariantów, moderatorów albo kryteriów podziału, mierz przed bodźcem. Po bodźcu umieść zmienną zależną, a dopiero za nią pytania, których nie zamierzasz używać do korekty ani do podziału na podgrupy.
| Zmienna | Gdzie | Dlaczego |
|---|---|---|
| Kowarianty do ANCOVA (np. postawa wyjściowa, wcześniejszy pomiar zmiennej zależnej) | Przed bodźcem | Zwiększają precyzję, a bodziec nie może ich zmienić |
| Moderatory planowanej analizy podgrup (identyfikacja, ideologia, doświadczenie) | Przed bodźcem, najlepiej oddzielone innymi pytaniami albo w poprzedniej fali | Pomiar po bodźcu przesuwa osoby między podgrupami |
| Cechy stałe (rok urodzenia, wykształcenie, miejsce zamieszkania) | Dowolnie, zwykle na początku | Bodziec nie zmieni faktów, ale może zmienić sposób ich deklarowania |
| Zmienna zależna | Zaraz po bodźcu (ewentualnie po krótkim sprawdzeniu, czy bodziec się wyświetlił) | Każde pytanie pomiędzy może osłabić albo zmienić efekt |
| Faktograficzne sprawdzenie manipulacji | Po zmiennej zależnej | Nie wpływa na odpowiedź na zmienną zależną |
| Mechanizm (np. wiarygodność, emocje), pytania eksploracyjne | Po zmiennej zależnej | To skutki bodźca: analizuj je jako osobne wyniki, nie jako zmienne kontrolne |
Pomiar przed bodźcem ma swoją cenę: pytania mogą zaktywizować myśli związane z tematem (torowanie, ang. priming) albo zdradzić cel badania (zob. charakterystyki żądania). Klar, Leeper i Robison (2020) argumentują, że w eksperymentach dotyczących tożsamości – płci, pochodzenia etnicznego – pytanie o tożsamość tuż przed bodźcem może ją uaktywnić. Dlatego w takich badaniach, zwłaszcza z udziałem kobiet i mniejszości, pomiar po bodźcu bywa uzasadniony. Dane z nowszych badań uspokajają. Sheagley i Clifford (2025) w sześciu eksperymentach z często używanymi moderatorami znaleźli niewiele dowodów torowania, nawet gdy moderator mierzono bezpośrednio przed bodźcem. Wniosek autorów: moderatory mierz przed bodźcem.
Podobnie jest z pomiarem zmiennej zależnej przed bodźcem. Clifford, Sheagley i Piston (2021) porównali w sześciu badaniach schematy z powtórzonym pomiarem zmiennej zależnej ze zwykłym schematem z pomiarem tylko po bodźcu. Wyniki były zwykle te same, a precyzja wyraźnie większa. Praktycznie: gdy obawiasz się torowania, oddziel pomiar wyjściowy od bodźca blokiem niezwiązanych pytań albo zbierz go w poprzedniej fali. Nie przenoś go za bodziec.
Sprawdzenie manipulacji: przed czy po zmiennej zależnej
To najczęstszy dylemat kolejności. Pytanie o to, jak respondent odebrał bodziec, umieszczone przed zmienną zależną, samo staje się częścią manipulacji. Hauser, Ellsworth i Gonzalez (2018) zwracają uwagę, że sprawdzenie manipulacji może wzmocnić, znieść albo zmienić efekt bodźca. Łatwo to zrozumieć: pytanie skłania do namysłu nad tym, co respondent właśnie przeczytał. Umieszczone po zmiennej zależnej jest z kolei zmienną zmierzoną po bodźcu. Możesz je opisać i porównać między warunkami, ale nie używaj go jako zmiennej kontrolnej ani jako filtra.
Pomaga rozróżnienie rodzajów pytań. Sprawdzenie faktograficzne („O jakim programie był artykuł?”) mierzy uwagę wobec bodźca. Kane i Barabas (2019) w czterech replikacjach znaleźli niewiele dowodów, że jego miejsce wpływa na efekt. Umieszczenie go tuż po zmiennej zależnej nie obniżało też odsetka poprawnych odpowiedzi. Sprawdzenie subiektywne („Jak bardzo przekonujący był tekst?”) mierzy już stan wywołany bodźcem, czyli potencjalny mediator. Takie pytanie po zmiennej zależnej jest bezpieczne dla oszacowania efektu, ale jego wynik jest skutkiem bodźca, a nie jego „czystszą” wersją. Szerzej o tym, czy osoby „niezdające” sprawdzenia usuwać, piszemy we wpisie o wykluczaniu respondentów w eksperymencie.
Dlaczego kontrola zmiennej po bodźcu psuje eksperyment
Zmienna zmierzona po bodźcu (oznaczmy ją M) obciąża oszacowanie na dwa sposoby, które zwykle działają jednocześnie.
- Odcięcie części efektu. Jeśli bodziec działa na zmienną zależną Y także przez M, kontrola M usuwa tę część efektu. Zostaje coś, co wygląda na efekt bezpośredni, ale nim nie jest (punkt 2). Pytanie badawcze dotyczyło zwykle efektu całkowitego, czyli tego, co szacuje prosta różnica średnich.
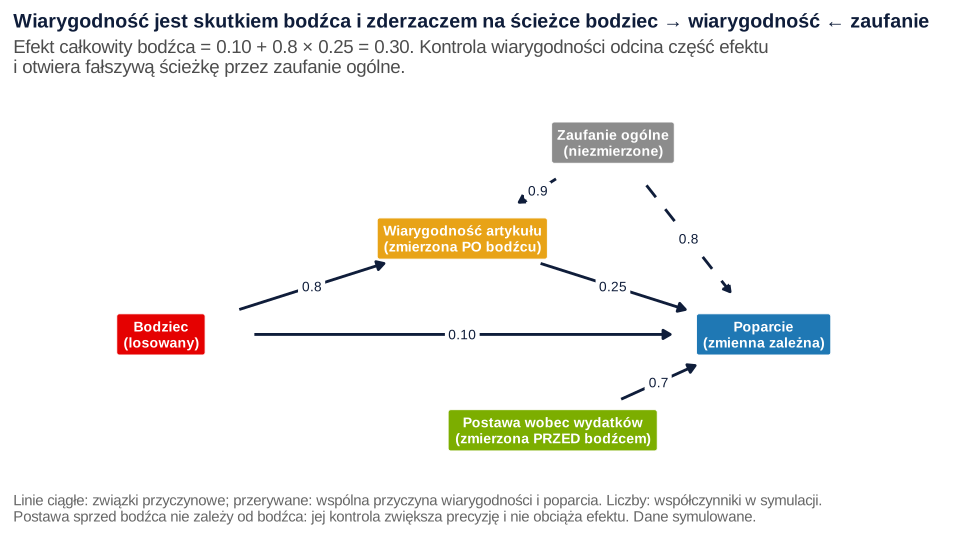
- Otwarcie fałszywej ścieżki. M zależy prawie zawsze także od cech respondenta, które wpływają na Y. Wtedy M jest zmienną zderzeniową na ścieżce bodziec → M ← cecha → Y. Wśród osób o tej samej wartości M grupa z bodźcem musi mieć „mniej” tej cechy, bo część wysokiego M dał jej bodziec. Losowość grup znika.
Cinelli, Forney i Pearl (2024) nazywają takie zmienne „złymi kontrolami”: po ich dodaniu współczynnik przestaje odpowiadać efektowi, który miał reprezentować. W badaniach obserwacyjnych tę samą logikę omawiają wpisy o grafach przyczynowych (DAG) i o błędzie tabeli 2. Eksperyment ma tę przewagę, że żadna kontrola nie jest potrzebna do usunięcia zakłóceń. Każda zmienna dodana do modelu musi więc tylko nie szkodzić. Zmienna sprzed bodźca spełnia ten warunek z definicji, zmienna zmierzona po bodźcu – nie.
Przykład: wiarygodność artykułu jako „zmienna kontrolna”
W symulowanym eksperymencie online 1200 osób losowo czyta jeden z dwóch tekstów (600 + 600). Wersja eksperymentalna to artykuł o tym, że gminny program pomocy psychologicznej dla młodzieży zmniejszył liczbę hospitalizacji. Wersja kontrolna to tekst neutralny o podobnej długości (o wyborze kontroli zob. warunek kontrolny w eksperymencie). Zmienna zależna to poparcie dla finansowania programu z budżetu gminy (1–7). Przed bodźcem respondenci oceniają swoją postawę wobec wydatków na zdrowie. Po zmiennej zależnej oceniają wiarygodność przeczytanego tekstu. Na wiarygodność i na poparcie wpływa też ogólne zaufanie do mediów i instytucji, którego w ankiecie nie zmierzono.
Prawdziwy efekt całkowity bodźca wynosi 0.30 punktu: 0.10 bezpośrednio i 0.20 przez wiarygodność. Bodziec podniósł wiarygodność średnio o 0.84 punktu, a postawy sprzed bodźca nie zmienił (różnica −0.003). Wyniki czterech analiz tych samych danych:
| Analiza | b [95% CI] | SE | n |
|---|---|---|---|
| Różnica średnich | 0.32 [0.14, 0.50] | 0.094 | 1200 |
| ANCOVA z postawą sprzed bodźca | 0.32 [0.16, 0.49] | 0.085 | 1200 |
| + wiarygodność zmierzona po bodźcu | −0.26 [−0.40, −0.13] | 0.069 | 1200 |
| Tylko osoby z wiarygodnością ≥ 5 | −0.13 [−0.39, 0.14] | 0.134 | 399 |
Pierwsze dwie analizy trafiają w efekt. Kowariata sprzed bodźca zmniejszyła błąd standardowy z 0.094 do 0.085 i nie zmieniła oszacowania (więcej o takiej korekcie we wpisie o analizie eksperymentu ankietowego). Po dodaniu wiarygodności efekt zmienia znak: −0.26, p < .001. Mniejszy błąd standardowy (0.069) daje złudzenie precyzji. Nie jest to też efekt bezpośredni (0.10). Wśród osób o tej samej wiarygodności grupa z bodźcem miała zaufanie ogólne niższe o 0.44 SD. W podzbiorze osób, które oceniły tekst jako wiarygodny (≥ 5), średnie zaufanie wynosiło 0.99 w grupie kontrolnej i 0.65 w grupie z bodźcem. Porównujesz więc ludzi, którzy różnią się czymś więcej niż bodźcem.
Żeby wykluczyć przypadek jednej próby, powtórzyliśmy eksperyment 1000 razy (Rysunek 2). Średnie oszacowanie wyniosło 0.301 dla różnicy średnich i 0.303 dla ANCOVA, z pokryciem 95% CI równym .949 i .946 (błąd Monte Carlo ±.007). Model z wiarygodnością dał średnio −0.220 i ujemne oszacowanie we wszystkich 1000 powtórzeniach. Jego przedział nie zawierał ani efektu całkowitego (pokrycie .000), ani bezpośredniego (.001). Analiza podzbioru dała średnio −0.079, z ujemnym znakiem w 72.9% powtórzeń.
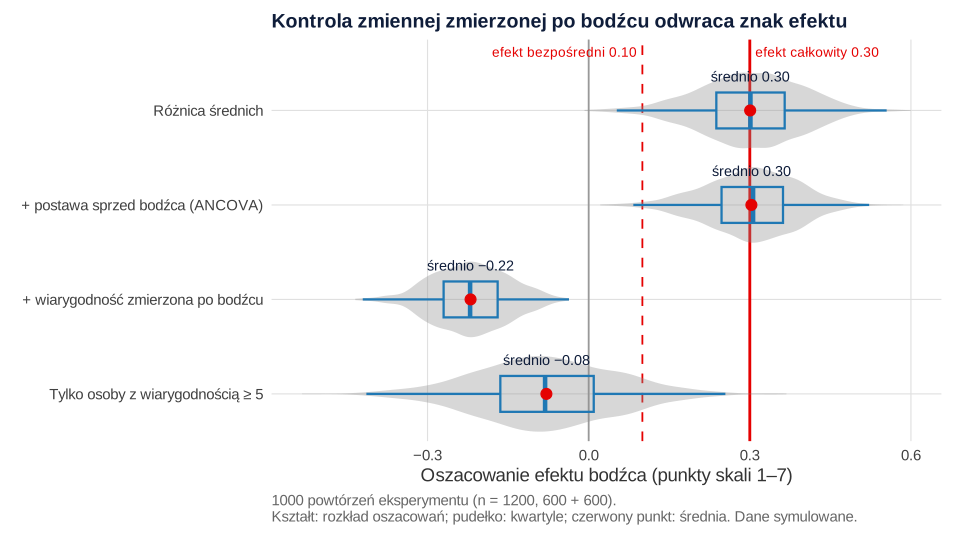
W realnych danych nie znasz prawdziwego efektu, więc nie zobaczysz, że analiza „z kontrolą” się myli. Zobaczysz tylko efekt, który „znika po kontroli wiarygodności” albo „odwraca się”. Kuszą interpretacje typu „bodziec działa wyłącznie przez wiarygodność”. Bez dodatkowych założeń dane ich nie uzasadniają.
Moderator zmierzony po bodźcu
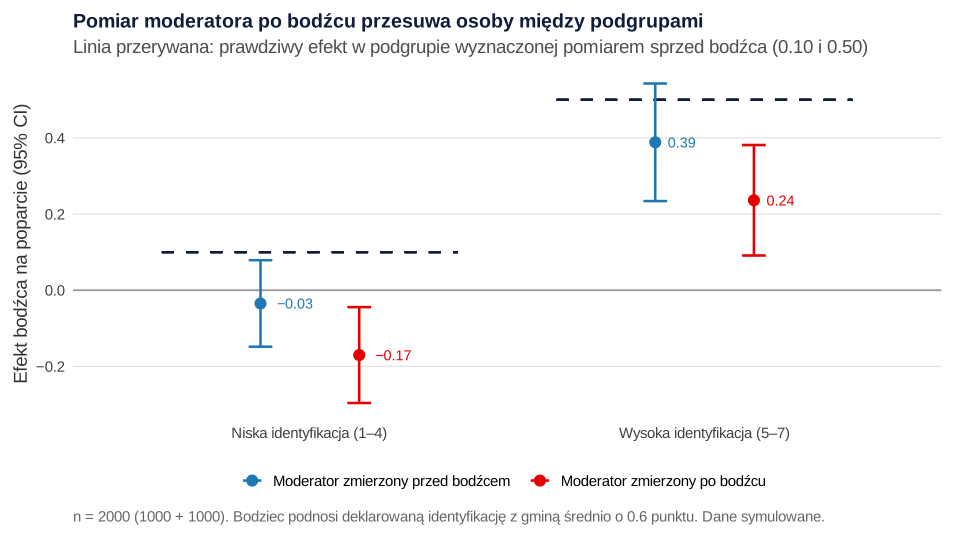
Ten sam problem dotyczy analizy podgrup. W drugim przykładzie (2000 osób, 1000 + 1000) efekt bodźca wynosi 0.10 przy niskiej identyfikacji z gminą (1–4) i 0.50 przy wysokiej (5–7). Bodziec podnosi jednak deklarowaną identyfikację średnio o 0.6 punktu. Przy pomiarze przed bodźcem wysoką identyfikację miało 32.4% osób w grupie kontrolnej i 35.2% w grupie z bodźcem. Przy pomiarze po bodźcu było to 34.3% i 52.3%. Podgrupy przestały być porównywalne: do „wysokiej” identyfikacji w grupie z bodźcem trafiły osoby, które bez bodźca byłyby w niższej.
Efekt w podgrupie wysokiej identyfikacji wyniósł 0.39, 95% CI [0.23, 0.54], przy pomiarze przed bodźcem i 0.24, 95% CI [0.09, 0.38], przy pomiarze po nim. W podgrupie niskiej identyfikacji pomiar po bodźcu dał −0.17, 95% CI [−0.30, −0.04], czyli pozorną szkodę, której w danych nie ma (Rysunek 3). W 1000 powtórzeniach średnie efekty przy pomiarze przed bodźcem wyniosły 0.099 i 0.503, czyli prawie dokładnie wartości prawdziwe. Przy pomiarze po bodźcu wyniosły 0.009 i 0.249: efekt w podgrupie wysokiej był o połowę za mały. Interakcja w tej próbie wyszła podobna w obu wariantach (0.42 i 0.41), więc sam test interakcji nie ostrzeże Cię przed problemem.
Co zrobić zamiast kontroli zmiennej po bodźcu
- Efekt całkowity szacuj bez zmiennych po bodźcu. Analizą główną jest różnica średnich albo ANCOVA z kowariantami zmierzonymi przed bodźcem i wpisanymi do planu analizy.
- Zmienną po bodźcu analizuj jako wynik. Różnica wiarygodności między warunkami (0.84 punktu w przykładzie) to rzetelna informacja o działaniu bodźca.
- Mechanizm badaj jako mediację, z jej założeniami. Oszacowanie efektu pośredniego wymaga założenia, że między mediatorem a zmienną zależną nie ma niezmierzonych zakłóceń. Randomizacja bodźca tego nie zapewnia (zob. mediacja przyczynowa i analiza wrażliwości). Acharya, Blackwell i Sen (2016) proponują skupić się na kontrolowanym efekcie bezpośrednim i szacować go strategią zapożyczoną z biostatystyki zamiast zwykłej regresji z mediatorem. To wymaga zmierzenia przed bodźcem zmiennych zakłócających związek mediatora ze zmienną zależną.
- Jeśli to możliwe, manipuluj mechanizmem. Zamiast mierzyć wiarygodność, dodaj warunek, w którym tekst jest podpisany przez mniej wiarygodne źródło. Wtedy porównujesz losowe grupy (zob. materiały do manipulacji).
- Filtrowanie raportuj obok analizy wszystkich wylosowanych. Jeśli recenzent prosi o wyniki tylko dla „uważnych” albo „przekonanych”, pokaż je jako analizę uzupełniającą i podaj, czy kryterium zależało od warunku.
Jak opisać kolejność pytań i analizę w artykule
W metodzie podaj kolejność bloków ankiety i to, które zmienne zmierzono przed bodźcem. W wynikach odróżnij analizę główną od analiz z mechanizmem. Wzór na podstawie przykładu:
Szerszy wzór sekcji metody i wyników znajdziesz we wpisie jak opisać eksperyment ankietowy. Jeśli recenzent kwestionuje dobór zmiennych kontrolnych w Twoim eksperymencie, możemy przygotować analizę i odpowiedź w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy są niezależne. Pierwszy zapisuje dane do pliku post-treatment-bias.csv (możesz go pobrać tutaj). Potrzebne pakiety: sandwich i lmtest.
1. Eksperyment z kowariatą sprzed bodźca i zmienną zmierzoną po bodźcu
R
# Krok 1. Eksperyment ankietowy: kontrola zmiennej sprzed bodźca i zmiennej zmierzonej po bodźcu (dane symulowane)
# Bodziec: artykuł o skuteczności gminnego programu pomocy psychologicznej dla młodzieży (bodziec = 1) albo artykuł neutralny (bodziec = 0).
# Zmienna zależna: poparcie dla finansowania programu z budżetu gminy (1–7).
suppressPackageStartupMessages({library(sandwich); library(lmtest)})
set.seed(3981)
n <- 1200
zaufanie_ogolne <- rnorm(n)                             # U: ogólne zaufanie do mediów i instytucji (nieobserwowane)
postawa <- rnorm(n)                                     # postawa wobec wydatków na zdrowie, zmierzona PRZED bodźcem
bodziec <- sample(rep(0:1, n / 2))                            # losowy przydział 600 + 600
# Wiarygodność artykułu (1–7), zmierzona PO bodźcu: zależy od bodźca i od zaufania ogólnego
wiarygodnosc <- 4 + 0.8 * bodziec + 0.9 * zaufanie_ogolne + rnorm(n)
# Poparcie (1–7): efekt bezpośredni 0.10, efekt przez wiarygodność 0.25 × 0.8 = 0.20, efekt całkowity 0.30
poparcie <- 4 + 0.10 * bodziec + 0.25 * (wiarygodnosc - 4) + 0.8 * zaufanie_ogolne + 0.7 * postawa + rnorm(n)
d <- data.frame(bodziec, postawa = round(4 + postawa, 2), wiarygodnosc = round(wiarygodnosc, 2), poparcie = round(poparcie, 2))
write.csv(d, "post-treatment-bias.csv", row.names = FALSE)

# Bodziec zmienia wiarygodność (to zmienna PO bodźcu), ale nie postawę (zmienną SPRZED bodźca)
round(c(roznica_postawa = coef(lm(postawa ~ bodziec, d))[["bodziec"]], roznica_wiarygodnosc = coef(lm(wiarygodnosc ~ bodziec, d))[["bodziec"]]), 3)

# Efekt bodźca w czterech analizach (błędy standardowe HC2)
efekt <- function(m) { ct <- coeftest(m, vcov = vcovHC(m, type = "HC2"))["bodziec", ]
  ci <- coefci(m, vcov. = vcovHC(m, type = "HC2"))["bodziec", ]
  c(b = ct[["Estimate"]], SE = ct[["Std. Error"]], dolna = ci[[1]], gorna = ci[[2]], p = ct[["Pr(>|t|)"]], n = nobs(m)) }
wyniki <- rbind(
  roznica_srednich       = efekt(lm(poparcie ~ bodziec, d)),
  kowariata_przed_bodzcem = efekt(lm(poparcie ~ bodziec + postawa, d)),
  kontrola_po_bodzcu     = efekt(lm(poparcie ~ bodziec + postawa + wiarygodnosc, d)),
  tylko_wiarygodny_ge_5  = efekt(lm(poparcie ~ bodziec + postawa, subset(d, wiarygodnosc >= 5))))
round(wyniki, 3)

# Dlaczego: wśród osób o tej samej wiarygodności grupa z bodźcem ma niższe zaufanie ogólne (U)
round(coef(lm(zaufanie_ogolne ~ bodziec + wiarygodnosc))[["bodziec"]], 3)
round(tapply(zaufanie_ogolne[wiarygodnosc >= 5], bodziec[wiarygodnosc >= 5], mean), 3)
Wynik w R
     roznica_postawa roznica_wiarygodnosc
              -0.003                0.844
                             b    SE  dolna  gorna     p    n
roznica_srednich         0.320 0.094  0.136  0.504 0.001 1200
kowariata_przed_bodzcem  0.322 0.085  0.155  0.488 0.000 1200
kontrola_po_bodzcu      -0.261 0.069 -0.396 -0.126 0.000 1200
tylko_wiarygodny_ge_5   -0.128 0.134 -0.392  0.136 0.340  399
[1] -0.443
    0     1
0.986 0.646
2. 1000 powtórzeń: obciążenie i pokrycie przedziałów
R
# Krok 2. 1000 powtórzeń tego samego eksperymentu: obciążenie, rozrzut i pokrycie 95% CI w czterech analizach
# Prawdziwy efekt całkowity bodźca = 0.30, efekt bezpośredni = 0.10. Przepis niezależny od kroku 1.
jeden <- function(n = 1200) {
  u <- rnorm(n); postawa <- rnorm(n); bodziec <- sample(rep(0:1, n / 2))
  wiarygodnosc <- 4 + 0.8 * bodziec + 0.9 * u + rnorm(n)
  poparcie <- 4 + 0.10 * bodziec + 0.25 * (wiarygodnosc - 4) + 0.8 * u + 0.7 * postawa + rnorm(n)
  d <- data.frame(bodziec, postawa, wiarygodnosc, poparcie)
  modele <- list(roznica_srednich = lm(poparcie ~ bodziec, d),
                 kowariata_przed_bodzcem = lm(poparcie ~ bodziec + postawa, d),
                 kontrola_po_bodzcu = lm(poparcie ~ bodziec + postawa + wiarygodnosc, d),
                 tylko_wiarygodny_ge_5 = lm(poparcie ~ bodziec + postawa, subset(d, wiarygodnosc >= 5)))
  t(sapply(modele, function(m) c(b = coef(m)[["bodziec"]], dolna = confint(m)["bodziec", 1], gorna = confint(m)["bodziec", 2])))
}
set.seed(3982)
sym <- replicate(1000, jeden())
podsum <- t(apply(sym, 1, function(x) c(srednia_b = mean(x["b", ]), SD_b = sd(x["b", ]),
  pokrycie_0.30 = mean(x["dolna", ] <= 0.30 & x["gorna", ] >= 0.30),
  pokrycie_0.10 = mean(x["dolna", ] <= 0.10 & x["gorna", ] >= 0.10),
  odsetek_b_ujemnych = mean(x["b", ] < 0))))
round(podsum, 3)
# Błąd Monte Carlo pokrycia przy 1000 powtórzeniach (dla pokrycia .95)
round(sqrt(0.95 * 0.05 / 1000), 3)
oszacowania <- data.frame(analiza = rep(rownames(sym), times = 1000), b = as.vector(sym[, "b", ]))
write.csv(oszacowania, "powtorzenia.csv", row.names = FALSE)
Wynik w R
                        srednia_b  SD_b pokrycie_0.30 pokrycie_0.10
roznica_srednich            0.301 0.096         0.949         0.420
kowariata_przed_bodzcem     0.303 0.086         0.946         0.313
kontrola_po_bodzcu         -0.220 0.070         0.000         0.001
tylko_wiarygodny_ge_5      -0.079 0.132         0.195         0.740
                        odsetek_b_ujemnych
roznica_srednich                     0.002
kowariata_przed_bodzcem              0.000
kontrola_po_bodzcu                   1.000
tylko_wiarygodny_ge_5                0.729
[1] 0.007
3. Moderator zmierzony przed bodźcem i po nim
R
# Krok 3. Moderator zmierzony przed bodźcem czy po nim: identyfikacja z gminą (1–7) jako moderator efektu bodźca
# Prawdziwy efekt bodźca: 0.10 przy niskiej i 0.50 przy wysokiej identyfikacji (podział według pomiaru sprzed bodźca).
# Bodziec podnosi deklarowaną identyfikację średnio o 0.6 punktu, więc pomiar po bodźcu jest już jego skutkiem.
suppressPackageStartupMessages({library(sandwich); library(lmtest)})
set.seed(3983)
n <- 2000
ident_przed <- round(pmin(pmax(rnorm(n, 4, 1.2), 1), 7))           # pomiar sprzed bodźca (np. w części metryczkowej na początku)
bodziec <- sample(rep(0:1, n / 2))
wysoka <- as.integer(ident_przed >= 5)
poparcie <- 4 + 0.3 * (ident_przed - 4) + bodziec * (0.10 + 0.40 * wysoka) + rnorm(n)
ident_po <- round(pmin(pmax(ident_przed + 0.6 * bodziec + rnorm(n, 0, 0.5), 1), 7))   # ten sam pomiar, ale po bodźcu
d <- data.frame(bodziec, ident_przed, ident_po, poparcie, wysoka_przed = wysoka, wysoka_po = as.integer(ident_po >= 5))

# Odsetek osób z „wysoką” identyfikacją w warunkach: przed bodźcem równy, po bodźcu już nie
round(100 * rbind(przed = tapply(d$wysoka_przed, d$bodziec, mean), po = tapply(d$wysoka_po, d$bodziec, mean)), 1)

# Efekt bodźca w podgrupach (różnica średnich z 95% CI, HC2) i interakcja
w_podgrupie <- function(zm, poziom) { m <- lm(poparcie ~ bodziec, subset(d, d[[zm]] == poziom))
  c(b = coef(m)[["bodziec"]], coefci(m, vcov. = vcovHC(m, type = "HC2"))["bodziec", ], n = nobs(m)) }
round(rbind(niska_przed = w_podgrupie("wysoka_przed", 0), wysoka_przed = w_podgrupie("wysoka_przed", 1),
            niska_po = w_podgrupie("wysoka_po", 0), wysoka_po = w_podgrupie("wysoka_po", 1)), 3)
interakcja <- function(f) { m <- lm(f, d); ct <- coeftest(m, vcov = vcovHC(m, type = "HC2"))
  ct[nrow(ct), c("Estimate", "Std. Error", "Pr(>|t|)")] }
round(rbind(moderator_przed = interakcja(poparcie ~ bodziec * wysoka_przed),
            moderator_po = interakcja(poparcie ~ bodziec * wysoka_po)), 3)
write.csv(d, "moderator-przed-po.csv", row.names = FALSE)

# 1000 powtórzeń: średnie oszacowanie efektu w podgrupach przy pomiarze moderatora przed i po bodźcu
jeden <- function(n = 2000) {
  ip <- round(pmin(pmax(rnorm(n, 4, 1.2), 1), 7)); b <- sample(rep(0:1, n / 2)); w <- as.integer(ip >= 5)
  y <- 4 + 0.3 * (ip - 4) + b * (0.10 + 0.40 * w) + rnorm(n)
  wpo <- as.integer(round(pmin(pmax(ip + 0.6 * b + rnorm(n, 0, 0.5), 1), 7)) >= 5)
  roznica <- function(g) mean(y[g & b == 1]) - mean(y[g & b == 0])
  c(niska_przed = roznica(w == 0), wysoka_przed = roznica(w == 1), niska_po = roznica(wpo == 0), wysoka_po = roznica(wpo == 1))
}
set.seed(3984)
round(rowMeans(replicate(1000, jeden())), 3)
Wynik w R
         0    1
przed 32.4 35.2
po    34.3 52.3
                  b  2.5 % 97.5 %    n
niska_przed  -0.035 -0.148  0.079 1324
wysoka_przed  0.389  0.234  0.543  676
niska_po     -0.170 -0.296 -0.044 1134
wysoka_po     0.236  0.091  0.381  866
                Estimate Std. Error Pr(>|t|)
moderator_przed    0.423      0.098        0
moderator_po       0.406      0.098        0
 niska_przed wysoka_przed     niska_po    wysoka_po
       0.099        0.503        0.009        0.249
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje lm() i confint() z pakietu stats) z pakietami sandwich (vcovHC()) i lmtest (coeftest(), coefci()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Kontrolowaliśmy wiarygodność, uwagę i nastrój, żeby wyizolować efekt”. W eksperymencie nie ma czego izolować. Zmienne po bodźcu wprowadzają obciążenie, a nie je usuwają.
- Metryczka z pytaniami o tożsamość na końcu, a potem analiza podgrup. Jeśli bodziec dotyczył tożsamości, deklaracje mogą już od niego zależeć. Mierz moderatory przed bodźcem albo w poprzedniej fali.
- Subiektywne sprawdzenie manipulacji przed zmienną zależną. Może zmienić efekt. Daj zmienną zależną zaraz po bodźcu, a sprawdzenie – po niej.
- Analiza tylko osób, które „zdały” sprawdzenie manipulacji. To warunkowanie na zmiennej po bodźcu. Raportuj analizę wszystkich wylosowanych jako główną.
- Interpretacja zaniku efektu po kontroli mediatora jako dowodu mechanizmu. Zanik albo zmiana znaku mogą wynikać z otwarcia ścieżki przez zderzacz.
- Pomiar wyjściowy zmiennej zależnej przeniesiony za bodziec z obawy przed torowaniem. Lepiej oddzielić go od bodźca innymi pytaniami. Po bodźcu przestaje być kowariatą.
Przed uruchomieniem eksperymentu sprawdź
- Czy każda zmienna, której użyjesz jako kowariaty, moderatora albo kryterium wykluczenia, jest w ankiecie przed bodźcem?
- Czy zmienna zależna stoi zaraz po bodźcu, a sprawdzenie manipulacji i pytania o mechanizm – po niej?
- Czy pomiar wyjściowy i moderatory są oddzielone od bodźca blokiem neutralnych pytań albo zebrane w poprzedniej fali?
- Czy plan analizy wymienia z nazwy kowarianty i zawiera zdanie, że zmiennych po bodźcu nie włączasz do modelu głównego?
- Czy pytania o mechanizm mają osobne hipotezy i osobny opis jako wyniki drugorzędne?
- Czy w teście technicznym sprawdziłeś, że kolejność bloków jest taka sama w obu warunkach (zob. randomizacja w ankiecie online)?
Najczęstsze pytania
Czy w eksperymencie można kontrolować zmienne zmierzone po manipulacji?
Nie w analizie głównej. Jeśli bodziec mógł zmienić taką zmienną, jej kontrola odcina część efektu i zwykle otwiera fałszywą ścieżkę przez cechy respondenta, które wpływają na nią i na zmienną zależną. W przykładzie na tej stronie kontrola wiarygodności tekstu zmieniła efekt z 0.32 na −0.26. Kontroluj tylko zmienne zmierzone przed bodźcem.
Sprawdzenie manipulacji przed czy po zmiennej zależnej?
Zwykle po. Pytanie o odbiór bodźca zadane przed zmienną zależną może samo wzmocnić albo osłabić efekt. Faktograficzne pytanie o treść bodźca umieszczone tuż po zmiennej zależnej w badaniach Kane’a i Barabasa nie obniżało odsetka poprawnych odpowiedzi, a miejsce takiego pytania w niewielkim stopniu wpływało na efekt. Wynik sprawdzenia opisz, ale nie używaj go jako zmiennej kontrolnej.
Gdzie w ankiecie eksperymentalnej umieścić metryczkę?
Cechy, których użyjesz jako kowariantów albo moderatorów, umieść przed bodźcem, najlepiej oddzielone od niego innymi pytaniami. Na koniec przenieś tylko pytania, których nie użyjesz w analizie efektu. Wyjątek to badania nad tożsamością, gdzie pytanie tuż przed bodźcem może ją uaktywnić; wtedy rozważ pomiar w poprzedniej fali.
Czy pytania przed bodźcem nie zmienią wyników eksperymentu?
Mogą, ale ryzyko bywa mniejsze, niż się zakłada. W sześciu eksperymentach Sheagleya i Clifforda niewiele wskazywało na torowanie, nawet gdy moderator mierzono tuż przed bodźcem, a powtórzony pomiar zmiennej zależnej w badaniach Clifforda i współpracowników dawał te same wyniki przy większej precyzji. Gdy obawiasz się torowania, oddziel te pytania od bodźca neutralnym blokiem.
Jak sprawdzić, czy bodziec działa przez mediator, skoro nie wolno go kontrolować?
Analizuj mediator najpierw jako osobny wynik eksperymentu. Efekt pośredni szacuj w ramach analizy mediacji, z założeniem braku niezmierzonych zakłóceń między mediatorem a zmienną zależną i z analizą wrażliwości. Najmocniejszy dowód daje dodatkowy warunek, w którym manipulujesz samym mechanizmem.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikWykluczanie respondentów w eksperymencie
Pytania kontrolne przed i po bodźcu, czas wypełniania, przerwania i granice Lee: które wykluczenia zachowują losowe porównanie.
Czytaj →PoradnikAnaliza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →Recenzent pyta o zmienne kontrolne w Twoim eksperymencie?
Pomożemy ułożyć kolejność pytań przed zbieraniem danych, wybrać kowarianty do planu analizy, oszacować efekt bez obciążenia i opisać analizy mechanizmu tak, żebyś mógł(a) samodzielnie obronić je przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Acharya, A., Blackwell, M., & Sen, M. (2016). Explaining causal findings without bias: Detecting and assessing direct effects. American Political Science Review, 110(3), 512–529. https://doi.org/10.1017/s0003055416000216 ● Otwarty dostęp: pełny tekst
- Cinelli, C., Forney, A., & Pearl, J. (2024). A crash course in good and bad controls. Sociological Methods & Research, 53(3), 1071–1104. https://doi.org/10.1177/00491241221099552 ● Otwarty dostęp: pełny tekst
- Clifford, S., Sheagley, G., & Piston, S. (2021). Increasing precision without altering treatment effects: Repeated measures designs in survey experiments. American Political Science Review, 115(3), 1048–1065. https://doi.org/10.1017/s0003055421000241 ● Otwarty dostęp: pełny tekst
- Hauser, D. J., Ellsworth, P. C., & Gonzalez, R. (2018). Are manipulation checks necessary? Frontiers in Psychology, 9, Article 998. https://doi.org/10.3389/fpsyg.2018.00998 ● Otwarty dostęp
- Kane, J. V., & Barabas, J. (2019). No harm in checking: Using factual manipulation checks to assess attentiveness in experiments. American Journal of Political Science, 63(1), 234–249. https://doi.org/10.1111/ajps.12396
- Klar, S., Leeper, T., & Robison, J. (2020). Studying identities with experiments: Weighing the risk of posttreatment bias against priming effects. Journal of Experimental Political Science, 7(1), 56–60. https://doi.org/10.1017/xps.2019.26
- Montgomery, J. M., Nyhan, B., & Torres, M. (2018). How conditioning on posttreatment variables can ruin your experiment and what to do about it. American Journal of Political Science, 62(3), 760–775. https://doi.org/10.1111/ajps.12357 ● Otwarty dostęp
- Rosenbaum, P. R. (1984). The consequences of adjustment for a concomitant variable that has been affected by the treatment. Journal of the Royal Statistical Society. Series A (General), 147(5), 656–666. https://doi.org/10.2307/2981697
- Sheagley, G., & Clifford, S. (2025). No evidence that measuring moderators alters treatment effects. American Journal of Political Science, 69(1), 49–63. https://doi.org/10.1111/ajps.12814 ● Otwarty dostęp
Cytowania BibTeX
@article{acharya2016explaining, author={Acharya, Avidit and Blackwell, Matthew and Sen, Maya}, title={{Explaining causal findings without bias: Detecting and assessing direct effects}}, journal={American Political Science Review}, year={2016}, volume={110}, number={3}, pages={512--529}, doi={10.1017/s0003055416000216}}@article{cinelli2024crash, author={Cinelli, Carlos and Forney, Andrew and Pearl, Judea}, title={{A crash course in good and bad controls}}, journal={Sociological Methods \& Research}, year={2024}, volume={53}, number={3}, pages={1071--1104}, doi={10.1177/00491241221099552}}@article{clifford2021increasing, author={Clifford, Scott and Sheagley, Geoffrey and Piston, Spencer}, title={{Increasing precision without altering treatment effects: Repeated measures designs in survey experiments}}, journal={American Political Science Review}, year={2021}, volume={115}, number={3}, pages={1048--1065}, doi={10.1017/s0003055421000241}}@article{hauser2018are, author={Hauser, David J. and Ellsworth, Phoebe C. and Gonzalez, Richard}, title={{Are manipulation checks necessary?}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={998}, doi={10.3389/fpsyg.2018.00998}}@article{kane2019no, author={Kane, John V. and Barabas, Jason}, title={{No harm in checking: Using factual manipulation checks to assess attentiveness in experiments}}, journal={American Journal of Political Science}, year={2019}, volume={63}, number={1}, pages={234--249}, doi={10.1111/ajps.12396}}@article{klar2020studying, author={Klar, Samara and Leeper, Thomas and Robison, Joshua}, title={{Studying identities with experiments: Weighing the risk of posttreatment bias against priming effects}}, journal={Journal of Experimental Political Science}, year={2020}, volume={7}, number={1}, pages={56--60}, doi={10.1017/xps.2019.26}}@article{montgomery2018how, author={Montgomery, Jacob M. and Nyhan, Brendan and Torres, Michelle}, title={{How conditioning on posttreatment variables can ruin your experiment and what to do about it}}, journal={American Journal of Political Science}, year={2018}, volume={62}, number={3}, pages={760--775}, doi={10.1111/ajps.12357}}@article{rosenbaum1984consequences, author={Rosenbaum, Paul R.}, title={{The consequences of adjustment for a concomitant variable that has been affected by the treatment}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1984}, volume={147}, number={5}, pages={656--666}, doi={10.2307/2981697}}@article{sheagley2025no, author={Sheagley, Geoffrey and Clifford, Scott}, title={{No evidence that measuring moderators alters treatment effects}}, journal={American Journal of Political Science}, year={2025}, volume={69}, number={1}, pages={49--63}, doi={10.1111/ajps.12814}}