Dobry bodziec zmienia jedną rzecz
W eksperymencie ankietowym manipulacja eksperymentalna to zwykle tekst, grafika, zdjęcie albo krótki film, który respondent zobaczy w swoim warunku. Z wpisu eksperyment w ankiecie online krok po kroku wiesz, gdzie bodziec stoi w ankiecie. Tu zajmujemy się samym materiałem: jak go napisać, sprawdzić przed badaniem i przygotować w kilku wersjach tak, żeby wynik dotyczył konstruktu, a nie jednego tekstu.
Dobry bodziec ma trafność teoretyczną: zmienia stan, o który chodzi w hipotezie, i niczego więcej. Jeśli komunikat z normą społeczną jest też dłuższy, bardziej wzruszający albo mniej wiarygodny niż komunikat kontrolny, warunki różnią się kilkoma cechami naraz. Każda z nich to zmienna zakłócająca wbudowana w procedurę. Randomizacja nic tu nie pomoże, bo zakłócenie jest w samym materiale, a nie w ludziach. Wells i Windschitl (1999) podkreślają, że brak próbkowania bodźców zagraża nie tylko uogólnianiu wyników, lecz także właśnie trafności teoretycznej.
W praktyce takie zakłócenia są częste. Chester i Lasko (2021) przejrzeli 348 manipulacji z jednego rocznika czołowego czasopisma psychologii społecznej. Większość materiałów przygotowano na potrzeby jednego badania, bez wcześniejszej walidacji. Pilotaż albo sprawdzenie manipulacji miała mniejszość, a około dwóch piątych manipulacji opierało się wyłącznie na tym, że „wyglądały na trafne”.
| Niezamierzona różnica | Czym grozi | Jak wyrównać |
|---|---|---|
| Długość tekstu, czas oglądania | Inny poziom zmęczenia i uwagi; różny czas wypełniania w warunkach | Ta sama liczba słów (±5%) i zdań, ten sam czas filmu |
| Ładunek emocjonalny | Efekt nastroju zamiast efektu treści | Neutralne słownictwo w obu wersjach; ocena poruszenia w preteście |
| Wiarygodność, źródło | Efekt zaufania do nadawcy | To samo źródło i format; ocena wiarygodności w preteście |
| Trudność, nowość informacji | Efekt zrozumienia albo zaskoczenia | Ten sam poziom języka; pytanie o zrozumiałość w preteście |
| Szata graficzna, zdjęcie | Efekt atrakcyjności zamiast treści | Ten sam szablon; ilustracja wspólna albo losowana niezależnie od warunku |
Siła manipulacji a realizm
Drugi kompromis dotyczy siły. Słaba manipulacja to częsta przyczyna wyników nieistotnych: komunikat, którego nikt nie zauważył, nie zmieni postaw. Zbyt silna manipulacja ma inne koszty. Przerysowany tekst („98% Twoich sąsiadów…”) bywa mało wiarygodny, zdradza cel badania i zaprasza do odpowiadania „pod hipotezę”. Orne (1962) opisał, że osoby badane odczytują wskazówki o tym, czego oczekuje badacz, i że to, czy wpływają one na zachowanie, jest kwestią empiryczną (zob. charakterystyki żądania). Bodziec oderwany od rzeczywistości obniża też trafność ekologiczną: efekt fikcyjnej, skrajnej informacji niewiele mówi o działaniu informacji, które ludzie spotykają naprawdę.
Praktyczna reguła: buduj bodziec z elementów, które mogłyby pojawić się w realnym komunikacie, i zwiększaj siłę przez wyrazistość oraz położenie kluczowej informacji (na początku, w nagłówku), a nie przez przesadę. Jeśli bodziec zawiera nieprawdziwe dane, na przykład wymyślony odsetek, to już zwodzenie. Potrzebujesz wtedy uzasadnienia dla komisji etycznej i debriefingu (zob. zwodzenie i debriefing w ankiecie online). Siła zależy też od porównania – wybór kontroli opisuje wpis warunek kontrolny w eksperymencie.
Przykład: komunikat o normie i komunikat kontrolny
W przykładzie (dane symulowane) badamy, czy informacja o normie opisowej („większość mieszkańców oszczędza energię”) zwiększa deklarowaną gotowość do oszczędzania energii. Zmienną zależną jest średnia z trzech pozycji na skali 1–7. Komunikat kontrolny ma tę samą długość, źródło i układ, ale zamiast informacji o innych ludziach podaje neutralną informację o zużyciu energii.
| Element | Wersja z normą | Wersja kontrolna |
|---|---|---|
| Nagłówek i źródło | „Energia w Twoim mieście” – biuletyn miejski | „Energia w Twoim mieście” – biuletyn miejski |
| Zdanie otwierające | „Większość mieszkańców Twojego miasta w ostatnim roku ograniczyła zużycie prądu w domu.” | „Zużycie prądu w domach zależy głównie od ogrzewania wody, oświetlenia i sprzętu AGD.” |
| Rozwinięcie (2–3 zdania) | Jak sąsiedzi to robią: wyłączanie urządzeń z trybu czuwania, krótsze pranie | Jakie urządzenia zużywają najwięcej energii: czajnik, pralka, tryb czuwania |
| Zakończenie | Te same dwie wskazówki praktyczne | Te same dwie wskazówki praktyczne |
| Forma | Ok. 90 słów, 5 zdań, bez zdjęcia | Ok. 90 słów, 5 zdań, bez zdjęcia |
Wskazówki praktyczne są w obu wersjach, więc efekt nie wynika z samej wiedzy, jak oszczędzać. Zdanie o „większości mieszkańców” musi być prawdziwe albo ujęte w debriefingu jako fikcja.
Jeden tekst to jeden przypadek: wiele wersji bodźca
Nawet najlepiej wyrównany tekst ma cechy, których nie przewidzisz. Jeśli każdy warunek ma jeden tekst, różnica między warunkami jest jednocześnie różnicą między dwoma konkretnymi tekstami. Żadna analiza tego nie rozdzieli. Jackson i Jacobs (1983) opisali ten problem w badaniach nad komunikatami. Gdy jeden komunikat reprezentuje całą kategorię, różnica między kategoriami może odzwierciedlać tylko cechy pojedynczych przypadków. Zalecili kilka komunikatów w każdej kategorii, analizowanych jako zagnieżdżone efekty losowe. Problem nie zniknął. Reeves i in. (2016) przeanalizowali 306 badań z psychologii mediów. W 65% eksperymentów na warunek przypadał jeden przykład materiału medialnego, choć wnioski dotyczyły szerokich kategorii mediów.
Rozwiązaniem jest próbkowanie bodźców (stimulus sampling): przygotuj kilka wersji każdego warunku i losuj respondentowi zarówno warunek, jak i wersję. Wersje powinny różnić się tym, co nieistotne dla hipotezy, czyli sformułowaniami, przykładami i kolejnością zdań. Składnik aktywny ma pozostać ten sam. Dobrym sposobem jest zlecenie napisania wersji kilku osobom według tej samej instrukcji.
Wersje trzeba potem uwzględnić w analizie jako efekt losowy. Judd i in. (2012) pokazali, że pomijanie losowej zmienności bodźców prowadzi do znacznych obciążeń, i zaproponowali modele mieszane jako ogólne rozwiązanie. W eksperymencie ankietowym każda osoba widzi zwykle jedną wersję, a każda wersja należy do jednego warunku. Wersje są więc zagnieżdżone w warunku, a nie skrzyżowane z osobami. Schematy, w których każdy uczestnik ocenia wiele bodźców, omawia wpis efekty skrzyżowane: uczestnicy × bodźce. Gdy respondent ocenia wiele opisów różniących się kilkoma cechami, właściwym narzędziem jest eksperyment conjoint lub winietowy.
Wyrównanie wersji: długość, czytelność, czas czytania
Zanim wyślesz materiały do pretestu, wyrównaj je na tym, co da się zmierzyć bez respondentów:
- Liczba słów i zdań. Policz w edytorze i zapisz w tabeli materiałów.
- Czytelność. Podobna średnia długość zdań, brak specjalistycznych terminów w jednej wersji, ten sam rejestr języka. Jeśli używasz wskaźnika czytelności, licz go jednym narzędziem dla wszystkich wersji.
- Czas ekspozycji. Przy filmach i nagraniach – identyczna długość. Przy tekstach zaplanuj pomiar czasu na stronie z bodźcem.
- Forma techniczna. Ten sam szablon strony, czcionka, położenie na ekranie i wygląd na telefonie.
Wyrównany czas czytania ma też znaczenie analityczne. Jeśli komunikat z normą jest wyraźnie dłuższy, osoby w tym warunku będą wypełniać ankietę dłużej. Wtedy kryterium „zbyt szybkich” odpowiedzi (speeding) usunie z warunków różne osoby. O tym, dlaczego to obciąża wynik, piszemy we wpisie wykluczanie respondentów w eksperymencie.
Pretest materiałów na osobnej próbie
W preteście materiałów osoby z tej samej populacji co próba główna, ale spoza eksperymentu, oceniają kandydackie wersje bodźca. Pytasz o wymiar docelowy (czy tekst przekazuje normę) i o wymiary, które mają się nie różnić (wiarygodność, poruszenie, zrozumiałość). Nie pytasz o zmienną zależną, bo pretest ma sprawdzić materiał, a nie hipotezę. To inny cel niż ogólne badanie pilotażowe, w którym sprawdzasz procedurę.
W przykładzie przygotowaliśmy po pięć kandydackich tekstów na warunek (N1–N5 i K1–K5). 150 osób oceniło po cztery losowo wybrane teksty, więc każdy tekst dostał od 47 do 76 ocen. Przed pretestem zapisaliśmy regułę: odrzucamy tekst, którego średnia wiarygodność albo poruszenie odstaje o więcej niż 0.5 punktu od mediany wszystkich tekstów. Reguła odrzuciła N4 (wiarygodność 3.89, przy pozostałych tekstach od 4.51 do 5.02) i K2 (poruszenie 4.02, przy pozostałych od 2.66 do 3.13). Rysunek 1 pokazuje profil wszystkich tekstów.
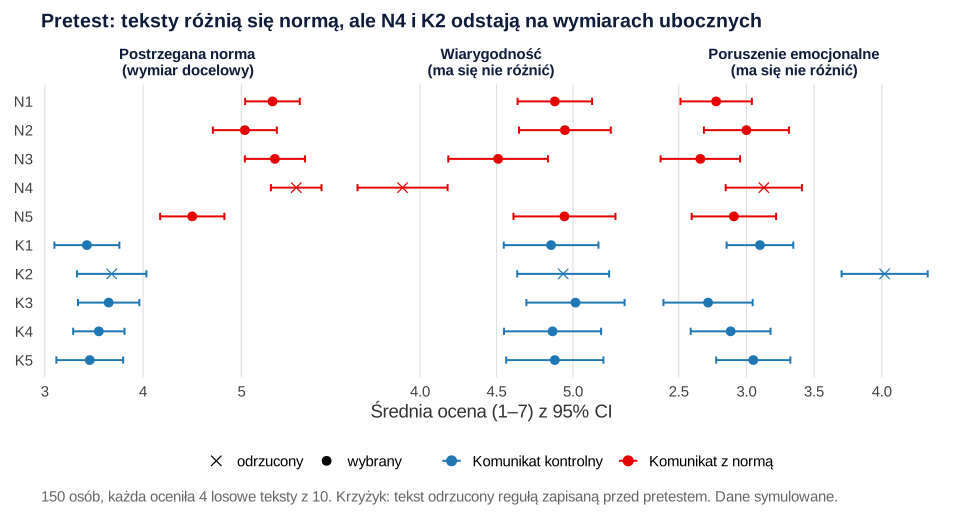
Dla ośmiu wybranych tekstów policzyliśmy model mieszany z osobami i tekstami jako czynnikami losowymi, bo każda osoba oceniała kilka tekstów. Teksty z normą podnosiły postrzeganą normę o 1.545 punktu, 90% CI [1.189, 1.901], p < .001. Siła manipulacji jest więc duża. Zwróć uwagę na stopnie swobody, około 5.7. Wynikają z liczby tekstów, a nie z liczby ocen. Najsłabszy był N5 (4.50), ale reguła dotyczyła tylko wymiarów ubocznych, więc tekst został.
Na wymiarach ubocznych nie wystarczy brak istotnej różnicy. Brak istotności w małym preteście nie dowodzi, że różnicy nie ma. Użyj testu równoważności TOST z najmniejszą różnicą, która ma znaczenie, ustaloną z góry. Lakens i in. (2018) opisują, jak w ten sposób odrzucić efekty co najmniej tak duże jak ta granica. Przy granicy ±0.5 punktu różnica wiarygodności wyniosła −0.030, 90% CI [−0.194, 0.134], pTOST < .001, a różnica poruszenia −0.109, 90% CI [−0.315, 0.097], pTOST = .006. Oba przedziały mieszczą się w granicach, więc wersje są równoważne na tych wymiarach. Wybrane teksty miały średnio 89.00 i 89.75 słowa, a mediana czasu czytania wyniosła 25.9 s w warunku z normą i 24.6 s w kontrolnym. W modelu wiarygodności wariancja tekstów oszacowała się na zero (komunikat singular fit). Stopnie swobody wzrosły wtedy do 391, a test stał się mniej ostrożny.
Jedno zastrzeżenie: teksty wybraliśmy na podstawie tych samych ocen, na których sprawdzamy równoważność. Wybór tekstów, które wypadły „dobrze”, częściowo wykorzystuje przypadek, a powtórny pomiar zwykle wypadnie mniej korzystnie (regresja do średniej). Jeśli budżet pozwala, potwierdź profil wybranych tekstów na nowej, małej próbie. Możesz też zmierzyć wymiary uboczne w badaniu głównym, po zmiennej zależnej.
Badanie główne: wersja jako czynnik losowy
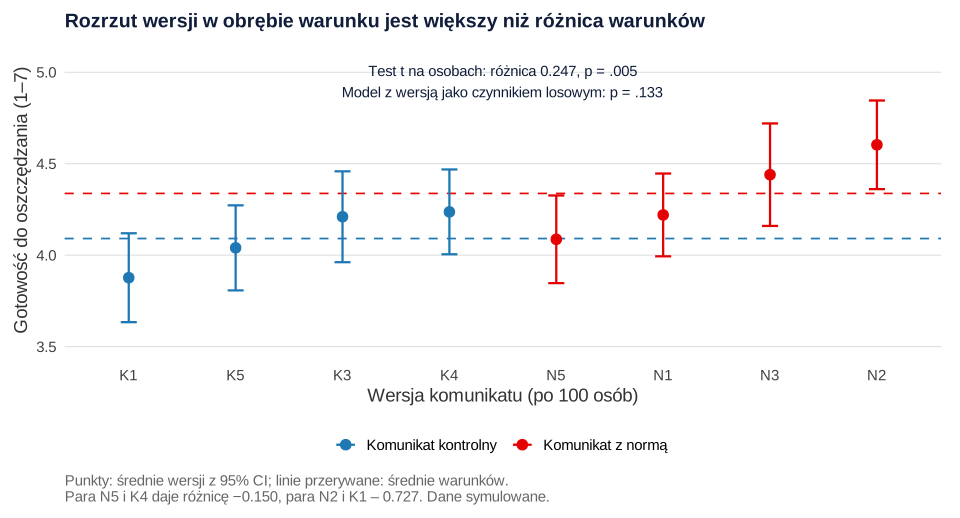
W badaniu głównym 800 osób losowo przydzielono do jednej z ośmiu wersji (po 100), czyli do warunku i do wersji w jego obrębie. Średnia gotowość do oszczędzania wahała się od 3.88 do 4.24 w wersjach kontrolnych i od 4.09 do 4.60 w wersjach z normą (Rysunek 2). Rozrzut wersji w obrębie warunku (0.36 i 0.51 punktu) był więc większy niż różnica między warunkami.
Dwie analizy tych samych danych prowadzą do różnych wniosków:
- Test t na wszystkich osobach, który pomija wersje: różnica 0.25 punktu, 95% CI [0.075, 0.418], t(798) = 2.82, p = .005, d = 0.20.
- Model mieszany z wersją jako losowym wyrazem wolnym (
lmer(gotowosc ~ war + (1 | wersja)), stopnie swobody według Satterthwaite’a): ta sama różnica 0.25, ale SE = 0.14, 95% CI [−0.10, 0.59], t(6.0) = 1.74, p = .133.
Odchylenie standardowe wersji wyniosło 0.16 punktu wobec 1.23 dla reszty. Wersje odpowiadały więc tylko za 1.6% wariancji, czyli ICC = .016. Mimo to zmieniły wniosek. Liczy się bowiem to, że uogólnienie na „komunikaty z normą” opiera się na czterech tekstach na warunek, a nie na 800 osobach. Test t pyta o te konkretne teksty, model mieszany – o komunikaty z normą jako kategorię.
W tej symulacji prawdziwy efekt istnieje (0.25 punktu). Wynik modelu znaczy, że cztery wersje na warunek to za mało, żeby go wiarygodnie wykazać. Gdyby badanie miało jeden tekst na warunek, wynik zależałby od tego, który tekst napisano. Spośród 16 możliwych par „norma–kontrola” różnice wahały się od −0.15 (N5 z K4) do 0.73 punktu (N2 z K1), a 7 par dało p < .05.
Ile kosztuje jeden bodziec: symulacja
Powtórzyliśmy eksperyment 500 razy dla 1, 2, 4 i 8 wersji na warunek. Za każdym razem badaliśmy 800 osób, przy SD wersji 0.15 i SD reszty 1.2. Prawdziwy efekt wynosił 0 (fałszywie istotne wyniki) albo 0.25 punktu (moc). Wyniki pokazuje Rysunek 3.
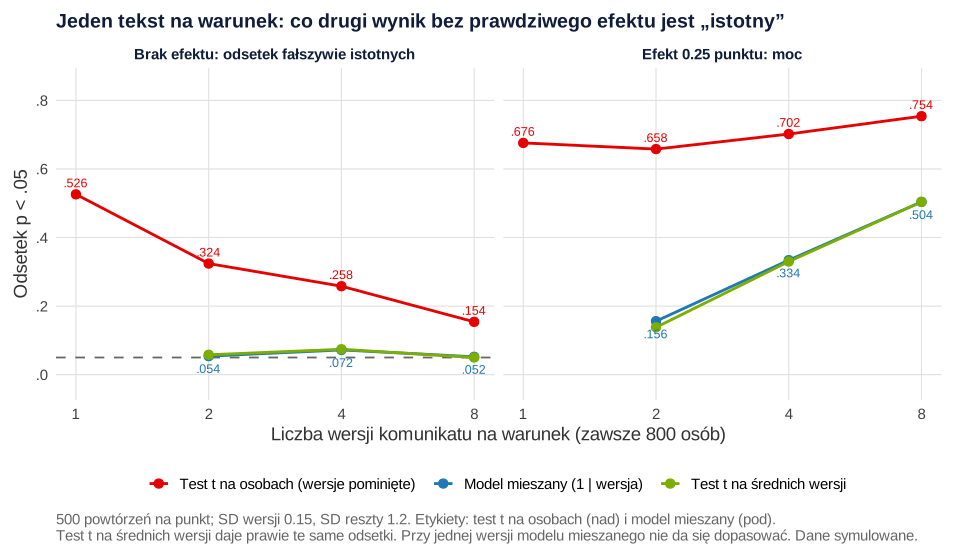
- Jeden tekst na warunek. Bez żadnego efektu manipulacji test t dał wynik istotny w 52.6% badań. Modelu z wersją jako czynnikiem losowym nie da się dopasować, bo wersja i warunek to to samo.
- Kilka wersji, analiza je pomija. Fałszywie istotnych wyników było mniej, ale wciąż dużo: 32.4% przy dwóch, 25.8% przy czterech i 15.4% przy ośmiu wersjach. Samo przygotowanie wielu wersji nie wystarczy.
- Kilka wersji w modelu mieszanym. Odsetek fałszywie istotnych wyników był bliski nominalnym 5%: 5.4%, 7.2% i 5.2% (błąd Monte Carlo ok. 1 punktu procentowego). Prosty test t na średnich wersji dał prawie te same odsetki. W schemacie zrównoważonym to dobra kontrola wyniku modelu.
- Moc rośnie z liczbą wersji, nie osób. Przy prawdziwym efekcie 0.25 punktu moc modelu mieszanego wyniosła .156 przy dwóch wersjach, .334 przy czterech i .504 przy ośmiu, przy tej samej liczbie 800 osób.
Westfall i in. (2014) pokazali, że gdy bodźce są czynnikiem losowym, moc nie zbliża się do 1 wraz z liczbą uczestników. Dąży do maksimum zależnego od liczby bodźców, które może być niskie. Planując badanie, licz więc moc dla liczby wersji i zmienności między nimi (zob. liczebność próby w eksperymencie ankietowym). Przy dwóch wersjach na warunek co piąty model był osobliwy (19.8%), bo z dwóch wersji trudno oszacować wariancję. To kolejny powód, by planować co najmniej cztery wersje.
Sprawdzenie manipulacji: co mierzyć i gdzie
Pretest pokazuje, że materiał potrafi zmienić stan. Sprawdzenie manipulacji w badaniu głównym pokazuje, czy zmienił go u tych respondentów. Mierz stan, który bodziec ma zmienić (tu: postrzeganą normę), a nie zmienną zależną. Najlepiej użyj tej samej miary co w preteście, wtedy porównasz siłę manipulacji w obu badaniach. Hauser i in. (2018) zwracają uwagę, że pytanie o stan zadane tuż po bodźcu może samo działać jak interwencja: wzmocnić, osłabić albo zmienić efekt. Za mniej problematyczne uznają miary niewerbalne albo behawioralne i sprawdzenie manipulacji w osobnym pilotażu. Jak kolejność pytań wpływa na wynik, opisujemy we wpisie kolejność pytań w eksperymencie.
Wynik sprawdzenia manipulacji służy do opisu siły bodźca, nie do usuwania osób. Wykluczenie tych, którzy „nie zaliczyli” sprawdzenia, łamie losowość porównania. Pokazuje to symulacja w haśle manipulacja eksperymentalna.
Zamaskowanie celu
Respondent, który odgadnie hipotezę, może odpowiadać tak, jak jego zdaniem oczekuje badacz. Cel najczęściej zdradzają tytuł badania, opis w zgodzie i oczywiste pytania tuż po bodźcu. Sposoby, które nie wymagają zwodzenia:
- ogólny, prawdziwy opis celu w zgodzie („badanie opinii o informacjach publicznych”), bez nazwy hipotezy;
- bodziec w otoczeniu kilku innych materiałów albo zadań, tak żeby nie był jedynym elementem ankiety;
- zmienna zależna nie bezpośrednio po bodźcu, tylko po krótkim, niezwiązanym bloku pytań, jeśli efekt nie jest bardzo krótkotrwały;
- pytanie na końcu: „Jak myślisz, czego dotyczyło badanie?”. Odsetek osób, które odgadły hipotezę, porównaj między warunkami. Nie używaj go do wykluczeń.
Każda zmiana, która ukrywa cel albo podaje nieprawdziwą informację, musi znaleźć się we wniosku do komisji bioetycznej i w debriefingu.
Jak opisać materiały w artykule
W metodzie podaj liczbę wersji na warunek, sposób ich przygotowania i wyrównania, wyniki pretestu z regułą wyboru oraz sposób uwzględnienia wersji w analizie. Pełne teksty wszystkich wersji umieść w materiałach dodatkowych. Jak cały opis eksperymentu ułożyć w pracy, pokazuje wpis jak opisać eksperyment ankietowy.
Jeśli przygotowujesz materiały do eksperymentu albo recenzent pyta o uogólnienie efektu na inne bodźce, możemy razem zaplanować pretest, liczbę wersji i analizę w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy są niezależne (każdy ma własne ziarno). Drugi zapisuje dane badania głównego do pliku materialy-manipulacji-badanie.csv (możesz go pobrać tutaj). Trzeci dopasowuje 3000 modeli mieszanych i trwa około dwóch minut. Potrzebne pakiety: lme4 i lmerTest.
1. Pretest materiałów: profil tekstów, reguła wyboru i test równoważności
R
# Krok 1. Pretest materiałów: 10 kandydackich komunikatów oceniany na osobnej próbie (dane symulowane)
# N1–N5: komunikat z normą opisową („większość mieszkańców Twojego miasta oszczędza energię”)
# K1–K5: komunikat kontrolny o tej samej długości i formie, bez informacji o tym, co robią inni
suppressPackageStartupMessages(library(lmerTest))
set.seed(3961)
teksty <- data.frame(
  tekst      = c(paste0("N", 1:5), paste0("K", 1:5)),
  warunek    = rep(c("norma", "kontrola"), each = 5),
  slowa      = c(88, 92, 85, 90, 91, 89, 86, 93, 90, 87),       # liczba słów policzona w edytorze
  norma_v    = c(5.3, 5.0, 5.5, 5.6, 4.9, 3.6, 3.4, 3.7, 3.5, 3.6),  # prawdziwe średnie (badacz ich nie zna)
  wiaryg_v   = c(4.9, 5.0, 4.8, 3.9, 5.1, 5.0, 4.9, 5.1, 4.8, 5.0),
  emocje_v   = c(3.0, 3.1, 2.9, 3.2, 3.0, 3.0, 4.1, 2.9, 3.1, 3.0))

# 150 osób z tej samej populacji co badanie główne, każda ocenia 4 losowe teksty (kolejność losowa)
ocen <- do.call(rbind, lapply(1:150, function(i) {
  t4 <- teksty[sample(10, 4), ]
  os <- rnorm(3, 0, c(0.6, 0.7, 0.6))                              # skłonności osoby w trzech ocenach
  data.frame(osoba = i, tekst = t4$tekst, warunek = t4$warunek,
             norma  = pmin(pmax(round(t4$norma_v  + os[1] + rnorm(4, 0, 1.0)), 1), 7),
             wiaryg = pmin(pmax(round(t4$wiaryg_v + os[2] + rnorm(4, 0, 1.0)), 1), 7),
             emocje = pmin(pmax(round(t4$emocje_v + os[3] + rnorm(4, 0, 1.0)), 1), 7),
             czas_s = round(t4$slowa / 3.6 * exp(rnorm(4, 0, 0.35))))   # czas czytania w sekundach
}))

# 1. Profil każdego tekstu: oceny na wymiarze docelowym i na wymiarach, które mają się NIE różnić
prof <- aggregate(cbind(norma, wiaryg, emocje) ~ tekst, data = ocen, FUN = mean)
prof$n <- as.vector(table(ocen$tekst)[prof$tekst])
prof$czas_med <- tapply(ocen$czas_s, ocen$tekst, median)[prof$tekst]
prof <- merge(teksty[, c("tekst", "warunek", "slowa")], prof, by = "tekst", sort = FALSE)
prof[, c("norma", "wiaryg", "emocje")] <- round(prof[, c("norma", "wiaryg", "emocje")], 2)
prof

# 2. Reguła wyboru zapisana przed pretestem: odrzuć tekst, którego wiarygodność albo poruszenie
#    różni się od mediany wszystkich tekstów o więcej niż 0.5 punktu
odchyl <- with(prof, pmax(abs(wiaryg - median(wiaryg)), abs(emocje - median(emocje))))
prof$wybrany <- odchyl <= 0.5
prof[!prof$wybrany, c("tekst", "wiaryg", "emocje")]

# 3. Wybrane teksty: siła manipulacji i równoważność na wymiarach ubocznych
#    (model mieszany: osoby i teksty jako czynniki losowe, stopnie swobody Satterthwaite'a)
wyb <- subset(ocen, tekst %in% prof$tekst[prof$wybrany])
wyb$war <- ifelse(wyb$warunek == "norma", 0.5, -0.5)
granica <- 0.5                                                      # najmniejsza różnica, która ma znaczenie (1–7)
efekt <- function(zm) {
  m <- lmer(reformulate("war + (1 | osoba) + (1 | tekst)", zm), data = wyb)
  s <- summary(m)$coefficients["war", ]
  b <- s[["Estimate"]]; se <- s[["Std. Error"]]; df <- s[["df"]]
  c(roznica = b, dolna90 = b - qt(.95, df) * se, gorna90 = b + qt(.95, df) * se, df = df,
    p_roznica = 2 * pt(-abs(b / se), df),
    p_TOST = max(pt((b + granica) / se, df, lower.tail = FALSE), pt((b - granica) / se, df)))
}
round(rbind(norma = efekt("norma"), wiarygodnosc = efekt("wiaryg"), poruszenie = efekt("emocje")), 3)
# Długość: liczba słów i mediana czasu czytania w wybranych tekstach
aggregate(cbind(slowa, czas_med) ~ warunek, data = subset(prof, wybrany), FUN = mean)
Wynik w R
   tekst  warunek slowa norma wiaryg emocje  n czas_med
1     N1    norma    88  5.32   4.88   2.78 76     26.0
2     N2    norma    92  5.04   4.95   3.00 57     26.0
3     N3    norma    85  5.34   4.51   2.66 47     24.0
4     N4    norma    90  5.56   3.89   3.13 70     27.0
5     N5    norma    91  4.50   4.94   2.91 54     27.5
6     K1 kontrola    89  3.43   4.86   3.10 70     23.0
7     K2 kontrola    86  3.68   4.94   4.02 47     22.0
8     K3 kontrola    93  3.65   5.02   2.72 60     25.5
9     K4 kontrola    90  3.55   4.87   2.88 60     25.0
10    K5 kontrola    87  3.46   4.88   3.05 59     25.0
  tekst wiaryg emocje
4    N4   3.89   3.13
7    K2   4.94   4.02
boundary (singular) fit: see help('isSingular')
             roznica dolna90 gorna90      df p_roznica p_TOST
norma          1.545   1.189   1.901   5.687     0.000  0.999
wiarygodnosc  -0.030  -0.194   0.134 391.106     0.763  0.000
poruszenie    -0.109  -0.315   0.097   5.478     0.339  0.006
   warunek slowa czas_med
1 kontrola 89.75   24.625
2    norma 89.00   25.875
2. Badanie główne: średnie wersji, test na osobach i model mieszany
R
# Krok 2. Badanie główne: 800 osób, warunek (norma / kontrola) i jedna z 4 wersji komunikatu w każdym warunku
# Zmienna zależna: deklarowana gotowość do oszczędzania energii (średnia 3 pozycji, 1–7). Dane symulowane.
suppressPackageStartupMessages(library(lmerTest))
set.seed(3962)
n <- 800
wersje <- c(paste0("N", c(1, 2, 3, 5)), paste0("K", c(1, 3, 4, 5)))   # teksty wybrane w preteście
d <- data.frame(id = 1:n, wersja = sample(rep(wersje, each = n / 8)))  # losowanie zrównoważone: po 100 osób
d$warunek <- factor(ifelse(substr(d$wersja, 1, 1) == "N", "norma", "kontrola"), levels = c("kontrola", "norma"))
d$war <- ifelse(d$warunek == "norma", 0.5, -0.5)
u <- setNames(rnorm(8, 0, 0.15), wersje)                       # specyfika wersji: SD = 0.15 punktu skali
d$gotowosc <- round(pmin(pmax(4.3 + 0.25 * d$war + u[d$wersja] + rnorm(n, 0, 1.2), 1), 7) * 3) / 3
write.csv(d, "materialy-manipulacji-badanie.csv", row.names = FALSE)

# 1. Średnie wersji: ta sama manipulacja, różne teksty
sr <- aggregate(gotowosc ~ wersja + warunek, data = d, FUN = mean)
sr$gotowosc <- round(sr$gotowosc, 2)
sr[order(sr$warunek, -sr$gotowosc), ]

# 2. Analiza, która pomija wersje: test t na wszystkich osobach i d Cohena
yN <- d$gotowosc[d$warunek == "norma"]; yK <- d$gotowosc[d$warunek == "kontrola"]
tt <- t.test(yN, yK, var.equal = TRUE)
sp <- sqrt(((length(yN) - 1) * var(yN) + (length(yK) - 1) * var(yK)) / (n - 2))
round(c(roznica = mean(yN) - mean(yK), dolna = tt$conf.int[1], gorna = tt$conf.int[2],
        t = tt$statistic[[1]], df = tt$parameter[[1]], p = tt$p.value, d = (mean(yN) - mean(yK)) / sp), 3)

# 3. Model mieszany: wersja jako czynnik losowy zagnieżdżony w warunku (Satterthwaite)
m <- lmer(gotowosc ~ war + (1 | wersja), data = d)
s <- summary(m)$coefficients["war", ]
round(c(roznica = s[["Estimate"]], SE = s[["Std. Error"]], df = s[["df"]],
        dolna = s[["Estimate"]] - qt(.975, s[["df"]]) * s[["Std. Error"]],
        gorna = s[["Estimate"]] + qt(.975, s[["df"]]) * s[["Std. Error"]],
        t = s[["t value"]], p = s[["Pr(>|t|)"]]), 3)
vc <- as.data.frame(VarCorr(m))
round(c(SD_wersji = vc$sdcor[1], SD_reszty = vc$sdcor[2], ICC_wersji = vc$vcov[1] / sum(vc$vcov)), 3)

# 4. Gdyby każdy warunek miał tylko jeden tekst: 4 × 4 = 16 możliwych par „norma – kontrola”
pary <- expand.grid(N = wersje[1:4], K = wersje[5:8], stringsAsFactors = FALSE)
pary$roznica <- NA; pary$p <- NA
for (i in seq_len(nrow(pary))) {
  x <- d$gotowosc[d$wersja == pary$N[i]]; y <- d$gotowosc[d$wersja == pary$K[i]]
  pary$roznica[i] <- mean(x) - mean(y)
  pary$p[i] <- t.test(x, y, var.equal = TRUE)$p.value
}
round(c(min = min(pary$roznica), max = max(pary$roznica), istotnych_p05 = sum(pary$p < .05), par = nrow(pary)), 3)
skrajne <- pary[order(pary$roznica), ][c(1, 16), ]
transform(skrajne, roznica = round(roznica, 3), p = round(p, 3))
Wynik w R
  wersja  warunek gotowosc
3     K4 kontrola     4.24
2     K3 kontrola     4.21
4     K5 kontrola     4.04
1     K1 kontrola     3.88
6     N2    norma     4.60
7     N3    norma     4.44
5     N1    norma     4.22
8     N5    norma     4.09
roznica   dolna   gorna       t      df       p       d
  0.247   0.075   0.418   2.824 798.000   0.005   0.200
roznica      SE      df   dolna   gorna       t       p
  0.247   0.142   6.000  -0.101   0.594   1.738   0.133
 SD_wersji  SD_reszty ICC_wersji
     0.159      1.228      0.016
          min           max istotnych_p05           par
       -0.150         0.727         7.000        16.000
    N  K roznica     p
12 N5 K4  -0.150 0.373
2  N2 K1   0.727 0.000
3. Symulacja: błąd I rodzaju i moc przy 1, 2, 4 i 8 wersjach na warunek
R
# Krok 3. Symulacja: 1, 2, 4 albo 8 wersji komunikatu na warunek, zawsze 800 osób (dane symulowane)
# Prawdziwy efekt warunku 0 (błąd I rodzaju) albo 0.25 punktu (moc); SD wersji 0.15, SD reszty 1.2
suppressPackageStartupMessages(library(lmerTest))
jedno <- function(k, efekt, n = 800, sd_w = 0.15, sd_e = 1.2) {
  w <- factor(sample(rep(1:(2 * k), length.out = n)))           # wersje 1..k: kontrola, k+1..2k: norma
  war <- ifelse(as.integer(w) > k, 0.5, -0.5)
  y <- 4.3 + efekt * war + rnorm(2 * k, 0, sd_w)[w] + rnorm(n, 0, sd_e)
  p_t <- t.test(y[war > 0], y[war < 0], var.equal = TRUE)$p.value  # analiza, która pomija wersje
  if (k == 1) return(c(t_osoby = p_t, model_mieszany = NA, t_wersje = NA, osobliwy = NA))
  m <- suppressMessages(lmer(y ~ war + (1 | w)))
  sw <- tapply(y, w, mean); ww <- tapply(war, w, mean)            # średnie wersji
  c(t_osoby = p_t, model_mieszany = summary(m)$coefficients["war", "Pr(>|t|)"],
    t_wersje = t.test(sw[ww > 0], sw[ww < 0], var.equal = TRUE)$p.value, osobliwy = isSingular(m))
}
set.seed(3963)
R <- 500
wyn <- do.call(rbind, lapply(c(0, 0.25), function(ef) do.call(rbind, lapply(c(1, 2, 4, 8), function(k) {
  p <- replicate(R, jedno(k, ef))
  data.frame(efekt = ef, wersji_na_warunek = k,
             t_osoby = mean(p["t_osoby", ] < .05), model_mieszany = mean(p["model_mieszany", ] < .05),
             t_wersje = mean(p["t_wersje", ] < .05), osobliwe = mean(p["osobliwy", ]))
}))))
wyn[, 3:6] <- round(wyn[, 3:6], 3)
wyn
write.csv(wyn, "symulacja-wersje.csv", row.names = FALSE)
# Błąd Monte Carlo odsetka przy 500 powtórzeniach: dla 5% i w najgorszym przypadku (50%)
round(c(przy_5proc = sqrt(.05 * .95 / R), maks = sqrt(.25 / R)), 3)
Wynik w R
  efekt wersji_na_warunek t_osoby model_mieszany t_wersje osobliwe
1  0.00                 1   0.526             NA       NA       NA
2  0.00                 2   0.324          0.054    0.058    0.198
3  0.00                 4   0.258          0.072    0.074    0.104
4  0.00                 8   0.154          0.052    0.050    0.082
5  0.25                 1   0.676             NA       NA       NA
6  0.25                 2   0.658          0.156    0.138    0.196
7  0.25                 4   0.702          0.334    0.330    0.120
8  0.25                 8   0.754          0.504    0.504    0.090
przy_5proc       maks
     0.010      0.022
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje t.test() i aggregate() z pakietu stats) z pakietami lme4 i lmerTest; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Jeden tekst na warunek. Różnica warunków jest wtedy różnicą dwóch tekstów. W symulacji bez prawdziwego efektu ponad połowa badań dawała wynik istotny.
- Wiele wersji, ale analiza na osobach. Przygotowanie wersji bez uwzględnienia ich w modelu nadal zawyża odsetek fałszywie istotnych wyników.
- Wersje różniące się czymś więcej niż składnikiem aktywnym. Dłuższy, bardziej emocjonalny albo mniej wiarygodny tekst w jednym warunku to zakłócenie, którego randomizacja nie usunie.
- „Brak istotnej różnicy w preteście” jako dowód równoważności. Przy małej próbie to tylko brak informacji. Użyj testu równoważności z granicą ustaloną z góry.
- Dobór tekstów po obejrzeniu wyników badania głównego. Wersje, które „nie zadziałały”, nie mogą zniknąć z analizy. Regułę wyboru stosuj tylko na danych z pretestu (zob. plan analizy i prerejestracja).
Przed uruchomieniem eksperymentu sprawdź
- Czy każdy warunek ma co najmniej cztery wersje bodźca, a wersje różnią się tylko elementami nieistotnymi dla hipotezy?
- Czy wersje są wyrównane pod względem liczby słów, struktury, źródła, szaty graficznej i wyglądu na telefonie?
- Czy pretest na osobnej próbie potwierdził siłę manipulacji i równoważność na wymiarach ubocznych, a reguła wyboru była zapisana przed pretestem?
- Czy narzędzie losuje warunek i wersję, a obie zmienne trafiają do eksportu danych?
- Czy plan analizy zawiera model z wersją jako czynnikiem losowym i analizę mocy uwzględniającą liczbę wersji?
- Czy sprawdzenie manipulacji mierzy stan docelowy i ma zaplanowane miejsce w ankiecie?
- Czy opis celu w zgodzie nie zdradza hipotezy, a ewentualne zwodzenie ma debriefing i zgodę komisji?
Najczęstsze pytania
Ile wersji bodźca przygotować do eksperymentu ankietowego?
Co najmniej cztery na warunek, a jeśli to możliwe – więcej. W symulacji z 800 osobami moc modelu mieszanego dla efektu 0.25 punktu wyniosła .156 przy dwóch wersjach, .334 przy czterech i .504 przy ośmiu. Przy dwóch wersjach co piąty model był osobliwy, bo z dwóch tekstów trudno oszacować zmienność między nimi.
Czym pretest materiałów różni się od sprawdzenia manipulacji?
Pretest prowadzisz przed eksperymentem na osobnej próbie: osoby oceniają kandydackie wersje bodźca na wymiarze docelowym i na wymiarach, które mają się nie różnić, a Ty wybierasz teksty według reguły zapisanej z góry. Sprawdzenie manipulacji jest częścią badania głównego i pokazuje, czy bodziec zmienił stan u tych respondentów. Pretest nie pyta o zmienną zależną.
Jak wykazać, że wersje bodźca nie różnią się wiarygodnością?
Brak istotnej różnicy w małym preteście nie wystarczy. Ustal z góry najmniejszą różnicę, która ma znaczenie (np. ±0.5 punktu na skali 1–7), i wykonaj test równoważności TOST. W przykładzie 90% CI różnicy wiarygodności, [−0.194, 0.134], mieścił się w granicach, pTOST < .001.
Czy wersję bodźca trzeba uwzględnić w analizie wyników eksperymentu?
Tak. Gdy każdy warunek ma kilka wersji, dodaj wersję jako losowy wyraz wolny w modelu mieszanym, np. lmer(y ~ warunek + (1 | wersja)). W przykładzie test t pomijający wersje dał p = .005, a model mieszany p = .133 przy tej samej różnicy 0.25 punktu, bo uogólnienie opiera się na czterech tekstach na warunek, a nie na 800 osobach.
Co to jest stimulus sampling w eksperymencie?
Stimulus sampling (próbkowanie bodźców) to użycie w każdym warunku kilku różnych egzemplarzy bodźca zamiast jednego, np. kilku tekstów z tym samym składnikiem aktywnym. Dzięki temu efekt dotyczy kategorii bodźców, a nie cech jednego tekstu. Wells i Windschitl (1999) pokazali, że brak próbkowania bodźców zagraża także trafności teoretycznej manipulacji.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →PoradnikWarunek kontrolny w eksperymencie
Brak bodźca, placebo, status quo czy drugi bodziec? Co szacuje każda kontrola, jak zmienia efekt i jak zbudować placebo w ankiecie.
Czytaj →Przygotowujesz bodźce do eksperymentu albo recenzent pyta o uogólnienie na inne materiały?
Pomożemy zaplanować pretest i liczbę wersji bodźca, policzyć moc z uwzględnieniem wersji, przeprowadzić analizę modelem mieszanym i opisać ją tak, żebyś mógł(a) samodzielnie obronić wyniki przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Chester, D. S., & Lasko, E. N. (2021). Construct validation of experimental manipulations in social psychology: Current practices and recommendations for the future. Perspectives on Psychological Science, 16(2), 377–395. https://doi.org/10.1177/1745691620950684 ● Otwarty dostęp: pełny tekst
- Hauser, D. J., Ellsworth, P. C., & Gonzalez, R. (2018). Are manipulation checks necessary? Frontiers in Psychology, 9, Article 998. https://doi.org/10.3389/fpsyg.2018.00998 ● Otwarty dostęp
- Jackson, S., & Jacobs, S. (1983). Generalizing about messages: Suggestions for design and analysis of experiments. Human Communication Research, 9(2), 169–191. https://doi.org/10.1111/j.1468-2958.1983.tb00691.x
- Judd, C. M., Westfall, J., & Kenny, D. A. (2012). Treating stimuli as a random factor in social psychology: A new and comprehensive solution to a pervasive but largely ignored problem. Journal of Personality and Social Psychology, 103(1), 54–69. https://doi.org/10.1037/a0028347
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Orne, M. T. (1962). On the social psychology of the psychological experiment: With particular reference to demand characteristics and their implications. American Psychologist, 17(11), 776–783. https://doi.org/10.1037/h0043424
- Reeves, B., Yeykelis, L., & Cummings, J. J. (2016). The use of media in media psychology. Media Psychology, 19(1), 49–71. https://doi.org/10.1080/15213269.2015.1030083
- Wells, G. L., & Windschitl, P. D. (1999). Stimulus sampling and social psychological experimentation. Personality and Social Psychology Bulletin, 25(9), 1115–1125. https://doi.org/10.1177/01461672992512005
- Westfall, J., Kenny, D. A., & Judd, C. M. (2014). Statistical power and optimal design in experiments in which samples of participants respond to samples of stimuli. Journal of Experimental Psychology: General, 143(5), 2020–2045. https://doi.org/10.1037/xge0000014
Cytowania BibTeX
@article{chester2021construct, author={Chester, David S. and Lasko, Emily N.}, title={{Construct validation of experimental manipulations in social psychology: Current practices and recommendations for the future}}, journal={Perspectives on Psychological Science}, year={2021}, volume={16}, number={2}, pages={377--395}, doi={10.1177/1745691620950684}}@article{hauser2018are, author={Hauser, David J. and Ellsworth, Phoebe C. and Gonzalez, Richard}, title={{Are manipulation checks necessary?}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={998}, doi={10.3389/fpsyg.2018.00998}}@article{jackson1983generalizing, author={Jackson, Sally and Jacobs, Scott}, title={{Generalizing about messages: Suggestions for design and analysis of experiments}}, journal={Human Communication Research}, year={1983}, volume={9}, number={2}, pages={169--191}, doi={10.1111/j.1468-2958.1983.tb00691.x}}@article{judd2012treating, author={Judd, Charles M. and Westfall, Jacob and Kenny, David A.}, title={{Treating stimuli as a random factor in social psychology: A new and comprehensive solution to a pervasive but largely ignored problem}}, journal={Journal of Personality and Social Psychology}, year={2012}, volume={103}, number={1}, pages={54--69}, doi={10.1037/a0028347}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{orne1962social, author={Orne, Martin T.}, title={{On the social psychology of the psychological experiment: With particular reference to demand characteristics and their implications}}, journal={American Psychologist}, year={1962}, volume={17}, number={11}, pages={776--783}, doi={10.1037/h0043424}}@article{reeves2016use, author={Reeves, Byron and Yeykelis, Leo and Cummings, James J.}, title={{The use of media in media psychology}}, journal={Media Psychology}, year={2016}, volume={19}, number={1}, pages={49--71}, doi={10.1080/15213269.2015.1030083}}@article{wells1999stimulus, author={Wells, Gary L. and Windschitl, Paul D.}, title={{Stimulus sampling and social psychological experimentation}}, journal={Personality and Social Psychology Bulletin}, year={1999}, volume={25}, number={9}, pages={1115--1125}, doi={10.1177/01461672992512005}}@article{westfall2014statistical, author={Westfall, Jacob and Kenny, David A. and Judd, Charles M.}, title={{Statistical power and optimal design in experiments in which samples of participants respond to samples of stimuli}}, journal={Journal of Experimental Psychology: General}, year={2014}, volume={143}, number={5}, pages={2020--2045}, doi={10.1037/xge0000014}}