Co to są czynniki zagnieżdżone i skrzyżowane?
Czynnik B jest zagnieżdżony w czynniku A (ang. nested, zapis B(A)), gdy każdy poziom B występuje tylko z jednym poziomem A: klasy w metodach nauczania, terapeuci w ośrodkach, próbki w zwierzętach. Czynniki są skrzyżowane (ang. crossed), gdy każdy poziom jednego występuje z każdym poziomem drugiego, jak w schemacie czynnikowym albo gdy każdy uczestnik ocenia każdy bodziec (efekty skrzyżowane: uczestnicy × bodźce). Rozpoznasz to w tabeli krzyżowej poziomów: przy skrzyżowaniu wszystkie komórki są zajęte, przy zagnieżdżeniu każdy wiersz ma jedną niepustą kolumnę.
Co z tego wynika dla analizy
Przy zagnieżdżeniu nie da się oszacować interakcji A × B. Schielzeth i Nakagawa (2013) wyjaśniają, że w modelach mieszanych wariancja tej interakcji łączy się wtedy z wariancją czynnika zagnieżdżonego, a rozdzielić je można tylko w planie skrzyżowanym. Dodają, że efekty zagnieżdżone można dopasować tą samą składnią co skrzyżowane, pod warunkiem że kodowanie poziomów odzwierciedla zagnieżdżenie. Czynnik zagnieżdżony jest zwykle losowy (efekty stałe i losowe), a efekt A ocenia się względem zmienności jego poziomów. Pominięcie go to pseudoreplikacja, czyli według Hurlberta (1984) testowanie z niewłaściwym członem błędu.
Przykład
Dwie metody nauczania, po cztery klasy i po dziesięciu uczniów (dane symulowane). Klasy w obu metodach ponumerowano 1–4. Model z (1 | klasa) widzi tylko 4 klasy, bo „klasa 1” z obu metod staje się jedną grupą; błąd standardowy efektu metody (3.49 punktu) wynosi 1.27. Poprawny model wielopoziomowy z (1 | metoda:klasa) ma 8 klas i błąd standardowy 3.96. Regresja bez klas daje 1.56.
Na rysunku
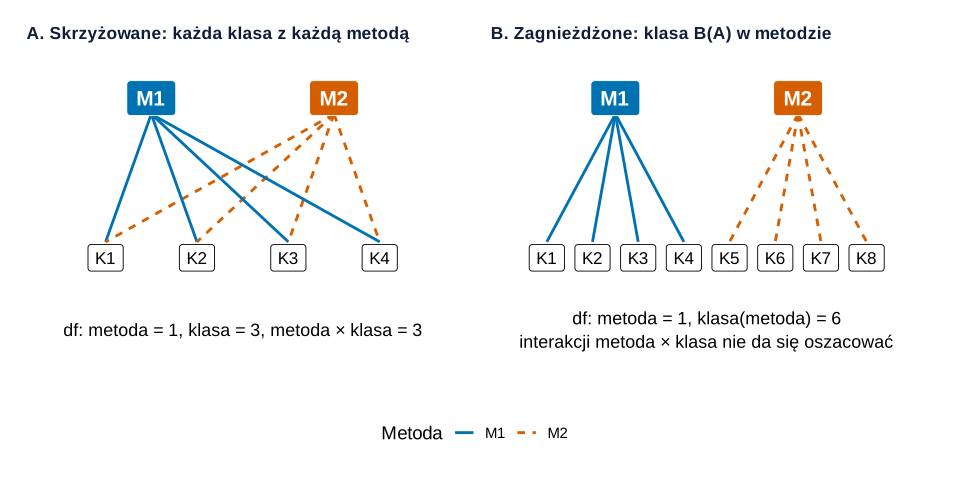
Co widać. Przy skrzyżowaniu z każdej metody wychodzi linia do każdej klasy (2 × 4 = 8 połączeń), więc każdą klasę da się porównać w obu metodach. Stąd 3 stopnie swobody na interakcję metoda × klasa. Przy zagnieżdżeniu z każdej klasy wychodzi jedna linia: 8 klas daje 2 · (4 − 1) = 6 stopni swobody dla klas w metodach, a interakcji nie ma z czego liczyć.
Na co uważać. Diagram nie zależy od etykiet w pliku danych. Jeśli klasy K5–K8 nazwiesz ponownie 1–4, program narysuje sobie panel A, choć badanie wygląda jak panel B.
Podpis do pracy:
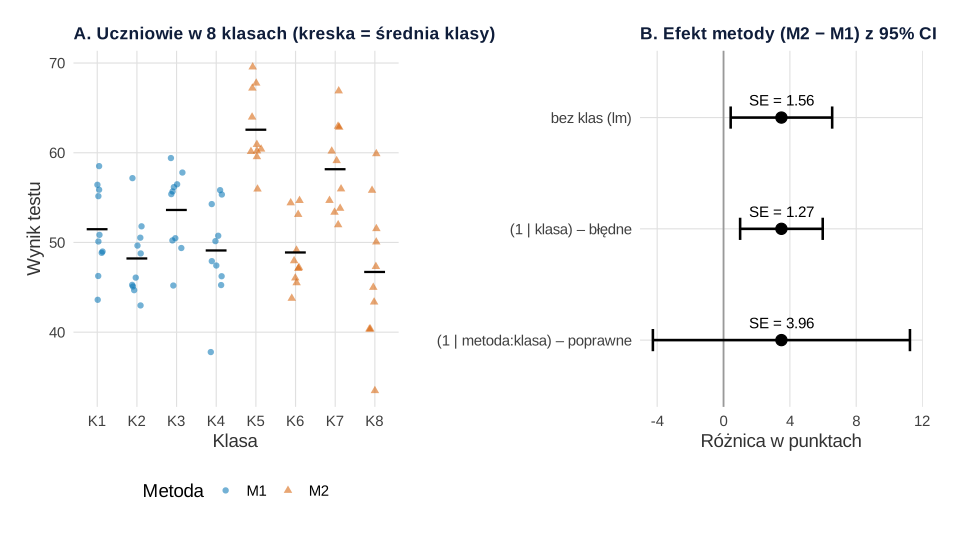
set.seed(617)).Co widać. Klasy w obrębie tej samej metody wyraźnie się różnią – w M2 średnie wynoszą od 46.7 do 62.6 punktu (A), a metoda ma tylko 4 klasy na poziom. Wszystkie trzy modele dają ten sam efekt, 3.49 punktu (B), ale tylko model z (1 | metoda:klasa) traktuje klasę jako jednostkę, której wynik przypisano metodzie. Jego 95% CI [−4.26, 11.24] obejmuje zero. Model bez klas i model z błędnie skrzyżowanymi klasami dają przedziały 2.54 i 3.12 raza węższe – i fałszywą pewność.
Na co uważać. Przedziały w panelu B to przybliżenie Walda (±1.96 SE). Przy 8 klasach dokładniejsze są przedziały z poprawką stopni swobody, które byłyby jeszcze szersze.
Podpis do pracy:
Kod losuje te same dane co przykład, z tym samym ziarnem set.seed(617), ustalonym raz. Rysunki na stronie różnią się od wyniku kodu tylko motywem serwisu.
Kod R rysunków 1 i 2
# Rysunek 1. Czynniki skrzyżowane i zagnieżdżone jako diagram połączeń + stopnie swobody
# Rysunek 2. Dane z przykładu: uczniowie w klasach, klasy w metodach; efekt metody w trzech modelach
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(lme4))

kol <- c(M1 = "#0072B2", M2 = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: a = 2 metody, b = 4 klasy na metodę
a <- 2; b <- 4
gora <- data.frame(x = c(2, 6), y = 2, lab = c("M1", "M2"))
skrz_dol <- data.frame(x = c(1, 3, 5, 7), y = 0, lab = paste0("K", 1:4))
zagn_dol <- data.frame(x = 1:8 - 0.5, y = 0, lab = paste0("K", 1:8))
krawedzie <- function(gora, dol, pary) data.frame(x = gora$x[pary[, 1]], y = 1.8, xend = dol$x[pary[, 2]], yend = 0.2,
                                                  metoda = gora$lab[pary[, 1]])
k_skrz <- krawedzie(gora, skrz_dol, expand.grid(1:2, 1:4))                       # każda klasa z każdą metodą
k_zagn <- krawedzie(gora, zagn_dol, cbind(rep(1:2, each = 4), 1:8))              # każda klasa w jednej metodzie
df_skrz <- c(A = a - 1, B = b - 1, AxB = (a - 1) * (b - 1))
df_zagn <- c(A = a - 1, `B(A)` = a * (b - 1))
df_skrz; df_zagn
diagram <- function(kr, dol, tytul, opis) {
  ggplot() +
    geom_segment(aes(x, y, xend = xend, yend = yend, colour = metoda, linetype = metoda), data = kr, linewidth = 1) +
    geom_label(aes(x, y, label = lab, fill = lab), data = gora, size = 5.5, fontface = "bold", colour = "white",
               label.padding = unit(0.4, "lines")) +
    geom_label(aes(x, y, label = lab), data = dol, size = 4.5, label.padding = unit(0.35, "lines")) +
    annotate("text", x = 4, y = -0.9, label = opis, size = 4.7, lineheight = 1.1) +
    scale_colour_manual(values = kol, name = "Metoda") + scale_fill_manual(values = kol, guide = "none") +
    scale_linetype_manual(values = c(M1 = "solid", M2 = "22"), name = "Metoda") +
    scale_y_continuous(limits = c(-1.5, 2.4)) + scale_x_continuous(limits = c(-0.3, 8.3)) +
    labs(title = tytul, x = NULL, y = NULL) + motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
}
p1 <- diagram(k_skrz, skrz_dol, "A. Skrzyżowane: każda klasa z każdą metodą",
              sprintf("df: metoda = %d, klasa = %d, metoda × klasa = %d", df_skrz[1], df_skrz[2], df_skrz[3])) +
      diagram(k_zagn, zagn_dol, "B. Zagnieżdżone: klasa B(A) w metodzie",
              sprintf("df: metoda = %d, klasa(metoda) = %d\ninterakcji metoda × klasa nie da się oszacować", df_zagn[1], df_zagn[2])) +
      plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1

# Rysunek 2: te same dane co w przykładzie (2 metody × 4 klasy × 10 uczniów)
set.seed(617)
d <- expand.grid(uczen = 1:10, klasa = 1:4, metoda = c("M1", "M2"))
d$klasa_id <- interaction(d$metoda, d$klasa)          # 8 różnych klas
u <- rnorm(8, sd = 3)                                   # efekty klas
d$y <- 50 + 4 * (d$metoda == "M2") + u[as.integer(d$klasa_id)] + rnorm(80, sd = 5)
modele <- list(`bez klas (lm)` = lm(y ~ metoda, data = d),
               `(1 | klasa) – błędne` = lmer(y ~ metoda + (1 | klasa), data = d),
               `(1 | metoda:klasa) – poprawne` = lmer(y ~ metoda + (1 | metoda:klasa), data = d))
efekt <- do.call(rbind, lapply(names(modele), function(nm) {
  m <- modele[[nm]]
  b <- if (inherits(m, "lm")) coef(m)[[2]] else fixef(m)[[2]]
  se <- sqrt(vcov(m)[2, 2])
  data.frame(model = nm, b = b, se = se, lo = b - 1.96 * se, hi = b + 1.96 * se)
}))
efekt[, -1] <- round(efekt[, -1], 2)
efekt
d$etykieta <- factor(paste0("K", d$klasa + 4 * (d$metoda == "M2")), levels = paste0("K", 1:8))  # K1–K4 w M1, K5–K8 w M2
srednie_klas <- aggregate(y ~ etykieta + metoda, data = d, FUN = mean)
sapply(split(srednie_klas$y, srednie_klas$metoda), function(x) round(range(x), 1))   # najniższa i najwyższa średnia klasy
round(efekt$se[3] / efekt$se[1:2], 2)                  # ile razy szerszy przedział poprawnego modelu
p2a <- ggplot(d, aes(etykieta, y, colour = metoda, shape = metoda)) +
  geom_jitter(width = 0.15, alpha = 0.55, size = 1.8) +
  geom_point(data = srednie_klas, size = 9, shape = 95, colour = "black") +
  scale_colour_manual(values = kol, name = "Metoda") + scale_shape_manual(values = c(M1 = 16, M2 = 17), name = "Metoda") +
  labs(title = "A. Uczniowie w 8 klasach (kreska = średnia klasy)", x = "Klasa", y = "Wynik testu") + motyw
efekt$model <- factor(efekt$model, levels = rev(names(modele)))
p2b <- ggplot(efekt, aes(b, model)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0.2, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3.5) +
  geom_text(aes(label = sprintf("SE = %.2f", se)), vjust = -1.1, size = 4) +
  labs(title = "B. Efekt metody (M2 − M1) z 95% CI", x = "Różnica w punktach", y = NULL) + motyw
p2 <- p2a + p2b + plot_layout(widths = c(1.15, 1))
p2
Wynik w R
  A   B AxB
  1   3   3
   A B(A)
   1    6
                          model    b   se    lo    hi
1                 bez klas (lm) 3.49 1.56  0.43  6.55
2          (1 | klasa) – błędne 3.49 1.27  1.00  5.98
3 (1 | metoda:klasa) – poprawne 3.49 3.96 -4.26 11.24
       M1   M2
[1,] 48.2 46.7
[2,] 53.6 62.6
[1] 2.54 3.12
Jak opisać w pracy
Na co uważać
- Powtarzane numery poziomów. Nadaj zagnieżdżonym jednostkom unikalne identyfikatory, inaczej program uzna je za skrzyżowane.
- Zagnieżdżenie z wyboru. Gdy plan skrzyżowany byłby wykonalny, połączenie wariancji trzeba wyraźnie odnotować (Schielzeth i Nakagawa, 2013).
- Mylenie z planem split-plot. W schemacie split-plot całe poletka są zagnieżdżone w A, ale czynnik B jest z A skrzyżowany.
Czynniki zagnieżdżone w R
Kod symuluje uczniów w klasach i klasy w metodach nauczania, sprawdza zagnieżdżenie tabelą krzyżową i porównuje w lme4::lmer błędne kodowanie klas (numery 1–4 powtarzane w obu metodach) z poprawnym zapisem (1 | metoda:klasa) oraz z regresją bez klas.
Zagnieżdżenie a kodowanie poziomów
R
# Czynniki zagnieżdżone: klasy w metodach nauczania, uczniowie w klasach
suppressPackageStartupMessages(library(lme4))
set.seed(617)
d <- expand.grid(uczen = 1:10, klasa = 1:4, metoda = c("M1", "M2"))
d$klasa_id <- interaction(d$metoda, d$klasa)          # 8 różnych klas
u <- rnorm(8, sd = 3)                                   # efekty klas
d$y <- 50 + 4 * (d$metoda == "M2") + u[as.integer(d$klasa_id)] + rnorm(80, sd = 5)
# Diagnoza: każda klasa występuje tylko w jednej metodzie (zagnieżdżenie)
table(d$klasa_id, d$metoda)[1:4, ]
# Błąd kodowania: numery 1-4 powtarzają się w obu metodach,
# więc (1 | klasa) traktuje "klasę 1" z M1 i M2 jak jedną grupę (skrzyżowanie)
m_zle <- lmer(y ~ metoda + (1 | klasa), data = d)
# Poprawnie: unikalne identyfikatory albo zapis (1 | metoda:klasa)
m_ok <- lmer(y ~ metoda + (1 | metoda:klasa), data = d)
wyn <- sapply(list(zle = m_zle, ok = m_ok), function(m) c(
  grupy = unname(ngrps(m)), sd_klas = attr(VarCorr(m)[[1]], "stddev")[[1]],
  efekt_M2 = fixef(m)[[2]], se = sqrt(vcov(m)[2, 2])))
round(wyn, 2)
# Ignorowanie klas (pseudoreplikacja): zbyt mały błąd standardowy
round(summary(lm(y ~ metoda, data = d))$coefficients[2, 1:2], 2)
Wynik w R
       M1 M2
  M1.1 10  0
  M2.1  0 10
  M1.2 10  0
  M2.2  0 10
          zle   ok
grupy    4.00 8.00
sd_klas  4.61 5.35
efekt_M2 3.49 3.49
se       1.27 3.96
  Estimate Std. Error
      3.49       1.56
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lme4; rysunki – pakiety ggplot2 4.0.2 i patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak sprawdzić, czy czynniki są zagnieżdżone czy skrzyżowane?
Zrób tabelę krzyżową poziomów obu czynników. Jeśli każdy poziom B ma obserwacje tylko w jednym poziomie A, B jest zagnieżdżony w A; jeśli zajęte są wszystkie komórki, czynniki są skrzyżowane.
Czy w planie zagnieżdżonym można badać interakcję?
Nie. Interakcji czynnika z czynnikiem w nim zagnieżdżonym nie da się oddzielić od efektu czynnika zagnieżdżonego; wariancje łączą się w jedną. Rozdzielenie wymaga planu skrzyżowanego.
Jak zapisać efekty zagnieżdżone w lme4?
Najprościej nadać jednostkom unikalne identyfikatory i użyć (1 | klasa_id). Gdy numery powtarzają się w grupach, zapisz (1 | metoda:klasa) lub (1 | metoda/klasa), jeśli metoda także ma być efektem losowym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w pracy z rolnictwa, zootechniki i weterynarii
Poletka w blokach, krzywa plonu, kojec jako jednostka, ważenia w modelu mieszanym, dokumentacja stada i ankiety: analizy, zdania APA i kod R.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Schielzeth, H., & Nakagawa, S. (2013). Nested by design: Model fitting and interpretation in a mixed model era. Methods in Ecology and Evolution, 4(1), 14–24. https://doi.org/10.1111/j.2041-210x.2012.00251.x ● Otwarty dostęp
Cytowania BibTeX
@article{hurlbert1984pseudoreplication, author={Hurlbert, Stuart H.}, title={{Pseudoreplication and the design of ecological field experiments}}, journal={Ecological Monographs}, year={1984}, volume={54}, number={2}, pages={187--211}, doi={10.2307/1942661}}@article{schielzeth2013nested, author={Schielzeth, Holger and Nakagawa, Shinichi}, title={{Nested by design: Model fitting and interpretation in a mixed model era}}, journal={Methods in Ecology and Evolution}, year={2013}, volume={4}, number={1}, pages={14--24}, doi={10.1111/j.2041-210x.2012.00251.x}}