(1 + war | osoba) + (1 | slowo). Test t na średnich osób ignoruje zmienność bodźców i zawyża błąd I rodzaju – w symulacji do 51.6% przy 80 osobach. Moc ogranicza wtedy liczba bodźców, nie tylko liczba osób.Dlaczego bodźce też są próbą
W wielu eksperymentach każda osoba reaguje na wiele bodźców: słów, zdjęć twarzy, winiet albo pozycji testu. Badacza nie interesują te konkretne 40 słów, tylko słowa negatywne i neutralne w ogóle. Bodźce są więc losową próbą z populacji bodźców, tak jak uczestnicy są losową próbą z populacji ludzi. Clark (1973) nazwał traktowanie materiału językowego jako efektu stałego błędem „language-as-fixed-effect”. Judd i in. (2012) pokazali, że w psychologii społecznej ten problem jest powszechny i zwykle ignorowany. Pominięcie losowej zmienności bodźców prowadzi do znacznych obciążeń wniosków.
Typowa analiza wygląda tak: dla każdej osoby liczysz średnią w każdym warunku, a potem wykonujesz test t albo ANOVA z powtarzanymi pomiarami. Ta agregacja usuwa informację o tym, że różnica między warunkami może wynikać z doboru bodźców. Test pyta wtedy tylko, czy ci sami badani zareagowaliby podobnie na te same słowa. Jest to pokrewne pseudoreplikacji: część obserwacji nie jest niezależna, a analiza tego nie widzi. Rozwiązaniem jest model mieszany, w którym uczestnicy i bodźce są dwoma skrzyżowanymi czynnikami losowymi (Baayen i in., 2008).
Wpis ANOVA z powtarzanymi pomiarami czy model mieszany wspomina o tym problemie jednym akapitem. Tutaj rozwijamy go w pełną analizę. Ogólną logikę efektów stałych i losowych oraz danych zagnieżdżonych opisuje poradnik model wielopoziomowy krok po kroku.
Skrzyżowane, a nie zagnieżdżone
W klasycznym modelu wielopoziomowym uczeń należy do jednej klasy, więc poziomy są zagnieżdżone. Tutaj każdy uczestnik widzi każde słowo, a każde słowo widzi każdy uczestnik. Czynniki są skrzyżowane: każda obserwacja ma dwa „adresy”, osobę i bodziec. W lme4 zapisujesz to dwoma osobnymi członami losowymi (Bates i in., 2015):
Tu i to osoba, a j to słowo. Osoby różnią się ogólnym tempem (u0i) i wrażliwością na walencję (u1i, czyli losowe nachylenie). Słowa różnią się trudnością (w0j). lme4 rozpoznaje skrzyżowanie sam, jeśli identyfikatory słów są unikalne w całym zbiorze.
Jakie efekty losowe dopasować do schematu
Barr i in. (2013) zalecają w testowaniu hipotez konfirmacyjnych maksymalną strukturę efektów losowych uzasadnioną schematem badania. Losowe nachylenie warunku dodajesz dla tego czynnika, w obrębie którego warunek się zmienia. Brauer i Curtin (2018) podają szczegółowe reguły dla predyktorów kategorialnych i ciągłych, które zmieniają się w obrębie osób, w obrębie bodźców albo w obu naraz.
| Schemat | Przykład | Efekty losowe w lme4 |
|---|---|---|
| Warunek w obrębie osób, między bodźcami | każdy widzi słowa negatywne i neutralne, ale każde słowo ma jedną walencję | (1 + war | osoba) + (1 | slowo) |
| Warunek w obrębie osób i w obrębie bodźców | ta sama twarz pokazana z uśmiechem i bez | (1 + war | osoba) + (1 + war | twarz) |
| Warunek między osobami, w obrębie bodźców | dwie grupy oceniają te same winiety w różnych instrukcjach | (1 | osoba) + (1 + war | winieta) |
| Warunek między osobami i między bodźcami | każda grupa ocenia własny zestaw zdjęć | (1 | osoba) + (1 | zdjecie) |
Pytanie pomocnicze brzmi: czy ta sama osoba (albo ten sam bodziec) występuje w obu warunkach? Jeśli tak, efekt warunku może się między nimi różnić i potrzebne jest losowe nachylenie. Rozróżnienie czynnika wewnątrzobiektowego i międzyobiektowego stosujesz więc osobno do osób i do bodźców. Dobrym punktem wyjścia są też eksperymenty winietowe, w których winiety są bodźcami.
Przykład: decyzja leksykalna ze słowami negatywnymi
Sześćdziesiąt osób wykonało zadanie decyzji leksykalnej z 40 słowami: 20 negatywnymi i 20 neutralnymi. Każdy widział każde słowo, co daje 2400 prób. Zmienna zależna to czas reakcji w milisekundach. Walencję zakodowano jako −0.5 i +0.5 (kodowanie efektów), więc wyraz wolny to średnia z obu warunków. Dane są symulowane i liczby pochodzą z kodu R na końcu strony. Zbiór możesz pobrać jako plik CSV (2400 wierszy: osoba, slowo, walencja, war, rt).
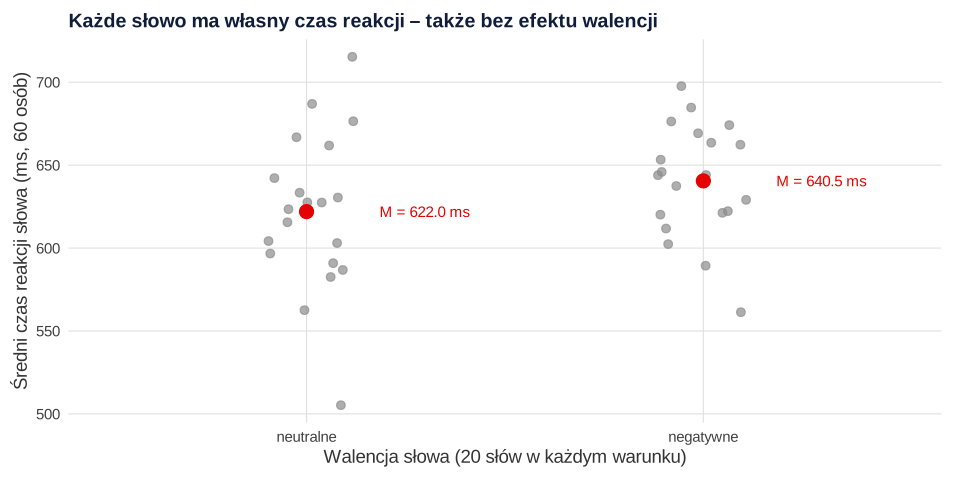
Ważne: dane wygenerowaliśmy bez efektu walencji. Prawdziwa różnica między słowami negatywnymi i neutralnymi wynosi 0 ms. Różnica w próbie wynika wyłącznie z tego, które słowa trafiły do której listy, i z szumu. Słowa negatywne były średnio wolniejsze: 640.5 wobec 622.0 ms. Rysunek 1 pokazuje, skąd ta różnica się bierze.
Krok 1. Analiza po uczestnikach i po bodźcach
Analiza „po uczestnikach” (F1) uśrednia odpowiedzi każdej osoby w warunku i porównuje średnie testem t dla prób zależnych. Wynik: różnica 18.53 ms, SE = 5.17, 95% CI [8.18, 28.88], t(59) = 3.58, p < .001. Gdybyś na tym poprzestał(a), ogłosiłbyś (ogłosiłabyś) efekt walencji, którego w populacji nie ma.
Analiza „po bodźcach” (F2) uśrednia odpowiedzi do każdego słowa i porównuje 20 słów z 20 słowami: t(38) = 1.42, p = .163. Dawniej raportowano oba testy i uznawano efekt, gdy oba były istotne. Baayen i in. (2008) pokazali w symulacjach, że modele mieszane mają przewagę nad analizą po osobach, nad łączną analizą po osobach i po bodźcach oraz nad testami quasi-F. Model mieszany z obu czynnikami losowymi rozwiązuje problem jedną analizą.
Krok 2. Model z efektami skrzyżowanymi
Ten sam efekt w trzech modelach (lmerTest, stopnie swobody Satterthwaite’a; Kuznetsova i in., 2017):
| Model | b (ms) | SE | t (df) | p |
|---|---|---|---|---|
Tylko uczestnicy: (1 + war | osoba) | 18.53 | 5.17 | 3.58 (59.0) | < .001 |
Skrzyżowane, maksymalny: (1 + war | osoba) + (1 | slowo) | 18.53 | 13.29 | 1.39 (40.4) | .171 |
Skrzyżowane, losowe wyrazy wolne: (1 | osoba) + (1 | slowo) | 18.53 | 13.03 | 1.42 (38.0) | .163 |
Oszacowanie efektu jest wszędzie takie samo, bo schemat jest zrównoważony. Zmienia się błąd standardowy: po dodaniu słów jako czynnika losowego rośnie z 5.17 do 13.29 ms. Stopnie swobody spadają z 59 do około 40, czyli bliżej liczby słów niż liczby osób. Model mówi wprost, że uogólnienie na inne słowa opiera się na 40 słowach, a nie na 2400 próbach. Przedział ufności efektu, 95% CI [−7.5, 44.6], obejmuje zero.
Składniki wariancji modelu maksymalnego: wyraz wolny osób 6826.49 (SD = 82.62), nachylenie walencji u osób 402.36 (SD = 20.06), wyraz wolny słów 1498.34 (SD = 38.71) i reszta 12030.71 (SD = 109.69). Słowa odpowiadały tylko za 7.4% wariancji wyrazów wolnych i reszty, osoby za 33.5%. Mimo to pominięcie słów zmieniło wniosek. Liczy się bowiem to, że różnica między warunkami opiera się na zaledwie 20 słowach w każdym.
Krok 3. Maksymalna struktura i problemy z dopasowaniem
Losowe nachylenie walencji u osób nie poprawiło istotnie dopasowania: χ²(2) = 2.65, p = .265 (porównanie modeli z tymi samymi efektami stałymi na wiarygodności REML; zob. REML a ML i test ilorazu wiarygodności). Czy je usunąć? Barr i in. (2013) argumentują, że model z samymi losowymi wyrazami wolnymi uogólnia gorzej, gdy osoby lub bodźce różnią się wrażliwością na manipulację. Matuschek i in. (2017) pokazali z kolei, że model maksymalny chroni przed błędem I rodzaju kosztem mocy i że strukturę wspieraną przez dane można wybrać kryterium wyboru modelu. W raporcie zapisz, którą regułę przyjąłeś(-ęłaś) przed analizą.
W tym przykładzie oba modele dały podobny wniosek. Przy mniejszej liczbie osób model maksymalny często daje ostrzeżenie boundary (singular) fit: wariancja nachylenia albo korelacja efektów losowych szacuje się na granicy. W symulacji poniżej zdarzyło się to w 21.0% prób z 20 osobami, 3.8% z 40 i 1.4% z 80. Co wtedy robić krok po kroku, opisuje wpis o ANOVA i modelu mieszanym, a Brauer i Curtin (2018) podają kroki naprawcze przy braku zbieżności. Najważniejsza zasada: nie usuwaj losowych efektów bodźców, żeby model się zbiegł, bo właśnie one chronią przed fałszywym wnioskiem.
Ile kosztuje pominięcie bodźców: symulacja
Jedna próba to anegdota, więc powtórzyliśmy badanie 500 razy dla 20, 40 i 80 osób, zawsze z 40 słowami i zerowym efektem walencji. W każdej próbie policzyliśmy test t na średnich osób i model z efektami skrzyżowanymi. Oczekiwany odsetek wyników istotnych przy prawdziwej hipotezie zerowej to 5% (błąd I rodzaju).
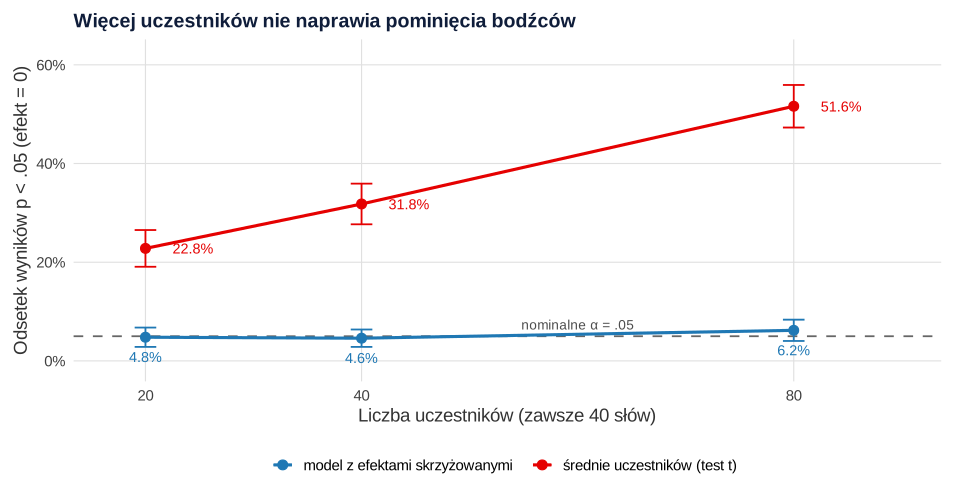
Test t na średnich osób dał wynik fałszywie istotny w 22.8% prób przy 20 osobach, 31.8% przy 40 i 51.6% przy 80. Model z efektami skrzyżowanymi: 4.8%, 4.6% i 6.2%. Paradoks jest pozorny. Większa liczba osób zmniejsza błąd standardowy analizy F1, ale nie zmienia faktu, że wszystkie osoby widziały te same 40 słów. Test coraz pewniej wykrywa różnicę między tymi słowami, a nie między słowami negatywnymi i neutralnymi.
Planowanie: liczba bodźców ogranicza moc
Ta sama symulacja pokazuje drugą stronę medalu. Średni błąd standardowy efektu w modelu skrzyżowanym wynosił 15.82 ms przy 20 osobach, 14.30 przy 40 i 13.42 przy 80. Nie spadnie poniżej 12.65 ms, bo tyle wynosi niepewność wynikająca z samego doboru 20 + 20 słów. Westfall i in. (2014) pokazali, że w schematach ze skrzyżowanymi czynnikami losowymi moc nie zbliża się do 1 wraz z liczbą osób, lecz do maksimum zależnego od próby bodźców, które może być niskie. Udostępnili też aplikację do planowania takich badań.
Wniosek praktyczny: zwiększ liczbę bodźców, a nie tylko osób. Jeśli to możliwe, użyj schematu, w którym ten sam bodziec występuje w obu warunkach, bo wtedy różnice między bodźcami częściowo się znoszą. Do analizy mocy klasyczne wzory dla testu t nie wystarczą; potrzebna jest symulacja z oboma źródłami wariancji. Jak ją zbudować w lme4, pokazuje kod niżej – wystarczy podstawić efekt różny od zera.
Wielkość efektu raportuj w milisekundach z CI. Jeśli potrzebujesz standaryzowanej, podziel efekt przez pierwiastek z sumy wariancji wyrazów wolnych osób i słów oraz reszty. W przykładzie daje to 0.13, ale zawsze zaznacz, które składniki wariancji weszły do mianownika, bo inne wybory dają inne liczby (zob. wielkość efektu).
Jak opisać model z efektami skrzyżowanymi (APA)
Najważniejsze elementy opisu to liczba osób, bodźców i obserwacji, kodowanie predyktorów, pełna struktura efektów losowych z regułą jej wyboru, metoda estymacji i przybliżenie stopni swobody, efekt z CI oraz składniki wariancji. Jeśli czas reakcji ma rozkład silnie prawostronnie skośny, rozważ transformację logarytmiczną albo uogólniony model mieszany; przy odpowiedziach poprawnych i błędnych sięgnij po wielopoziomową regresję logistyczną, w której te same skrzyżowane efekty losowe zapisujesz w glmer().
Planujesz eksperyment z bodźcami albo recenzent prosi o model mieszany zamiast analizy F1 i F2? Możemy razem sprawdzić strukturę efektów losowych i plan mocy w ramach wsparcia statystycznego dla badaczy. Planowanie eksperymentów i badań ankietowych zbiera też przewodnik po ankietach i eksperymentach.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik efekty-skrzyzowane-dane.csv (możesz go pobrać tutaj), liczy analizy po uczestnikach i po słowach oraz trzy modele mieszane. Drugi to symulacja błędu I rodzaju (1500 modeli, kilka minut). Potrzebne pakiety: lme4 i lmerTest.
1. Dane, analizy F1 i F2 oraz modele z efektami skrzyżowanymi
R
# Dane symulowane: zadanie decyzji leksykalnej. 60 uczestników ocenia te same 40 słów
# (20 negatywnych i 20 neutralnych); zmienna zależna to czas reakcji w ms.
# Walencja słowa zmienia się między słowami, a w obrębie uczestnika (każdy widzi oba rodzaje słów).
# Prawdziwy efekt walencji w symulacji wynosi 0 ms: każda różnica między warunkami wynika z doboru słów i szumu.
suppressPackageStartupMessages({library(lme4); library(lmerTest)})
set.seed(20000)
n_os <- 60; n_sl <- 40
slowa <- data.frame(slowo = sprintf("s%02d", 1:n_sl), walencja = rep(c("neutralne", "negatywne"), each = n_sl / 2))
slowa$war <- ifelse(slowa$walencja == "negatywne", 0.5, -0.5)          # kodowanie efektów: −0.5 / +0.5
osoby <- data.frame(osoba = sprintf("o%02d", 1:n_os))
u0 <- rnorm(n_os, 0, 80); u1 <- rnorm(n_os, 0, 25)                    # uczestnicy: tempo i wrażliwość na walencję
w0 <- rnorm(n_sl, 0, 40)                                                # słowa: każde ma własną trudność
dane <- merge(osoby, slowa)
io <- match(dane$osoba, osoby$osoba); is <- match(dane$slowo, slowa$slowo)
dane$rt <- round(650 + u0[io] + w0[is] + (0 + u1[io]) * dane$war + rnorm(nrow(dane), 0, 110))
dane <- dane[order(dane$osoba, dane$slowo), c("osoba", "slowo", "walencja", "war", "rt")]
write.csv(dane, "efekty-skrzyzowane-dane.csv", row.names = FALSE)
head(dane, 4)
c(proby = nrow(dane), uczestnicy = n_os, slowa = n_sl)
round(tapply(dane$rt, dane$walencja, mean), 1)

# A. Analiza „po uczestnikach” (F1): średnie każdej osoby w obu warunkach i test t dla prób zależnych
sr_os <- aggregate(rt ~ osoba + walencja, data = dane, FUN = mean)
szer <- reshape(sr_os, idvar = "osoba", timevar = "walencja", direction = "wide")
t_os <- t.test(szer$rt.negatywne, szer$rt.neutralne, paired = TRUE)
round(c(roznica = unname(t_os$estimate), SE = unname(t_os$stderr), t = unname(t_os$statistic),
        df = unname(t_os$parameter), CI = t_os$conf.int), 3)
signif(t_os$p.value, 3)
# B. Analiza „po bodźcach” (F2): średnia każdego słowa i test t dla prób niezależnych
sr_sl <- aggregate(rt ~ slowo + walencja, data = dane, FUN = mean)
t_sl <- t.test(rt ~ factor(walencja, levels = c("negatywne", "neutralne")), data = sr_sl, var.equal = TRUE)
round(c(t = unname(t_sl$statistic), df = unname(t_sl$parameter), p = t_sl$p.value), 3)

ctrl <- lmerControl(optimizer = "bobyqa")
# C. Model mieszany tylko z uczestnikami (pomija zmienność słów)
m_os <- lmer(rt ~ war + (1 + war | osoba), data = dane, control = ctrl)
# D. Efekty skrzyżowane: uczestnicy i słowa (maksymalna struktura dla tego schematu)
m_max <- lmer(rt ~ war + (1 + war | osoba) + (1 | slowo), data = dane, control = ctrl)
# E. Same losowe wyrazy wolne dla uczestników i słów
m_int <- lmer(rt ~ war + (1 | osoba) + (1 | slowo), data = dane, control = ctrl)
wiersz <- function(m) summary(m)$coefficients["war", ]
round(rbind(tylko_uczestnicy = wiersz(m_os), skrzyzowane_max = wiersz(m_max), skrzyzowane_int = wiersz(m_int)), 3)
round(confint(m_max, parm = "war", method = "Wald"), 1)
print(VarCorr(m_max), comp = c("Variance", "Std.Dev."))
c(isSingular = isSingular(m_max))
# Czy potrzebne losowe nachylenie walencji dla uczestników? (te same efekty stałe, porównanie na REML)
anova(m_int, m_max, refit = FALSE)
# Udział składników wariancji i standaryzowana różnica (mianownik: wariancje wyrazów wolnych + reszta)
vc <- as.data.frame(VarCorr(m_max))
v <- c(uczestnicy = vc$vcov[vc$grp == "osoba" & vc$var1 == "(Intercept)" & is.na(vc$var2)],
       slowa = vc$vcov[vc$grp == "slowo"], reszta = vc$vcov[vc$grp == "Residual"])
round(100 * v / sum(v), 1)
round(fixef(m_max)[["war"]] / sqrt(sum(v)), 3)
Wynik w R
    osoba slowo  walencja  war  rt
1     o01   s01 neutralne -0.5 856
61    o01   s02 neutralne -0.5 755
121   o01   s03 neutralne -0.5 727
181   o01   s04 neutralne -0.5 856
     proby uczestnicy      slowa
      2400         60         40
negatywne neutralne
    640.5     622.0
roznica      SE       t      df     CI1     CI2
 18.533   5.173   3.583  59.000   8.183  28.884
[1] 0.000689
     t     df      p
 1.422 38.000  0.163
                 Estimate Std. Error     df t value Pr(>|t|)
tylko_uczestnicy   18.533      5.173 59.000   3.583    0.001
skrzyzowane_max    18.533     13.289 40.404   1.395    0.171
skrzyzowane_int    18.533     13.034 38.000   1.422    0.163
    2.5 % 97.5 %
war  -7.5   44.6
 Groups   Name        Variance Std.Dev. Corr
 osoba    (Intercept)  6826.49  82.623
          war           402.36  20.059  0.045
 slowo    (Intercept)  1498.34  38.708
 Residual             12030.71 109.685
isSingular
     FALSE
Data: dane
Models:
m_int: rt ~ war + (1 | osoba) + (1 | slowo)
m_max: rt ~ war + (1 + war | osoba) + (1 | slowo)
      npar   AIC   BIC logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_int    5 29647 29676 -14818     29637
m_max    7 29648 29689 -14817     29634 2.6542  2     0.2652
uczestnicy      slowa     reszta
      33.5        7.4       59.1
[1] 0.13
2. Symulacja błędu I rodzaju dla 20, 40 i 80 uczestników
R
# Symulacja błędu I rodzaju: prawdziwy efekt walencji = 0, 40 słów (20 + 20), różna liczba uczestników.
# W każdej replikacji: analiza po uczestnikach (test t na średnich osób) i model z efektami skrzyżowanymi.
# Wymaga obiektu ctrl z przepisu 1 (ta sama sesja R). Czas działania: kilka minut.
symuluj <- function(n_os, n_sl = 40, sd_sl = 40) {
  war_sl <- rep(c(-0.5, 0.5), each = n_sl / 2)
  d <- expand.grid(osoba = factor(1:n_os), slowo = factor(1:n_sl))
  d$war <- war_sl[d$slowo]
  u0 <- rnorm(n_os, 0, 80); u1 <- rnorm(n_os, 0, 25); w0 <- rnorm(n_sl, 0, sd_sl)
  d$rt <- 650 + u0[d$osoba] + w0[d$slowo] + u1[d$osoba] * d$war + rnorm(nrow(d), 0, 110)
  sr <- tapply(d$rt, list(d$osoba, d$war), mean)
  p_f1 <- t.test(sr[, "0.5"], sr[, "-0.5"], paired = TRUE)$p.value
  m <- suppressMessages(suppressWarnings(lmer(rt ~ war + (1 + war | osoba) + (1 | slowo), data = d, control = ctrl)))
  s <- summary(m)$coefficients["war", ]
  c(p_f1 = p_f1, p_skrz = unname(s["Pr(>|t|)"]), se_skrz = unname(s["Std. Error"]), osobliwy = isSingular(m))
}
set.seed(20029)
R <- 500
wyniki <- do.call(rbind, lapply(c(20, 40, 80), function(n) {
  w <- t(replicate(R, symuluj(n)))
  data.frame(uczestnicy = n, blad_I_po_uczestnikach = mean(w[, "p_f1"] < .05),
             blad_I_skrzyzowane = mean(w[, "p_skrz"] < .05), sredni_SE_skrzyzowane = mean(w[, "se_skrz"]),
             odsetek_osobliwych = mean(w[, "osobliwy"]))
}))
wyniki$blad_I_po_uczestnikach_MCSE <- sqrt(wyniki$blad_I_po_uczestnikach * (1 - wyniki$blad_I_po_uczestnikach) / R)
wyniki$blad_I_skrzyzowane_MCSE <- sqrt(wyniki$blad_I_skrzyzowane * (1 - wyniki$blad_I_skrzyzowane) / R)
print(round(wyniki, 3))
# Dolna granica SE różnicy warunków wynikająca z samej próby słów (σ_słów = 40, po 20 słów w warunku)
round(sqrt(40^2 / 20 + 40^2 / 20), 2)
Wynik w R
  uczestnicy blad_I_po_uczestnikach blad_I_skrzyzowane sredni_SE_skrzyzowane
1         20                  0.228              0.048                15.823
2         40                  0.318              0.046                14.301
3         80                  0.516              0.062                13.421
  odsetek_osobliwych blad_I_po_uczestnikach_MCSE blad_I_skrzyzowane_MCSE
1              0.210                       0.019                   0.010
2              0.038                       0.021                   0.009
3              0.014                       0.022                   0.011
[1] 12.65
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4 i lmerTest; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Uśrednianie po bodźcach przed analizą. Test t albo ANOVA na średnich osób traktuje bodźce jako stałe i zawyża błąd I rodzaju, tym bardziej, im więcej osób zbadasz.
- Usuwanie losowego efektu bodźców, gdy model się nie zbiega. Upraszczaj najpierw korelacje i nachylenia, a nie czynnik, który odpowiada za uogólnienie na inne bodźce.
- Identyfikatory bodźców powtarzające się w podzbiorach. Jeśli słowo „s01” w dwóch listach to różne słowa, lme4 potraktuje je jak jedno.
- Analiza mocy tylko dla liczby osób. Przy małej liczbie bodźców nawet bardzo duża próba osób nie da wysokiej mocy.
- Kodowanie 0/1 przy interakcjach. Przy kodowaniu zero-jedynkowym efekt główny jednego czynnika jest efektem prostym w kategorii odniesienia drugiego; przy kodowaniu ±0.5 jest efektem uśrednionym.
Najczęstsze pytania
Kiedy bodźce traktować jako efekt losowy?
Gdy chcesz uogólnić wynik na inne bodźce tego samego rodzaju, a użyte słowa, twarze czy winiety są tylko ich próbą. Tak jest w większości eksperymentów psychologicznych. Bodźce traktujesz jako stałe tylko wtedy, gdy wniosek dotyczy wyłącznie tych konkretnych bodźców, np. dwóch wersji jednej reklamy.
Czy wystarczy test t albo ANOVA na średnich uczestników w eksperymencie z wieloma bodźcami?
Nie, jeśli wnioskujesz o bodźcach w ogóle. Uśrednianie po bodźcach ukrywa ich zmienność i zawyża błąd I rodzaju. W symulacji z zerowym efektem i 40 słowami test t na średnich osób dawał wynik istotny w 22.8–51.6% badań, a model z efektami skrzyżowanymi w 4.6–6.2%.
Jak zapisać skrzyżowane efekty losowe w lme4?
Dwoma osobnymi członami: lmer(rt ~ war + (1 + war | osoba) + (1 | slowo), data = dane). Losowe nachylenie warunku dodaj dla tego czynnika, w obrębie którego warunek się zmienia. Upewnij się, że każdy bodziec ma unikalny identyfikator w całym zbiorze.
Czy więcej uczestników zwiększa moc w eksperymencie z bodźcami?
Tylko do pewnego stopnia. Gdy bodźce są czynnikiem losowym, błąd standardowy efektu nie spada poniżej granicy wyznaczonej przez liczbę i zróżnicowanie bodźców. W przykładzie z 20 słowami na warunek granica ta wynosiła 12.65 ms, a przy 80 osobach średni SE wynosił 13.42 ms. Najskuteczniej zwiększysz moc, dodając bodźce.
Co zrobić, gdy model z losowymi efektami osób i bodźców daje singular fit?
Sprawdź, który składnik szacuje się na zerze albo która korelacja wynosi ±1, i upraszczaj od korelacji efektów losowych oraz nachyleń o najmniejszej wariancji. Nie usuwaj losowego wyrazu wolnego bodźców tylko po to, żeby model się zbiegł. Regułę upraszczania ustal przed analizą i opisz ją w raporcie.
Powiązane hasła
Przeczytaj też
ANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikWielopoziomowa regresja logistyczna (GLMM)
glmer krok po kroku: ICC z π²/3 i MOR, ilorazy szans warunkowe a uśrednione, kwadratura, zbieżność, prawdopodobieństwa i wzór opisu APA.
Czytaj →Recenzent pyta, dlaczego bodźce nie są w modelu efektem losowym?
Pomożemy zbudować model z efektami skrzyżowanymi, dobrać strukturę efektów losowych, zaplanować liczbę bodźców i wyjaśnić wyniki tak, żebyś mógł(a) samodzielnie je opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Baayen, R. H., Davidson, D. J., & Bates, D. M. (2008). Mixed-effects modeling with crossed random effects for subjects and items. Journal of Memory and Language, 59(4), 390–412. https://doi.org/10.1016/j.jml.2007.12.005 ● Otwarty dostęp: pełny tekst
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Brauer, M., & Curtin, J. J. (2018). Linear mixed-effects models and the analysis of nonindependent data: A unified framework to analyze categorical and continuous independent variables that vary within-subjects and/or within-items. Psychological Methods, 23(3), 389–411. https://doi.org/10.1037/met0000159
- Clark, H. H. (1973). The language-as-fixed-effect fallacy: A critique of language statistics in psychological research. Journal of Verbal Learning and Verbal Behavior, 12(4), 335–359. https://doi.org/10.1016/s0022-5371(73)80014-3
- Judd, C. M., Westfall, J., & Kenny, D. A. (2012). Treating stimuli as a random factor in social psychology: A new and comprehensive solution to a pervasive but largely ignored problem. Journal of Personality and Social Psychology, 103(1), 54–69. https://doi.org/10.1037/a0028347
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13 ● Otwarty dostęp
- Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001 ● Otwarty dostęp
- Westfall, J., Kenny, D. A., & Judd, C. M. (2014). Statistical power and optimal design in experiments in which samples of participants respond to samples of stimuli. Journal of Experimental Psychology: General, 143(5), 2020–2045. https://doi.org/10.1037/xge0000014
Cytowania BibTeX
@article{baayen2008mixed, author={Baayen, R. Harald and Davidson, Douglas J. and Bates, Douglas M.}, title={{Mixed-effects modeling with crossed random effects for subjects and items}}, journal={Journal of Memory and Language}, year={2008}, volume={59}, number={4}, pages={390--412}, doi={10.1016/j.jml.2007.12.005}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{brauer2018linear, author={Brauer, Markus and Curtin, John J.}, title={{Linear mixed-effects models and the analysis of nonindependent data: A unified framework to analyze categorical and continuous independent variables that vary within-subjects and/or within-items}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={389--411}, doi={10.1037/met0000159}}@article{clark1973language, author={Clark, Herbert H.}, title={{The language-as-fixed-effect fallacy: A critique of language statistics in psychological research}}, journal={Journal of Verbal Learning and Verbal Behavior}, year={1973}, volume={12}, number={4}, pages={335--359}, doi={10.1016/s0022-5371(73)80014-3}}@article{judd2012treating, author={Judd, Charles M. and Westfall, Jacob and Kenny, David A.}, title={{Treating stimuli as a random factor in social psychology: A new and comprehensive solution to a pervasive but largely ignored problem}}, journal={Journal of Personality and Social Psychology}, year={2012}, volume={103}, number={1}, pages={54--69}, doi={10.1037/a0028347}}@article{kuznetsova2017lmertest, author={Kuznetsova, Alexandra and Brockhoff, Per B. and Christensen, Rune H. B.}, title={{lmerTest package: Tests in linear mixed effects models}}, journal={Journal of Statistical Software}, year={2017}, volume={82}, number={13}, pages={1--26}, doi={10.18637/jss.v082.i13}}@article{matuschek2017balancing, author={Matuschek, Hannes and Kliegl, Reinhold and Vasishth, Shravan and Baayen, Harald and Bates, Douglas}, title={{Balancing Type I error and power in linear mixed models}}, journal={Journal of Memory and Language}, year={2017}, volume={94}, pages={305--315}, doi={10.1016/j.jml.2017.01.001}}@article{westfall2014statistical, author={Westfall, Jacob and Kenny, David A. and Judd, Charles M.}, title={{Statistical power and optimal design in experiments in which samples of participants respond to samples of stimuli}}, journal={Journal of Experimental Psychology: General}, year={2014}, volume={143}, number={5}, pages={2020--2045}, doi={10.1037/xge0000014}}