glmer() są warunkowe (w obrębie skupienia) i leżą dalej od 1 niż ilorazy uśrednione w populacji z GEE, więc napisz, który raportujesz.Kiedy zwykła regresja logistyczna nie wystarcza
Wynik jest binarny (zdarzenie wystąpiło albo nie), a obserwacje tworzą skupienia: pacjentów w szpitalach, uczniów w szkołach, próby u tej samej osoby. Zwykła regresja logistyczna zakłada niezależność obserwacji, więc zaniża błędy standardowe predyktorów mierzonych na poziomie skupienia i daje fałszywie małe wartości p. Taki błąd to odmiana pseudoreplikacji. Rozwiązaniem jest wielopoziomowa regresja logistyczna, czyli uogólniony liniowy model mieszany (GLMM) z funkcją łączącą logit.
Interpretację ilorazów szans i diagnostykę jednopoziomowego modelu omawia poradnik regresja logistyczna krok po kroku, a centrowanie, losowe nachylenia i interakcje międzypoziomowe przy wyniku ciągłym – model wielopoziomowy krok po kroku. Tu skupiamy się na tym, co jest specyficzne dla wyniku binarnego: ICC na skali latentnej, różnicę między ilorazem szans warunkowym a uśrednionym, metodę aproksymacji wiarygodności, ostrzeżenia funkcji glmer() z pakietu lme4 (Bates i in., 2015) i prawdopodobieństwa przewidywane. Kolejność kroków jest zbliżona do procedury Sommeta i Morselliego (2017): model pusty, test losowego nachylenia, model końcowy.
Przykład: ponowne hospitalizacje w 36 szpitalach
Analizujemy 30-dniowe ponowne przyjęcia pacjentów wypisanych po zaostrzeniu niewydolności serca. Część szpitali prowadzi program telefonicznej kontroli po wypisie (zmienna poziomu 2, nierandomizowana). Na poziomie pacjenta mamy wiek, liczbę chorób współistniejących i informację, czy pacjent mieszka sam. Dane są symulowane, a wszystkie liczby pochodzą z kodu R na końcu strony. Zbiór możesz pobrać jako plik CSV (1979 wierszy: szpital, program, lozka, wiek, choroby, sam, rehosp).
| Element | Wartość |
|---|---|
| Szpitale | 36: 17 z programem, 19 bez programu |
| Pacjenci | 1979, od 26 do 92 w szpitalu |
| Ponowna hospitalizacja w ciągu 30 dni | 16.4% ogółem; 12.4% w szpitalach z programem, 20.7% bez programu |
| Rozrzut odsetków między szpitalami | od 2.1% do 44.9% |
Wiek kodujemy w dekadach od 75 lat, a liczbę chorób jako odchylenie od 2, więc wyraz wolny opisuje realnego pacjenta (centrowanie zmiennych wokół stałej).
Krok 1. Model pusty i ICC na skali latentnej
Model pusty zawiera tylko wyraz wolny i losowy wyraz wolny szpitala:
W modelu liniowym ICC to udział wariancji między skupieniami w wariancji całkowitej. W modelu logistycznym nie ma jednak reszty poziomu 1 o oszacowanej wariancji. Najczęściej przyjmuje się więc ujęcie latentne: wynik 0/1 powstaje z przekroczenia progu przez ciągłą zmienną ukrytą o rozkładzie logistycznym, której wariancja wynosi π²/3 ≈ 3.29. Goldstein i in. (2002) pokazują, że w modelach z wynikiem dyskretnym podział wariancji nie jest tak prosty jak w modelu liniowym, a ujęcie latentne to jedna z kilku możliwych metod.
W przykładzie τ² = 0.548, więc ICC = .143: 14.3% zmienności skłonności do ponownej hospitalizacji przypada na różnice między szpitalami. Ta sama wariancja daje medianowy iloraz szans MOR = 2.03. Gdy losowo wybierzesz dwa szpitale i porównasz tego samego pacjenta w szpitalu o wyższym i niższym ryzyku, mediana ilorazu szans wyniesie około 2. Merlo i in. (2006) pokazali, że MOR daje łatwiejszą do zinterpretowania informację o znaczeniu kontekstu niż ICC. Ma też tę zaletę, że możesz go porównać z ilorazami szans predyktorów. Model pusty był lepiej dopasowany niż regresja bez efektu szpitala, χ²(1) = 71.95, p < .001 (test ilorazu wiarygodności, wartość p podzielona przez 2, bo wariancja nie może być ujemna).
Krok 2. Predyktory poziomu 1 i 2
Do modelu dodajemy trzy predyktory poziomu pacjenta i program na poziomie szpitala. Efekty stałe interpretujesz jak w zwykłej regresji logistycznej, z jedną ważną różnicą, którą opisuje krok 3.
| Predyktor | b (SE) | OR | 95% CI | z | p |
|---|---|---|---|---|---|
| Wyraz wolny | −1.624 (0.186) | 0.197 | [0.137, 0.283] | −8.75 | < .001 |
| Wiek (na 10 lat) | 0.279 (0.072) | 1.322 | [1.148, 1.522] | 3.89 | < .001 |
| Liczba chorób współistniejących | 0.208 (0.042) | 1.231 | [1.134, 1.336] | 4.97 | < .001 |
| Mieszka sam (1 = tak) | 0.395 (0.134) | 1.485 | [1.143, 1.930] | 2.96 | .003 |
| Program kontroli (poziom 2) | −0.729 (0.263) | 0.482 | [0.288, 0.807] | −2.78 | .006 |
Wyraz wolny 0.197 to szansa ponownego przyjęcia u 75-latka z dwiema chorobami, który nie mieszka sam, w typowym szpitalu bez programu. W szpitalach z programem szansa była o około połowę niższa (OR = 0.48). Program nie był losowo przydzielany, więc to związek, a nie efekt przyczynowy. Precyzję efektu poziomu 2 wyznacza liczba szpitali (36), a nie 1979 pacjentów. Ten sam problem przy planowaniu badania opisuje efekt schematu.
Wariancja między szpitalami spadła do τ² = 0.438 (resztowy ICC = .117, MOR = 1.88). Nie nazywaj jednak tego spadku o 20.1% „wariancją wyjaśnioną”. W modelu logistycznym dodanie predyktorów poziomu 1 zmienia skalę wszystkich współczynników, więc τ² może nawet wzrosnąć. Do opisu dopasowania lepsze są miary z hasła R² w modelach wielopoziomowych.
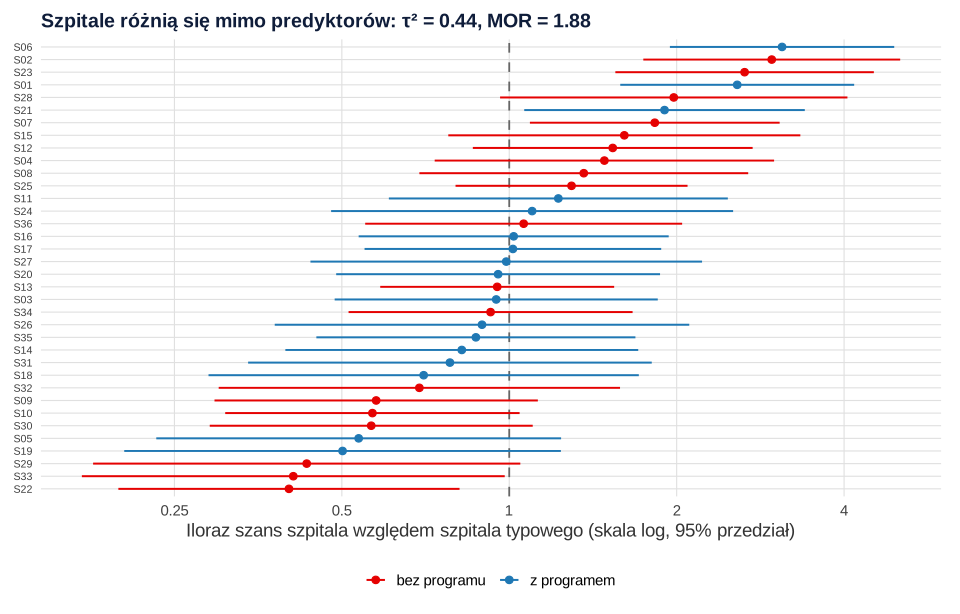
Czy wpływ chorób współistniejących różni się między szpitalami? Model z losowym nachyleniem liczby chorób nie był lepszy, χ²(2) = 0.54, p = .764, więc zostajemy przy losowym wyrazie wolnym. Ten test jest konserwatywny, bo wariancja nachylenia leży na granicy przestrzeni parametrów.
Krok 3. Iloraz szans warunkowy a uśredniony w populacji
To najważniejsza różnica między GLMM a zwykłą regresją logistyczną. Iloraz szans z glmer() jest warunkowy (ang. subject-specific, cluster-specific): porównuje pacjentów z tego samego szpitala albo z dwóch szpitali o tym samym efekcie losowym. Model uśredniony w populacji (ang. population-averaged, PA) opisuje natomiast, jak zmienia się odsetek zdarzeń w całej populacji szpitali. Zeger i in. (1988) wprowadzili to rozróżnienie i pokazali, że przy normalnym rozkładzie efektów losowych współczynnik PA jest w przybliżeniu współczynnikiem warunkowym podzielonym przez √(1 + 0.346 τ²). Oba ujęcia odpowiadają na różne pytania, bo logit średniej nie jest średnią logitów.
Klasycznym estymatorem modelu PA są uogólnione równania estymujące (GEE). Pakiet geepack nie jest zainstalowany w naszym środowisku, dlatego model PA przybliżamy zwykłą regresją logistyczną z błędami standardowymi odpornymi na skupienia (sandwich::vcovCL). Daje ona te same oszacowania co GEE z niezależną roboczą macierzą korelacji. Trzecie ujęcie to uśrednienie przewidywań samego GLMM po rozkładzie efektów szpitali, co opisują Austin i Merlo (2017).
| Predyktor | OR warunkowy (GLMM) | OR uśredniony (glm) | OR z przybliżenia | SE glm naiwny | SE glm odporny |
|---|---|---|---|---|---|
| Wiek (na 10 lat) | 1.322 | 1.273 | 1.297 | 0.070 | 0.074 |
| Liczba chorób | 1.231 | 1.223 | 1.214 | 0.041 | 0.041 |
| Mieszka sam | 1.485 | 1.445 | 1.446 | 0.130 | 0.150 |
| Program kontroli | 0.482 | 0.545 | 0.507 | 0.125 | 0.259 |
Ilorazy uśrednione leżą bliżej 1 niż warunkowe. Szanse w szpitalach z programem są niższe o 52% w ujęciu warunkowym i o 45–49% w ujęciu populacyjnym. Uśrednienie przewidywań GLMM daje OR = 0.511 i różnicę ryzyka −9.0 punktu procentowego (21.0% bez programu wobec 12.0% z programem). Ostatnie kolumny pokazują skutek ignorowania skupień: naiwny błąd standardowy programu (0.125) jest ponad dwa razy mniejszy od odpornego (0.259).
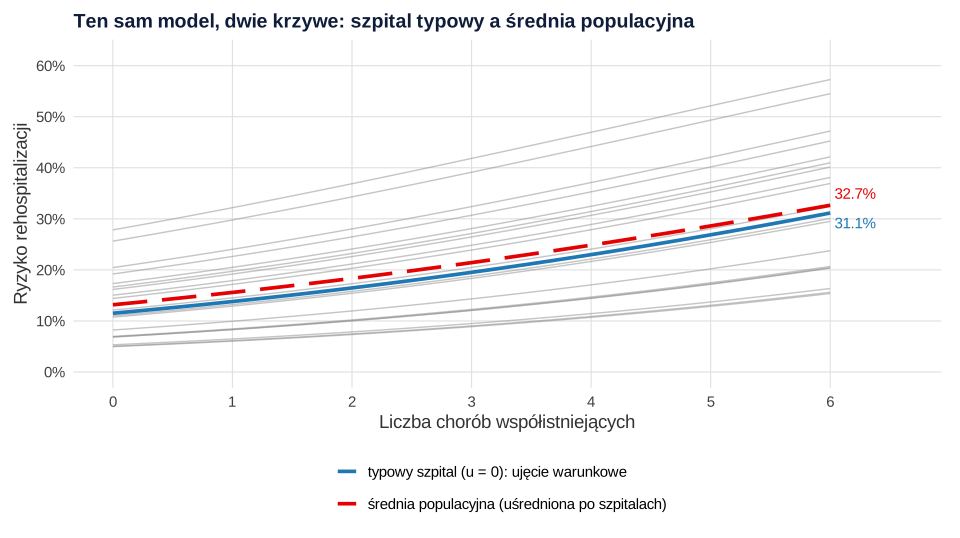
Które ujęcie wybrać? Warunkowe, gdy pytasz o pacjenta lub szpital („co się zmieni dla tego pacjenta w tym szpitalu”). Populacyjne, gdy pytasz o politykę zdrowotną („o ile spadnie odsetek ponownych przyjęć, jeśli program obejmie wszystkie szpitale”). Hubbard i in. (2010) bronią modeli PA, bo wymagają mniej nieweryfikowalnych założeń o rozkładzie efektów losowych. GLMM pozwala za to opisać zmienność między szpitalami i przewidywać dla konkretnych szpitali. W pracy napisz wprost, który iloraz raportujesz.
Krok 4. Laplace czy kwadratura Gaussa–Hermite'a (nAGQ)
Wiarygodność GLMM wymaga całkowania po efektach losowych i nie ma postaci zamkniętej. Domyślnie glmer() używa aproksymacji Laplace’a (nAGQ = 1). Adaptacyjna kwadratura Gaussa–Hermite’a z większą liczbą punktów (np. nAGQ = 25) przybliża tę całkę dokładniej, ale w lme4 działa tylko wtedy, gdy model ma jeden skalarny efekt losowy, czyli sam losowy wyraz wolny jednego czynnika. Bolker i in. (2009) przypominają, że złożone GLMM trudno dopasować, a wnioskowanie z nich bywa trudne. Różnice między metodami aproksymacji rosną zwykle przy małych skupieniach i rzadkich zdarzeniach.
W przykładzie różnice były pomijalne: współczynnik programu −0.7293 (Laplace) i −0.7295 (25 punktów), τ² = 0.438 i 0.443. To typowe przy dużych skupieniach (tu 26–92 pacjentów). Sprawdź kwadraturę, gdy skupienia są małe (pary, rodziny, kilka prób na osobę), zdarzenie jest rzadkie albo τ² duże, a przy różnicach raportuj model z kwadraturą.
Krok 5. Ostrzeżenia o zbieżności i co z nimi zrobić
GLMM częściej niż modele liniowe kończą się ostrzeżeniem. Dodaliśmy do modelu liczbę łóżek szpitala w surowych jednostkach (268–884) obok predyktorów rzędu 0–1. glmer() zgłosił: „Model is nearly unidentifiable: very large eigenvalue – Rescale variables?”. Po wycentrowaniu i przeliczeniu na setki łóżek ostrzeżenie zniknęło, a współczynnik w przeliczeniu na 100 łóżek był w obu modelach taki sam (0.0542). Ostrzeżenie było więc problemem numerycznym, a nie merytorycznym. Tak wygląda rozsądna kolejność postępowania:
- Przeskaluj i wycentruj predyktory ciągłe. To usuwa większość ostrzeżeń o dużych wartościach własnych i gradiencie.
- Sprawdź, czy wynik zależy od optymalizatora. Funkcja
allFit()dopasowuje model kilkoma algorytmami. W przykładzie pięć optymalizatorów dało identyczne współczynniki i log-wiarygodność (−821.261), więc wynik jest wiarygodny. - Przy osobliwym dopasowaniu (boundary (singular) fit) uprość strukturę efektów losowych, np. usuń korelację albo losowe nachylenie bliskie zera. Barr i in. (2013) zalecają strukturę maksymalną uzasadnioną schematem. Matuschek i in. (2017) pokazują, że struktura dobrana do danych daje zwykle wyższą moc bez zawyżania błędu I rodzaju. Więcej o osobliwym dopasowaniu piszemy we wpisie ANOVA z powtarzanymi pomiarami czy model mieszany.
- Sprawdź separację. Ogromne współczynniki i błędy standardowe sygnalizują, że predyktor idealnie rozdziela wynik w części skupień (zob. separacja w regresji logistycznej).
- Opisz w pracy, co zmieniłeś i czy wnioski pozostały takie same.
Krok 6. Prawdopodobieństwa przewidywane
Ryzyko w procentach jest czytelniejsze niż iloraz szans. Pakiet emmeans liczy średnie brzegowe na skali prawdopodobieństwa. Dla pacjenta o średnim wieku i średniej liczbie chorób w próbie (uśrednione po samotnym mieszkaniu) i typowego szpitala przewidywane ryzyko wynosi 19.6%, 95% CI [14.6, 25.8], bez programu i 10.5%, 95% CI [7.4, 14.8], z programem. Kontrast tych dwóch wartości to dokładnie iloraz szans z modelu: OR = 0.48, 95% CI [0.29, 0.81].
Ryzyko rośnie z liczbą chorób: od 11.5% przy braku chorób do 31.1% przy sześciu (75 lat, nie mieszka sam, szpital typowy bez programu). Pamiętaj, że emmeans dla GLMM podaje prawdopodobieństwa warunkowe, czyli dla szpitala z u = 0. Uśrednione ryzyko z kroku 3 (21.0% bez programu) jest wyższe niż 19.6%. Uśrednia ono przewidywania po rozkładzie szpitali i po wszystkich pacjentach, a nie podstawia średnich wartości do nieliniowej krzywej. Jeśli czytelnik ma dostać odsetki „dla całej populacji”, podaj wartości uśrednione z kroku 3.
Jak opisać wielopoziomową regresję logistyczną (APA)
W części „Metoda” podaj liczbę skupień i zakres ich wielkości, funkcję łączącą, strukturę efektów losowych i powód jej wyboru, metodę aproksymacji (Laplace albo liczbę punktów kwadratury), kodowanie i centrowanie predyktorów oraz to, czy raportujesz ilorazy warunkowe, czy uśrednione. W wynikach pokaż τ², ICC na skali latentnej lub MOR z modelu pustego, tabelę efektów stałych z OR i 95% CI (wzór w haśle tabela regresji logistycznej w APA) oraz prawdopodobieństwa przewidywane. Wymogi czasopism medycznych zbiera wpis statystyka w publikacji medycznej.
Jeśli recenzent pyta, dlaczego Twój iloraz szans różni się od wyniku GEE w innym badaniu, albo chcesz sprawdzić strukturę efektów losowych przed wysłaniem pracy, możemy przejrzeć model w ramach wsparcia statystycznego dla badaczy. W badaniach z losowaniem całych szpitali zajrzyj też do wpisu badanie z randomizacją klastrową, a gdy te same osoby mierzysz wiele razy – do wpisu modele wzrostu w lme4.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik glmm-rehospitalizacje-dane.csv (możesz go pobrać tutaj) i dopasowuje modele. Drugi pokazuje ostrzeżenie o zbieżności i jego naprawę. Trzeci porównuje ilorazy szans i liczy prawdopodobieństwa przewidywane. Potrzebne pakiety: lme4, sandwich i emmeans.
1. Model pusty, ICC, MOR, predyktory, kwadratura i losowe nachylenie
R
# Dane symulowane: 30-dniowa ponowna hospitalizacja (0/1) pacjentów z niewydolnością serca w 36 szpitalach.
# Poziom 1 (pacjent): wiek, liczba chorób współistniejących, samotne mieszkanie; poziom 2 (szpital): program telefonicznej kontroli po wypisie.
suppressPackageStartupMessages(library(lme4))
set.seed(17514)
J <- 36
szpitale <- data.frame(szpital = sprintf("S%02d", 1:J), program = rbinom(J, 1, .5),
                       n = sample(25:95, J, replace = TRUE), u = rnorm(J, 0, sqrt(.45)))
dane <- szpitale[rep(1:J, szpitale$n), c("szpital", "program", "u")]
N <- nrow(dane)
dane$wiek <- round(pmin(pmax(rnorm(N, 74, 9), 50), 95))
dane$choroby <- pmin(rpois(N, 2.2), 8)
dane$sam <- rbinom(N, 1, .30)
eta <- -1.70 + 0.22 * (dane$wiek - 75) / 10 + 0.28 * (dane$choroby - 2) + 0.40 * dane$sam - 0.50 * dane$program + dane$u
dane$rehosp <- rbinom(N, 1, plogis(eta))
dane$u <- NULL
szpitale$lozka <- round(runif(J, 250, 900))       # liczba łóżek (cecha szpitala, w modelu niepotrzebna; użyta w kroku 5)
dane$lozka <- szpitale$lozka[match(dane$szpital, szpitale$szpital)]
# Predyktory poziomu 1 wycentrowane wokół wartości stałych: wiek w dekadach od 75 lat, choroby od 2
dane$wiek10 <- (dane$wiek - 75) / 10
dane$choroby_c <- dane$choroby - 2
write.csv(dane[, c("szpital", "program", "lozka", "wiek", "choroby", "sam", "rehosp")], "glmm-rehospitalizacje-dane.csv", row.names = FALSE)

# Opis danych
c(pacjenci = N, szpitale = J, min_n = min(table(dane$szpital)), max_n = max(table(dane$szpital)),
  odsetek_rehosp = round(100 * mean(dane$rehosp), 1))
round(100 * tapply(dane$rehosp, dane$program, mean), 1)          # odsetek ponownych hospitalizacji: bez programu / z programem
table(program = szpitale$program)
round(range(100 * tapply(dane$rehosp, dane$szpital, mean)), 1)   # rozrzut odsetków między szpitalami

# Krok 1. Model pusty: wariancja między szpitalami, ICC na skali latentnej i MOR
m0 <- glmer(rehosp ~ 1 + (1 | szpital), data = dane, family = binomial)
tau2_0 <- as.numeric(VarCorr(m0)$szpital)
c(tau2 = round(tau2_0, 3), ICC = round(tau2_0 / (tau2_0 + pi^2 / 3), 3), MOR = round(exp(sqrt(2 * tau2_0) * qnorm(.75)), 2))
# Test wariancji szpitali: model pusty vs zwykła regresja logistyczna (p dzielone na 2, bo wariancja nie może być < 0)
lrt0 <- 2 * (as.numeric(logLik(m0)) - as.numeric(logLik(glm(rehosp ~ 1, data = dane, family = binomial))))
c(chi2 = round(lrt0, 2), p = signif(pchisq(lrt0, 1, lower.tail = FALSE) / 2, 3))

# Krok 2. Predyktory poziomu 1 i 2 (Laplace, nAGQ = 1)
m1 <- glmer(rehosp ~ wiek10 + choroby_c + sam + program + (1 | szpital), data = dane, family = binomial)
ci1 <- confint(m1, parm = "beta_", method = "Wald")
tab <- cbind(b = fixef(m1), SE = sqrt(diag(vcov(m1))), OR = exp(fixef(m1)), dolny = exp(ci1[, 1]), gorny = exp(ci1[, 2]),
             z = coef(summary(m1))[, "z value"], p = coef(summary(m1))[, "Pr(>|z|)"])
round(tab, 3)
tau2_1 <- as.numeric(VarCorr(m1)$szpital)
c(tau2 = round(tau2_1, 3), ICC_resztowe = round(tau2_1 / (tau2_1 + pi^2 / 3), 3), MOR = round(exp(sqrt(2 * tau2_1) * qnorm(.75)), 2),
  proc_wyjasn_tau2 = round(100 * (1 - tau2_1 / tau2_0), 1))

# Krok 3. Laplace a adaptacyjna kwadratura Gaussa–Hermite'a (25 punktów)
m1q <- update(m1, nAGQ = 25)
round(cbind(Laplace = c(fixef(m1), tau2 = tau2_1), AGQ25 = c(fixef(m1q), tau2 = as.numeric(VarCorr(m1q)$szpital))), 4)

# Krok 4. Czy efekt chorób współistniejących różni się między szpitalami? Losowe nachylenie + LRT
m2 <- glmer(rehosp ~ wiek10 + choroby_c + sam + program + (1 + choroby_c | szpital), data = dane, family = binomial)
print(VarCorr(m2), comp = "Variance")
isSingular(m2)
anova(m1, m2)
Wynik w R
      pacjenci       szpitale          min_n          max_n odsetek_rehosp
        1979.0           36.0           26.0           92.0           16.4
   0    1
20.7 12.4
program
 0  1
19 17
[1]  2.1 44.9
 tau2   ICC   MOR
0.548 0.143 2.030
     chi2         p
7.195e+01 1.100e-17
                 b    SE    OR dolny gorny      z     p
(Intercept) -1.624 0.186 0.197 0.137 0.283 -8.754 0.000
wiek10       0.279 0.072 1.322 1.148 1.522  3.885 0.000
choroby_c    0.208 0.042 1.231 1.134 1.336  4.974 0.000
sam          0.395 0.134 1.485 1.143 1.930  2.959 0.003
program     -0.729 0.263 0.482 0.288 0.807 -2.776 0.006
            tau2     ICC_resztowe              MOR proc_wyjasn_tau2
           0.438            0.117            1.880           20.100
            Laplace   AGQ25
(Intercept) -1.6245 -1.6253
wiek10       0.2790  0.2792
choroby_c    0.2077  0.2078
sam          0.3954  0.3956
program     -0.7293 -0.7295
tau2         0.4376  0.4435
 Groups  Name        Variance  Corr
 szpital (Intercept) 0.4617061
         choroby_c   0.0032968 -0.667
[1] FALSE
Data: dane
Models:
m1: rehosp ~ wiek10 + choroby_c + sam + program + (1 | szpital)
m2: rehosp ~ wiek10 + choroby_c + sam + program + (1 + choroby_c | szpital)
   npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m1    6 1655.1 1688.7 -821.56    1643.1
m2    8 1658.6 1703.3 -821.29    1642.6 0.5385  2     0.7639
2. Ostrzeżenie o zbieżności, przeskalowanie i allFit
R
# Krok 5. Ostrzeżenia o zbieżności: liczba łóżek w surowych jednostkach (268–884) obok predyktorów rzędu 0–1
m_surowy <- glmer(rehosp ~ wiek + choroby + sam + program + lozka + (1 | szpital), data = dane, family = binomial)
# Naprawa 1: przeskalowanie i wycentrowanie (łóżka w setkach od średniej)
dane$lozka100 <- (dane$lozka - mean(szpitale$lozka)) / 100
m_skal <- glmer(rehosp ~ wiek10 + choroby_c + sam + program + lozka100 + (1 | szpital), data = dane, family = binomial)
length(m_skal@optinfo$conv$lme4$messages)        # 0 = brak ostrzeżeń
# Te same wnioski? Przelicz współczynnik łóżek z modelu surowego na setki łóżek
round(c(surowy_na_100_lozek = 100 * fixef(m_surowy)[["lozka"]], skalowany = fixef(m_skal)[["lozka100"]]), 4)
# Naprawa 2: sprawdzenie, czy różne optymalizatory dają to samo (allFit z lme4)
wsz <- allFit(m_skal, verbose = FALSE)
round(summary(wsz)$fixef, 3)
round(summary(wsz)$llik, 3)
Wynik w R
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model is nearly unidentifiable: very large eigenvalue
 - Rescale variables?;Model is nearly unidentifiable: large eigenvalue ratio
 - Rescale variables?
[1] 0
surowy_na_100_lozek           skalowany
             0.0542              0.0542
                              (Intercept) wiek10 choroby_c   sam program
bobyqa                             -1.648  0.278     0.208 0.393   -0.67
Nelder_Mead                        -1.648  0.278     0.208 0.393   -0.67
nlminbwrap                         -1.648  0.278     0.208 0.393   -0.67
nloptwrap.NLOPT_LN_NELDERMEAD      -1.648  0.278     0.208 0.393   -0.67
nloptwrap.NLOPT_LN_BOBYQA          -1.648  0.278     0.208 0.393   -0.67
                              lozka100
bobyqa                           0.054
Nelder_Mead                      0.054
nlminbwrap                       0.054
nloptwrap.NLOPT_LN_NELDERMEAD    0.054
nloptwrap.NLOPT_LN_BOBYQA        0.054
                       bobyqa                   Nelder_Mead
                     -821.261                      -821.261
                   nlminbwrap nloptwrap.NLOPT_LN_NELDERMEAD
                     -821.261                      -821.261
    nloptwrap.NLOPT_LN_BOBYQA
                     -821.261
3. Ilorazy szans warunkowe i uśrednione, prawdopodobieństwa przewidywane
R
# Krok 6. Iloraz szans warunkowy (GLMM) a uśredniony w populacji
suppressPackageStartupMessages({library(sandwich); library(emmeans)})
# a) zwykła regresja logistyczna z błędami odpornymi na klastrowanie (oszacowania jak w GEE z niezależną macierzą roboczą)
m_pa <- glm(rehosp ~ wiek10 + choroby_c + sam + program, data = dane, family = binomial)
se_pa <- sqrt(diag(vcovCL(m_pa, cluster = ~ szpital)))
se_naiw <- sqrt(diag(vcov(m_pa)))
# b) przybliżenie Zegera i in. (1988): b_PA ≈ b_SS / sqrt(1 + c² τ²), c = 16√3 / (15π)
c2 <- (16 * sqrt(3) / (15 * pi))^2
porown <- cbind(OR_warunkowy = exp(fixef(m1)), OR_usredniony_glm = exp(coef(m_pa)),
                OR_przyblizenie = exp(fixef(m1) / sqrt(1 + c2 * tau2_1)),
                SE_glm_naiwny = se_naiw, SE_glm_odporny = se_pa)
round(porown[-1, ], 3)
# c) uśredniony OR programu z samego GLMM: całkowanie po rozkładzie efektów szpitali N(0, τ²)
u_siatka <- qnorm(ppoints(2000)) * sqrt(tau2_1)
p_usr <- function(prog) {
  X <- model.matrix(~ wiek10 + choroby_c + sam + program, transform(dane, program = prog))
  mean(sapply(u_siatka, function(u) mean(plogis(X %*% fixef(m1) + u))))
}
p0 <- p_usr(0); p1 <- p_usr(1)
round(c(p_bez = p0, p_z = p1, OR_usredniony = (p1 / (1 - p1)) / (p0 / (1 - p0)), roznica_pp = 100 * (p1 - p0)), 3)

# Krok 7. Prawdopodobieństwa przewidywane (emmeans): pacjent o średnich wartościach predyktorów w typowym szpitalu (u = 0)
em <- emmeans(m1, ~ program, type = "response")
summary(em)
summary(pairs(em, reverse = TRUE), infer = TRUE)     # iloraz szans: program vs brak programu
# Przewidywane prawdopodobieństwo wg liczby chorób (0–6), szpital bez programu, osoba 75 lat mieszkająca z kimś
summary(emmeans(m1, ~ choroby_c, at = list(choroby_c = c(-2, 0, 2, 4), wiek10 = 0, sam = 0, program = 0), type = "response"))
Wynik w R
          OR_warunkowy OR_usredniony_glm OR_przyblizenie SE_glm_naiwny
wiek10           1.322             1.273           1.297         0.070
choroby_c        1.231             1.223           1.214         0.041
sam              1.485             1.445           1.446         0.130
program          0.482             0.545           0.507         0.125
          SE_glm_odporny
wiek10             0.074
choroby_c          0.041
sam                0.150
program            0.259
        p_bez           p_z OR_usredniony    roznica_pp
        0.210         0.120         0.511        -9.041
 program  prob     SE  df asymp.LCL asymp.UCL
       0 0.196 0.0283 Inf     0.146     0.258
       1 0.105 0.0186 Inf     0.074     0.148

Results are averaged over the levels of: sam
Confidence level used: 0.95
Intervals are back-transformed from the logit scale
 contrast            odds.ratio    SE  df asymp.LCL asymp.UCL null z.ratio
 program1 / program0      0.482 0.127 Inf     0.288     0.807    1  -2.776
 p.value
  0.0055

Results are averaged over the levels of: sam
Confidence level used: 0.95
Intervals are back-transformed from the log odds ratio scale
Tests are performed on the log odds ratio scale
 choroby_c  prob     SE  df asymp.LCL asymp.UCL
        -2 0.115 0.0216 Inf     0.079     0.165
         0 0.165 0.0255 Inf     0.120     0.221
         2 0.230 0.0344 Inf     0.169     0.304
         4 0.311 0.0503 Inf     0.222     0.417

Confidence level used: 0.95
Intervals are back-transformed from the logit scale
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4, sandwich i emmeans; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- ICC z wariancji reszt „z wydruku”. W modelu logistycznym nie ma oszacowanej wariancji reszt. Użyj π²/3 i napisz, że to ICC na skali latentnej, albo podaj MOR.
- Porównywanie OR z GLMM i z GEE jak równoważnych. Iloraz warunkowy jest dalej od 1 niż uśredniony, i to tym bardziej, im większe jest τ².
- Prawdopodobieństwa z
emmeansopisane jako odsetek w populacji. To ryzyko w szpitalu typowym, a nie średnia po szpitalach. - Efekt poziomu 2 oceniany „na pacjentach”. Moc dla programu zależy od liczby szpitali.
- Wyłączanie ostrzeżeń o zbieżności zamiast przeskalowania predyktorów i sprawdzenia
allFit(). - Wniosek przyczynowy z cechy skupienia. Program wdrożony w niektórych szpitalach może współwystępować z innymi ich cechami. Uważaj też na błąd ekologiczny, gdy z różnic między szpitalami wnioskujesz o pacjentach.
Najczęstsze pytania
Dlaczego w ICC dla wielopoziomowej regresji logistycznej używa się π²/3?
Model logistyczny nie ma oszacowanej wariancji reszt pierwszego poziomu. Zakłada się więc, że wynik 0/1 powstaje z przekroczenia progu przez zmienną ukrytą o rozkładzie logistycznym, której wariancja wynosi π²/3 ≈ 3.29. Wtedy ICC = τ² / (τ² + 3.29). To jedna z kilku metod podziału wariancji (Goldstein i in., 2002), dlatego w pracy napisz, że to ICC na skali latentnej.
Czym różni się iloraz szans z modelu mieszanego od ilorazu szans z GEE?
GLMM daje iloraz warunkowy: porównanie osób w tym samym skupieniu. GEE daje iloraz uśredniony w populacji, który opisuje zmianę odsetka zdarzeń w całej populacji skupień. Przy wyniku binarnym iloraz uśredniony jest bliżej 1, i to tym bardziej, im większa jest wariancja między skupieniami (Zeger i in., 1988).
Kiedy ustawić nAGQ większe niż 1 w funkcji glmer?
Gdy model ma tylko losowy wyraz wolny jednego czynnika, a skupienia są małe, zdarzenie rzadkie albo wariancja między skupieniami duża. Wtedy aproksymacja Laplace’a może być niedokładna. Porównaj wyniki z nAGQ = 1 i np. nAGQ = 25; jeśli się różnią, raportuj model z kwadraturą. Przy losowych nachyleniach lme4 pozwala tylko na Laplace’a.
Co zrobić, gdy glmer zgłasza „Model is nearly unidentifiable: very large eigenvalue”?
Najczęściej predyktory mają bardzo różne skale. Wycentruj i przeskaluj zmienne ciągłe (np. wiek w dekadach, liczbę łóżek w setkach), dopasuj model ponownie i porównaj współczynniki po przeliczeniu. Funkcją allFit() sprawdź, czy różne optymalizatory dają ten sam wynik, i opisz tę decyzję w pracy.
Co oznacza medianowy iloraz szans (MOR) w modelu wielopoziomowym?
MOR to mediana ilorazów szans przy porównaniu tej samej osoby w dwóch losowo wybranych skupieniach, zawsze w kierunku skupienia o wyższym ryzyku. Liczysz go wzorem exp(√(2τ²) × 0.6745). MOR = 1 oznacza brak różnic między skupieniami, a MOR = 2 – różnice tak duże jak predyktor podwajający szanse (Merlo i in., 2006).
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRandomizacja klastrowa – plan i analiza
ICC z przedziałem ufności, efekt schematu przy nierównych oddziałach, cztery analizy tych samych danych, poprawki df i raport CONSORT – z kodem R.
Czytaj →Masz wynik binarny w danych zagnieżdżonych i nie wiesz, który iloraz szans raportować?
Pomożemy zbudować i sprawdzić model GLMM, rozwiązać ostrzeżenia o zbieżności i wyjaśnić ilorazy szans tak, żebyś mógł(a) samodzielnie opisać i obronić wyniki.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., & Merlo, J. (2017). Intermediate and advanced topics in multilevel logistic regression analysis. Statistics in Medicine, 36(20), 3257–3277. https://doi.org/10.1002/sim.7336 ● Otwarty dostęp
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008 ● Otwarty dostęp: pełny tekst
- Goldstein, H., Browne, W., & Rasbash, J. (2002). Partitioning variation in multilevel models. Understanding Statistics, 1(4), 223–231. https://doi.org/10.1207/s15328031us0104_02
- Hubbard, A. E., Ahern, J., Fleischer, N. L., Van der Laan, M., Lippman, S. A., Jewell, N., Bruckner, T., & Satariano, W. A. (2010). To GEE or not to GEE: Comparing population average and mixed models for estimating the associations between neighborhood risk factors and health. Epidemiology, 21(4), 467–474. https://doi.org/10.1097/ede.0b013e3181caeb90
- Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001 ● Otwarty dostęp
- Merlo, J., Chaix, B., Ohlsson, H., Beckman, A., Johnell, K., Hjerpe, P., Råstam, L., & Larsen, K. (2006). A brief conceptual tutorial of multilevel analysis in social epidemiology: Using measures of clustering in multilevel logistic regression to investigate contextual phenomena. Journal of Epidemiology and Community Health, 60(4), 290–297. https://doi.org/10.1136/jech.2004.029454 ● Otwarty dostęp: pełny tekst
- Sommet, N., & Morselli, D. (2017). Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS. International Review of Social Psychology, 30(1), 203–218. https://doi.org/10.5334/irsp.90 ● Otwarty dostęp
- Zeger, S. L., Liang, K.-Y., & Albert, P. S. (1988). Models for longitudinal data: A generalized estimating equation approach. Biometrics, 44(4), 1049–1060. https://doi.org/10.2307/2531734
Cytowania BibTeX
@article{austin2017intermediate, author={Austin, Peter C. and Merlo, Juan}, title={{Intermediate and advanced topics in multilevel logistic regression analysis}}, journal={Statistics in Medicine}, year={2017}, volume={36}, number={20}, pages={3257--3277}, doi={10.1002/sim.7336}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{bolker2009generalized, author={Bolker, Benjamin M. and Brooks, Mollie E. and Clark, Connie J. and Geange, Shane W. and Poulsen, John R. and Stevens, M. Henry H. and White, Jada-Simone S.}, title={{Generalized linear mixed models: A practical guide for ecology and evolution}}, journal={Trends in Ecology \& Evolution}, year={2009}, volume={24}, number={3}, pages={127--135}, doi={10.1016/j.tree.2008.10.008}}@article{goldstein2002partitioning, author={Goldstein, Harvey and Browne, William and Rasbash, Jon}, title={{Partitioning variation in multilevel models}}, journal={Understanding Statistics}, year={2002}, volume={1}, number={4}, pages={223--231}, doi={10.1207/s15328031us0104_02}}@article{hubbard2010gee, author={Hubbard, Alan E. and Ahern, Jennifer and Fleischer, Nancy L. and Van der Laan, Mark and Lippman, Sheri A. and Jewell, Nicholas and Bruckner, Tim and Satariano, William A.}, title={{To GEE or not to GEE: Comparing population average and mixed models for estimating the associations between neighborhood risk factors and health}}, journal={Epidemiology}, year={2010}, volume={21}, number={4}, pages={467--474}, doi={10.1097/ede.0b013e3181caeb90}}@article{matuschek2017balancing, author={Matuschek, Hannes and Kliegl, Reinhold and Vasishth, Shravan and Baayen, Harald and Bates, Douglas}, title={{Balancing Type I error and power in linear mixed models}}, journal={Journal of Memory and Language}, year={2017}, volume={94}, pages={305--315}, doi={10.1016/j.jml.2017.01.001}}@article{merlo2006brief, author={Merlo, Juan and Chaix, Basile and Ohlsson, Henrik and Beckman, Anders and Johnell, Kristina and Hjerpe, Per and Råstam, L. and Larsen, K.}, title={{A brief conceptual tutorial of multilevel analysis in social epidemiology: Using measures of clustering in multilevel logistic regression to investigate contextual phenomena}}, journal={Journal of Epidemiology and Community Health}, year={2006}, volume={60}, number={4}, pages={290--297}, doi={10.1136/jech.2004.029454}}@article{sommet2017keep, author={Sommet, Nicolas and Morselli, Davide}, title={{Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={203--218}, doi={10.5334/irsp.90}}@article{zeger1988models, author={Zeger, Scott L. and Liang, Kung-Yee and Albert, Paul S.}, title={{Models for longitudinal data: A generalized estimating equation approach}}, journal={Biometrics}, year={1988}, volume={44}, number={4}, pages={1049--1060}, doi={10.2307/2531734}}