Kiedy losować oddziały, a nie pacjentów
W badaniu z randomizacją klastrową (cluster randomised trial) losuje się całe grupy: oddziały, przychodnie, szkoły, zespoły. Wszyscy uczestnicy z jednej grupy dostają tę samą interwencję. Takie badanie jest trudniejsze w planowaniu, wymaga więcej uczestników do uzyskania tej samej mocy i bardziej złożonej analizy niż zwykła randomizacja osób (Campbell i in., 2004). Wybierasz je więc nie dlatego, że jest wygodne, tylko dlatego, że losowanie osób nie ma sensu.
Typowe powody są dwa. Pierwszy: interwencja działa na poziomie grupy. Szkolenie personelu z komunikacji z pacjentem zmienia sposób pracy całego oddziału, więc nie da się go „podać” co drugiemu pacjentowi. Drugi: kontaminacja. Gdyby na jednej sali leżeli pacjenci z obu grup, pielęgniarki przeszkolone w nowym sposobie rozmowy stosowałyby go wobec wszystkich, a różnica między grupami by się rozmyła.
Ten wpis dotyczy analizy i raportu. Jak policzyć liczbę klastrów do wniosku grantowego (wzór i symulacja mocy), pokazujemy w poradniku plan analiz do wniosku grantowego na przykładzie klas szkolnych. Kolejne modele wielopoziomowe z predyktorami obu poziomów opisujemy w tekście model wielopoziomowy krok po kroku. Tutaj zostajemy przy jednym pytaniu: jak rzetelnie oszacować efekt interwencji, gdy jednostką losowania jest oddział.
Badanie przykładowe: program komunikacji na 24 oddziałach
W szpitalu wieloprofilowym 24 oddziały (12 zabiegowych i 12 zachowawczych) wylosowano do programu komunikacji personelu z pacjentem albo do zwykłej opieki. Losowanie było warstwowe: w każdej warstwie typu oddziału po 6 oddziałów trafiło do każdej grupy. Wynikiem pierwszorzędowym był lęk pacjenta w dniu wypisu (skala 0–21, wyższy wynik oznacza większy lęk). Dane są symulowane, a wszystkie liczby pochodzą z kodu R na końcu strony. Zbiór możesz pobrać jako plik CSV (838 wierszy: oddział, typ, grupa, wiek, lęk).
| Element | Wartość |
|---|---|
| Klastry | 24 oddziały: 12 w programie, 12 w zwykłej opiece (po 6 w każdej warstwie) |
| Pacjenci | 838: 400 w programie, 438 w zwykłej opiece |
| Wielkość oddziału | 12–48 pacjentów, średnio 34.9; współczynnik zmienności CV = 0.28 |
| Lęk przy wypisie (surowe średnie) | program: M = 7.65, SD = 3.80; zwykła opieka: M = 9.22, SD = 3.55 |
Zwróć uwagę na pierwszy wiersz. W tym badaniu jest 24 niezależne jednostki losowania, a nie 838. Analizowanie 838 pacjentów tak, jakby byli niezależni, to pseudoreplikacja. Ta liczba wyznacza stopnie swobody, precyzję i to, co wolno napisać w abstrakcie.
Ryzyka, których nie ma przy losowaniu osób
Najpoważniejsze ryzyko pojawia się, gdy pacjentów włącza się do badania już po wylosowaniu oddziałów. Personel, który wie, że oddział jest w programie, może inaczej zapraszać pacjentów albo inaczej stosować kryteria włączenia. Puffer i in. (2003) przejrzeli 36 badań klastrowych z trzech czołowych czasopism medycznych. Bezpieczny przydział klastrów potwierdzało tylko 15 z nich (42%), a w 14 (39%) widać było podatność na błąd na poziomie uczestników, choć same klastry zwykle były dobrze zrównoważone.
- Włączaj pacjentów według stałej reguły (np. wszyscy przyjęci w określonym okresie) albo przez osobę, która nie zna przydziału. Wytyczne wymagają opisania, jak ograniczono to ryzyko (Campbell i in., 2004).
- Losuj wszystkie oddziały naraz, z warstwami lub ograniczeniami, gdy klastrów jest mało. Warstwę uwzględnij potem w modelu.
- Zaplanuj zaślepioną ocenę wyniku (zaślepienie), bo personelu i pacjentów zwykle nie da się zaślepić.
- Licz odpadanie na dwóch poziomach: utracone oddziały i utraconych pacjentów (attrition).
Krok 1. ICC i efekt schematu z zebranych danych
Współczynnik korelacji wewnątrzklasowej (ICC) mówi, jaka część zmienności wyniku przypada na różnice między oddziałami. W modelu pustym (bez predyktorów) ICC wyniósł .101, a 95% CI z bootstrapu parametrycznego (500 prób) – [.042, .169]. Przedział jest szeroki, bo opiera się na 24 oddziałach. To dobra lekcja na przyszłość: ICC z jednego badania jest niepewny, więc planując kolejne, sprawdź kilka wartości.
Po uwzględnieniu grupy, typu oddziału i wieku wariancja między oddziałami spadła do 0.841, a reszt wyniosła 12.722. ICC warunkowy wynosi więc .062. Część różnic między oddziałami wyjaśnia sama interwencja i typ oddziału. W raporcie zaznacz, z którego modelu pochodzi ICC.
Z ICC liczysz efekt schematu (design effect). Przy równych oddziałach DE = 1 + (m − 1) × ICC = 4.42. Oddziały nie są jednak równe, a Eldridge i in. (2006) pokazują, że nierówne klastry zmniejszają moc i trzeba to uwzględnić we wzorze:
gdzie m to średnia wielkość klastra, a CV – współczynnik zmienności wielkości klastrów. Tu DE = 4.70, więc 838 pacjentów niesie tyle informacji o efekcie interwencji, co około 178 niezależnych osób. Ta liczba dobrze tłumaczy recenzentowi, dlaczego przedziały ufności są szersze, niż sugeruje liczba pacjentów.
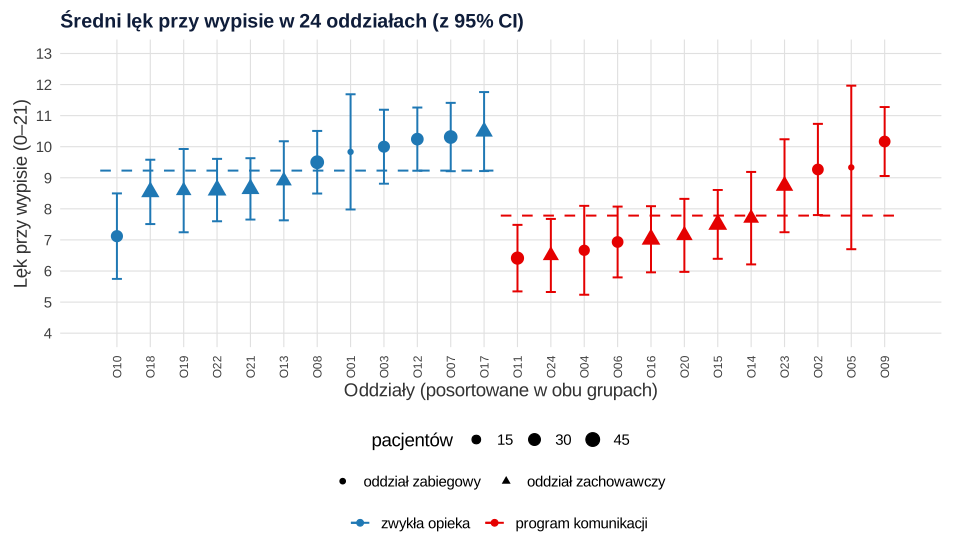
Krok 2. Cztery analizy tych samych danych
Ten sam efekt można oszacować na kilka sposobów. W tabeli zestawiamy błędny i trzy poprawne. Każda analiza uwzględnia warstwę (typ oddziału), a analizy na pacjentach także wiek.
| Analiza | b | SE | df | 95% CI | p |
|---|---|---|---|---|---|
| a) Regresja na pacjentach bez klastrów (błędna) | −1.54 | 0.25 | 834 | [−2.04, −1.05] | < .001 |
| b) Regresja na średnich oddziałów | −1.45 | 0.46 | 21 | [−2.40, −0.50] | .005 |
| c) Model mieszany, df Kenwarda–Rogera | −1.49 | 0.45 | 20.6 | [−2.43, −0.54] | .004 |
| c) Model mieszany, df Satterthwaite’a | −1.49 | 0.45 | 20.3 | [−2.43, −0.54] | .004 |
| d) Regresja z odpornym błędem klastrowym CR2 | −1.54 | 0.45 | 19.4 | [−2.48, −0.61] | .003 |
Oszacowania efektu są podobne. Różnią się błędy standardowe. Regresja bez klastrów podaje SE 0.25 zamiast około 0.45, bo traktuje 838 pacjentów jak niezależne obserwacje. Przy dużym efekcie wniosek się nie zmienia, ale przy mniejszym taka analiza daje „istotność” tam, gdzie jej nie ma. Ignorowanie zależności obserwacji zawyża ryzyko fałszywie istotnego wyniku znacznie ponad nominalne α (Aarts i in., 2014).
Trzy poprawne analizy odpowiadają trzem podejściom:
- Analiza na poziomie klastrów. Liczysz średnią dla każdego oddziału i porównujesz średnie (agregacja danych). Jest prosta i przejrzysta. Gorzej radzi sobie z kowariantami na poziomie pacjenta i z bardzo nierównymi klastrami.
- Model mieszany (model wielopoziomowy) z losowym wyrazem wolnym oddziału. Program i typ oddziału są efektami stałymi, oddział – efektem losowym. Estymacja REML, stopnie swobody z poprawką dla małych prób.
- Regresja z odpornym błędem klastrowym, czyli rozszerzenie odpornych błędów standardowych na klastry, tu w wersji CR2 z poprawką dla małej liczby klastrów. Podobną logikę mają równania GEE.
Wielkość efektu odnieś do całkowitej wariancji z modelu (oddziały + reszty): d = −0.40, 95% CI [−0.66, −0.15]. Szerszy kontekst interpretacji znajdziesz w haśle o standaryzowanej różnicy średnich.
Krok 3. Mała liczba oddziałów i poprawki stopni swobody
Model mieszany nie załatwia sprawy automatycznie. Gdy oddziałów jest kilkanaście, test, który traktuje statystykę t jak rozkład normalny, jest zbyt liberalny. Luke (2017) pokazuje, że w lme4 najbliższy nominalnemu błąd I rodzaju dają REML i przybliżenie stopni swobody Kenwarda–Rogera lub Satterthwaite’a. McNeish (2017) zaleca przy małej liczbie grup REML z poprawką Kenwarda–Rogera. Sprawdziliśmy to w symulacji: 1000 badań bez efektu dla każdej liczby oddziałów, ICC = .06.
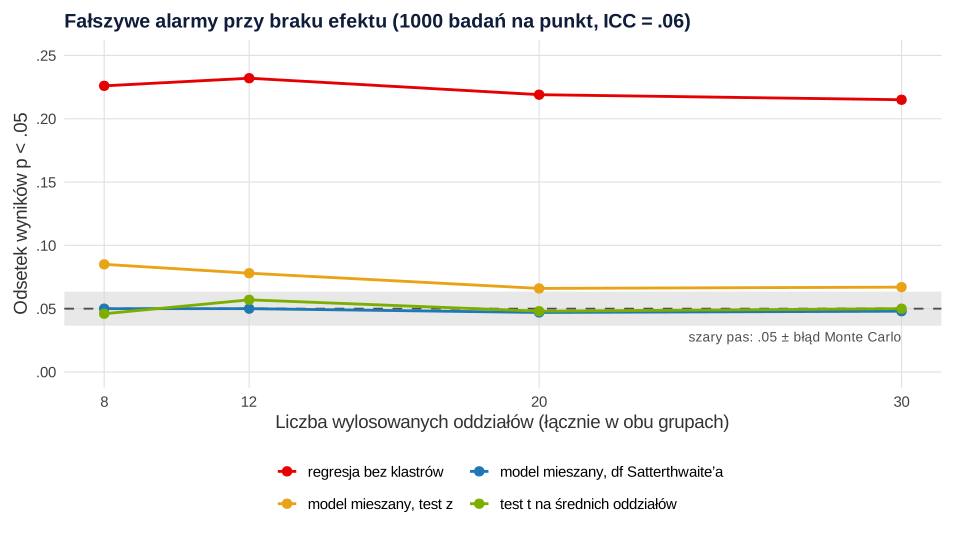
Regresja bez klastrów myliła się w 21.5–23.2% badań niezależnie od liczby oddziałów. Model mieszany z testem z dawał 8.5% fałszywych alarmów przy 8 oddziałach i 6.7% przy 30. Ten sam model ze stopniami swobody Satterthwaite’a oraz test t na średnich oddziałów trzymały się blisko 5%. Leyrat i in. (2018) w znacznie większej symulacji doszli do tego samego: przy 40 lub mniej klastrach analiza na poziomie klastrów, model mieszany z poprawką df i GEE z poprawką dla małych prób chronią przed błędem I rodzaju, a metody bez poprawek go zawyżają. Autorzy dodają, że przy mniej niż 20 klastrach moc bywa niska, więc poprawkę trzeba uwzględnić już w obliczeniu liczebności.
Praktyczna reguła: przy kilkunastu lub kilkudziesięciu klastrach raportuj model mieszany z poprawką Kenwarda–Rogera albo Satterthwaite’a, a analizę na średnich klastrów dodaj jako analizę wrażliwości. Jeśli wyniki się rozjeżdżają, zwykle winne są bardzo nierówne klastry albo pojedynczy nietypowy oddział.
Krok 4. Raport według CONSORT dla badań klastrowych
Rozszerzenie CONSORT dla badań z randomizacją klastrową (Campbell i in., 2004), zaktualizowane do wersji CONSORT 2010 (Campbell i in., 2012), dodaje do zwykłej listy kilka wymagań. Najważniejsze dla części statystycznej:
- oznacz badanie jako klastrowe w tytule lub abstrakcie i uzasadnij wybór schematu;
- w opisie liczebności podaj liczbę i wielkość klastrów oraz założony ICC z miarą jego niepewności;
- opisz, jak analiza uwzględnia klastry;
- pokaż przepływ klastrów i uczestników przez badanie (diagram) oraz liczbę analizowanych klastrów i osób w każdej grupie, z informacją, czy analiza była zgodna z zasadą ITT;
- dla każdego wyniku pierwszorzędowego podaj efekt z 95% CI i ICC.
Warto to robić starannie, bo recenzenci wciąż znajdują braki. W losowej próbie 300 badań klastrowych z lat 2000–2008 po publikacji rozszerzenia poprawiło się tylko 5 z 14 kryteriów raportowania i żadne z kryteriów metodologicznych (Ivers i in., 2011). Ogólne zasady opisu badań klinicznych zebraliśmy w tekście statystyka w publikacji medycznej.
Jeśli potrzebujesz kogoś, kto sprawdzi model dla Twojego schematu klastrowego albo przygotuje odpowiedź na uwagi recenzenta o zagnieżdżeniu danych, zajrzyj do oferty dla badaczy.
Analiza badania klastrowego w R: ICC, cztery analizy i symulacja
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Przepis 1 symuluje dane, liczy ICC z bootstrapem, efekt schematu i cztery analizy efektu programu. Przepis 2 to symulacja błędu I rodzaju przy małej liczbie oddziałów (ok. 1–2 minut). Modele mieszane liczy pakiet lme4 z lmerTest (stopnie swobody Satterthwaite’a i Kenwarda–Rogera przez pbkrtest), a odporny błąd klastrowy – clubSandwich.
1. ICC, efekt schematu i cztery analizy (tabela, rysunek 1)
R
# B154 – przepis 1: analiza badania z randomizacją klastrową (oddziały szpitalne)
# Wpis: /blog/randomizacja-klastrowa-badanie/
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R b154-1-analiza-oddzialy.R
# Projekt przykładowy (dane symulowane): 24 oddziały (12 zabiegowych, 12 zachowawczych) wylosowano
# w warstwach typu oddziału do programu komunikacji personelu z pacjentem albo do zwykłej opieki.
# Wynik pierwszorzędowy: lęk pacjenta w dniu wypisu (skala 0–21, wyższy wynik = większy lęk).
suppressPackageStartupMessages({library(lme4); library(lmerTest); library(clubSandwich)})

# 1. Symulacja danych ---------------------------------------------------------------
set.seed(15401)
K <- 24
oddzialy <- data.frame(oddzial = sprintf("O%02d", 1:K),
                       typ = rep(c("zabiegowy", "zachowawczy"), each = K / 2))
# randomizacja warstwowa: w każdej warstwie 6 oddziałów do programu, 6 do zwykłej opieki
oddzialy$program <- unlist(lapply(split(oddzialy, oddzialy$typ), function(w) sample(rep(0:1, each = 6))))
oddzialy$n <- round(runif(K, 12, 48))                 # nierówne liczebności oddziałów
oddzialy$u <- rnorm(K, 0, 1.0)                        # efekt losowy oddziału
dane <- oddzialy[rep(seq_len(K), oddzialy$n), c("oddzial", "typ", "program", "u")]
dane$wiek <- round(rnorm(nrow(dane), 62, 12))
lek <- 8.6 + 0.8 * (dane$typ == "zabiegowy") - 1.3 * dane$program + 0.03 * (dane$wiek - 62) +
  dane$u + rnorm(nrow(dane), 0, 3.9)
dane$lek <- pmin(pmax(round(lek), 0), 21)
dane$u <- NULL
dane$wiek_c <- dane$wiek - mean(dane$wiek)
write.csv(dane[, c("oddzial", "typ", "program", "wiek", "lek")], "../randomizacja-klastrowa-dane-oddzialy.csv", row.names = FALSE)

# 2. Opis: oddziały, pacjenci, nierówność klastrów -----------------------------------
c(oddzialy = K, pacjenci = nrow(dane))
table(oddzialy$typ, oddzialy$program)
tapply(oddzialy$n, oddzialy$program, sum)
n_k <- table(dane$oddzial)
c(min = min(n_k), max = max(n_k), srednia = round(mean(n_k), 1), CV = round(sd(n_k) / mean(n_k), 2))
round(sapply(split(dane$lek, dane$program), function(x) c(M = mean(x), SD = sd(x))), 2)

# 3. ICC z modelu pustego i jego niepewność (bootstrap parametryczny) ------------------
m0 <- lme4::lmer(lek ~ 1 + (1 | oddzial), data = dane)
icc_f <- function(m) { v <- as.data.frame(VarCorr(m))$vcov; v[1] / sum(v) }
icc <- icc_f(m0)
set.seed(15402)
bt <- bootMer(m0, icc_f, nsim = 500)
c(ICC = round(icc, 3), CI_dolna = round(quantile(bt$t, .025), 3), CI_gorna = round(quantile(bt$t, .975), 3))
m_sr <- mean(n_k); cv <- sd(n_k) / mean(n_k)
c(DE_rowne = round(1 + (m_sr - 1) * icc, 2),
  DE_cv = round(1 + ((cv^2 + 1) * m_sr - 1) * icc, 2),
  N_efektywne = round(nrow(dane) / (1 + ((cv^2 + 1) * m_sr - 1) * icc)))

# 4. Cztery analizy tego samego efektu ---------------------------------------------
wiersz <- function(nazwa, b, se, df) {
  data.frame(metoda = nazwa, b = b, SE = se, df = df, CI_dolna = b - qt(.975, df) * se,
             CI_gorna = b + qt(.975, df) * se, p = 2 * pt(-abs(b / se), df))
}
# a) błędna: regresja na pacjentach, jakby byli niezależni
a <- lm(lek ~ program + typ + wiek_c, data = dane)
wa <- wiersz("a) regresja bez klastrów", coef(a)["program"], sqrt(vcov(a)["program", "program"]), a$df.residual)
# b) analiza na poziomie oddziałów: średnie oddziałów (nieważone), warstwa jako kowarianta
sr <- aggregate(lek ~ oddzial + typ + program, data = dane, FUN = mean)
b <- lm(lek ~ program + typ, data = sr)
wb <- wiersz("b) średnie oddziałów", coef(b)["program"], sqrt(vcov(b)["program", "program"]), b$df.residual)
# c) model mieszany (REML) z losowym wyrazem wolnym oddziału, df Satterthwaite’a i Kenwarda–Rogera
m1 <- lmerTest::lmer(lek ~ program + typ + wiek_c + (1 | oddzial), data = dane)
s_sat <- summary(m1, ddf = "Satterthwaite")$coefficients["program", ]
s_kr <- summary(m1, ddf = "Kenward-Roger")$coefficients["program", ]
wc <- wiersz("c) model mieszany, Satterthwaite", s_sat["Estimate"], s_sat["Std. Error"], s_sat["df"])
wc2 <- wiersz("c) model mieszany, Kenward-Roger", s_kr["Estimate"], s_kr["Std. Error"], s_kr["df"])
# d) regresja z odpornym błędem klastrowym CR2 i stopniami swobody Bella–McCaffreya
d_cr <- coef_test(a, vcov = "CR2", cluster = dane$oddzial, test = "Satterthwaite")
dr <- d_cr[d_cr$Coef == "program", ]
wd <- wiersz("d) regresja, odporny błąd CR2", dr$beta, dr$SE, dr$df_Satt)
wyniki <- rbind(wa, wb, wc, wc2, wd); rownames(wyniki) <- NULL
wyniki[, -1] <- round(wyniki[, -1], 3)
print(wyniki, row.names = FALSE)

# 5. Wielkość efektu i składowe wariancji modelu mieszanego -------------------------
vc <- as.data.frame(VarCorr(m1))
c(var_oddzial = round(vc$vcov[1], 3), var_reszt = round(vc$vcov[2], 3),
  ICC_warunkowy = round(vc$vcov[1] / sum(vc$vcov), 3),
  d = round(s_kr["Estimate"] / sqrt(sum(vc$vcov)), 2),
  d_CI_dolna = round(wc2$CI_dolna / sqrt(sum(vc$vcov)), 2),
  d_CI_gorna = round(wc2$CI_gorna / sqrt(sum(vc$vcov)), 2))
saveRDS(list(dane = dane, sr = sr, wyniki = wyniki, icc = icc), "b154-1.rds")

# 6. Statystyka t (Kenward–Roger) i rozrzut średnich oddziałów (rysunek 1) ------------
round(s_kr, 3)
round(c(min_srednia_oddzialu = min(sr$lek), max_srednia_oddzialu = max(sr$lek)), 2)
round(tapply(sr$lek, sr$program, mean), 2)
Wynik w R
oddzialy pacjenci
      24      838

              0 1
  zabiegowy   6 6
  zachowawczy 6 6
  0   1
438 400
    min     max srednia      CV
  12.00   48.00   34.90    0.28
      0    1
M  9.22 7.65
SD 3.55 3.80
           ICC  CI_dolna.2.5% CI_gorna.97.5%
         0.101          0.042          0.169
   DE_rowne       DE_cv N_efektywne
       4.42        4.70      178.00
                           metoda      b    SE      df CI_dolna CI_gorna     p
         a) regresja bez klastrów -1.544 0.254 834.000   -2.042   -1.046 0.000
             b) średnie oddziałów -1.449 0.458  21.000   -2.402   -0.496 0.005
 c) model mieszany, Satterthwaite -1.488 0.453  20.260   -2.432   -0.543 0.004
 c) model mieszany, Kenward-Roger -1.488 0.454  20.631   -2.432   -0.543 0.004
    d) regresja, odporny błąd CR2 -1.544 0.447  19.431   -2.478   -0.610 0.003
  var_oddzial     var_reszt ICC_warunkowy    d.Estimate    d_CI_dolna    d_CI_gorna
        0.841        12.722         0.062        -0.400        -0.660        -0.150
  Estimate Std. Error         df    t value   Pr(>|t|)
    -1.488      0.454     20.631     -3.280      0.004
min_srednia_oddzialu max_srednia_oddzialu
                6.41                10.49
   0    1
9.23 7.78
2. Fałszywe alarmy przy małej liczbie oddziałów (rysunek 2)
R
# B154 – przepis 2: odsetek fałszywych alarmów przy małej liczbie oddziałów (rysunek 2)
# Wpis: /blog/randomizacja-klastrowa-badanie/
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R b154-2-symulacja-mala-liczba.R
# Brak efektu programu; ICC = .06; liczebność oddziału losowana z przedziału 10–40 pacjentów.
# Dla każdej liczby oddziałów (8, 12, 20, 30 łącznie) 1000 symulowanych badań i cztery analizy.
suppressPackageStartupMessages({library(lme4); library(lmerTest)})
sd_u <- 1; sd_e <- sqrt(15)                     # ICC = 1 / (1 + 15) = .0625
c(ICC = round(sd_u^2 / (sd_u^2 + sd_e^2), 4))
jedno_badanie <- function(K) {
  n <- round(runif(K, 10, 40))
  prog <- sample(rep(0:1, each = K / 2))
  odd <- rep(seq_len(K), n)
  y <- 9 + rnorm(K, 0, sd_u)[odd] + rnorm(sum(n), 0, sd_e)
  d <- data.frame(y = y, program = prog[odd], oddzial = factor(odd))
  p_naiw <- summary(lm(y ~ program, d))$coefficients["program", 4]
  m <- suppressMessages(lmerTest::lmer(y ~ program + (1 | oddzial), d))
  s <- summary(m, ddf = "Satterthwaite")$coefficients["program", ]
  p_z <- 2 * pnorm(-abs(s["t value"]))
  sr <- tapply(d$y, d$oddzial, mean)
  p_sr <- t.test(sr[prog == 1], sr[prog == 0], var.equal = TRUE)$p.value
  c(regresja_bez_klastrow = p_naiw, mieszany_z_normalny = unname(p_z),
    mieszany_Satterthwaite = unname(s["Pr(>|t|)"]), srednie_oddzialow = p_sr)
}
set.seed(15403)
R <- 1000
sym <- do.call(rbind, lapply(c(8, 12, 20, 30), function(K) {
  p <- t(replicate(R, jedno_badanie(K)))
  data.frame(K = K, metoda = colnames(p), alfa = colMeans(p < .05))
}))
sym$CI_MC <- round(1.96 * sqrt(sym$alfa * (1 - sym$alfa) / R), 3)   # błąd Monte Carlo
print(reshape(sym[, 1:3], idvar = "metoda", timevar = "K", direction = "wide"), row.names = FALSE)
saveRDS(sym, "b154-2.rds")
Wynik w R
   ICC
0.0625
                 metoda alfa.8 alfa.12 alfa.20 alfa.30
  regresja_bez_klastrow  0.226   0.232   0.219   0.215
    mieszany_z_normalny  0.085   0.078   0.066   0.067
 mieszany_Satterthwaite  0.050   0.050   0.047   0.048
      srednie_oddzialow  0.046   0.057   0.048   0.050
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- pbkrtest (wersja 0.5.5): Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models – The R package pbkrtest. Journal of Statistical Software, 59(9), 1–30. https://doi.org/10.18637/jss.v059.i09
- clubSandwich (wersja 0.7.0): Pustejovsky, J. E. (2026). clubSandwich: Cluster-robust (sandwich) variance estimators with small-sample corrections [R package]. https://doi.org/10.32614/CRAN.package.clubSandwich
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w badaniach klastrowych
- Analiza na pacjentach bez klastrów. Zawyża liczbę „istotnych” wyników nawet przy niewielkim ICC (rysunek 2).
- Test z w modelu mieszanym przy kilkunastu klastrach. Model jest dobry, ale wnioskowanie bez poprawki stopni swobody nadal jest zbyt liberalne.
- Raportowanie liczby pacjentów jako liczebności badania. W abstrakcie podaj liczbę klastrów i uczestników w każdej grupie.
- Rekrutacja po randomizacji przez osoby znające przydział. Takiego błędu selekcji nie naprawi żadna analiza (Puffer i in., 2003).
- Brak ICC w wynikach. Bez niego kolejny zespół nie zaplanuje liczebności, a czytelnik nie oceni Twojego planu.
- Pominięcie warstw randomizacji w modelu. Zmienne, według których losowano, powinny trafić do analizy.
- Wnioskowanie o pojedynczych pacjentach z różnic między oddziałami. Efekt dotyczy programu wdrożonego w oddziale. Pytania o mechanizm na poziomie pacjenta wymagają osobnych analiz, np. z predyktorami obu poziomów opisanymi w poradniku o modelu wielopoziomowym.
Jeśli przed dużym badaniem klastrowym planujesz mniejsze sprawdzenie rekrutacji oddziałów i retencji pacjentów, zajrzyj do wpisu o badaniu pilotażowym wykonalności.
Najczęstsze pytania
Jak analizować badanie z randomizacją klastrową?
Najczęściej liniowym modelem mieszanym z losowym wyrazem wolnym klastra i warstwami randomizacji jako efektami stałymi, z poprawką stopni swobody Kenwarda–Rogera lub Satterthwaite’a. Równoważne alternatywy to analiza na średnich klastrów i regresja z odpornym błędem klastrowym z poprawką dla małych prób. Nie analizuj uczestników tak, jakby byli niezależni.
Ile klastrów potrzeba w badaniu z randomizacją klastrową?
Zależy to od ICC, wielkości klastrów i efektu, który chcesz wykryć, więc liczbę klastrów wyznacza analiza mocy. Przy kilkunastu klastrach poprawne analizy chronią przed błędem I rodzaju, ale mają często niską moc (Leyrat i in., 2018). Jak policzyć liczbę klastrów do wniosku, pokazujemy w planie analiz do wniosku grantowego.
Czy w badaniu klastrowym trzeba podawać ICC?
Tak. Rozszerzenie CONSORT dla badań klastrowych zaleca podanie ICC dla każdego wyniku pierwszorzędowego, a w opisie liczebności także założonego ICC z miarą niepewności (Campbell i in., 2004). Zaznacz, czy ICC pochodzi z modelu pustego, czy z modelu z predyktorami, bo te wartości się różnią.
Co się stanie, gdy w badaniu klastrowym zignoruję klastry?
Oszacowanie efektu zwykle niewiele się zmienia, ale błąd standardowy jest za mały. W symulacji na tej stronie regresja bez klastrów dawała około 22% fałszywych alarmów zamiast 5%, już przy ICC = .06.
Czym różni się randomizacja klastrowa od randomizacji warstwowej?
W randomizacji klastrowej jednostką losowania jest grupa, np. oddział, i wszyscy jej członkowie dostają tę samą interwencję. Warstwowanie to sposób losowania: najpierw dzielisz jednostki na warstwy (np. typ oddziału), a potem losujesz w każdej osobno. Oba rozwiązania można łączyć, jak w przykładzie na tej stronie.
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikPlan analiz do wniosku grantowego
Hipotezy przypisane do modeli, symulacja mocy przy randomizacji klas, braki danych, analiza wrażliwości δ, tabela ryzyk i wzór tekstu do metodyki.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →Losujesz oddziały, szkoły albo przychodnie i nie wiesz, jak to policzyć?
Sprawdzimy model dla Twojego schematu klastrowego, policzymy ICC i analizy wrażliwości oraz wyjaśnimy wyniki tak, żebyś mógł je samodzielnie obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Aarts, E., Verhage, M., Veenvliet, J. V., Dolan, C. V., & van der Sluis, S. (2014). A solution to dependency: Using multilevel analysis to accommodate nested data. Nature Neuroscience, 17(4), 491–496. https://doi.org/10.1038/nn.3648
- Campbell, M. K., Elbourne, D. R., & Altman, D. G. (2004). CONSORT statement: Extension to cluster randomised trials. BMJ, 328(7441), 702–708. https://doi.org/10.1136/bmj.328.7441.702 ● Otwarty dostęp
- Campbell, M. K., Piaggio, G., Elbourne, D. R., Altman, D. G., & CONSORT Group. (2012). Consort 2010 statement: Extension to cluster randomised trials. BMJ, 345, Article e5661. https://doi.org/10.1136/bmj.e5661 ● Otwarty dostęp
- Eldridge, S. M., Ashby, D., & Kerry, S. (2006). Sample size for cluster randomized trials: Effect of coefficient of variation of cluster size and analysis method. International Journal of Epidemiology, 35(5), 1292–1300. https://doi.org/10.1093/ije/dyl129 ● Otwarty dostęp
- Ivers, N. M., Taljaard, M., Dixon, S., Bennett, C., McRae, A., Taleban, J., Skea, Z., Brehaut, J. C., Boruch, R. F., Eccles, M. P., Grimshaw, J. M., Weijer, C., Zwarenstein, M., & Donner, A. (2011). Impact of CONSORT extension for cluster randomised trials on quality of reporting and study methodology: Review of random sample of 300 trials, 2000-8. BMJ, 343, Article d5886. https://doi.org/10.1136/bmj.d5886 ● Otwarty dostęp
- Leyrat, C., Morgan, K. E., Leurent, B., & Kahan, B. C. (2018). Cluster randomized trials with a small number of clusters: Which analyses should be used? International Journal of Epidemiology, 47(1), 321–331. https://doi.org/10.1093/ije/dyx169
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
- McNeish, D. (2017). Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction. Multivariate Behavioral Research, 52(5), 661–670. https://doi.org/10.1080/00273171.2017.1344538
- Puffer, S., Torgerson, D., & Watson, J. (2003). Evidence for risk of bias in cluster randomised trials: Review of recent trials published in three general medical journals. BMJ, 327(7418), 785–789. https://doi.org/10.1136/bmj.327.7418.785 ● Otwarty dostęp
Cytowania BibTeX
@article{aarts2014solution, author={Aarts, Emmeke and Verhage, Matthijs and Veenvliet, Jesse V. and Dolan, Conor V. and van der Sluis, Sophie}, title={{A solution to dependency: Using multilevel analysis to accommodate nested data}}, journal={Nature Neuroscience}, year={2014}, volume={17}, number={4}, pages={491--496}, doi={10.1038/nn.3648}}@article{campbell2004consort, author={Campbell, Marion K. and Elbourne, Diana R. and Altman, Douglas G.}, title={{CONSORT statement: Extension to cluster randomised trials}}, journal={BMJ}, year={2004}, volume={328}, number={7441}, pages={702--708}, doi={10.1136/bmj.328.7441.702}}@article{campbell2012consort, author={Campbell, Marion K. and Piaggio, Gilda and Elbourne, Diana R. and Altman, Douglas G. and {CONSORT Group}}, title={{Consort 2010 statement: Extension to cluster randomised trials}}, journal={BMJ}, year={2012}, volume={345}, eid={e5661}, doi={10.1136/bmj.e5661}}@article{eldridge2006sample, author={Eldridge, Sandra M. and Ashby, Deborah and Kerry, Sally}, title={{Sample size for cluster randomized trials: Effect of coefficient of variation of cluster size and analysis method}}, journal={International Journal of Epidemiology}, year={2006}, volume={35}, number={5}, pages={1292--1300}, doi={10.1093/ije/dyl129}}@article{ivers2011impact, author={Ivers, Noah M. and Taljaard, Monica and Dixon, Stephanie and Bennett, Carol and McRae, Andrew and Taleban, Julia and Skea, Zoe and Brehaut, Jamie C. and Boruch, Robert F. and Eccles, Martin P. and Grimshaw, Jeremy M. and Weijer, Charles and Zwarenstein, Merrick and Donner, Allan}, title={{Impact of CONSORT extension for cluster randomised trials on quality of reporting and study methodology: Review of random sample of 300 trials, 2000-8}}, journal={BMJ}, year={2011}, volume={343}, eid={d5886}, doi={10.1136/bmj.d5886}}@article{leyrat2018cluster, author={Leyrat, Clémence and Morgan, Katy E. and Leurent, Baptiste and Kahan, Brennan C.}, title={{Cluster randomized trials with a small number of clusters: Which analyses should be used?}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={1}, pages={321--331}, doi={10.1093/ije/dyx169}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}@article{mcneish2017small, author={McNeish, Daniel}, title={{Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction}}, journal={Multivariate Behavioral Research}, year={2017}, volume={52}, number={5}, pages={661--670}, doi={10.1080/00273171.2017.1344538}}@article{puffer2003evidence, author={Puffer, Suezann and Torgerson, David and Watson, Judith}, title={{Evidence for risk of bias in cluster randomised trials: Review of recent trials published in three general medical journals}}, journal={BMJ}, year={2003}, volume={327}, number={7418}, pages={785--789}, doi={10.1136/bmj.327.7418.785}}