Co to jest błąd I i II rodzaju?
Test statystyczny kończy się decyzją: odrzucić hipotezę zerową albo nie. Ponieważ decyzję podejmujemy na podstawie próby, może być błędna na dwa sposoby:
- Błąd I rodzaju (ang. type I error, wynik fałszywie dodatni) – odrzucenie H0, która jest prawdziwa. Mówimy wtedy o efekcie, którego w populacji nie ma. Prawdopodobieństwo tego błędu to poziom istotności α.
- Błąd II rodzaju (ang. type II error, wynik fałszywie ujemny) – nieodrzucenie H0, która jest fałszywa. Przeoczamy efekt, który istnieje. Jego prawdopodobieństwo oznacza się β, a 1 − β to moc testu.
Tak definiują oba błędy m.in. Banerjee i in. (2009) oraz Kim (2015). Pojęcia te wywodzą się z podejścia Neymana i Pearsona (1933), w którym hipotezę zerową testuje się względem konkretnej alternatywy i kontroluje oba rodzaje pomyłek. Pamiętaj: w pojedynczym badaniu nie wiesz, czy popełniłeś błąd – α i β opisują, jak często myli się procedura w wielu badaniach.
Tabela decyzji: cztery możliwe wyniki testu
Zestawienie prawdy w populacji z decyzją testu daje cztery sytuacje. Liczby w nawiasach pochodzą z naszej symulacji: 10 000 badań, w których H0 była prawdziwa, i 10 000 badań, w których istniał efekt d = 0.5 (test t, dwie grupy po 64 osoby, α = .05).
| Decyzja testu | H0 prawdziwa (efektu nie ma) | H0 fałszywa (efekt istnieje) |
|---|---|---|
| Odrzucam H0 | Błąd I rodzaju – fałszywy alarm; prawdopodobieństwo α (506 z 10 000, czyli 5.1%) | Decyzja poprawna – wykrycie efektu; prawdopodobieństwo 1 − β, czyli moc (8 043 z 10 000, 80.4%) |
| Nie odrzucam H0 | Decyzja poprawna; prawdopodobieństwo 1 − α (9 494 z 10 000, 94.9%) | Błąd II rodzaju – przeoczenie efektu; prawdopodobieństwo β (1 957 z 10 000, 19.6%) |
Odsetki z symulacji są bliskie wartościom teoretycznym: α = .05 i β = .20 (moc .80). Zauważ, że prawdopodobieństwa sumują się w kolumnach, a nie w wierszach – α i β dotyczą dwóch różnych „światów”: takiego, w którym efektu nie ma, i takiego, w którym istnieje.
Analogie: sąd i badanie przesiewowe
Banerjee i in. (2009) objaśniają oba błędy na przykładzie procesu sądowego. Hipoteza zerowa to domniemanie niewinności. Błąd I rodzaju to skazanie niewinnego, a błąd II rodzaju – uniewinnienie winnego. Uniewinnienie z braku dowodów nie dowodzi niewinności – tak jak wynik nieistotny nie dowodzi braku efektu.
Druga analogia to kwestionariusz przesiewowy w kierunku depresji. Wynik fałszywie dodatni (osoba zdrowa zakwalifikowana do dalszej diagnozy) odpowiada błędowi I rodzaju, a fałszywie ujemny (przeoczona osoba z depresją) – błędowi II rodzaju. Podniesienie progu punktowego zmniejsza liczbę fałszywych alarmów, ale zwiększa liczbę przeoczeń – dokładnie tak jak obniżenie α. Ten sam kompromis opisują macierz pomyłek i krzywa ROC.
Skąd się biorą α i β? Dwa rozkłady statystyki testu
Rysunek 1 pokazuje rozkład statystyki t w dwóch „światach”: gdy H0 jest prawdziwa (szara krzywa wokół zera) i gdy istnieje efekt d = 0.5 przy 64 osobach w grupie (niebieska krzywa przesunięta w prawo). Pionowa linia to wartość krytyczna: wyniki poza nią prowadzą do odrzucenia H0.
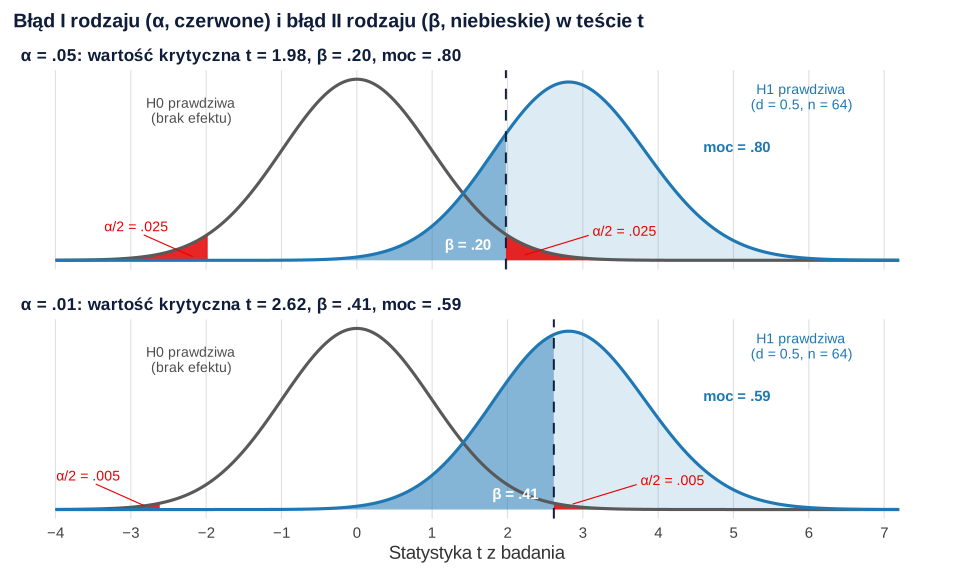
Czerwone pola leżą pod szarą krzywą: to szansa, że przy braku efektu statystyka przekroczy wartość krytyczną. Ciemnoniebieskie pole leży pod krzywą niebieską: to szansa, że mimo istniejącego efektu statystyka jej nie przekroczy. Przy α = .05 wartość krytyczna wynosi 1.98, a β = .20. Gdy zaostrzysz kryterium do α = .01, wartość krytyczna przesuwa się do 2.62, a β rośnie do .41 – moc spada z .80 do .59.
Kompromis między α a β
Przy stałej liczebności próby i wielkości efektu nie da się zmniejszyć obu błędów naraz: mniejsze α oznacza większe β. Kim (2015) podkreśla, że ze względu na tę zależność trzeba kontrolować oba błędy, przede wszystkim przez odpowiednią liczebność próby; w badaniach eksperymentalnych zwykle wymaga się mocy .80–.90. Przy α = .05 i efekcie d = 0.5 β wynosi .66 dla 20 osób w grupie, .20 dla 64 osób i .06 dla 100 osób. Ile osób potrzeba w Twoim badaniu, policzysz w analizie mocy a priori.
Popularna konwencja α = .05 i moc .80 (β = .20) oznacza, że ryzyko przeoczenia efektu akceptujemy na poziomie czterokrotnie wyższym niż ryzyko fałszywego alarmu. Nie zawsze jest to rozsądne. Który błąd jest groźniejszy, zależy od konsekwencji: uznanie nieskutecznej terapii za skuteczną (błąd I rodzaju) czy porzucenie skutecznej (błąd II rodzaju). Maier i Lakens (2022) pokazują, jak dobrać α tak, by zminimalizować albo zrównoważyć łączne ryzyko obu błędów.
Ryzyko błędu I rodzaju rośnie też wraz z liczbą testów: każdy kolejny test to nowa okazja do fałszywego alarmu – zob. korekta Bonferroniego i porównania wielokrotne. Z kolei test jednostronny zmniejsza β, ale tylko gdy kierunek efektu ustalono przed badaniem.
Jak pisać o błędach I i II rodzaju w pracy
W metodzie podaj α i moc zaplanowaną dla zakładanej wielkości efektu. W dyskusji odnieś się do błędu, który mógł wystąpić: przy wyniku nieistotnym – do błędu II rodzaju i mocy badania; przy wielu wynikach istotnych z wielu testów – do błędu I rodzaju.
Więcej o opisie wyników nieistotnych przeczytasz w haśle wartość p i w poradniku Jak opisać wyniki w pracy – gotowe zdania w stylu APA.
Przykład w R
Kod liczy wartość krytyczną i β dla α = .05 i α = .01, pokazuje, jak β maleje wraz z liczebnością grup, i odtwarza symulację z tabeli decyzji.
α, β i tabela decyzji z symulacji
R
# Plan: test t dla dwóch grup po 64 osoby, prawdziwy efekt d = 0.5 (gdy H1 jest prawdziwa)
bledy <- sapply(c(.05, .01), function(a) c(alfa = a, t_kr = qt(1 - a / 2, df = 126),
                                           beta = 1 - power.t.test(n = 64, delta = 0.5, sig.level = a)$power))
round(bledy, 4)
1 - sapply(c(20, 64, 100), function(n) power.t.test(n = n, delta = 0.5)$power)   # β a liczebność grupy

# Symulacja decyzji: 10 000 badań przy prawdziwej H0 i 10 000 przy prawdziwej H1 (α = .05)
set.seed(2026)
p_H0 <- replicate(10000, t.test(rnorm(64), rnorm(64), var.equal = TRUE)$p.value)
p_H1 <- replicate(10000, t.test(rnorm(64), rnorm(64, mean = 0.5), var.equal = TRUE)$p.value)
table(decyzja = ifelse(c(p_H0, p_H1) < .05, "odrzucam H0", "nie odrzucam H0"),
      rzeczywistosc = rep(c("H0 prawdziwa", "H1 prawdziwa"), each = 10000))
Wynik w R
       [,1]   [,2]
alfa 0.0500 0.0100
t_kr 1.9790 2.6154
beta 0.1985 0.4147
[1] 0.66229163 0.19854138 0.05957282
                 rzeczywistosc
decyzja           H0 prawdziwa H1 prawdziwa
  nie odrzucam H0         9494         1957
  odrzucam H0              506         8043
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „α to prawdopodobieństwo, że mój istotny wynik jest fałszywy” – α to prawdopodobieństwo odrzucenia H0, gdy jest ona prawdziwa. Odsetek fałszywych alarmów wśród wyników istotnych zależy dodatkowo od mocy i od tego, jak często badane hipotezy są prawdziwe (zob. skutki niskiej mocy).
- „β = 1 − α” – nie: β zależy od wielkości efektu, liczebności próby i α. W naszym przykładzie przy α = .05 β wynosi od .06 do .66 zależnie od liczebności.
- „Wynik nieistotny to błąd II rodzaju” – tylko wtedy, gdy efekt naprawdę istnieje. Tego nie wiesz; możesz jedynie ocenić moc badania i przedział ufności.
- Myślenie, że istotny wynik wyklucza pomyłkę – fałszywe alarmy zdarzają się z częstością α w każdej serii badań, w której H0 jest prawdziwa, a przy wielu testach stają się bardzo prawdopodobne.
Najczęstsze pytania
Co to jest błąd pierwszego rodzaju?
Błąd I rodzaju to odrzucenie hipotezy zerowej, która jest prawdziwa – czyli stwierdzenie efektu, którego w populacji nie ma (wynik fałszywie dodatni). Jego prawdopodobieństwo to poziom istotności α, najczęściej .05.
Co to jest błąd drugiego rodzaju?
Błąd II rodzaju to nieodrzucenie hipotezy zerowej, która jest fałszywa – czyli przeoczenie efektu, który istnieje (wynik fałszywie ujemny). Jego prawdopodobieństwo oznacza się β, a 1 − β to moc testu. Typowo planuje się β = .20, czyli moc .80.
Który błąd jest gorszy: I czy II rodzaju?
To zależy od konsekwencji. Uznanie nieskutecznej terapii za skuteczną (błąd I rodzaju) może narazić pacjentów, a porzucenie skutecznej (błąd II rodzaju) – pozbawić ich pomocy. Konwencja α = .05 i β = .20 traktuje fałszywy alarm jako czterokrotnie poważniejszy, ale w uzasadnionych przypadkach można przyjąć inne wartości.
Jak zmniejszyć błąd I i II rodzaju jednocześnie?
Przy stałej próbie się nie da – mniejsze α zwiększa β. Oba błędy zmniejsza dopiero większa liczebność próby, silniejszy efekt (np. mocniejsza manipulacja) albo mniej szumu w danych (rzetelniejsze narzędzia, plan wewnątrzobiektowy). Liczebność zaplanujesz w analizie mocy a priori.
Czy wynik nieistotny oznacza błąd II rodzaju?
Nie musi. Błąd II rodzaju występuje tylko wtedy, gdy efekt naprawdę istnieje, a tego w pojedynczym badaniu nie wiesz. Możesz ocenić moc badania dla rozsądnej wielkości efektu i przedział ufności – jeśli moc była niska, wynik nieistotny niewiele mówi.
Czym różni się błąd I rodzaju od poziomu istotności?
Błąd I rodzaju to rodzaj pomyłki (odrzucenie prawdziwej H0), a poziom istotności α to ustalone przed badaniem maksymalne prawdopodobieństwo tej pomyłki. Przy α = .05 procedura daje fałszywy alarm w około 5% badań, w których H0 jest prawdziwa.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikWartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Banerjee, A., Chitnis, U. B., Jadhav, S. L., Bhawalkar, J. S., & Chaudhury, S. (2009). Hypothesis testing, type I and type II errors. Industrial Psychiatry Journal, 18(2), 127–131. https://doi.org/10.4103/0972-6748.62274 ● Otwarty dostęp
- Kim, H.-Y. (2015). Statistical notes for clinical researchers: Type I and type II errors in statistical decision. Restorative Dentistry & Endodontics, 40(3), 249–252. https://doi.org/10.5395/rde.2015.40.3.249 ● Otwarty dostęp
- Maier, M., & Lakens, D. (2022). Justify your alpha: A primer on two practical approaches. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221080396. https://doi.org/10.1177/25152459221080396 ● Otwarty dostęp
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009 ● Otwarty dostęp
Cytowania BibTeX
@article{banerjee2009hypothesis, author={Banerjee, Amitav and Chitnis, U. B. and Jadhav, S. L. and Bhawalkar, J. S. and Chaudhury, S.}, title={{Hypothesis testing, type I and type II errors}}, journal={Industrial Psychiatry Journal}, year={2009}, volume={18}, number={2}, pages={127--131}, doi={10.4103/0972-6748.62274}}@article{kim2015type, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Type I and type II errors in statistical decision}}, journal={Restorative Dentistry \& Endodontics}, year={2015}, volume={40}, number={3}, pages={249--252}, doi={10.5395/rde.2015.40.3.249}}@article{maier2022justify, author={Maier, Maximilian and Lakens, Daniël}, title={{Justify your alpha: A primer on two practical approaches}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221080396}, doi={10.1177/25152459221080396}}@article{neyman1933problem, author={Neyman, Jerzy and Pearson, Egon S.}, title={{On the problem of the most efficient tests of statistical hypotheses}}, journal={Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character}, year={1933}, volume={231}, number={694–706}, pages={289--337}, doi={10.1098/rsta.1933.0009}}