Co to jest test t Studenta?
Test t Studenta (ang. Student's t-test) to rodzina testów parametrycznych, które sprawdzają, czy różnica między średnimi jest większa, niż można by się spodziewać po samej przypadkowej zmienności próby. W psychologii to najczęściej używany test w pracach dyplomowych: porównuje się nim grupę eksperymentalną z kontrolną, kobiety z mężczyznami albo wyniki przed interwencją i po niej.
Wszystkie warianty opierają się na tej samej idei. Statystyka t to obserwowana różnica podzielona przez jej błąd standardowy. Gdy prawdziwa jest hipoteza zerowa, ma ona rozkład t z określoną liczbą stopni swobody. Rozkładu t używa się zamiast normalnego, bo wariancji w populacji nie znamy i szacujemy ją z próby (Kim, 2015).
Nazwa pochodzi od pseudonimu „Student”, pod którym William S. Gosset, chemik browaru Guinnessa, opublikował klasyczny artykuł o błędzie średniej z małych prób (Student, 1908).
Trzy warianty testu t – który wybrać?
Wariant testu wynika z planu badania, a nie z wyglądu danych. Odpowiedz na dwa pytania: z czym porównujesz średnią i czy oba wyniki pochodzą od tych samych osób.
| Pytanie badawcze | Wariant testu | Przykład | Stopnie swobody | Alternatywa nieparametryczna |
|---|---|---|---|---|
| Czy średnia różni się od znanej wartości? | Test t dla jednej próby | średnia skali Likerta a punkt środkowy 3 | n − 1 | test Wilcoxona dla jednej próby |
| Czy średnie dwóch różnych grup osób się różnią? | Test t dla prób niezależnych, domyślnie w wersji Welcha | grupa eksperymentalna a kontrolna | Student: n1 + n2 − 2; Welch: wartość ułamkowa | test U Manna–Whitneya |
| Czy średnie dwóch pomiarów tych samych osób się różnią? | Test t dla prób zależnych | lęk przed kursem i po kursie | liczba par − 1 | test Wilcoxona dla par (znakowanych rang) |
Próby są zależne nie tylko wtedy, gdy te same osoby zbadano dwa razy. Zależne są też pary dobrane celowo: bliźnięta, partnerzy w związku czy osoby dopasowane pod względem wieku i płci. Jeśli porównujesz trzy grupy lub więcej, nie wykonuj serii testów t – użyj analizy wariancji (zob. ANOVA krok po kroku), bo z każdym kolejnym porównaniem rośnie ryzyko błędu I rodzaju.
Wzór ogólny i błędy standardowe
Licznik mówi, jak duży jest efekt, a mianownik – jak dokładnie go zmierzono. Duża wartość t oznacza, że różnica wyraźnie przewyższa typowy „szum” wynikający z losowania próby. Warianty różnią się tylko tym, jak liczy się błąd standardowy i stopnie swobody:
| Wariant | Błąd standardowy różnicy | Stopnie swobody |
|---|---|---|
| Jedna próba | SE = SD / √n | n − 1 |
| Próby niezależne – Student | SE = SDłączone × √(1/n1 + 1/n2) | n1 + n2 − 2 |
| Próby niezależne – Welch | SE = √(SD1²/n1 + SD2²/n2) | wzór Welcha–Satterthwaite’a (zwykle ułamkowe) |
| Próby zależne | SE = SDróżnic / √n | n − 1 (n = liczba par) |
Rozkład t a rozkład normalny
Rozkład t jest symetryczny i dzwonowaty jak rozkład normalny, ale ma grubsze ogony. Odzwierciedla to dodatkową niepewność: odchylenie standardowe w mianowniku też jest szacowane z próby, więc w małych próbach skrajne wartości t zdarzają się częściej. Im więcej stopni swobody, tym bardziej rozkład t przypomina normalny (rysunek 1).
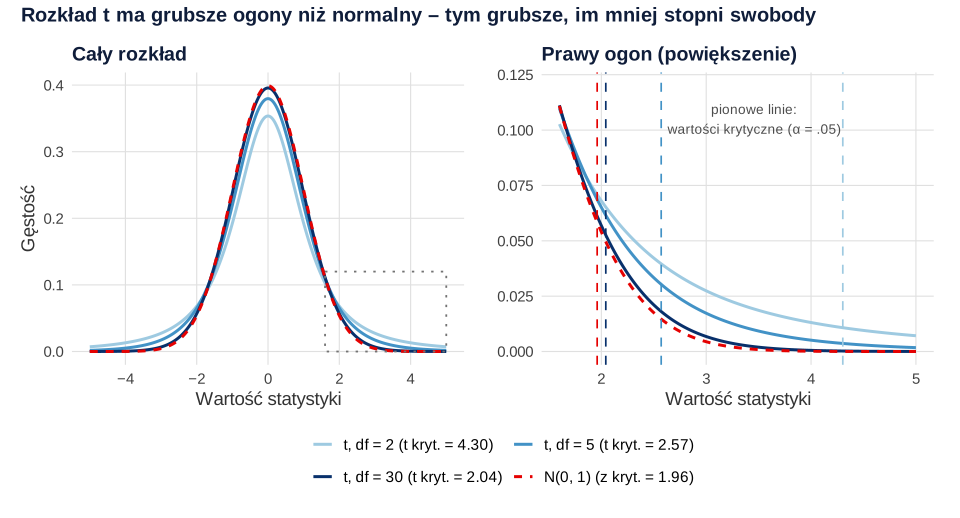
Konsekwencja praktyczna: wartość krytyczna dla α = .05 (test dwustronny) wynosi 4.30 przy 2 stopniach swobody, 2.57 przy 5, 2.04 przy 30 i 1.98 przy 100 – a nie 1.96 jak w rozkładzie normalnym. Gdyby przy 5 stopniach swobody użyć progu 1.96, odsetek fałszywych alarmów wyniósłby 10.7% zamiast 5%, a przy 2 stopniach swobody – 18.9%. Programy statystyczne liczą wartość p z właściwego rozkładu t automatycznie.
Założenia testu t
Kim (2015) wymienia trzy klasyczne założenia testu t: normalność, równość wariancji i niezależność obserwacji. W praktyce warto je rozumieć tak:
- Niezależność obserwacji – wynik jednej osoby nie wpływa na wynik innej (w teście dla prób zależnych niezależne mają być pary). To założenie wynika z planu badania i żaden test go nie „naprawi”.
- Zmienna ilościowa – mierzona co najmniej na skali przedziałowej; w praktyce także sumy i średnie z wielopozycyjnych skal Likerta.
- Rozkład zbliżony do normalnego – w grupach, a w teście dla prób zależnych: rozkład różnic. Lumley i in. (2002) pokazują, że w dużych próbach test t pozostaje trafny także przy rozkładach wyraźnie odbiegających od normalnego. W małych próbach groźne są silna skośność i obserwacje odstające; oceniaj je na wykresie Q-Q, a nie wyłącznie testem Shapiro–Wilka.
- Równość wariancji – wymaga jej tylko klasyczny test Studenta dla prób niezależnych. Delacre i in. (2017) zwracają uwagę, że w psychologii założenie to rzadko jest spełnione, a wybór testu na podstawie wstępnego testu równości wariancji często zawodzi – dlatego domyślnie używaj testu Welcha.
Kiedy zamiast testu t wybrać test nieparametryczny?
Testy nieparametryczne – U Manna–Whitneya dla grup niezależnych i Wilcoxona dla par – pracują na rangach, więc pojedyncze skrajne wyniki mają na nie mały wpływ. Rozważ je, gdy:
- próba jest mała, a rozkład (lub rozkład różnic) wyraźnie skośny albo z obserwacjami odstającymi;
- zmienna jest porządkowa, np. pojedyncze pytanie z odpowiedziami od „nigdy” do „zawsze”;
- pytanie badawcze dotyczy tego, czy wyniki jednej grupy są zwykle wyższe, a nie różnicy średnich.
Pamiętaj jednak, że test nieparametryczny nie jest zapasową wersją testu t, lecz testem innej hipotezy. Fagerland (2012) pokazał w symulacjach, że przy dużych próbach i skośnych rozkładach test Wilcoxona–Manna–Whitneya daje znacznie mniejsze wartości p niż test t nawet wtedy, gdy średnie i mediany grup są równe, a grupy różnią się tylko nieco rozproszeniem. Zamiana testu t na test rangowy „bo rozkład nie jest normalny” bywa więc w dużych próbach błędem. Wybieraj test według pytania badawczego.
Przykład: ten sam zbiór danych, dwa różne testy
Dwanaście osób wykonało zadanie Stroopa: nazywało kolor czcionki, którą napisano nazwę tego samego koloru (warunek zgodny) albo innego koloru (warunek niezgodny). Średni czas reakcji wyniósł 636.67 ms (SD = 100.40) w warunku zgodnym i 697.17 ms (SD = 106.75) w niezgodnym (dane symulowane). Każda osoba wykonała oba warunki, więc właściwy jest test dla prób zależnych. Porównaj dwie analizy tych samych liczb:
- poprawnie – test dla prób zależnych: średnia różnica 60.50 ms, t(11) = 6.96, p < .001, 95% CI [41.36, 79.64];
- błędnie – test dla grup niezależnych (Welch): t(21.92) = 1.43, p = .167, 95% CI [−27.25, 148.25].
Różnica średnich jest w obu analizach identyczna. Test dla grup niezależnych traktuje jednak duże różnice w tempie między osobami (SD ≈ 100 ms) jako szum. Test dla prób zależnych analizuje zmianę w obrębie osoby, a ta jest bardzo spójna: SD różnic wynosi 30.13 ms, a korelacja pomiarów r = .96. Dlatego schematy wewnątrzosobowe wymagają mniejszych prób. Brysbaert (2019) szacuje, że przy efekcie d = 0.4 porównanie dwóch warunków wewnątrzobiektowych z mocą 80% wymaga ponad 50 osób, a porównania międzygrupowe – znacznie więcej (zob. moc testu).
Jak opisać wynik testu t w pracy (APA)
Niezależnie od wariantu opis zawiera te same elementy: statystyki opisowe (M, SD), nazwę testu, t ze stopniami swobody w nawiasie, dokładne p oraz wielkość efektu z przedziałem ufności. Ogólny szablon:
Przykład dla zadania Stroopa:
W Wordzie zapisz „z” przy d w indeksie dolnym (dz to d liczone z odchylenia standardowego różnic). Wzory dla każdego wariantu znajdziesz na stronach poszczególnych testów, gotowe tabele – w haśle tabela testu t w APA, a interpretację d – w haśle d Cohena.
Przykład w R i SPSS
Kod liczy wartości krytyczne rozkładu t i analizuje dane z zadania Stroopa dwoma testami – właściwym i błędnym. Liczby w tekście pochodzą z tego kodu.
Wartości krytyczne i dwa warianty testu t
R
# Wartości krytyczne t (dwustronnie, α = .05) – im mniej df, tym dalej od 1.96
round(qt(0.975, df = c(2, 5, 30, 100)), 3)
round(qnorm(0.975), 3)

# Efekt Stroopa: te same 12 osób w warunku zgodnym i niezgodnym (czas reakcji, ms)
set.seed(33)
tempo <- rnorm(12, 0, 110)                      # stałe różnice w tempie między osobami
zgodny <- round(640 + tempo + rnorm(12, 0, 25))
niezgodny <- round(700 + tempo + rnorm(12, 0, 25))
t.test(niezgodny, zgodny, paired = TRUE)        # poprawnie: test t dla prób zależnych
t.test(niezgodny, zgodny)                       # błędnie: jak dla grup niezależnych (Welch)
effectsize::repeated_measures_d(niezgodny, zgodny, method = "z", adjust = FALSE)   # d_z
Wynik w R
[1] 4.303 2.571 2.042 1.984
[1] 1.96

	Paired t-test

data:  niezgodny and zgodny
t = 6.9568, df = 11, p-value = 2.401e-05
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 41.35917 79.64083
sample estimates:
mean difference
           60.5


	Welch Two Sample t-test

data:  niezgodny and zgodny
t = 1.4301, df = 21.918, p-value = 0.1668
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -27.25468 148.25468
sample estimates:
mean of x mean of y
 697.1667  636.6667

d (z) |       95% CI
--------------------
2.01  | [1.03, 2.99]
SPSS: gdzie znaleźć test t
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Test dla grup niezależnych zamiast dla prób zależnych – jak w przykładzie: ta sama różnica średnich, a wynik z p < .001 zamienia się w nieistotny.
- Seria testów t zamiast ANOVA – przy trzech grupach trzy porównania parami bez korekty zawyżają ryzyko fałszywego alarmu (zob. korekta Bonferroniego).
- Klasyczny test Studenta przy nierównych wariancjach i liczebnościach – wybierz test Welcha od początku, zamiast uzależniać decyzję od testu Levene’a.
- Automatyczne przejście na test nieparametryczny po istotnym teście Shapiro–Wilka w dużej próbie – zmienia to testowaną hipotezę, a nie „naprawia” analizy (Fagerland, 2012).
- Test jednostronny wybrany po obejrzeniu danych – kierunek hipotezy zapisuje się przed badaniem (zob. test jednostronny i dwustronny).
- Sama wartość p bez wielkości efektu – nawet bardzo mała różnica będzie istotna w dużej próbie; podawaj d z 95% CI.
Najczęstsze pytania
Kiedy stosować test t Studenta?
Gdy porównujesz średnie zmiennej ilościowej w dokładnie dwóch warunkach: średnią próby z wartością odniesienia, dwie niezależne grupy albo dwa pomiary tych samych osób. Przy trzech i więcej grupach albo pomiarach użyj analizy wariancji (ANOVA), a nie serii testów t.
Jaki test t wybrać: dla prób niezależnych czy zależnych?
Zdecyduj na podstawie planu badania. Jeśli w grupach są różne osoby, wybierz test dla prób niezależnych. Jeśli te same osoby zbadano dwa razy albo pary dobrano celowo (np. bliźnięta), wybierz test dla prób zależnych – zwykle ma on wyraźnie większą moc.
Czym różni się test t Studenta od testu Welcha?
Klasyczny test Studenta dla prób niezależnych zakłada równe wariancje w obu grupach, a test Welcha – nie, dlatego jego stopnie swobody są zwykle ułamkowe. Test Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci przy równych, więc zaleca się go jako wybór domyślny (Delacre i in., 2017).
Co zrobić, gdy rozkład nie jest normalny?
Przy większych próbach test t jest odporny na odstępstwa od normalności (Lumley i in., 2002). W małych próbach z silną skośnością lub obserwacjami odstającymi rozważ test U Manna–Whitneya albo test Wilcoxona, pamiętając, że testują one inną hipotezę niż test t (Fagerland, 2012).
Jak zapisać wynik testu t w APA?
Podaj średnie i odchylenia standardowe, a potem t ze stopniami swobody w nawiasie, dokładne p i wielkość efektu z przedziałem ufności, np. t(11) = 6.96, p < .001, dz = 2.01, 95% CI [1.03, 2.99]. Wartości p poniżej .001 zapisz jako p < .001.
Skąd nazwa „test t Studenta”?
„Student” to pseudonim Williama S. Gosseta, który pracował w browarze Guinnessa i w 1908 roku opublikował klasyczny artykuł o błędzie średniej z małych prób (Student, 1908). Z tej pracy wywodzi się rozkład t i oparty na nim test.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies—a paradox of statistical practice? BMC Medical Research Methodology, 12(1), Article 78. https://doi.org/10.1186/1471-2288-12-78 ● Otwarty dostęp
- Kim, T. K. (2015). T test as a parametric statistic. Korean Journal of Anesthesiology, 68(6), 540–546. https://doi.org/10.4097/kjae.2015.68.6.540 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
Cytowania BibTeX
@article{brysbaert2019how, author={Brysbaert, Marc}, title={{How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{fagerland2012ttests, author={Fagerland, Morten W.}, title={{t-tests, non-parametric tests, and large studies—a paradox of statistical practice?}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={78}, doi={10.1186/1471-2288-12-78}}@article{kim2015ttest, author={Kim, Tae Kyun}, title={{T test as a parametric statistic}}, journal={Korean Journal of Anesthesiology}, year={2015}, volume={68}, number={6}, pages={540--546}, doi={10.4097/kjae.2015.68.6.540}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{student1908probable, author={{Student}}, title={{The probable error of a mean}}, journal={Biometrika}, year={1908}, volume={6}, number={1}, pages={1--25}, doi={10.1093/biomet/6.1.1}}