Co to jest test t dla prób zależnych?
Test t dla prób zależnych (ang. paired samples t-test) sprawdza, czy różnią się średnie dwóch powiązanych pomiarów. Najczęściej są to dwa pomiary tych samych osób: przed interwencją i po niej, w dwóch warunkach eksperymentu albo dwie oceny wystawione przez tę samą osobę. Zależne są też pary dobrane celowo – bliźnięta, partnerzy w związku czy osoby dopasowane pod względem wieku i płci. Zmienna, która rozróżnia pomiary, to czynnik wewnątrzobiektowy.
Kim (2015) opisuje ten test – obok testu dla prób niezależnych – jako jeden z dwóch podstawowych wariantów porównania średnich. Kluczowa różnica: tutaj analizuje się zmianę w obrębie osoby, więc stałe różnice między ludźmi (jedni zawsze mają wyższy lęk, inni niższy) nie powiększają błędu. Dlatego schematy wewnątrzosobowe zwykle mają większą moc niż międzygrupowe (Lakens, 2013).
Wzór: test t na różnicach
Dla każdej osoby liczysz różnicę di = pomiar 1 − pomiar 2. Potem wykonujesz test t dla jednej próby na różnicach, z wartością odniesienia 0:
- Mróżnic – średnia różnica (równa różnicy średnich obu pomiarów),
- SDróżnic – odchylenie standardowe różnic,
- n – liczba par.
Odchylenie standardowe różnic zależy od korelacji między pomiarami: SDróżnic² = SD1² + SD2² − 2r × SD1 × SD2. Im silniej pomiary są skorelowane, tym mniejsze SD różnic i tym większe t przy tej samej różnicy średnich.
Przykład: lęk przed wystąpieniami przed kursem i po nim
Trzydzieści osób wypełniło skalę lęku przed wystąpieniami publicznymi (10–50 punktów) przed sześciotygodniowym kursem wystąpień i po jego zakończeniu (dane symulowane).
| Pomiar | M | SD | 95% CI |
|---|---|---|---|
| Przed kursem | 31.53 | 7.94 | [28.57, 34.50] |
| Po kursie | 28.03 | 8.50 | [24.86, 31.21] |
| Różnica (przed − po) | 3.50 | 5.63 | [1.40, 5.60] |
- Różnice: lęk spadł u 20 osób, u 2 się nie zmienił, a u 8 wzrósł. Korelacja pomiarów wynosi r = .77.
- Błąd standardowy średniej różnicy: SE = 5.63 / √30 = 1.03.
- Statystyka testowa: t = 3.50 / 1.03 = 3.40, df = 29, p = .002.
- Przedział ufności: 95% CI średniej różnicy [1.40, 5.60] nie obejmuje zera.
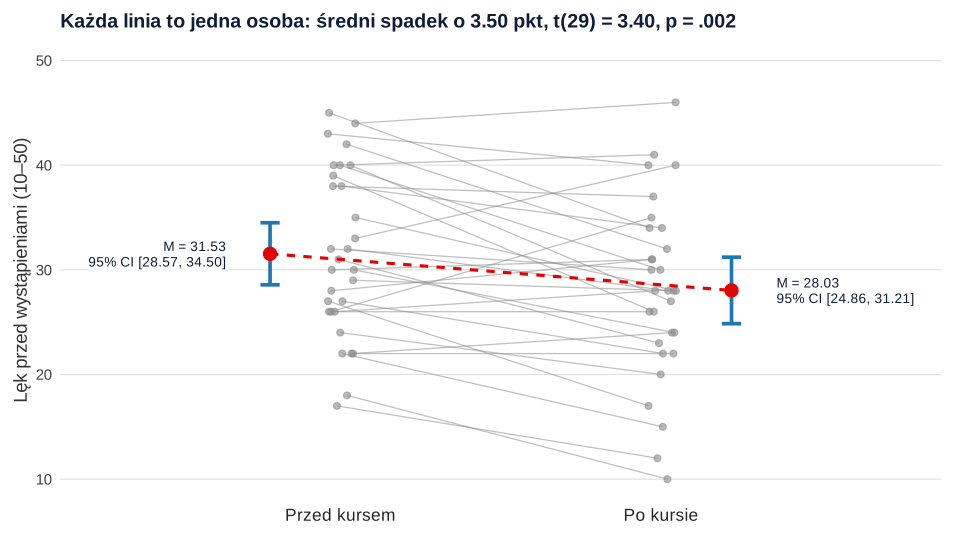
Na rysunku 1 widać, że spadek nie dotyczy wszystkich – część linii biegnie w górę. Średnia zmiana jest niewielka w porównaniu z różnicami między osobami, ale większość osób zachowuje swoją pozycję względem innych (wysoka korelacja pomiarów), więc test dla prób zależnych wyraźnie ją wykrywa. Gdyby błędnie potraktować oba pomiary jak niezależne grupy, wynik byłby nieistotny: t(57.73) = 1.65, p = .105.
Założenia: normalność różnic, nie wyników
- Pary są niezależne od siebie – wynik jednej osoby nie wpływa na wyniki innych.
- Zmienna ilościowa mierzona tak samo w obu pomiarach (ta sama skala i wersja narzędzia).
- Rozkład różnic zbliżony do normalnego – założenie dotyczy różnic, a nie każdego pomiaru osobno. Surowe wyniki mogą być skośne, a różnice symetryczne, i odwrotnie.
Równości wariancji obu pomiarów test nie wymaga. Normalność różnic oceniaj przede wszystkim wzrokowo, na histogramie lub wykresie Q-Q (rysunek 2). Kim (2012) przestrzega jednak, że w małych próbach nawet dane z populacji normalnej rzadko wyglądają „normalnie”, a formalne testy normalności bywają zawodne w bardzo dużych próbach. W przykładzie test Shapiro–Wilka nie wskazał odstępstwa od normalności różnic (W = .98, p = .706).
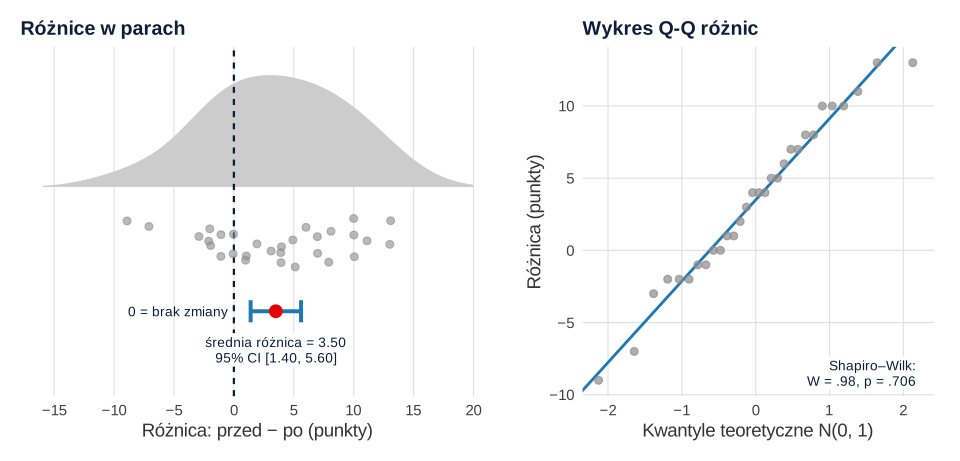
Gdy różnice są wyraźnie skośne albo zawierają skrajne wartości, a próba jest mała, wybierz test Wilcoxona dla par.
Wielkość efektu: dz czy dav?
W schemacie wewnątrzosobowym d Cohena można policzyć na kilka sposobów, które dają wyraźnie różne liczby. Lakens (2013) opisuje między innymi te dwa:
dz standaryzuje zmianę odchyleniem standardowym różnic, więc rośnie wraz z korelacją pomiarów i mówi, jak spójna jest zmiana w obrębie osób. Tę wartość podaje się jako dane wejściowe w analizie mocy dla prób zależnych, np. w G*Power (zob. analiza mocy a priori). dav dzieli zmianę przez średnie odchylenie standardowe obu pomiarów i pomija korelację, dzięki czemu łatwiej porównać je z d z badań międzygrupowych. Lakens (2013) zaleca w raportach przede wszystkim dav albo drm (wersję uwzględniającą korelację między pomiarami), a do metaanaliz – gav z poprawką na małą próbę.
W przykładzie dz = 0.62, 95% CI [0.23, 1.01], a dav = 0.43, 95% CI [0.18, 0.67] (gav = 0.41). Ta sama zmiana wygląda więc na „średnią” albo „małą do średniej” zależnie od wzoru, dlatego zawsze napisz, którą wersję d podajesz. SPSS (od wersji 27) w tabeli wielkości efektu dla prób zależnych liczy d Cohena z odchylenia standardowego różnic, czyli dz. Interpretację wartości d opisujemy w haśle d Cohena.
Badanie przed–po bez grupy kontrolnej – ostrożnie z wnioskami
Test pokazał, że lęk po kursie był niższy niż przed nim. Nie pokazał natomiast, że obniżył go kurs. W schemacie „jedna grupa, pomiar przed i po” zmianę mogą wyjaśniać także upływ czasu, inne wydarzenia między pomiarami, oswojenie się z kwestionariuszem i regresja do średniej – zwłaszcza gdy na kurs zgłaszają się osoby z najwyższym lękiem. To zagrożenia trafności wewnętrznej; plany, które pozwalają je ograniczyć, omawia klasyczny podręcznik planów eksperymentalnych i quasi-eksperymentalnych (Shadish i in., 2002; zob. też schemat quasi-eksperymentalny).
Jeśli masz grupę kontrolną, porównaj zmianę między grupami: testem t dla prób niezależnych na różnicach albo analizą kowariancji z pomiarem wyjściowym jako kowariantem (ANCOVA). Vickers i Altman (2001) pokazują, że to, które z prostych podejść ma większą moc, zależy od korelacji między pomiarem wyjściowym a końcowym. Przy więcej niż dwóch pomiarach użyj ANOVA z powtarzanymi pomiarami.
Jak opisać wynik w pracy (APA)
W Wordzie zapisz „av” i „z” w indeksie dolnym. Podaj też korelację między pomiarami (r = .77) – pozwala ona innym przeliczyć wielkość efektu na inną wersję d. Wzór tabeli dla prób zależnych znajdziesz w haśle tabela testu t w APA.
Przykład w R i SPSS
Kod generuje dane z przykładu, sprawdza normalność różnic, wykonuje test t dla prób zależnych i liczy dwie wersje d z przedziałami ufności. Liczby w tekście pochodzą z tego kodu.
Test t dla prób zależnych, dz i dav
R
library(MASS); library(effectsize)
S <- matrix(c(49, .72 * 7 * 7.5, .72 * 7 * 7.5, 56.25), 2)   # SD 7 i 7.5, r = .72 w populacji
set.seed(2013)
X <- mvrnorm(30, mu = c(33, 30), Sigma = S)
przed <- pmin(50, pmax(10, round(X[, 1])))                    # lęk przed wystąpieniami (10–50)
po <- pmin(50, pmax(10, round(X[, 2])))
roznica <- przed - po                                         # dodatnia = spadek lęku
round(c(M_przed = mean(przed), M_po = mean(po), r = cor(przed, po),
        M_roznicy = mean(roznica), SD_roznicy = sd(roznica)), 2)
shapiro.test(roznica)                                         # normalność RÓŻNIC
t.test(przed, po, paired = TRUE)
repeated_measures_d(przed, po, method = "z", adjust = FALSE)  # d_z
repeated_measures_d(przed, po, method = "av", adjust = FALSE) # d_av
Wynik w R
   M_przed       M_po          r  M_roznicy SD_roznicy
     31.53      28.03       0.77       3.50       5.63

	Shapiro-Wilk normality test

data:  roznica
W = 0.97579, p-value = 0.706


	Paired t-test

data:  przed and po
t = 3.4045, df = 29, p-value = 0.001957
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 1.397392 5.602608
sample estimates:
mean difference
            3.5

d (z) |       95% CI
--------------------
0.62  | [0.23, 1.01]
d (av) |       95% CI
---------------------
0.43   | [0.18, 0.67]
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, ggdist i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2024). ggdist: Visualizations of distributions and uncertainty in the grammar of graphics. IEEE Transactions on Visualization and Computer Graphics, 30(1), 414–424. https://doi.org/10.1109/TVCG.2023.3327195
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Analiza zależnych pomiarów jak grup niezależnych – w przykładzie p = .105 zamiast .002 (zob. też przykład w haśle test t Studenta).
- Sprawdzanie normalności każdego pomiaru osobno zamiast rozkładu różnic.
- Wniosek przyczynowy z badania przed–po bez grupy kontrolnej – spadek wyniku nie dowodzi skuteczności interwencji.
- Niepodanie wersji d – dz i dav mogą się wyraźnie różnić (tu 0.62 i 0.43).
- Pominięcie osób bez drugiego pomiaru bez komentarza – opisz, ile osób odpadło i czy różniły się w pierwszym pomiarze.
- Seria testów t przy trzech i więcej pomiarach – użyj ANOVA z powtarzanymi pomiarami albo modelu mieszanego.
Najczęstsze pytania
Kiedy stosować test t dla prób zależnych?
Gdy porównujesz średnie dwóch pomiarów tych samych osób (np. przed i po interwencji, w dwóch warunkach eksperymentu) albo dobranych par, takich jak bliźnięta. Jeśli w grupach są różne osoby, użyj testu dla prób niezależnych, a przy trzech i więcej pomiarach – ANOVA z powtarzanymi pomiarami.
Czy w teście t dla prób zależnych trzeba sprawdzać normalność?
Tak, ale rozkładu różnic między pomiarami, a nie każdego pomiaru osobno. Najlepiej oceń go na histogramie lub wykresie Q-Q różnic; test Shapiro–Wilka traktuj pomocniczo, bo w małych próbach ma niską moc, a w bardzo dużych wykrywa nieistotne odstępstwa.
Czym różni się d_z od d_av w teście t dla prób zależnych?
dz dzieli średnią różnicę przez odchylenie standardowe różnic, więc rośnie wraz z korelacją pomiarów i służy m.in. do analizy mocy. dav dzieli ją przez średnie odchylenie standardowe obu pomiarów i jest porównywalne z d z badań międzygrupowych; Lakens (2013) zaleca w raportach właśnie dav albo drm.
Czy test t dla prób zależnych wystarczy w badaniu przed–po bez grupy kontrolnej?
Test pokaże, czy wynik się zmienił, ale nie, dlaczego. Bez grupy kontrolnej zmianę mogą wyjaśniać upływ czasu, inne wydarzenia czy regresja do średniej, więc unikaj wniosków przyczynowych. Z grupą kontrolną porównaj zmianę między grupami albo użyj ANCOVA.
Co zrobić, gdy różnice nie mają rozkładu normalnego?
Przy kilkudziesięciu parach i umiarkowanej skośności test t zwykle działa dobrze. Przy małej próbie z wyraźnie skośnymi różnicami albo skrajnymi wartościami użyj testu Wilcoxona dla par i opisz wynik medianami.
Jak zrobić test t dla prób zależnych w SPSS?
Wybierz Analiza → Porównywanie średnich → Test t dla prób zależnych i wskaż parę zmiennych (np. przed i po). W tabeli „Test dla prób zależnych” odczytaj średnią różnic z 95% CI, t, df i istotność dwustronną; SPSS od wersji 27 podaje też d Cohena liczone jako dz.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Próby zależne w obrazkach
Te same 30 par dwoma testami, rozkład różnic, korelacja pomiarów od −.5 do .8, moc z symulacji i regresja do średniej – pięć rysunków z kodem R.
Czytaj →PoradnikTest t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kim, H.-Y. (2012). Statistical notes for clinical researchers: Assessing normal distribution (1). Restorative Dentistry & Endodontics, 37(4), 245–248. https://doi.org/10.5395/rde.2012.37.4.245 ● Otwarty dostęp
- Kim, T. K. (2015). T test as a parametric statistic. Korean Journal of Anesthesiology, 68(6), 540–546. https://doi.org/10.4097/kjae.2015.68.6.540 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
Cytowania BibTeX
@article{kim2012assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (1)}}, journal={Restorative Dentistry \& Endodontics}, year={2012}, volume={37}, number={4}, pages={245--248}, doi={10.5395/rde.2012.37.4.245}}@article{kim2015ttest, author={Kim, Tae Kyun}, title={{T test as a parametric statistic}}, journal={Korean Journal of Anesthesiology}, year={2015}, volume={68}, number={6}, pages={540--546}, doi={10.4097/kjae.2015.68.6.540}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}