Co to jest test t dla jednej próby?
Test t dla jednej próby (ang. one-sample t-test) sprawdza, czy średnia zmiennej ilościowej w populacji różni się od konkretnej wartości μ0, ustalonej przed zebraniem danych. To najprostszy wariant testu t Studenta: zamiast dwóch grup jest jedna próba i liczba, z którą się ją porównuje.
Hipotezy mają postać H0: μ = μ0 oraz – w wersji dwustronnej – H1: μ ≠ μ0 (zob. hipoteza zerowa i alternatywna). Test nie mówi, czy średnia jest „wysoka” w sensie absolutnym. Mówi tylko, czy dane są zgodne z tym, że średnia w populacji wynosi dokładnie μ0. Dlatego wartość tego testu zależy przede wszystkim od tego, czy wartość odniesienia ma sens merytoryczny.
Z czym porównywać średnią?
Wartość μ0 musi pochodzić spoza danych i mieć jasną interpretację. W psychologii najczęściej jest to jedna z poniższych wartości:
| Wartość odniesienia | Przykład | Na co uważać |
|---|---|---|
| Norma populacyjna | średnia 100 w teście inteligencji, średnia z norm testowych | norma musi dotyczyć porównywalnej populacji i tej samej wersji testu (przykład w haśle błąd standardowy) |
| Poziom przypadku | 50% trafnych odpowiedzi w zadaniu z dwiema opcjami | sprawdź, czy zgadywanie rzeczywiście daje 50%, np. przy nierównych proporcjach bodźców |
| Punkt środkowy skali | 3 na skali 1–5 („ani się zgadzam, ani nie”) | ma sens tylko na skali dwubiegunowej z neutralnym środkiem |
| Próg kliniczny | punkt odcięcia kwestionariusza przesiewowego | próg dotyczy pojedynczych osób, a test – średniej grupy |
Jeśli z normą porównujesz wynik jednej osoby, a nie średnią grupy, a próba normalizacyjna była mała, użyj zmodyfikowanego testu t Crawforda i Howella (1998) zamiast przeliczania wyniku na wynik z i tablic rozkładu normalnego. Jeśli wartość odniesienia pochodzi z innej, niewielkiej próby, potraktuj ją jako drugą grupę i użyj testu t dla prób niezależnych.
Wzór i założenia
- M – średnia w próbie, μ0 – wartość odniesienia,
- SD / √n – błąd standardowy średniej,
- n − 1 – liczba stopni swobody.
Rozkład t z n − 1 stopniami swobody pojawia się dlatego, że wariancji w populacji nie znamy i szacujemy ją z próby (Kim, 2015). Z tych samych składników powstaje 95% przedział ufności dla średniej: M ± tkryt × SE. Jeśli przedział nie obejmuje μ0, test dwustronny daje p < .05 – to dwa sposoby przedstawienia tej samej informacji.
Założenia są proste: niezależne obserwacje, zmienna ilościowa i w przybliżeniu normalny rozkład średnich z prób. Przy kilkudziesięciu osobach test znosi umiarkowaną skośność; przy małej próbie obejrzyj wykres Q-Q i poszukaj obserwacji odstających.
Przykład: średnia skali Likerta a punkt środkowy
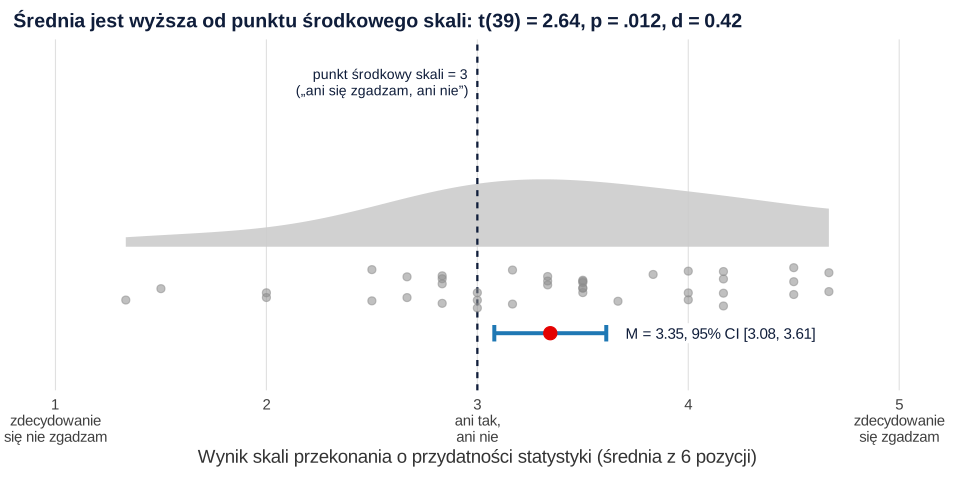
Czterdzieścioro studentów psychologii wypełniło sześciopozycyjną skalę przekonania o przydatności statystyki (np. „Statystyka przyda mi się w pracy psychologa”). Odpowiedzi zapisano na skali od 1 (zdecydowanie się nie zgadzam) do 5 (zdecydowanie się zgadzam), a wynikiem osoby jest średnia z sześciu pozycji, więc mieści się w tym samym zakresie 1–5. Rzetelność skali była dobra (α = .87). Pytanie badawcze: czy studenci przeciętnie raczej zgadzają się, że statystyka jest przydatna – czyli czy średnia jest wyższa od neutralnego 3? (dane symulowane)
- Statystyki opisowe: n = 40, M = 3.346, SD = 0.830 (mediana 3.42, zakres 1.33–4.67).
- Błąd standardowy: SE = 0.830 / √40 = 0.131.
- Statystyka testowa: t = (3.346 − 3) / 0.131 = 2.64 przy 39 stopniach swobody.
- Decyzja: wartość krytyczna t(39) dla α = .05 wynosi 2.02, a dwustronne p = .012, więc odrzucamy H0.
- Przedział ufności: 95% CI dla średniej [3.08, 3.61] nie obejmuje 3.
Przeciętnie studenci skłaniali się więc ku zgodzie z twierdzeniami skali – ale średnia przewyższała punkt neutralny tylko o 0.35 punktu, czyli o około jedną trzecią odległości między „ani się zgadzam, ani nie” a „raczej się zgadzam”. Rysunek 1 pokazuje, że wyniki są mocno rozproszone: część osób ma wyniki wyraźnie poniżej 3.
Kiedy porównanie z punktem środkowym skali ma sens?
- Skala jest dwubiegunowa (od niezgody do zgody), a środek oznacza postawę neutralną. Na skalach jednobiegunowych („wcale – bardzo”, „nigdy – zawsze”) środek nie jest neutralny: „czasami” to już pewne nasilenie.
- Wynik skali jest średnią, a nie sumą pozycji – wtedy punkt środkowy nadal wynosi 3. Przy sumie sześciu pozycji środkiem byłoby 18.
- Interpretujesz wynik względem formatu odpowiedzi, a nie normy. „Średnia powyżej 3” znaczy „więcej zgody niż niezgody”, a nie „wysoki poziom cechy w porównaniu z populacją” – do takich wniosków potrzebne są normy.
- Pamiętasz o stylu odpowiadania – skłonność do zgadzania się z twierdzeniami podnosi średnią, zwłaszcza gdy w skali brakuje pozycji odwróconych.
Analiza średniej z kilku pozycji testem parametrycznym jest powszechna i zwykle uzasadniona. Sullivan i Artino (2013) zaznaczają, że testy parametryczne można stosować do wyników skal Likerta, ale łączenie pozycji w skalę trzeba poprzeć dowodami rzetelności lub struktury. Norman (2010) przypomina, że metody parametryczne są odporne na naruszenia założeń, także przy danych z takich skal. Liddell i Kruschke (2018) przestrzegają jednak, że analiza danych porządkowych modelami metrycznymi może dawać fałszywe alarmy, a nawet odwracać kierunek efektu i że uśrednianie pozycji nie usuwa tego problemu. Przy pojedynczym pytaniu rozważ więc test Wilcoxona dla jednej próby albo regresję porządkową. W przykładzie test Wilcoxona dał zgodny wynik: V = 524.5, p = .009.
d Cohena dla jednej próby
d mówi, o ile odchyleń standardowych średnia odbiega od wartości odniesienia. W przykładzie d = 0.42, 95% CI [0.09, 0.74], a g Hedgesa (z poprawką na małą próbę) wynosi 0.41. Według konwencji Cohena (1992) to efekt pomiędzy małym a średnim. Przedział ufności jest jednak szeroki: dane są zgodne zarówno z ledwie zauważalnym, jak i z wyraźnym odchyleniem od punktu środkowego. Więcej o interpretacji – w haśle d Cohena.
Istotność zależy od liczebności, wielkość efektu – nie
W teście dla jednej próby statystykę t i d łączy prosty związek: t = d × √n. Ta sama różnica (d = 0.42) daje więc różne wyniki testu przy różnej liczebności (rysunek 2): przy 15 osobach t(14) = 1.61, p = .129, przy 40 osobach p = .012, a przy 80 – p < .001. Próg istotności zostaje przekroczony dopiero od 25 osób.
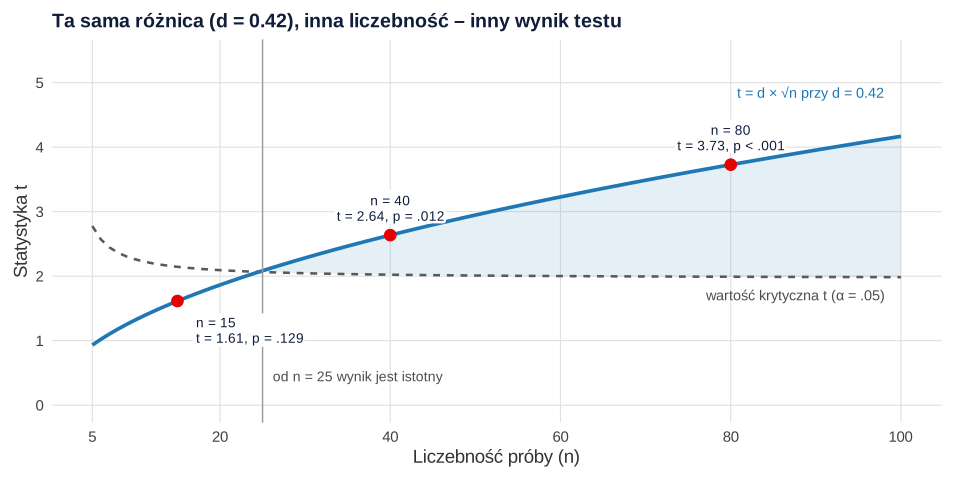
Wniosek praktyczny: wynik nieistotny w małej próbie nie dowodzi, że średnia równa się wartości odniesienia, a wynik istotny w dużej próbie nie oznacza jeszcze ważnej różnicy. Liczebność planuj z góry na podstawie mocy testu (zob. analiza mocy a priori w G*Power).
Jak opisać wynik w pracy (APA)
W części metodologicznej napisz, dlaczego porównujesz średnią właśnie z tą wartością (np. „punkt środkowy oznacza postawę neutralną”). Gdy wynik jest nieistotny, nie pisz, że „średnia była równa 3” – napisz, że nie stwierdzono istotnej różnicy, i podaj przedział ufności. Więcej gotowych zdań znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przykład w R i SPSS
Kod generuje dane z przykładu, sprawdza rzetelność skali, wykonuje test t dla jednej próby z wartością odniesienia 3, liczy d z przedziałem ufności i dla porównania test Wilcoxona.
Test t dla jednej próby i d Cohena
R
library(effectsize)
set.seed(77)
postawa <- rnorm(40, 0.3, 0.75)                 # 40 osób; odpowiedzi na 6 pozycji (1–5)
odp <- sapply(1:6, function(j)
  as.integer(cut(postawa + rnorm(40, 0, 0.8), c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf))))
wynik <- rowMeans(odp)                          # wynik skali = średnia z 6 pozycji
round(psych::alpha(odp)$total$raw_alpha, 3)     # rzetelność skali (alfa Cronbacha)
round(c(M = mean(wynik), SD = sd(wynik), SE = sd(wynik) / sqrt(40)), 3)
t.test(wynik, mu = 3)                           # porównanie z punktem środkowym skali
cohens_d(wynik, mu = 3)                         # d dla jednej próby z 95% CI
wilcox.test(wynik, mu = 3, exact = FALSE)       # nieparametryczna alternatywa
Wynik w R
[1] 0.865
    M    SD    SE
3.346 0.830 0.131

	One Sample t-test

data:  wynik
t = 2.6358, df = 39, p-value = 0.01198
alternative hypothesis: true mean is not equal to 3
95 percent confidence interval:
 3.080447 3.611220
sample estimates:
mean of x
 3.345833

Cohen's d |       95% CI
------------------------
0.42      | [0.09, 0.74]

- Deviation from a difference of 3.
	Wilcoxon signed rank test with continuity correction

data:  wynik
V = 524.5, p-value = 0.009079
alternative hypothesis: true location is not equal to 3
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i ggdist. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2024). ggdist: Visualizations of distributions and uncertainty in the grammar of graphics. IEEE Transactions on Visualization and Computer Graphics, 30(1), 414–424. https://doi.org/10.1109/TVCG.2023.3327195
Najczęstsze błędy
- Wartość odniesienia wybrana po obejrzeniu danych – μ0 ustala się przed analizą; dopasowanie jej do wyniku odbiera testowi sens.
- Porównanie z punktem środkowym skali jednobiegunowej albo z „normą” opracowaną w innej populacji.
- Traktowanie punktu środkowego jak normy – średnia powyżej 3 nie znaczy „wysoki poziom cechy”.
- Porównywanie pojedynczej osoby z normą jak średniej grupy – do tego służy test Crawforda i Howella (1998) albo wynik na skali standaryzowanej.
- Brak wielkości efektu – w dużej próbie nawet minimalne odchylenie od μ0 będzie istotne.
- Test jednostronny bez uzasadnienia zapisanego przed badaniem – zob. test jednostronny i dwustronny.
Najczęstsze pytania
Kiedy stosuje się test t dla jednej próby?
Gdy chcesz sprawdzić, czy średnia zmiennej ilościowej w populacji różni się od konkretnej wartości ustalonej przed badaniem: normy testowej, poziomu przypadku (np. 50% trafień), progu klinicznego albo punktu środkowego skali. Wartość odniesienia nie może pochodzić z tych samych danych.
Jak obliczyć test t dla jednej próby?
Odejmij wartość odniesienia od średniej i podziel wynik przez błąd standardowy średniej: t = (M − μ0) / (SD/√n). Na przykład przy M = 3.346, SD = 0.830 i n = 40: t = 0.346 / 0.131 = 2.64 przy 39 stopniach swobody, p = .012. W R: t.test(x, mu = 3).
Czy można porównać średnią skali Likerta z punktem środkowym?
Tak, jeśli skala jest dwubiegunowa (od niezgody do zgody), środek oznacza postawę neutralną, a wynikiem jest średnia z pozycji. Wynik interpretuj względem formatu odpowiedzi („więcej zgody niż niezgody”), a nie jako wysoki poziom cechy w populacji – do tego potrzebne są normy.
Jak obliczyć d Cohena dla jednej próby?
Podziel różnicę między średnią a wartością odniesienia przez odchylenie standardowe: d = (M − μ0) / SD. W przykładzie ze strony d = 0.346 / 0.830 = 0.42, 95% CI [0.09, 0.74]. W R przedział ufności policzysz funkcją cohens_d(x, mu = 3) z pakietu effectsize.
Co zamiast testu t dla jednej próby, gdy rozkład nie jest normalny?
Przy kilkudziesięciu osobach test t zwykle wystarcza, bo jest odporny na umiarkowaną skośność. Przy małej próbie z silną skośnością albo dla pojedynczej pozycji porządkowej użyj testu Wilcoxona dla jednej próby (w R: wilcox.test(x, mu = 3)).
Jak wykonać test t dla jednej próby w SPSS?
Wybierz Analiza → Porównywanie średnich → Test t dla jednej próby, przenieś zmienną do pola „Zmienne testowane” i wpisz wartość odniesienia jako „Wartość testowana”. W tabeli „Test dla jednej próby” odczytaj t, df, istotność dwustronną i 95% przedział ufności różnicy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Crawford, J. R., & Howell, D. C. (1998). Comparing an individual’s test score against norms derived from small samples. The Clinical Neuropsychologist, 12(4), 482–486. https://doi.org/10.1076/clin.12.4.482.7241
- Kim, T. K. (2015). T test as a parametric statistic. Korean Journal of Anesthesiology, 68(6), 540–546. https://doi.org/10.4097/kjae.2015.68.6.540 ● Otwarty dostęp
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{crawford1998comparing, author={Crawford, John R. and Howell, David C.}, title={{Comparing an individual’s test score against norms derived from small samples}}, journal={The Clinical Neuropsychologist}, year={1998}, volume={12}, number={4}, pages={482--486}, doi={10.1076/clin.12.4.482.7241}}@article{kim2015ttest, author={Kim, Tae Kyun}, title={{T test as a parametric statistic}}, journal={Korean Journal of Anesthesiology}, year={2015}, volume={68}, number={6}, pages={540--546}, doi={10.4097/kjae.2015.68.6.540}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}