Co to jest średnia arytmetyczna?
Średnia arytmetyczna (ang. arithmetic mean; w raportach M, we wzorach x̄) to suma wszystkich wyników podzielona przez ich liczbę. To najczęściej podawana miara tendencji centralnej w psychologii: średni wynik w skali lęku, średni czas reakcji, średnia liczba poprawnych odpowiedzi w teście. Razem z medianą i dominantą należy do podstawowych narzędzi statystyki opisowej.
Średnia korzysta z informacji zawartej w każdej obserwacji i spośród miar tendencji centralnej najmniej zmienia się między kolejnymi próbami. Ma jednak słabe strony: jest wrażliwa na wartości skrajne (zwłaszcza w małych próbach), źle opisuje rozkłady skośne i nie da się jej policzyć dla danych nominalnych (Manikandan, 2011). Liczymy ją więc dla zmiennych mierzonych na skali ilościowej. Dla skali nominalnej – np. kierunku studiów zakodowanego jako 1, 2 i 3 – średnia kodów nie ma sensu, nawet jeśli program ją wyliczy.
Wzór na średnią arytmetyczną
- M (x̄) – średnia w próbie; średnią w populacji oznacza się grecką literą μ,
- xi – wynik i-tej osoby,
- Σ – suma wyników wszystkich osób,
- n – liczba obserwacji.
Przykład. Siedem osób wykonało komputerowe zadanie Stroopa. Ich średnie czasy reakcji w próbach niezgodnych wyniosły 570, 531, 764, 583, 837, 732 i 652 ms. Suma wyników to 4669 ms, więc:
Mediana tych samych siedmiu wyników to 652 ms – sposób jej wyznaczania pokazujemy w haśle o medianie.
Właściwości średniej
- Odchylenia od średniej sumują się do zera. W przykładzie: −97 − 136 + 97 − 84 + 170 + 65 − 15 = 0. Średnia jest „punktem równowagi” rozkładu.
- Średnia minimalizuje sumę kwadratów odchyleń. Żadna inna liczba c nie daje mniejszej sumy (xi − c)². Dlatego wariancję i odchylenie standardowe liczy się właśnie wokół średniej.
- Zmiana jednostek zmienia średnią w przewidywalny sposób. Dodanie stałej do każdego wyniku przesuwa średnią o tę stałą, a pomnożenie wyników przez liczbę mnoży przez nią średnią: 667 ms to 0.667 s.
- Każda obserwacja wpływa na wynik. To zaleta przy rozkładach symetrycznych i wada, gdy w danych są obserwacje odstające.
Średnia z próby jest też punktem wyjścia do wnioskowania o średniej w populacji – jej precyzję opisuje błąd standardowy.
Średnia w rozkładzie skośnym: przykład czasów reakcji
Czasy reakcji mają zwykle długi prawy ogon: większość osób odpowiada szybko, ale kilka – znacznie wolniej. Rysunek 1 pokazuje symulowane wyniki 120 studentów w zadaniu Stroopa (te same dane wykorzystujemy w hasłach o medianie, kwartylach i rozstępie ćwiartkowym).
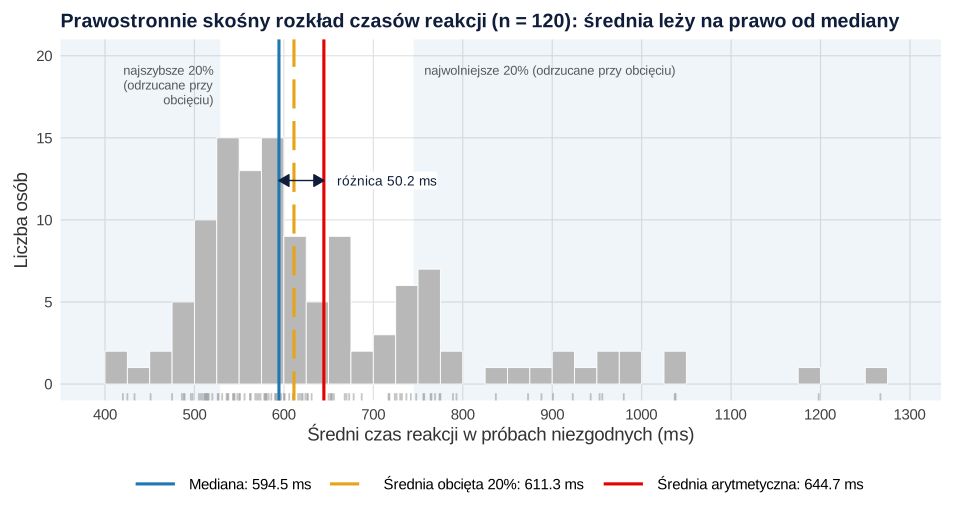
Średnia wyniosła M = 644.71 ms (SD = 154.37), a mediana Mdn = 594.50 ms. Kilka bardzo wolnych osób (najwolniejsza: 1267 ms) ciągnie średnią w stronę ogona – leży ona aż o 50.21 ms na prawo od mediany. W efekcie 62.5% osób ma czas krótszy od średniej – średnia nie opisuje tu typowej osoby. Taki rozkład nazywamy prawostronnie skośnym; współczynnik skośności (estymator G1, jak w SPSS) wyniósł 1.57.
Ostrożnie z podręcznikową regułą „przy skośności prawostronnej średnia jest większa od mediany”. Von Hippel (2005) pokazuje, że zawodzi ona zaskakująco często: w rozkładach wielomodalnych, w rozkładach z jednym długim, a drugim ciężkim ogonem, a najczęściej w rozkładach dyskretnych, takich jak odpowiedzi na skali 1–5. Kształt rozkładu oceniaj na histogramie albo wykresie pudełkowym, a nie po samej różnicy średniej i mediany. W psychologii trzeba się z tym liczyć stale: Micceri (1989) przeanalizował 440 dużych rozkładów wyników testów osiągnięć i miar psychometrycznych – wszystkie istotnie odbiegały od rozkładu normalnego.
Średnia obcięta i inne odporne miary położenia
Średnia obcięta (ang. trimmed mean) to średnia policzona po odrzuceniu ustalonego odsetka najmniejszych i największych wyników. Przy obcięciu 20% i n = 120 pomijamy po 24 wyniki z każdej strony i uśredniamy środkowe 72 (od 531 do 742 ms). W naszych danych średnia obcięta 20% wynosi 611.26 ms – leży między medianą a zwykłą średnią. Pokrewne miary to:
- średnia winsoryzowana – skrajne wyniki nie są usuwane, tylko zastępowane najbliższą wartością z pozostawionej części (przy 20%: 621.36 ms);
- średnia obcięta 5% – podaje ją SPSS w procedurze Explore jako 5% Trimmed Mean (tu 631.25 ms);
- mediana – skrajny przypadek obcięcia, w którym zostaje jeden albo dwa środkowe wyniki.
Wilcox i Keselman (2003) wyjaśniają, dlaczego nowsze badania nad danymi odbiegającymi od normalności ujawniają praktyczne problemy przy porównywaniu średnich. Metody oparte na odpornych miarach położenia, takich jak średnia obcięta, mogą wyraźnie zwiększyć moc i trafność porównań w stosunku do klasycznego testu t i ANOVA. W R wykonasz je w pakiecie WRS2 – np. test Yuena (yuen()) porównuje średnie obcięte dwóch grup i domyślnie obcina 20%.
Średnia ważona
Gdy poszczególne wartości mają różną wagę, liczymy średnią ważoną:
gdzie wi to waga i-tej wartości. Typowa sytuacja w pracy dyplomowej: znasz średnie kilku podgrup o różnej liczebności i chcesz policzyć średnią całej próby. Wagami są wtedy liczebności grup. W naszym przykładzie badani pochodzili z trzech roczników:
| Grupa | n | M (ms) |
|---|---|---|
| I rok | 60 | 638.65 |
| II rok | 40 | 612.65 |
| III rok | 20 | 727.00 |
| Średnia trzech średnich (bez wag) | – | 659.43 |
| Średnia ważona liczebnościami | 120 | 644.71 |
Zwykła średnia trzech średnich (659.43 ms) zawyża wynik, bo nieliczny III rok liczy się w niej tyle samo co trzy razy liczniejszy I rok. Średnia ważona, (60 × 638.65 + 40 × 612.65 + 20 × 727.00) / 120 = 644.71 ms, jest równa średniej całej próby. Różnice między rocznikami są tu przypadkowe – ważny jest mechanizm. Manikandan (2011) omawia także inne rodzaje średnich: geometryczną i harmoniczną.
Średnia czy mediana? M (SD) czy Mdn (IQR)
Wybór miary położenia zależy od skali pomiaru i kształtu rozkładu. Jeśli rozkład jest w miarę symetryczny, podaj średnią z odchyleniem standardowym; jeśli jest silnie skośny albo zawiera wartości skrajne – medianę z rozstępem ćwiartkowym.
| Dane | Co podać | Przykład |
|---|---|---|
| Zmienna ilościowa, rozkład zbliżony do symetrycznego | M (SD) | wynik skali samooceny, iloraz inteligencji |
| Zmienna ilościowa, silna skośność lub wartości skrajne | Mdn (IQR), często razem z M (SD) | czasy reakcji, liczba objawów, dochód |
| Pojedyncza pozycja na skali porządkowej | Mdn i rozkład odpowiedzi | odpowiedź 1–5 na pozycję skali Likerta |
| Zmienna nominalna | liczebności, procenty, dominanta | kierunek studiów, miejsce zamieszkania |
W tabeli z charakterystyką próby możesz podać obie miary, jeśli czytelnik ma ocenić kształt rozkładu – wzór znajdziesz w haśle tabela statystyk opisowych w APA.
Jak opisać średnią w pracy (APA)
W stylu APA średnią oznacza się kursywą jako M, a odchylenie standardowe jako SD. Podawaj je razem, z tą samą liczbą miejsc po przecinku (zwykle dwoma). Przy skośnych danych dopisz medianę z IQR.
Porównując grupy, podawaj M i SD każdej z nich, a nie tylko wynik testu. Więcej gotowych zdań zebraliśmy w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Kod odtwarza dane z rysunku 1 i liczy średnią, medianę, średnie obcięte, skośność oraz średnią ważoną. W SPSS większość tych statystyk znajdziesz w menu Analyze → Descriptive Statistics → Explore (tabela Descriptives: Mean, 5% Trimmed Mean, Median).
Średnia, średnia obcięta i średnia ważona
R
set.seed(53)
rt <- round(rnorm(120, mean = 500, sd = 50) + rexp(120, rate = 1 / 150))  # czasy reakcji (ms)
round(c(M = mean(rt), Mdn = median(rt), SD = sd(rt),
        M_obc20 = mean(rt, trim = 0.2),       # średnia obcięta 20%
        M_obc05 = mean(rt, trim = 0.05)), 2)  # średnia obcięta 5%
mean(rt < mean(rt))                           # odsetek osób poniżej średniej
round(psych::skew(rt, type = 2), 2)           # skośność G1 (jak w SPSS)
rok <- factor(rep(c("I", "II", "III"), times = c(60, 40, 20)))
srednie <- tapply(rt, rok, mean)              # średnie w rocznikach
round(srednie, 2)
round(mean(srednie), 2)                       # średnia średnich – błąd przy różnych n
round(weighted.mean(srednie, w = table(rok)), 2)  # średnia ważona = średnia całej próby
Wynik w R
      M     Mdn      SD M_obc20 M_obc05
 644.71  594.50  154.37  611.26  631.25
[1] 0.625
[1] 1.57
     I     II    III
638.65 612.65 727.00
[1] 659.43
[1] 644.71
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; skośność policzono w pakiecie psych, a rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Średnia jako „typowy wynik” w skośnym rozkładzie – w przykładzie 62.5% osób było szybszych niż średnia. Zanim zinterpretujesz M, obejrzyj histogram.
- Średnia kodów zmiennej nominalnej – „średnia płeć” czy „średni kierunek studiów” nic nie znaczą (Manikandan, 2011).
- Średnia średnich przy nierównych grupach – zamiast średniej ważonej; w przykładzie zawyżyła wynik o prawie 15 ms.
- Ocenianie skośności tylko po relacji średniej i mediany – ta reguła bywa zawodna, zwłaszcza w danych dyskretnych (von Hippel, 2005).
- Usuwanie „niewygodnych” wyników, aby poprawić średnią – kryteria obserwacji odstających ustal przed analizą albo użyj odpornej miary położenia (Wilcox i Keselman, 2003).
- Średnia bez miary rozproszenia – M = 644.71 ms niewiele mówi bez SD; dwie grupy o tej samej średniej mogą mieć zupełnie różne rozkłady (przykład pokazujemy w haśle o odchyleniu standardowym).
Najczęstsze pytania
Jak obliczyć średnią arytmetyczną?
Dodaj wszystkie wyniki i podziel sumę przez ich liczbę: M = Σx / n. Na przykład czasy reakcji 570, 531, 764, 583, 837, 732 i 652 ms sumują się do 4669 ms, więc średnia wynosi 4669 / 7 = 667 ms. W R służy do tego funkcja mean().
Kiedy lepiej podać medianę niż średnią?
Gdy rozkład jest silnie skośny (np. czasy reakcji, liczba objawów), gdy w danych są wartości skrajne albo gdy zmienna jest porządkowa. Średnia przesuwa się wtedy w stronę ogona i przestaje opisywać typową osobę. Podaj medianę z rozstępem ćwiartkowym, a w razie potrzeby także średnią z SD.
Co to jest średnia obcięta?
To średnia policzona po odrzuceniu ustalonego odsetka najmniejszych i największych wyników, np. po 20% z każdej strony. Jest dużo mniej wrażliwa na wartości skrajne niż zwykła średnia. W R: mean(x, trim = 0.2); SPSS w procedurze Explore podaje średnią obciętą 5%.
Jak obliczyć średnią ważoną?
Pomnóż każdą wartość przez jej wagę, zsumuj iloczyny i podziel przez sumę wag: Mw = Σwixi / Σwi. Gdy łączysz średnie grup o różnej liczebności, wagami są liczebności grup – wynik równa się wtedy średniej całej próby. W R: weighted.mean(x, w).
Jak zapisać średnią w APA?
Średnią oznacz kursywą jako M i podaj ją razem z odchyleniem standardowym, np. M = 644.71 ms (SD = 154.37). Zwykle wystarczą dwa miejsca po przecinku. Przy skośnym rozkładzie dodaj medianę z rozstępem ćwiartkowym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Manikandan, S. (2011). Measures of central tendency: The mean. Journal of Pharmacology and Pharmacotherapeutics, 2(2), 140–142. https://doi.org/10.4103/0976-500X.81920 ● Otwarty dostęp: pełny tekst
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- von Hippel, P. T. (2005). Mean, median, and skew: Correcting a textbook rule. Journal of Statistics Education, 13(2). https://doi.org/10.1080/10691898.2005.11910556 ● Otwarty dostęp
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods: Measures of central tendency. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
Cytowania BibTeX
@article{manikandan2011mean, author={Manikandan, S.}, title={{Measures of central tendency: The mean}}, journal={Journal of Pharmacology and Pharmacotherapeutics}, year={2011}, volume={2}, number={2}, pages={140--142}, doi={10.4103/0976-500x.81920}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}@article{vonhippel2005mean, author={von Hippel, Paul T.}, title={{Mean, median, and skew: Correcting a textbook rule}}, journal={Journal of Statistics Education}, year={2005}, volume={13}, number={2}, doi={10.1080/10691898.2005.11910556}}@article{wilcox2003modern, author={Wilcox, Rand R. and Keselman, H. J.}, title={{Modern robust data analysis methods: Measures of central tendency}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={254--274}, doi={10.1037/1082-989x.8.3.254}}