Co to jest statystyka opisowa?
Statystyka opisowa (ang. descriptive statistics) to zestaw liczb, tabel i wykresów, które streszczają zebrane dane: ile osób jest w każdej kategorii, jaki wynik jest typowy, jak bardzo wyniki się różnią i jaki kształt ma ich rozkład. Opisuje próbę, którą masz, i niczego nie uogólnia. Wnioskowanie o populacji – przedziały ufności i testy statystyczne – to już statystyka indukcyjna.
W pracy dyplomowej statystyki opisowe pojawiają się dwa razy: w metodzie, gdy opisujesz osoby badane, i na początku wyników, gdy przedstawiasz badane zmienne, zanim przejdziesz do testowania hipotez. To nie formalność: dopiero rozkład pokazuje, czy wybrane testy mają sens i czy w danych nie ma błędów.
Cztery pytania, cztery grupy miar
| Grupa miar | Na jakie pytanie odpowiada | Miary |
|---|---|---|
| Liczebności i odsetki | Ile osób jest w każdej kategorii? | n, %, odsetek ważnych odpowiedzi, odsetek skumulowany; dla dwóch zmiennych – tabela krzyżowa |
| Tendencja centralna | Jaki wynik jest typowy? | średnia, mediana, dominanta |
| Rozproszenie | Jak bardzo wyniki się różnią? | odchylenie standardowe, wariancja, rozstęp ćwiartkowy, rozstęp, kwartyle |
| Kształt rozkładu | Czy rozkład jest symetryczny i jak często zdarzają się wyniki skrajne? | skośność, kurtoza |
Liczby warto uzupełnić wykresem, bo różne rozkłady mogą mieć te same średnie i odchylenia. Mishra i in. (2019) przypominają, że kształt rozkładu ocenia się nie tylko liczbowo, ale też graficznie – na histogramie, wykresie pudełkowym czy wykresie Q-Q. Rozkład kategorii pokażesz na wykresie słupkowym, a związek dwóch zmiennych ilościowych – na wykresie rozrzutu.
Które statystyki dla jakiej zmiennej?
Wybór miar zależy przede wszystkim od poziomu pomiaru. Podział na skale nominalną, porządkową, interwałową i ilorazową pochodzi od Stevensa (1946); w praktyce dwie ostatnie łączy się jako skalę ilościową.
| Poziom pomiaru | Przykład | Typowy wynik | Rozproszenie i kształt |
|---|---|---|---|
| nominalny | płeć, kierunek studiów, forma terapii | dominanta | n i % w każdej kategorii |
| porządkowy | rok studiów, wykształcenie, pojedyncza pozycja skali Likerta | mediana (i dominanta) | kwartyle albo rozstęp ćwiartkowy; rozkład odpowiedzi w % |
| ilościowy, rozkład zbliżony do symetrycznego | wynik skali kwestionariusza, wynik testu | średnia | odchylenie standardowe, zakres, skośność, kurtoza |
| ilościowy, rozkład skośny | czas reakcji, liczba objawów, czas w mediach społecznościowych | mediana (obok średnia) | rozstęp ćwiartkowy, zakres, skośność, kurtoza |
Dominanta jest jedyną miarą tendencji centralnej dla danych nominalnych, a mediana nadaje się do danych porządkowych i – w przeciwieństwie do średniej – nie ulega wpływowi wartości skrajnych i skośności (Manikandan, 2011). Pojedyncze pozycje skali Likerta są porządkowe, więc opisuje się je medianą i rozkładem odpowiedzi, ale wynik całej skali, złożony z wielu pozycji, można opisywać średnią i analizować metodami parametrycznymi (Sullivan i Artino, 2013). Program policzy średnią z każdej kolumny liczb – także z kodów płci (w przykładzie niżej wyszłoby 1.31) – ale taka liczba nic nie znaczy.
Przykład: jedna zmienna, wiele statystyk
Sto pięćdziesiąt osób (dane symulowane) podało, ile godzin dziennie spędza w mediach społecznościowych; trzy osoby nie odpowiedziały. Rysunek 1 pokazuje, co mówią o tej zmiennej poszczególne statystyki.
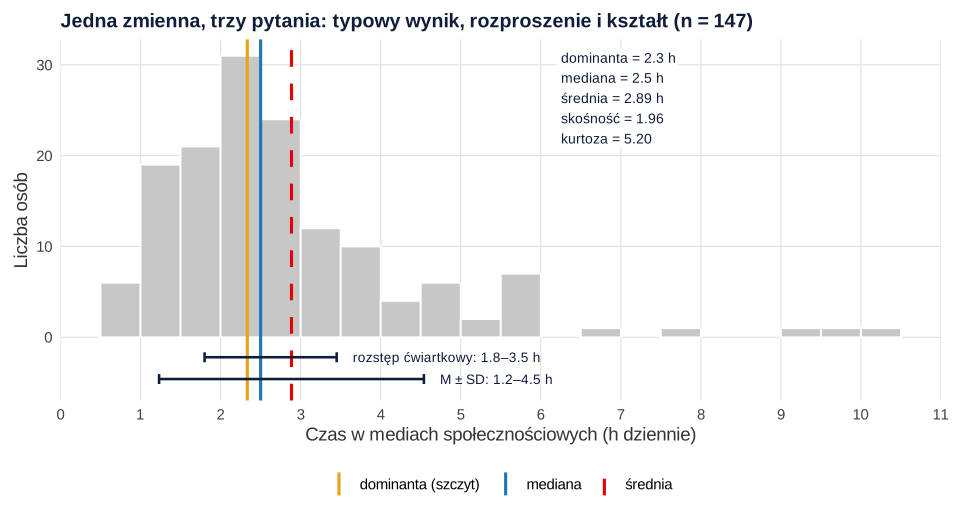
Szczyt rozkładu przypada na 2.3 h, mediana wynosi 2.50 h, a średnia 2.89 h. Średnią ciągnie w prawo kilka osób z bardzo długim czasem – pięć osób podało od 7.0 do 10.4 h dziennie – więc przekracza ją tylko 36.7% badanych. Przedział M ± SD (od 1.23 do 4.54 h) sugeruje symetryczny rozrzut, którego tu nie ma; typowe wyniki lepiej opisuje rozstęp ćwiartkowy, od 1.80 do 3.45 h. To samo mówią liczby: skośność wynosi 1.96, a kurtoza 5.20. Cain i in. (2017) stwierdzili, że 74% rozkładów jednowymiarowych z badań opublikowanych w Psychological Science i American Educational Research Journal odbiegało od normalności, i dlatego zalecają rutynowe raportowanie skośności i kurtozy. W tabeli dla takiej zmiennej podaj medianę z kwartylami, a obok średnią i odchylenie standardowe.
Opis próby: charakterystyka osób badanych
W części „Osoby badane” podaj liczbę osób i ich podstawowe cechy, które pozwolą czytelnikowi ocenić, kogo dotyczą wyniki: płeć (n i %), wiek (M, SD i zakres), a dalej – zależnie od badania – kierunek i rok studiów, wykształcenie, miejsce zamieszkania czy diagnozę. Napisz, ile osób wykluczono i dlaczego, a przy zmiennych z brakami podaj n dla każdej z nich. Szczegóły i wzory zdań znajdziesz w poradnikach jak opisać charakterystykę próby i wzór przedstawienia charakterystyki próby.
Tabela statystyk opisowych w stylu APA
Gdy zmiennych jest kilka, zestaw je w tabeli. Poniższa łączy charakterystykę próby ze statystykami badanych zmiennych i do każdej zmiennej dobiera miary według poziomu pomiaru i kształtu rozkładu. Standardowy układ tabeli z kolumnami M, SD, skośność, kurtoza i α, z notą i wzorem w Wordzie, pokazujemy w haśle tabela statystyk opisowych w APA.
Tabela 1
Charakterystyka próby i statystyki opisowe badanych zmiennych
| Zmienna | Statystyka | Wartość |
|---|---|---|
| Płeć: kobieta | n (%) | 107 (71.3) |
| Płeć: mężczyzna | n (%) | 39 (26.0) |
| Płeć: inna lub nie podano | n (%) | 4 (2.7) |
| Studia stacjonarne | n (%) | 122 (81.3) |
| Rok studiów | Mdn (Q1–Q3) | 2 (1–3) |
| Wiek (lata) | M (SD); zakres | 22.58 (2.46); 19–33 |
| Czas w mediach społecznościowych (h/dzień)a | Mdn (Q1–Q3) | 2.50 (1.80–3.45) |
| M (SD) | 2.89 (1.65) | |
| Stres akademicki (1–5) | M (SD) | 3.14 (0.66) |
Uwaga. N = 150. Q1 i Q3 – pierwszy i trzeci kwartyl. Skośność i kurtozę obliczono tak jak w SPSS.
a n = 147 (trzy osoby nie odpowiedziały); rozkład prawostronnie skośny (skośność = 1.96, kurtoza = 5.20).
Jak opisać statystyki opisowe w pracy (APA)
W tekście nie powtarzaj wszystkich liczb z tabeli – przywołaj ją i opisz najważniejsze informacje. Średnią podawaj z odchyleniem standardowym, medianę z kwartylami albo rozstępem ćwiartkowym, a odsetki z liczebnościami. Przykład dla danych z tej strony:
Do opisu precyzji średniej służy błąd standardowy i przedział ufności – w opisie próby podawaj jednak odchylenie standardowe. Więcej wzorów zdań znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Kod odtwarza dane z tej strony i liczy wszystkie wartości z tabeli 1: liczebności i odsetki zmiennych nominalnych, medianę i kwartyle roku studiów, statystyki zmiennych ilościowych funkcją describe() z pakietu psych oraz własne podsumowanie w formacie gotowym do tabeli. W SPSS te same wyniki dają trzy procedury z menu Analiza → Opis statystyczny (Analyze → Descriptive Statistics): Częstości (Frequencies) – liczebności, odsetki, dominanta, mediana i kwartyle; Statystyki opisowe (Descriptives) – średnia, odchylenie standardowe, minimum, maksimum, skośność i kurtoza; Eksploracja (Explore) – mediana, rozstęp ćwiartkowy i wykresy pudełkowe, także w podziale na grupy.
Statystyki opisowe dla zmiennych nominalnych, porządkowych i ilościowych
R
library(psych)   # describe()

# Dane symulowane: 150 studentów
set.seed(85)
N <- 150
plec  <- sample(c("Kobieta", "Mężczyzna", "Inna/nie podano"), N, replace = TRUE, prob = c(.70, .27, .03))
forma <- sample(c("stacjonarne", "niestacjonarne"), N, replace = TRUE, prob = c(.8, .2))
rok   <- sample(1:5, N, replace = TRUE, prob = c(.30, .25, .20, .15, .10))
wiek  <- 18 + rok + round(rexp(N, 1 / 2.2))
media <- round(exp(rnorm(N, log(2.5), 0.5)), 1)    # czas w mediach społecznościowych (h/dzień)
media[sample(N, 3)] <- NA                          # trzy osoby nie odpowiedziały
stres <- round(pmin(pmax(rnorm(N, 3.1, 0.7), 1), 5), 2)
dane  <- data.frame(plec, forma, rok, wiek, media, stres)

# Zmienne nominalne: liczebności i odsetki
table(dane$plec)
round(100 * prop.table(table(dane$plec)), 1)
table(dane$forma)
# Zmienna porządkowa (rok studiów): rozkład, mediana i kwartyle
table(dane$rok)
quantile(dane$rok, c(.25, .50, .75))
# Zmienne ilościowe: type = 2 liczy skośność i kurtozę tak jak SPSS
round(describe(dane[, c("wiek", "media", "stres")], type = 2)[,
      c("n", "mean", "sd", "median", "min", "max", "skew", "kurtosis")], 2)

# Własne podsumowanie gotowe do tabeli: M (SD) oraz Mdn [Q1, Q3]
opis <- function(x) sprintf("M = %.2f (SD = %.2f); Mdn = %.2f [%.2f, %.2f]",
                            mean(x, na.rm = TRUE), sd(x, na.rm = TRUE), median(x, na.rm = TRUE),
                            quantile(x, .25, na.rm = TRUE), quantile(x, .75, na.rm = TRUE))
sapply(dane[, c("wiek", "media", "stres")], opis)
Wynik w R
Inna/nie podano         Kobieta       Mężczyzna
              4             107              39

Inna/nie podano         Kobieta       Mężczyzna
            2.7            71.3            26.0

niestacjonarne    stacjonarne
            28            122

 1  2  3  4  5
44 37 35 23 11
25% 50% 75%
  1   2   3
        n  mean   sd median   min   max skew kurtosis
wiek  150 22.58 2.46   22.0 19.00 33.00 1.11     2.02
media 147  2.89 1.65    2.5  0.80 10.40 1.96     5.20
stres 150  3.14 0.66    3.1  1.64  4.89 0.38     0.13
                                               wiek
"M = 22.58 (SD = 2.46); Mdn = 22.00 [21.00, 24.00]"
                                              media
    "M = 2.89 (SD = 1.65); Mdn = 2.50 [1.80, 3.45]"
                                              stres
    "M = 3.14 (SD = 0.66); Mdn = 3.10 [2.72, 3.52]"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; statystyki opisowe policzono w pakiecie psych, a rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Średnia kodów zmiennej nominalnej – „średnia płeć” czy „średni kierunek studiów” nic nie znaczą; podaj n i % (Manikandan, 2011).
- Sama średnia przy silnie skośnym rozkładzie – w przykładzie średnią przekroczyło tylko 36.7% osób; dodaj medianę z kwartylami.
- Błąd standardowy zamiast odchylenia standardowego – SE opisuje precyzję średniej, a nie zróżnicowanie osób.
- Odsetki bez podstawy – napisz, czy liczono je od wszystkich badanych, czy od osób, które odpowiedziały, i podaj n przy zmiennych z brakami.
- Statystyki bez sprawdzenia danych – zacznij od minimum i maksimum każdej zmiennej; wynik spoza skali (np. kod 99) zdradza błąd albo niezdefiniowany brak danych, który trzeba zrekodować.
- Różnice w statystykach opisowych jako wnioski – to, że jedna grupa ma wyższą średnią, nie oznacza jeszcze różnicy w populacji; do tego służą testy i przedziały ufności.
Najczęstsze pytania
Co to jest statystyka opisowa?
To zestaw liczb, tabel i wykresów, które streszczają zebrane dane: liczebności i odsetki, typowy wynik, rozproszenie wyników i kształt rozkładu. Opisuje próbę i niczego nie uogólnia – wnioskowanie o populacji to zadanie statystyki indukcyjnej (przedziały ufności, testy).
Jakie statystyki opisowe podać w pracy?
Dla zmiennych nominalnych liczebności i odsetki, dla porządkowych medianę z kwartylami, a dla ilościowych średnią i odchylenie standardowe, często także zakres, skośność i kurtozę. Przy silnie skośnym rozkładzie dodaj medianę z kwartylami. Zawsze podaj N, a przy zmiennych z brakami – n.
Czym różnią się miary tendencji centralnej od miar rozproszenia?
Miary tendencji centralnej (średnia, mediana, dominanta) mówią, jaki wynik jest typowy. Miary rozproszenia (odchylenie standardowe, wariancja, rozstęp ćwiartkowy) – jak bardzo wyniki różnią się od siebie. Do opisu zmiennej potrzebujesz obu.
Jak policzyć statystyki opisowe w SPSS?
Użyj menu Analiza → Opis statystyczny: Częstości dla liczebności, odsetków, dominanty, mediany i kwartyli, Statystyki opisowe dla średniej, odchylenia standardowego, minimum, maksimum, skośności i kurtozy, a Eksploracja dla mediany, rozstępu ćwiartkowego i wykresów pudełkowych w grupach.
Jak policzyć statystyki opisowe w R?
Dla zmiennych ilościowych użyj psych::describe(dane, type = 2) – zwraca n, średnią, odchylenie standardowe, medianę, zakres, skośność i kurtozę liczone jak w SPSS. Dla zmiennych kategorialnych użyj table() i prop.table(), a kwartyle policzysz funkcją quantile().
Czy statystyki opisowe wystarczą do wniosków?
Nie. Pokazują, co wyszło w próbie, ale nie mówią, czy różnica lub związek wystąpiłyby w populacji. Do tego potrzebne są przedziały ufności i testy statystyczne, a także wielkości efektu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cain, M. K., Zhang, Z., & Yuan, K.-H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1 ● Otwarty dostęp
- Manikandan, S. (2011). Measures of central tendency: Median and mode. Journal of Pharmacology and Pharmacotherapeutics, 2(3), 214–215. https://doi.org/10.4103/0976-500X.83300 ● Otwarty dostęp: pełny tekst
- Mishra, P., Pandey, C. M., Singh, U., Gupta, A., Sahu, C., & Keshri, A. (2019). Descriptive statistics and normality tests for statistical data. Annals of Cardiac Anaesthesia, 22(1), 67–72. https://doi.org/10.4103/aca.ACA_157_18 ● Otwarty dostęp
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@article{cain2017univariate, author={Cain, Meghan K. and Zhang, Zhiyong and Yuan, Ke-Hai}, title={{Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={5}, pages={1716--1735}, doi={10.3758/s13428-016-0814-1}}@article{manikandan2011median, author={Manikandan, S.}, title={{Measures of central tendency: Median and mode}}, journal={Journal of Pharmacology and Pharmacotherapeutics}, year={2011}, volume={2}, number={3}, pages={214--215}, doi={10.4103/0976-500x.83300}}@article{mishra2019descriptive, author={Mishra, Prabhaker and Pandey, Chandra M. and Singh, Uttam and Gupta, Anshul and Sahu, Chinmoy and Keshri, Amit}, title={{Descriptive statistics and normality tests for statistical data}}, journal={Annals of Cardiac Anaesthesia}, year={2019}, volume={22}, number={1}, pages={67--72}, doi={10.4103/aca.aca_157_18}}@article{stevens1946theory, author={Stevens, S. S.}, title={{On the theory of scales of measurement}}, journal={Science}, year={1946}, volume={103}, number={2684}, pages={677--680}, doi={10.1126/science.103.2684.677}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}