Co to jest obserwacja odstająca?
Obserwacja odstająca (wartość odstająca, ang. outlier) to wynik, który wyraźnie odbiega od pozostałych obserwacji w danych (Aguinis i in., 2013). Może to być czas reakcji kilka razy dłuższy niż u innych osób, wiek 47 lat w grupie dwudziestolatków albo profil odpowiedzi, który nie pasuje do reszty próby. Obserwacje odstające mają duży wpływ na wskaźniki oparte na wszystkich wynikach, takie jak średnia, odchylenie standardowe czy współczynnik korelacji, dlatego ich sprawdzenie należy do podstaw statystyki opisowej i przygotowania danych.
Każda definicja musi odpowiedzieć na pytanie: odstająca względem czego? Punktem odniesienia może być rozkład jednej zmiennej, chmura punktów kilku zmiennych albo model statystyczny. Leys i in. (2019) proponują dlatego definicję funkcjonalną: obserwacje odstające to obserwacje o dużych resztach, czyli dużych odległościach od wartości przewidywanych przez model – a najprostszym modelem jest sama średnia. Jednej uzgodnionej definicji jednak nie ma. Aguinis i in. (2013) znaleźli w literaturze 14 różnych definicji, 39 technik wykrywania i 20 sposobów postępowania z obserwacjami odstającymi.
Rodzaje obserwacji odstających
Ze względu na źródło
- Błędne – powstały przez pomyłkę: przy wpisywaniu, kodowaniu, eksporcie danych albo przez usterkę sprzętu (wiek 223 lata, kod braku danych 99 potraktowany jak wynik). Leys i in. (2019) zalecają je poprawiać, a gdy to niemożliwe – usuwać.
- Interesujące – prawdziwe wyniki osób, które z jakiegoś powodu różnią się od reszty, np. nie zrozumiały instrukcji albo należą do innej populacji. Mogą być ciekawym tropem badawczym.
- Losowe – rzadkie, ale prawidłowe wyniki z ogona rozkładu. W dużej próbie zawsze się pojawiają.
- Wpływowe – obserwacje, które same zmieniają wynik analizy, np. nachylenie linii regresji. Aguinis i in. (2013) proponują dla obserwacji błędnych, interesujących i wpływowych osobne ścieżki decyzji.
W praktyce obserwacji interesujących i losowych zwykle nie da się od siebie odróżnić, więc Leys i in. (2019) radzą traktować je tak samo. Obserwacja odstająca nie jest automatycznie błędem – i odwrotnie: błąd mieszczący się w typowym zakresie, np. wiek 32 zamiast 23 lat, nie odstaje i żadna metoda go nie wykryje.
Ze względu na to, gdzie odstaje
Rysunek 1 pokazuje trzy sytuacje. W pierwszej wynik jest skrajny w jednej zmiennej. W drugiej oba wyniki osoby są zwyczajne, ale ich połączenie jest nietypowe: wyniki z wynoszą 1.38 i −1.86, a mimo to odległość Mahalanobisa D² = 16.20 jest ponad dwa razy większa niż u kogokolwiek innego (najwyżej 6.54). W trzeciej obserwacja leży daleko od pozostałych w predyktorze i nie pasuje do trendu, przez co sama zmienia nachylenie linii regresji z 1.74 na 0.52.
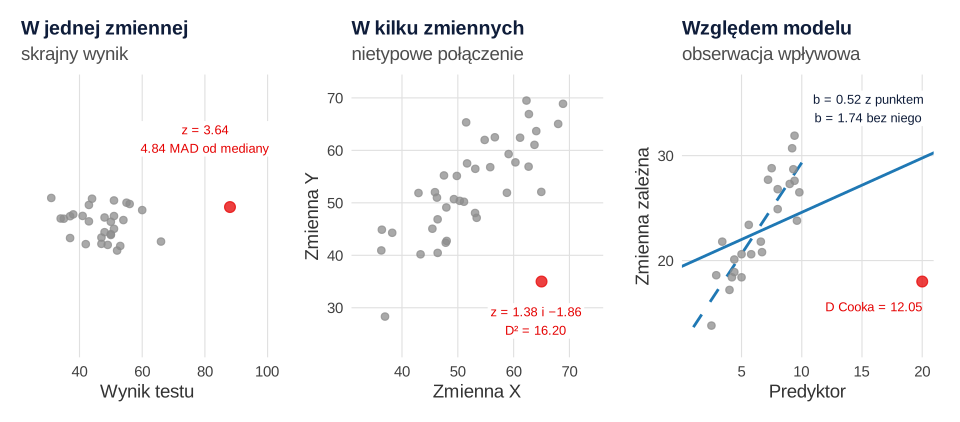
- Jednowymiarowa – skrajny wynik w jednej zmiennej; widać ją na histogramie i wykresie pudełkowym.
- Wielowymiarowa – nietypowe połączenie wyników kilku zmiennych; wykrywa ją odległość Mahalanobisa, a w dwóch wymiarach także wykres rozrzutu.
- Względem modelu – obserwacja o dużej reszcie, dużej dźwigni (nietypowym predyktorze) albo dużym wpływie na współczynniki regresji; ocenia się ją na podstawie reszt i odległości Cooka.
Przykład: wiek uczestników badania
W badaniu wzięło udział 15 studentów. W bazie wieku znalazły się dwie nietypowe wartości: 223 i 47 lat. Najpierw sprawdzamy zakres – 223 lata to oczywisty błąd. Po zajrzeniu do papierowej ankiety okazało się, że osoba wpisała 22 lata, więc wartość poprawiamy. Wiek 47 lat jest natomiast prawdziwy: jedna osoba podjęła studia później. Tabela pokazuje statystyki w trzech wersjach danych.
| Wersja danych | n | M | SD | Mdn | MAD |
|---|---|---|---|---|---|
| Z błędem (223 lata) | 15 | 36.87 | 51.92 | 22 | 1.48 |
| Po korekcie błędu (22 lata) | 15 | 23.47 | 6.70 | 22 | 1.48 |
| Po korekcie, bez osoby w wieku 47 lat | 14 | 21.79 | 1.63 | 22 | 1.48 |
Z przykładu płyną trzy wnioski:
- Jedna wartość zniekształca średnią i SD, ale nie medianę. Błąd podniósł średni wiek z 23.47 do 36.87 lat, a odchylenie standardowe z 6.70 do 51.92. Mediana (22) i medianowe odchylenie bezwzględne MAD (1.48) pozostały bez zmian.
- Jedna obserwacja odstająca może ukryć inną. Przy błędnej wartości w danych wynik z osoby w wieku 47 lat wynosił tylko 0.20, bo SD było ogromne. Po korekcie błędu wzrósł do 3.51. To zjawisko maskowania – dlatego Leys i in. (2013) odradzają kryterium „średnia ± 3 SD” i zalecają medianę z MAD. Według tego kryterium wiek 47 lat leży 16.86 MAD od mediany, daleko poza granicami 17.55–26.45 lat.
- Odstająca nie znaczy błędna. Wiek 47 lat jest prawdziwy, więc zostaje w danych. Zmienia się tylko sposób opisu: zamiast średniej i SD lepiej podać medianę, rozstęp ćwiartkowy i pełny zakres wieku.
Jak wykryć obserwację odstającą?
Van den Broeck i in. (2005) opisują czyszczenie danych jako powtarzany cykl przesiewu, diagnozy i edycji, oparty na regułach ustalonych z góry. Zacznij od kontroli zakresu i błędów, a dopiero potem stosuj kryteria statystyczne.
| Metoda | Kiedy | Uwagi |
|---|---|---|
| Kontrola zakresu i kodów braków danych | Zawsze, na początku | Wykrywa błędy, a nie obserwacje odstające (zob. braki danych) |
| Mdn ± 3 MAD | Jedna zmienna | Kryterium odporne, zalecane przez Leysa i in. (2019) |
| Płoty Tukeya (1.5 × IQR) | Jedna zmienna, wykres pudełkowy | Odporne; opis w haśle o rozstępie ćwiartkowym |
| M ± 3 SD | Tylko dla porównania | Podatne na maskowanie (zob. reguła trzech sigm) |
| Odległość Mahalanobisa (najlepiej odporna, MCD) | Kilka zmiennych naraz | Próg z rozkładu χ² o liczbie stopni swobody równej liczbie zmiennych |
| Reszty, dźwignia, odległość Cooka | Modele regresji | Ocena wpływu obserwacji na wynik modelu |
Całą procedurę – z przykładami, rysunkami i kodem dla każdej z tych metod – opisujemy we wpisie wartości odstające: jak je wykryć i co z nimi zrobić.
Co zrobić z obserwacją odstającą?
Błędy popraw albo usuń, a prawdziwe wyniki zostaw lub wyklucz – ale tylko według reguły zapisanej przed analizą, najlepiej w prerejestracji. Leys i in. (2019) zalecają, by przy braku prerejestracji podawać wyniki z obserwacjami odstającymi i bez nich. Decyzja podjęta po obejrzeniu wyników jest ryzykowna: Bakker i Wicherts (2014) pokazali, że usuwanie obserwacji odstających według popularnych progów z przed testem t silnie zawyża błąd I rodzaju, zwłaszcza gdy badacz dobiera próg do wyniku. Alternatywą dla usuwania są metody odporne, np. test Yuena dla średnich przyciętych albo test Manna-Whitneya.
Jak opisać obserwacje odstające w pracy (APA)
Napisz, jak szukano obserwacji odstających, ile ich znaleziono, co z nimi zrobiono i dlaczego. Opis dla przykładu z wiekiem:
Gdy wykluczasz osoby z analizy, podaj ich liczbę w każdej grupie i liczebność próby po wykluczeniach, a w analizie wrażliwości – wyniki z pełnej próby. Wiek uczestników zwykle opisuje się w charakterystyce próby; przy jednej nietypowej osobie podaj zawsze pełny zakres wieku, czyli wartość najmniejszą i największą (zob. rozstęp).
Przykład w R
Kod odtwarza przykład z wiekiem: sprawdza zakres, porównuje statystyki przed korektą błędu i po niej oraz odległość dwóch nietypowych wartości od środka danych w jednostkach SD i MAD. Funkcja mad() domyślnie mnoży medianę odchyleń bezwzględnych przez 1.4826.
Wpływ obserwacji odstających i kryterium MAD
R
wiek <- c(19, 20, 20, 21, 21, 21, 22, 22, 22, 23, 23, 24, 25, 47, 223)   # wiek 15 uczestników
range(wiek)                                       # kontrola zakresu: 223 lata to błąd
wiek_kor <- replace(wiek, wiek == 223, 22)        # korekta po sprawdzeniu papierowej ankiety
opis <- function(x) round(c(M = mean(x), SD = sd(x), Mdn = median(x), MAD = mad(x)), 2)
rbind(z_bledem = opis(wiek), po_korekcie = opis(wiek_kor), bez_47 = opis(wiek_kor[wiek_kor != 47]))

# odległość od środka: wynik z (z błędem i po korekcie) oraz liczba MAD od mediany
z_bledem <- (wiek - mean(wiek)) / sd(wiek)
z_kor    <- (wiek_kor - mean(wiek_kor)) / sd(wiek_kor)
w_mad    <- (wiek_kor - median(wiek_kor)) / mad(wiek_kor)
round(data.frame(wiek, z_bledem, z_kor, w_mad)[wiek %in% c(47, 223), ], 2)
median(wiek_kor) + c(-3, 3) * mad(wiek_kor)       # granice Mdn ± 3 MAD po korekcie
Wynik w R
[1]  19 223
                M    SD Mdn  MAD
z_bledem    36.87 51.92  22 1.48
po_korekcie 23.47  6.70  22 1.48
bez_47      21.79  1.63  22 1.48
   wiek z_bledem z_kor w_mad
14   47     0.20  3.51 16.86
15  223     3.58 -0.22  0.00
[1] 17.5522 26.4478
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork (dane do panelu środkowego wylosowano funkcją mvrnorm() z pakietu MASS). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Utożsamianie obserwacji odstającej z błędem. Prawdziwe, nietypowe wyniki należą do danych; usunięte bez powodu zaniżają zmienność i zawężają wnioski.
- Usuwanie błędów, które można poprawić. Zanim usuniesz wartość, sprawdź źródło – ankietę, plik z eksportu, dokumentację.
- Kryterium „średnia ± 3 SD” jako jedyna metoda. Jedna skrajna wartość potrafi zamaskować inne – w przykładzie wynik z osoby w wieku 47 lat wynosił 0.20.
- Decyzja po obejrzeniu wyników. Dobieranie progu do wyniku testu zawyża odsetek fałszywych alarmów (Bakker i Wicherts, 2014).
- Sprawdzanie tylko pojedynczych zmiennych. Nietypowe połączenie wyników jest niewidoczne w każdej zmiennej osobno.
- Brak informacji w pracy. Czytelnik powinien wiedzieć, ile obserwacji poprawiono lub wykluczono i według jakiej reguły.
Najczęstsze pytania
Co to jest obserwacja odstająca?
To wynik, który wyraźnie odbiega od pozostałych obserwacji – w jednej zmiennej (np. czas reakcji kilka razy dłuższy niż u innych), w połączeniu kilku zmiennych albo względem modelu, np. linii regresji. Jednej uzgodnionej definicji nie ma: Aguinis i in. (2013) znaleźli w literaturze 14 definicji obserwacji odstających.
Czy obserwacja odstająca to błąd?
Nie zawsze. Bywa błędem wpisywania lub kodowania (wiek 223 lata), ale może być też prawdziwym, nietypowym wynikiem – jak wiek 47 lat w grupie studentów. Błędy poprawiaj albo usuwaj, a prawdziwe wyniki zostawiaj lub wykluczaj tylko według reguły ustalonej przed analizą.
Jak wykryć obserwację odstającą?
Najpierw sprawdź zakres i kody braków danych. W jednej zmiennej użyj kryterium mediana ± 3 MAD albo płotów Tukeya 1.5 × IQR, w kilku zmiennych – odległości Mahalanobisa, a w regresji – reszt, dźwigni i odległości Cooka. Kryterium „średnia ± 3 SD” jest podatne na maskowanie.
Czym różni się obserwacja odstająca od wpływowej?
Obserwacja odstająca odbiega od pozostałych danych, a wpływowa zmienia wynik analizy, np. nachylenie linii regresji. Nie każda obserwacja odstająca jest wpływowa: punkt daleko od pozostałych, ale zgodny z trendem, nie zmienia współczynników. Wpływ mierzy się zwykle odległością Cooka.
Czy można usunąć obserwacje odstające z analizy?
Tak, jeśli to błędy, których nie da się poprawić, albo jeśli tak przewiduje reguła zapisana przed analizą. Podaj liczbę usuniętych obserwacji i powody, a gdy reguły nie zapisano wcześniej – przedstaw wyniki z obserwacjami odstającymi i bez nich (Leys i in., 2019). Alternatywą są metody odporne na wartości odstające.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikCzy można usunąć obserwacje odstające?
Kiedy usunięcie wyniku jest uzasadnione, a kiedy staje się manipulacją: tabela decyzji, analiza wrażliwości w R i gotowy opis do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aguinis, H., Gottfredson, R. K., & Joo, H. (2013). Best-practice recommendations for defining, identifying, and handling outliers. Organizational Research Methods, 16(2), 270–301. https://doi.org/10.1177/1094428112470848
- Bakker, M., & Wicherts, J. M. (2014). Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations. Psychological Methods, 19(3), 409–427. https://doi.org/10.1037/met0000014
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
- Van den Broeck, J., Argeseanu Cunningham, S., Eeckels, R., & Herbst, K. (2005). Data cleaning: Detecting, diagnosing, and editing data abnormalities. PLoS Medicine, 2(10), Article e267. https://doi.org/10.1371/journal.pmed.0020267 ● Otwarty dostęp
Cytowania BibTeX
@article{aguinis2013best, author={Aguinis, Herman and Gottfredson, Ryan K. and Joo, Harry}, title={{Best-practice recommendations for defining, identifying, and handling outliers}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={2}, pages={270--301}, doi={10.1177/1094428112470848}}@article{bakker2014outlier, author={Bakker, Marjan and Wicherts, Jelte M.}, title={{Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations}}, journal={Psychological Methods}, year={2014}, volume={19}, number={3}, pages={409--427}, doi={10.1037/met0000014}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}@article{vandenbroeck2005data, author={Van den Broeck, Jan and Argeseanu Cunningham, Solveig and Eeckels, Roger and Herbst, Kobus}, title={{Data cleaning: Detecting, diagnosing, and editing data abnormalities}}, journal={PLoS Medicine}, year={2005}, volume={2}, number={10}, eid={e267}, doi={10.1371/journal.pmed.0020267}}