Co to jest odległość Mahalanobisa?
Odległość Mahalanobisa (ang. Mahalanobis distance; zwykle podaje się jej kwadrat, D²) mierzy, jak daleko profil wyników jednej osoby leży od środka danych w kilku zmiennych naraz – z uwzględnieniem ich wariancji i korelacji. Zaproponował ją w 1936 roku indyjski statystyk Prasanta Chandra Mahalanobis. W odróżnieniu od zwykłej odległości „w linii prostej”, czyli euklidesowej, uznaje za dalekie przede wszystkim nietypowe połączenia wyników, a nie wyniki, które są wysokie, ale zgodne z ogólnym wzorcem danych.
W psychologii odległość Mahalanobisa służy głównie do wykrywania wielowymiarowych obserwacji odstających przed regresją wieloraką, MANOVA czy modelowaniem równań strukturalnych. Przydaje się też przy szukaniu nieuważnych odpowiedzi w kwestionariuszach: Meade i Craig (2012) uwzględnili analizę wielowymiarowych obserwacji odstających wśród porównywanych przez siebie metod wykrywania takich odpowiedzi. Ta sama idea – odległość od środka grupy z uwzględnieniem kowariancji – stoi za klasyfikacją w analizie dyskryminacyjnej.
Wzór na odległość Mahalanobisa
- xi – wektor wyników osoby i w p zmiennych,
- x̄ – wektor średnich, czyli środek danych (centroid),
- S−1 – odwrotność macierzy kowariancji zmiennych,
- T – transpozycja (zamiana wektora kolumnowego na wierszowy).
Odwrotność macierzy kowariancji robi dwie rzeczy: dzieli odchylenia przez wariancje – jak przy wynikach z – i uwzględnia to, co wynika z korelacji między zmiennymi. Pomagają to zrozumieć dwa szczególne przypadki. Dla jednej zmiennej D² = z², czyli kwadrat wyniku standaryzowanego. Dla zmiennych nieskorelowanych D² to suma kwadratów wyników z. Dla dwóch zmiennych o korelacji r wzór można zapisać bez macierzy:
Gdy przy dodatniej korelacji oba wyniki odchylają się w tę samą stronę, składnik −2rz1z2 zmniejsza odległość. Gdy odchylają się w przeciwne strony – zwiększa ją. Samo D (pierwiastek z D²) można czytać jak liczbę odchyleń standardowych od środka, przy czym „odchylenie standardowe” jest tu różne w różnych kierunkach.
Intuicja: elipsy zamiast okręgów
Punkty o tej samej odległości euklidesowej od środka leżą na okręgu (gdy zmienne są wyrażone w wynikach z). Punkty o tej samej odległości Mahalanobisa leżą na elipsie wydłużonej wzdłuż korelacji, czyli tam, gdzie wyników jest najwięcej. Zgodnie z kierunkiem korelacji można więc oddalić się od średnich dalej, zanim wynik stanie się nietypowy. W poprzek korelacji granica nietypowości jest znacznie bliżej. Im silniejsza korelacja, tym bardziej wydłużone są elipsy – a przy zmiennych nieskorelowanych zamieniają się w okręgi.
Próg: rozkład χ² z liczbą stopni swobody równą liczbie zmiennych
Jeśli dane mają wielowymiarowy rozkład normalny, D² ma w przybliżeniu rozkład χ² z liczbą stopni swobody równą liczbie zmiennych p (a nie liczbie osób). Dla każdej osoby można więc obliczyć prawdopodobieństwo uzyskania tak dużej lub większej odległości, a jako granicę przyjąć wartość krytyczną χ² dla małego poziomu, zwykle p < .001. Taki próg (χ² dla p = .001) zalecają Leys i in. (2019).
| Liczba zmiennych (df) | 1 | 2 | 3 | 4 | 5 | 6 | 10 | 20 |
|---|---|---|---|---|---|---|---|---|
| Wartość krytyczna χ² dla p = .001 | 10.83 | 13.82 | 16.27 | 18.47 | 20.52 | 22.46 | 29.59 | 45.31 |
To tylko przybliżenie. Cain i in. (2017) stwierdzili, że 68% z 254 przeanalizowanych rozkładów wielowymiarowych z publikowanych badań odbiegało od normalności. Przy skośnych zmiennych albo pojedynczych pozycjach skali Likerta odsetek osób powyżej progu może się różnić od tego, co przewiduje rozkład χ². Dlatego wysokie D² traktuj jako sygnał do sprawdzenia, a nie automatyczny wyrok.
Przykład: lęk i objawy depresji
Grupa 150 studentów wypełniła skalę HADS, która daje wynik lęku i wynik objawów depresji (po 0–21 pkt; dane symulowane). Średnie wynoszą 8.05 i 4.58 pkt, odchylenia standardowe – 4.10 i 3.26, a korelacja r = .57. Porównajmy dwie osoby z tym samym wysokim wynikiem lęku, 17 pkt:
- osoba A ma 0 pkt w skali depresji – jej wyniki z wynoszą 2.181 i −1.405;
- osoba B ma 9 pkt w skali depresji – jej wyniki z wynoszą 2.181 i 1.356.
W linii prostej obie osoby leżą prawie tak samo daleko od środka: odległość euklidesowa w wynikach z wynosi 2.59 dla A i 2.57 dla B. Dla osoby A wzór daje jednak (przy r = .573):
Dla osoby B D² wynosi tylko 4.77. Osoba A przekracza wartość krytyczną χ²(2) = 13.82 (p < .001), osoba B – nie (p = .092). Wysoki lęk przy braku objawów depresji jest w tej grupie rzadkim połączeniem, a wysoki lęk z umiarkowanymi objawami depresji – typowym.
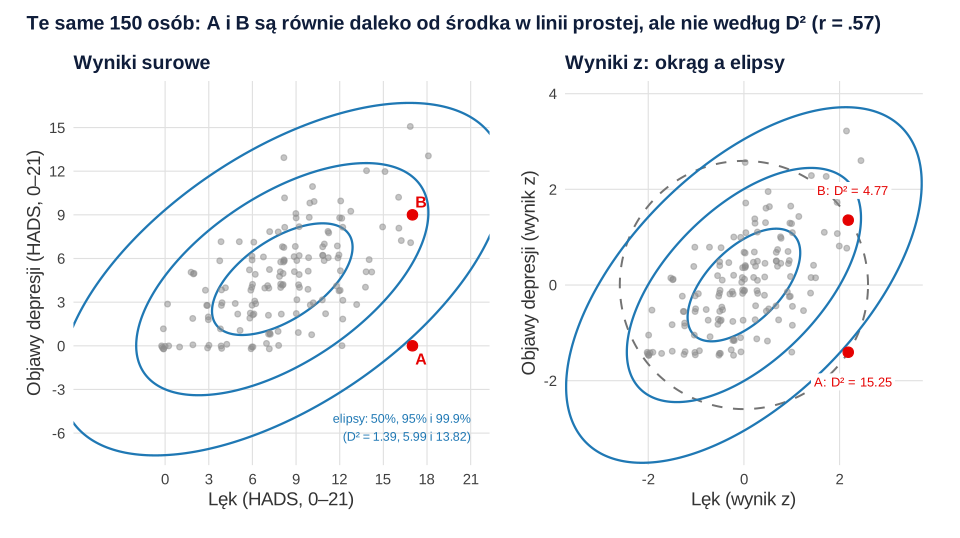
W całej próbie tylko osoba A przekroczyła próg dla p < .001. Osoba najbardziej oddalona od środka w linii prostej – z 17 pkt lęku i 15 pkt depresji, odległością euklidesową 3.87 – ma D² = 10.40, bo jej wyniki są wysokie, ale zgodne z korelacją. Wysokie D² osoby A nie oznacza błędu. To sygnał, by sprawdzić jej odpowiedzi i postąpić zgodnie z regułą ustaloną przed analizą.
Zastosowanie: przesiewanie danych
- Policz D² dla zmiennych, które wejdą do analizy – np. predyktorów regresji albo wszystkich pozycji kwestionariusza, gdy szukasz nieuważnych odpowiedzi. Przy 20 pozycjach próg dla p < .001 wynosi χ²(20) = 45.31; taki przykład opisujemy we wpisie nieuważne odpowiedzi w ankietach online.
- Użyj wersji odpornej. Klasyczne D² liczy się ze średnich i kowariancji, na które wpływają same obserwacje odstające. Jak pokazali Rousseeuw i van Zomeren (1990), kilka takich obserwacji może się przez to wzajemnie zamaskować. Rozwiązaniem jest estymator MCD (ang. minimum covariance determinant), który wyznacza środek i kowariancje z najbardziej zwartej części danych; szybki algorytm opisali Rousseeuw i Van Driessen (1999). Leys i in. (2019) zalecają wariant MCD75, w którym tę część tworzy 75% obserwacji. Przykład, w którym klasyczne D² nie wykrywa żadnej z dziesięciu nietypowych osób, a MCD wykrywa wszystkie, znajdziesz w poradniku wartości odstające: jak je wykryć i co z nimi zrobić.
- Obejrzyj profile oznaczonych osób i zdecyduj według reguły ustalonej z góry: wykluczenie, pozostawienie albo analiza wrażliwości.
W regresji odległość Mahalanobisa liczona dla predyktorów jest ściśle związana z dźwignią: hi = 1/n + D²i/(n − 1). Gdyby lęk i depresja były predyktorami, osoba A miałaby dźwignię h = 0.109. Dźwignia to jednak tylko połowa obrazu – to, czy obserwacja rzeczywiście zmienia wyniki modelu, pokazuje odległość Cooka.
Jak opisać w pracy (APA)
Podaj zmienne, dla których liczono D², próg i jego uzasadnienie, liczbę oznaczonych osób i decyzję. Opis dla przykładu:
Jeśli użyłeś wersji odpornej, dopisz: „odległość obliczono na podstawie odpornych oszacowań średnich i kowariancji (MCD75, pakiet robustbase w R)”.
Przykład w R
Kod liczy D² funkcją mahalanobis(), prawdopodobieństwo z rozkładu χ², sprawdza wynik osoby A wzorem dla dwóch zmiennych i powtarza analizę w wersji odpornej. W SPSS klasyczne D² zapiszesz w menu Analiza → Regresja → Liniowa: jako zmienną zależną wstaw dowolną zmienną (np. numer osoby), jako niezależne – zmienne do sprawdzenia, a w oknie Save zaznacz Mahalanobis. Zmienna MAH_1 to D²; prawdopodobieństwo policzysz wyrażeniem 1 - CDF.CHISQ(MAH_1, 2).
D², wartość p i wersja odporna (MCD)
R
library(MASS); library(robustbase)
set.seed(48)
S <- matrix(c(4^2, .55 * 4 * 3.5, .55 * 4 * 3.5, 3.5^2), 2)
X <- round(mvrnorm(148, mu = c(8, 4.5), Sigma = S))         # lęk i depresja (HADS, 0–21)
X <- pmin(pmax(X, 0), 21)
X <- rbind(X, A = c(17, 0), B = c(17, 9))                   # dwie osoby z przykładu
colnames(X) <- c("lek", "depresja")
round(c(colMeans(X), sd = apply(X, 2, sd), r = cor(X)[1, 2]), 3)

D2 <- mahalanobis(X, center = colMeans(X), cov = cov(X))   # D² każdej osoby
p  <- pchisq(D2, df = ncol(X), lower.tail = FALSE)          # df = liczba zmiennych
round(cbind(X, D2, p)[c("A", "B"), ], 4)
sum(D2 > qchisq(.999, df = 2))                              # ile osób powyżej progu (p < .001)

# to samo ręcznie dla osoby A: wyniki z i korelacja
z <- scale(X)["A", ]; r <- cor(X)[1, 2]
round(c(z, D2_recznie = (z[[1]]^2 + z[[2]]^2 - 2 * r * z[[1]] * z[[2]]) / (1 - r^2)), 2)

# wariant odporny: środek i kowariancje z MCD75
mcd <- covMcd(X, alpha = .75)
which(mahalanobis(X, mcd$center, mcd$cov) > qchisq(.999, df = 2))
Wynik w R
        lek    depresja      sd.lek sd.depresja           r
      8.053       4.580       4.102       3.259       0.573
  lek depresja      D2      p
A  17        0 15.2490 0.0005
B  17        9  4.7731 0.0919
[1] 1
       lek   depresja D2_recznie
      2.18      -1.41      15.25
  A
149
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- robustbase (wersja 0.99-7): Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L., & Anna di Palma, M. (2026). robustbase: Basic robust statistics [R package]. http://robustbase.r-forge.r-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Porównywanie D z progiem dla D² (albo odwrotnie). Wartości krytyczne χ² dotyczą kwadratu odległości; SPSS zapisuje właśnie D².
- Stopnie swobody równe liczbie osób. Liczba stopni swobody to liczba zmiennych, dla których liczysz odległość.
- Automatyczne wykluczanie każdej osoby z dużym D². Rzadkie połączenie wyników nie jest błędem – najpierw obejrzyj odpowiedzi.
- Klasyczne D² przy kilku obserwacjach odstających. Mogą się wzajemnie maskować; użyj wersji odpornej (MCD).
- Zmienne liniowo zależne, np. wynik ogólny skali razem z jej pozycjami. Macierz kowariancji nie ma wtedy odwrotności i D² nie da się policzyć (zob. współliniowość).
- Ślepa wiara w próg χ². Przy danych dalekich od normalności odsetek osób powyżej progu jest inny niż teoretyczny (Cain i in., 2017).
Najczęstsze pytania
Co to jest odległość Mahalanobisa?
To miara tego, jak daleko wyniki osoby w kilku zmiennych leżą od średnich, z uwzględnieniem wariancji i korelacji zmiennych. W odróżnieniu od odległości euklidesowej uznaje za dalekie przede wszystkim nietypowe połączenia wyników – np. wysoki lęk przy braku objawów depresji, gdy zmienne są dodatnio skorelowane.
Jak obliczyć odległość Mahalanobisa?
Ze wzoru D² = (x − x̄)TS−1(x − x̄), gdzie S to macierz kowariancji. Dla dwóch zmiennych D² = (z1² + z2² − 2rz1z2) / (1 − r²). W R służy do tego funkcja mahalanobis(X, colMeans(X), cov(X)).
Jaki próg odległości Mahalanobisa przyjąć?
Najczęściej wartość krytyczną rozkładu χ² dla p < .001 z liczbą stopni swobody równą liczbie zmiennych: 13.82 dla dwóch zmiennych, 16.27 dla trzech, 45.31 dla dwudziestu. W R: qchisq(.999, df = p). Próg porównuj z D², a nie z jego pierwiastkiem.
Jak policzyć odległość Mahalanobisa w SPSS?
W menu Analiza → Regresja → Liniowa wstaw jako zmienną zależną dowolną zmienną (np. numer osoby), jako niezależne – zmienne do sprawdzenia, a w oknie Save zaznacz Mahalanobis. SPSS doda zmienną MAH_1 (D²), którą porównasz z wartością krytyczną χ² albo zamienisz na p wyrażeniem 1 - CDF.CHISQ(MAH_1, k).
Co to jest odporna odległość Mahalanobisa (MCD)?
To odległość liczona ze średnich i kowariancji oszacowanych na najbardziej zwartej części danych, np. 75% obserwacji (MCD75). Klasyczne D² może przeoczyć kilka obserwacji odstających, które wspólnie zawyżają kowariancje (maskowanie). Wersję odporną zalecają Leys i in. (2019); w R policzysz ją funkcją covMcd() z pakietu robustbase.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikWykrywanie nietypowych transakcji
Karty podarunkowe, 10 sprawdzeń dziennie: Mahalanobis klasyczny i odporny, LOF, las losowy, maskowanie i nowy wzorzec nadużyć – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cain, M. K., Zhang, Z., & Yuan, K.-H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1 ● Otwarty dostęp
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
- Meade, A. W., & Craig, S. B. (2012). Identifying careless responses in survey data. Psychological Methods, 17(3), 437–455. https://doi.org/10.1037/a0028085
- Rousseeuw, P. J., & Van Driessen, K. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
- Rousseeuw, P. J., & van Zomeren, B. C. (1990). Unmasking multivariate outliers and leverage points. Journal of the American Statistical Association, 85(411), 633–639. https://doi.org/10.1080/01621459.1990.10474920
Cytowania BibTeX
@article{cain2017univariate, author={Cain, Meghan K. and Zhang, Zhiyong and Yuan, Ke-Hai}, title={{Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={5}, pages={1716--1735}, doi={10.3758/s13428-016-0814-1}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}@article{meade2012identifying, author={Meade, Adam W. and Craig, S. Bartholomew}, title={{Identifying careless responses in survey data}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={437--455}, doi={10.1037/a0028085}}@article{rousseeuw1999fast, author={Rousseeuw, Peter J. and Van Driessen, Katrien}, title={{A fast algorithm for the minimum covariance determinant estimator}}, journal={Technometrics}, year={1999}, volume={41}, number={3}, pages={212--223}, doi={10.1080/00401706.1999.10485670}}@article{rousseeuw1990unmasking, author={Rousseeuw, Peter J. and van Zomeren, Bert C.}, title={{Unmasking multivariate outliers and leverage points}}, journal={Journal of the American Statistical Association}, year={1990}, volume={85}, number={411}, pages={633--639}, doi={10.1080/01621459.1990.10474920}}