Co to jest odległość Cooka?
Odległość Cooka (ang. Cook’s distance, oznaczana D) mierzy, jak bardzo zmieniłby się cały model regresji, gdyby usunąć z danych jedną obserwację. Duża wartość D oznacza obserwację wpływową: taką, od której wyraźnie zależą współczynniki i przewidywania modelu. Cook (1977) zaproponował tę miarę na podstawie obszarów ufności dla współczynników i pokazał, że łączy ona informację o reszcie studentyzowanej z informacją o wariancji reszt i wartości przewidywanych – czyli o dźwigni obserwacji.
Odległość Cooka to jedno z narzędzi diagnostyki regresji liniowej. Reszty mówią, które obserwacje są źle przewidywane, VIF – czy predyktory się nie dublują (współliniowość), a test Durbina-Watsona – czy reszty kolejnych pomiarów nie są skorelowane. Odległość Cooka odpowiada na inne pytanie: czy wynik zależy od pojedynczej osoby? Obserwacja odstająca nie musi być wpływowa, a wpływowa nie musi mieć wyjątkowo dużej reszty.
Wzór: reszta razy dźwignia
- ri – reszta studentyzowana wewnętrznie obserwacji i (w R:
rstandard()), czyli to, jak bardzo wynik odbiega od przewidywania; - hii – dźwignia: jak nietypowe są wartości predyktorów tej obserwacji; średnia dźwignia wynosi p/n, a dźwignia rośnie razem z odległością Mahalanobisa od środka rozkładu predyktorów;
- p – liczba parametrów modelu razem ze stałą.
Równoważna postać mówi wprost, co mierzy D: sumę kwadratów zmian wszystkich wartości przewidywanych po usunięciu obserwacji i, podzieloną przez p × s². Wpływ pojawia się więc dopiero wtedy, gdy duża reszta spotyka się z dużą dźwignią: w metodzie najmniejszych kwadratów punkt o skrajnej wartości predyktora działa jak długie ramię dźwigni i „przyciąga” prostą, o ile leży daleko od niej. Osoba o przeciętnych wartościach predyktorów może mieć dużą resztę i prawie nie zmieniać prostej; osoba o skrajnej wartości predyktora, która leży blisko prostej, także nie jest groźna. Cook (1979) pokazuje, że usunięcie jednej obserwacji może istotnie zmienić analizę: testy F, reszty studentyzowane i oszacowania współczynników.
Progi 4/n i 1 – heurystyki, nie testy
| Kryterium | W przykładzie (n = 60, p = 2) | Jak traktować |
|---|---|---|
| D > 4/n | 0.067 – przekraczają je 2 osoby | Liberalne sito: wskazuje obserwacje do obejrzenia, nie do usunięcia |
| D ≥ mediana rozkładu F(p, n − p) | 0.70 | Usunięcie obserwacji przesuwa współczynniki na brzeg 50% obszaru ufności |
| D > 1 | 1 – przekracza go 1 osoba | Silny wpływ; koniecznie sprawdź dane i pokaż analizę wrażliwości |
| Wyraźna luka | 1.06 wobec 0.086 dla kolejnej osoby | Jedna wartość odstaje od pozostałych D – często najbardziej przydatna wskazówka |
Żaden z tych progów nie jest testem statystycznym. Aguinis i in. (2013) w przeglądzie literatury metodologicznej naliczyli 39 technik identyfikowania obserwacji odstających i 20 sposobów postępowania z nimi, a w badaniach empirycznych – niespójność i brak przejrzystości. Pokazali też, że różne decyzje w tej sprawie potrafią zmienić wnioski merytoryczne. Dlatego kryterium i sposób postępowania określ przed analizą – najlepiej w prerejestracji, jak zalecają Leys i in. (2019).
Przykład: media społecznościowe a poczucie samotności
Sześćdziesięcioro studentów (dane symulowane) podało, ile godzin dziennie spędza w mediach społecznościowych, i wypełniło skalę poczucia samotności (20–80). Osoba 60 podała 9 godzin dziennie przy niskim poczuciu samotności (34 punkty), a pozostałe osoby – od 1 do 6.1 godziny. W regresji prostej nachylenie wyniosło b = 1.47, 95% CI [−0.01, 2.95], p = .051, R² = .06.
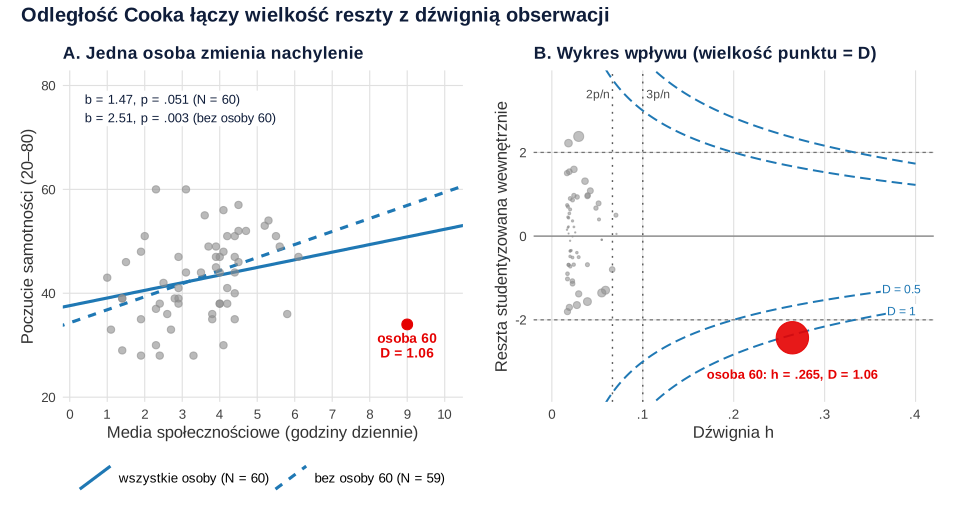
Diagnostyka wskazuje jedną wyraźnie wpływową obserwację. Osoba 60 ma dźwignię h = .265, ośmiokrotnie wyższą od średniej (p/n = 2/60), resztę studentyzowaną −2.54 i odległość Cooka D = 1.06. Kolejna największa wartość to zaledwie 0.086 – ma ją osoba 22, która ma podobnie dużą resztę (2.49), ale typową liczbę godzin (h = .030); jej usunięcie zmienia nachylenie tylko z 1.47 na 1.67. Z kolei osoba 36 (6.1 godziny) ma drugą co do wielkości dźwignię (h = .071), ale leży blisko prostej, więc jej D jest bliskie zera. To dobrze pokazuje, że o wpływie decyduje połączenie reszty i dźwigni.
Bez osoby 60 nachylenie rośnie do b = 2.51, 95% CI [0.88, 4.15], p = .003, R² = .14. DFBETA dla nachylenia wynosi −1.04: obecność tej jednej osoby obniża nachylenie o 1.04 punktu na godzinę. Wniosek o istotności związku zależy więc od jednej osoby. Co z tym zrobić?
- Sprawdź, czy to błąd. Porównaj odpowiedź z oryginalnym kwestionariuszem i innymi pytaniami (np. o czas w tygodniu). Błąd wprowadzania popraw, jeśli masz na to dowód – nie „na oko”.
- Jeśli wynik jest prawdziwy, zostaw go w danych i pokaż analizę wrażliwości: wyniki z obserwacją i bez niej. Bollen i Jackman (1985) przypominają, że diagnostyki nie wolno stosować mechanicznie, a usunięcie obserwacji to skrajny środek ostateczny – ważniejsze jest pytanie, dlaczego jest wpływowa.
- Zastanów się nad modelem. Wpływowa obserwacja na krańcu zakresu bywa sygnałem, że związek nie jest liniowy albo że osoby korzystające z mediów bardzo intensywnie różnią się od reszty próby – a próba ma za mało takich osób, by to ocenić (zob. regresja krzywoliniowa).
Jak opisać obserwacje wpływowe w pracy (APA)
W metodach podaj przyjęte kryterium, a w wynikach – co wykazała diagnostyka i jak wyglądają wyniki z obserwacją wpływową i bez niej. Wzór dla przykładu:
Więcej o wykrywaniu i raportowaniu nietypowych wyników – także jednozmiennowych i wielozmiennowych – piszemy w poradniku wartości odstające: jak je wykryć i co z nimi zrobić oraz w haśle obserwacja odstająca. Miejsce diagnostyki wpływu w całej analizie regresji pokazujemy w poradniku regresja wieloraka krok po kroku.
Przykład w R i SPSS
Kod tworzy dane z przykładu, liczy odległość Cooka, dźwignię i reszty studentyzowane, porównuje je z progami, odtwarza D ze wzoru i wykonuje analizę wrażliwości. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Odległość Cooka, dźwignia i analiza wrażliwości
R
suppressPackageStartupMessages(library(car))   # influencePlot()

# Dane symulowane: N = 60 studentów; czas w mediach społecznościowych (godziny dziennie)
# i poczucie samotności (20–80)
set.seed(3756)
n <- 60
godziny   <- round(pmin(pmax(rnorm(n, 3.2, 1.3), 0.5), 7.5), 1)
samotnosc <- round(pmin(pmax(36 + 2.4 * godziny + rnorm(n, sd = 7.5), 20), 80))
godziny[60] <- 9; samotnosc[60] <- 34      # osoba 60: 9 godzin dziennie i niska samotność
dane <- data.frame(godziny, samotnosc)

model <- lm(samotnosc ~ godziny, data = dane)
round(summary(model)$coefficients, 3)

# Odległość Cooka, dźwignia i reszta studentyzowana – cztery największe D
dane$D <- cooks.distance(model)
dane$h <- hatvalues(model)
dane$t <- rstudent(model)
round(head(dane[order(-dane$D), ], 4), 3)
p <- length(coef(model))                    # liczba parametrów (ze stałą)
round(c(prog_4_n = 4 / n, mediana_F = qf(0.5, p, n - p), liczba_D_powyzej_4_n = sum(dane$D > 4 / n)), 3)

# Ten sam wynik ze wzoru: D = r^2 / p * h / (1 - h)
r <- rstandard(model)[60]; h <- hatvalues(model)[60]
round(unname(r^2 / p * h / (1 - h)), 3)

# Analiza wrażliwości: nachylenie z osobą 60 i bez niej (DFBETA = różnica nachyleń)
model_bez <- update(model, data = dane[-60, ])
round(dfbeta(model)[60, "godziny"], 3)
round(rbind(z_osoba_60   = c(b = unname(coef(model)[2]), confint(model)[2, ], p = summary(model)$coefficients[2, 4]),
            bez_osoby_60 = c(b = unname(coef(model_bez)[2]), confint(model_bez)[2, ], p = summary(model_bez)$coefficients[2, 4])), 3)
round(c(R2_z = summary(model)$r.squared, R2_bez = summary(model_bez)$r.squared), 3)
round(coef(update(model, data = dane[-22, ]))[2], 3)   # dla porównania: nachylenie bez osoby 22

# Wykres wpływu: dźwignia, reszta studentyzowana i odległość Cooka (wypisuje też najbardziej nietypowe obserwacje)
influencePlot(model)
Wynik w R
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   37.623      2.818  13.351    0.000
godziny        1.470      0.739   1.991    0.051
   godziny samotnosc     D     h      t
60     9.0        34 1.060 0.265 -2.540
22     2.3        60 0.086 0.030  2.486
24     1.4        29 0.054 0.055 -1.368
49     5.8        36 0.052 0.059 -1.300
            prog_4_n            mediana_F liczba_D_powyzej_4_n
               0.067                0.701                2.000
[1] 1.06
[1] -1.041
                 b  2.5 % 97.5 %     p
z_osoba_60   1.470 -0.008  2.949 0.051
bez_osoby_60 2.511  0.876  4.147 0.003
  R2_z R2_bez
 0.064  0.142
godziny
  1.673
       StudRes        Hat        CookD
22  2.48605282 0.02953533 0.0863372024
36  0.05176497 0.07108013 0.0001043145
60 -2.53968511 0.26453041 1.0603201382
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Automatyczne usuwanie wszystkiego powyżej 4/n. W przykładzie próg ten wskazuje też osobę 22, której usunięcie zmienia nachylenie pięć razy mniej niż usunięcie osoby 60. Próg 4/n służy do przeglądu, nie do czyszczenia danych.
- Usuwanie obserwacji, „bo wynik wtedy wychodzi istotny”. To decyzja zależna od wyniku, czyli p-hacking. Raportuj obie analizy.
- Mylenie obserwacji odstającej z wpływową. Duża reszta przy typowych wartościach predyktorów (osoba 22) nie zmienia prostej; o wpływie decyduje dopiero połączenie reszty z dźwignią.
- Usuwanie obserwacji jedna po drugiej. Po usunięciu najbardziej wpływowej obserwacji często kolejne przekraczają próg; ta pętla prowadzi do sztucznie „czystej” próby.
- Pomijanie dźwigni w modelach z małymi grupami. W modelu, którego jedynym predyktorem jest zmienna kategorialna (dummy coding), każda osoba z kategorii liczącej trzy osoby ma dźwignię 1/3 – jej wynik silnie wpływa na oszacowanie różnicy dla tej grupy.
- Brak informacji w pracy. Czytelnik musi wiedzieć, jakie kryterium przyjęto, ile obserwacji je spełniło i co z nimi zrobiono (Aguinis i in., 2013).
Najczęstsze pytania
Co to jest odległość Cooka?
To miara wpływu pojedynczej obserwacji na model regresji. Mówi, jak bardzo zmieniłyby się wszystkie wartości przewidywane (a więc i współczynniki), gdyby tę obserwację usunąć. Duże D mają obserwacje, które łączą dużą resztę z nietypowymi wartościami predyktorów.
Jaka wartość odległości Cooka jest za duża?
Popularne heurystyki to D > 4/n (liberalne sito do przeglądu), D większe od mediany rozkładu F(p, n − p) i D > 1 (silny wpływ). Żadna z nich nie jest testem. Najwięcej mówi często wyraźna luka – jedna wartość dużo większa od pozostałych.
Czy obserwację z dużą odległością Cooka trzeba usunąć?
Nie. Najpierw sprawdź, czy to błąd danych – błąd popraw, jeśli masz dowód. Prawdziwy wynik zostaw i pokaż wyniki z tą obserwacją i bez niej. Usunięcie jest środkiem ostatecznym (Bollen i Jackman, 1985), a decyzję najlepiej zaplanować przed analizą (Leys i in., 2019).
Czy każda obserwacja z dużą resztą ma duże D Cooka?
Obserwacja odstająca ma dużą resztę – jej wynik odbiega od przewidywania. Wpływowa zmienia model, co wymaga także dużej dźwigni. W przykładzie z tej strony osoba z resztą 2.49 i typową wartością predyktora miała D = 0.086, a osoba z resztą −2.54 i dźwignią .265 – D = 1.06.
Jak policzyć odległość Cooka w R i SPSS?
W R: cooks.distance(model), a wykres wpływu narysujesz funkcją car::influencePlot(model). W SPSS: Analiza → Regresja → Liniowa → Zapisz → Odległości: Cooka; program dopisze zmienną COO_1 do zbioru danych.
Co to jest dźwignia w regresji?
Dźwignia (h) mówi, jak nietypowe są wartości predyktorów danej obserwacji. Średnia dźwignia wynosi p/n, a wartości powyżej 2p/n lub 3p/n uznaje się za wysokie. Sama wysoka dźwignia nie oznacza wpływu – obserwacja leżąca blisko prostej regresji jej nie zmienia.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Obserwacje wpływowe – wizualizacja
Jedna osoba w sześciu miejscach wykresu, mapa wpływu, dźwignia i odległość Cooka, n = 20 vs 200 i 1000 badań – pięć rysunków z kodem R.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aguinis, H., Gottfredson, R. K., & Joo, H. (2013). Best-practice recommendations for defining, identifying, and handling outliers. Organizational Research Methods, 16(2), 270–301. https://doi.org/10.1177/1094428112470848
- Bollen, K. A., & Jackman, R. W. (1985). Regression diagnostics: An expository treatment of outliers and influential cases. Sociological Methods & Research, 13(4), 510–542. https://doi.org/10.1177/0049124185013004004
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D. (1979). Influential observations in linear regression. Journal of the American Statistical Association, 74(365), 169–174. https://doi.org/10.1080/01621459.1979.10481634 ● Otwarty dostęp: pełny tekst
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
Cytowania BibTeX
@article{aguinis2013best, author={Aguinis, Herman and Gottfredson, Ryan K. and Joo, Harry}, title={{Best-practice recommendations for defining, identifying, and handling outliers}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={2}, pages={270--301}, doi={10.1177/1094428112470848}}@article{bollen1985regression, author={Bollen, Kenneth A. and Jackman, Robert W.}, title={{Regression diagnostics: An expository treatment of outliers and influential cases}}, journal={Sociological Methods \& Research}, year={1985}, volume={13}, number={4}, pages={510--542}, doi={10.1177/0049124185013004004}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{cook1979influential, author={Cook, R. Dennis}, title={{Influential observations in linear regression}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={365}, pages={169--174}, doi={10.1080/01621459.1979.10481634}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}