Co to jest mediana?
Mediana (ang. median; w APA Mdn, w polskich podręcznikach także Me) to wartość środkowa uporządkowanego zbioru wyników: co najmniej połowa obserwacji jest od niej mniejsza lub jej równa i co najmniej połowa – większa lub równa. Jest drugim kwartylem (Q2) i 50. percentylem rozkładu. Obok średniej i dominanty to podstawowa miara tendencji centralnej.
Mediana nie jest zniekształcana przez wartości odstające ani skośność rozkładu i można ją wyznaczyć dla danych porządkowych, przedziałowych i ilorazowych. Ceną jest to, że nie wykorzystuje całej informacji zawartej w danych (Manikandan, 2011): liczy się porządek wyników, a nie ich odległości od siebie. W psychologii medianę podaje się najczęściej dla czasów reakcji, liczby objawów, długości terapii i odpowiedzi na pojedyncze pozycje kwestionariusza.
Jak obliczyć medianę? Nieparzysta i parzysta liczba wyników
Najpierw uporządkuj wyniki od najmniejszego do największego. Dalej postępowanie zależy od liczebności n:
n parzyste: Mdn = [x(n / 2) + x(n / 2 + 1)] / 2
gdzie x(k) oznacza k-ty wynik w uporządkowanym szeregu.
Nieparzyste n. Siedem osób uzyskało w zadaniu Stroopa średnie czasy reakcji 570, 531, 764, 583, 837, 732 i 652 ms. Po uporządkowaniu: 531, 570, 583, 652, 732, 764, 837. Środkowy jest czwarty wynik, bo (7 + 1) / 2 = 4, więc Mdn = 652 ms. Średnia tych samych wyników to 667 ms.
Parzyste n. Dołącza ósma osoba z czasem 496 ms: 496, 531, 570, 583, 652, 732, 764, 837. Środek wypada między czwartym a piątym wynikiem, więc Mdn = (583 + 652) / 2 = 617.5 ms. Mediana nie musi więc być wynikiem żadnej z badanych osób.
Odporność mediany na wartości skrajne
Największą zaletą mediany jest odporność. Rysunek 1 pokazuje, co się dzieje, gdy do 11 osób dołącza jedna z czasem 2400 ms – na przykład ktoś, kto w trakcie zadania odebrał telefon.
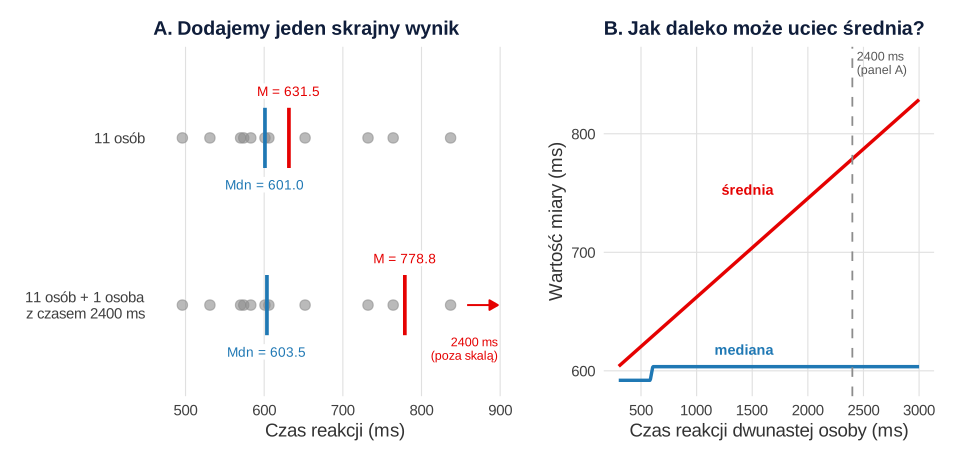
Bez tej osoby średnia wynosi 631.45 ms, a mediana 601.00 ms. Po jej dołączeniu średnia skacze do 778.83 ms, czyli o 147.38 ms, a mediana przesuwa się zaledwie o 2.50 ms – do 603.50 ms. Nowa średnia jest wyższa niż wyniki 10 z 11 pozostałych osób, więc przestaje opisywać grupę. Panel B uogólnia ten wynik: bez względu na to, czy dwunasta osoba ma 300, czy 3000 ms, mediana pozostaje w przedziale 592.0–603.5 ms, a średnia rośnie liniowo od 603.83 do 828.83 ms. Aby dowolnie przesunąć medianę, trzeba by zmienić aż połowę wyników; średnią przesunie jeden.
Ta sama logika stoi za odpornymi metodami wykrywania obserwacji odstających. Leys i in. (2013) krytykują popularną regułę „średnia ± 3 SD”, bo zarówno średnia, jak i SD same reagują na wartości odstające. Proponują w zamian kryterium oparte na medianie i medianowym odchyleniu bezwzględnym (MAD), czyli medianie odległości wyników od mediany. Dla 120 czasów reakcji z naszego przykładu MAD wynosi 68 ms, a po pomnożeniu przez stałą 1.4826 (tak domyślnie liczy funkcja mad() w R) – 100.82 ms.
Mediana a średnia w rozkładzie skośnym
W rozkładzie symetrycznym mediana i średnia są niemal równe. W rozkładzie skośnym średnia przesuwa się w stronę dłuższego ogona, a mediana leży zwykle między średnią a dominantą (Manikandan, 2011). W pełnej próbie 120 czasów reakcji mediana wynosi 594.50 ms, a średnia 644.71 ms – histogram tych danych pokazujemy w haśle o średniej. Nie traktuj jednak tej relacji jako testu skośności. Von Hippel (2005) pokazuje, że reguła „przy skośności prawostronnej średnia jest większa od mediany” często zawodzi, zwłaszcza w rozkładach dyskretnych, takich jak odpowiedzi na skali 1–5.
Mediana dla danych porządkowych i skali Likerta
Mediana wymaga tylko uporządkowania wyników, dlatego nadaje się do zmiennych mierzonych na skali porządkowej. Sullivan i Artino (2013) zalecają, by odpowiedzi na pojedyncze pozycje skali Likerta opisywać medianą i rozkładem częstości, bo są to dane porządkowe. Wynik całej skali, czyli sumę lub średnią wielu pozycji, można natomiast analizować metodami parametrycznymi.
W przykładzie te same 120 osób odpowiedziało na pozycję „Przed egzaminem czuję silny niepokój” (od 1 – zdecydowanie nie do 5 – zdecydowanie tak):
| Odpowiedź | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Liczba osób | 11 | 21 | 26 | 39 | 23 |
| Odsetek | 9.2% | 17.5% | 21.7% | 32.5% | 19.2% |
Mediana wynosi 4: co najmniej połowa osób (51.7%) zaznaczyła „4” albo „5”. Średnia 3.35 sugerowałaby odpowiedź „między 3 a 4”, której nie było w kafeterii. Przy parzystej liczbie osób dwie środkowe odpowiedzi mogą się różnić (np. 3 i 4) – mediana wynosi wtedy 3.5. To poprawny wynik, ale obok zawsze pokaż rozkład odpowiedzi. Zmiennej nominalnej medianą nie opiszesz – tam zostaje dominanta. Jeśli odpowiedzi pochodzą z formularza online, najpierw zakoduj je liczbowo (zob. dane z Google Forms i LimeSurvey w SPSS i R).
Jak opisać medianę w pracy (APA)
Medianę podawaj z miarą rozproszenia, która też jest odporna: z rozstępem ćwiartkowym (IQR = Q3 − Q1) albo z wartościami pierwszego i trzeciego kwartyla. Nie łącz mediany z odchyleniem standardowym. Przy kilku grupach dobrze sprawdza się wykres pudełkowy, który pokazuje mediany i kwartyle wszystkich grup naraz.
Gdy porównujesz grupy testem nieparametrycznym, np. testem Manna-Whitneya, podaj medianę i IQR w każdej grupie, ale nie opisuj wyniku jako „różnicy median”. Hart (2001) pokazuje, że test Manna-Whitneya nie jest testem median: wykrywa także różnice kształtu i rozproszenia rozkładów, dlatego opisz istotne cechy danych, a nie tylko wartość p.
Przykład w R
Kod odtwarza przykłady z tej strony: medianę dla nieparzystej i parzystej liczby wyników, efekt jednego skrajnego wyniku, kwartyle, IQR i MAD oraz medianę odpowiedzi na pozycję Likerta. W SPSS medianę i kwartyle otrzymasz w menu Analyze → Descriptive Statistics → Frequencies → Statistics (Median, Quartiles).
Mediana, kwartyle i MAD
R
set.seed(53)
rt <- round(rnorm(120, mean = 500, sd = 50) + rexp(120, rate = 1 / 150))     # czasy reakcji (ms)
likert <- sample(1:5, 120, replace = TRUE, prob = c(.08, .17, .22, .33, .20))  # pozycja 1–5
sort(rt[1:7]); median(rt[1:7])     # n nieparzyste: środkowy wynik
sort(rt[1:8]); median(rt[1:8])     # n parzyste: średnia dwóch środkowych
x11 <- rt[1:11]
round(c(M = mean(x11), Mdn = median(x11)), 2)                    # 11 osób
round(c(M = mean(c(x11, 2400)), Mdn = median(c(x11, 2400))), 2)  # + osoba z 2400 ms
round(c(Mdn = median(rt), Q1 = quantile(rt, 0.25, names = FALSE),
        Q3 = quantile(rt, 0.75, names = FALSE), IQR = IQR(rt), MAD = mad(rt)), 2)
table(likert)      # rozkład odpowiedzi na pozycję Likerta
median(likert)
Wynik w R
[1] 531 570 583 652 732 764 837
[1] 652
[1] 496 531 570 583 652 732 764 837
[1] 617.5
     M    Mdn
631.45 601.00
     M    Mdn
778.83 603.50
   Mdn     Q1     Q3    IQR    MAD
594.50 541.75 719.50 177.75 100.82
likert
 1  2  3  4  5
11 21 26 39 23
[1] 4
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://CRAN.R-project.org/package=patchwork
Najczęstsze błędy
- Szukanie środka w nieuporządkowanych danych – mediana to środkowy wynik po posortowaniu, a nie środkowy wiersz arkusza.
- Wybór jednego z dwóch środkowych wyników przy parzystym n – zgodnie z definicją liczymy ich średnią (w przykładzie 617.5 ms).
- Mediana z odchyleniem standardowym – medianę łącz z IQR lub kwartylami, a średnią z odchyleniem standardowym.
- „Test Manna-Whitneya wykazał różnicę median” – ten test porównuje całe rozkłady, nie tylko mediany (Hart, 2001).
- Sama mediana jako opis pozycji Likerta – dodaj rozkład odpowiedzi, jak zalecają Sullivan i Artino (2013); ta sama mediana może kryć bardzo różne rozkłady.
- Wykrywanie wartości odstających regułą „średnia ± 3 SD” – reguła sama jest wrażliwa na wartości odstające; odporniejsza jest mediana z MAD (Leys i in., 2013).
Najczęstsze pytania
Jak obliczyć medianę?
Uporządkuj wyniki od najmniejszego do największego. Przy nieparzystej liczbie wyników mediana to wynik środkowy, np. czwarty z siedmiu. Przy parzystej – średnia dwóch środkowych wyników, np. (583 + 652) / 2 = 617.5. W R: median(x).
Czym różni się mediana od średniej?
Średnia zależy od wartości każdego wyniku, a mediana tylko od ich porządku. Dlatego jeden skrajny wynik potrafi mocno przesunąć średnią, a medianę prawie wcale: w przykładzie czas 2400 ms podniósł średnią o 147.38 ms, a medianę o 2.50 ms. W rozkładzie symetrycznym obie miary są niemal równe.
Kiedy podawać medianę zamiast średniej?
Gdy rozkład jest wyraźnie skośny, gdy w danych są wartości skrajne oraz przy danych porządkowych, np. odpowiedziach na pojedynczą pozycję skali Likerta. Medianę podawaj z rozstępem ćwiartkowym. Przy rozkładach zbliżonych do symetrycznych zwykle lepsza jest średnia z odchyleniem standardowym.
Czy można liczyć medianę dla skali Likerta?
Tak – mediana wymaga tylko uporządkowania odpowiedzi, więc pasuje do danych porządkowych. Dla pojedynczych pozycji podaj medianę i rozkład odpowiedzi (Sullivan i Artino, 2013). Przy parzystej liczbie osób mediana może wynieść np. 3.5, jeśli dwie środkowe odpowiedzi to 3 i 4.
Jak zapisać medianę w APA?
Użyj skrótu Mdn pisanego kursywą i podaj miarę rozproszenia: Mdn = 594.50 ms (IQR = 177.75) albo Mdn = 594.50 ms (Q1 = 541.75, Q3 = 719.50). Nie łącz mediany z odchyleniem standardowym.
Czy mediana to drugi kwartyl?
Tak. Mediana to drugi kwartyl (Q2) i 50. percentyl: dzieli uporządkowane dane na dwie równe części. Pierwszy i trzeci kwartyl wyznaczają granice środkowych 50% wyników, a ich różnica to rozstęp ćwiartkowy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikRegresja kwantylowa krok po kroku
Model dla kilku τ, błędy standardowe, wykres współczynników w funkcji τ, test równości nachyleń i porównanie z MNK – na jednym przykładzie w R.
Czytaj →PoradnikCzas na stronie – skośne metryki
Portal z ofertami pracy: średnia, mediana i średnia geometryczna, Welch, logarytm, Mann–Whitney, bootstrap, boty i symulacja mocy – kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
- Manikandan, S. (2011). Measures of central tendency: Median and mode. Journal of Pharmacology and Pharmacotherapeutics, 2(3), 214–215. https://doi.org/10.4103/0976-500X.83300 ● Otwarty dostęp: pełny tekst
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
- von Hippel, P. T. (2005). Mean, median, and skew: Correcting a textbook rule. Journal of Statistics Education, 13(2). https://doi.org/10.1080/10691898.2005.11910556 ● Otwarty dostęp
Cytowania BibTeX
@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}@article{manikandan2011median, author={Manikandan, S.}, title={{Measures of central tendency: Median and mode}}, journal={Journal of Pharmacology and Pharmacotherapeutics}, year={2011}, volume={2}, number={3}, pages={214--215}, doi={10.4103/0976-500x.83300}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}@article{vonhippel2005mean, author={von Hippel, Paul T.}, title={{Mean, median, and skew: Correcting a textbook rule}}, journal={Journal of Statistics Education}, year={2005}, volume={13}, number={2}, doi={10.1080/10691898.2005.11910556}}