Przykład: portal z ogłoszeniami o pracę
Fikcyjny portal z ogłoszeniami o pracę testuje nową stronę oferty: w wersji B widełki płacowe i główne wymagania są na górze, a pełny opis rozwija się po kliknięciu. Przez 14 dni każdy użytkownik losowo trafia do wersji A albo B – to klasyczny test A/B. Dział produktu pyta: czy ludzie dłużej czytają oferty? Mierzymy czas na stronie oferty (s) i liczbę odsłon w sesji – dwie mocno skośne metryki.
System liczy czas jako odstęp między odsłonami, więc sesja z jedną odsłoną (odbicie) ma 0 s, a po 30 minutach bezczynności sesja się kończy (najwyżej 1800 s). Upraszczamy: jedna sesja to jeden użytkownik (gdy użytkownicy wracają, licz niepewność jak we wpisie wskaźniki ilorazowe w testach A/B).
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: 4000 sesji na wersję, odbicia 38% w A i 37% w B, lognormalny czas sesji zaangażowanych z medianą 75 s w A i o 6% dłuższą w B (odchylenie logarytmów 1.25), limit 1800 s i 22 sesje botów (4 w A, 18 w B). Boty to długie sesje z 60–240 odsłonami; nierówny podział jest realistyczny, bo jeden robot z jednym ciasteczkiem wraca wiele razy i zostaje w swojej wersji. Efekt wersji B i liczbę botów poprawiliśmy po pierwszym uruchomieniu, żeby różnice między metodami były wyraźne; ziarna 660 nie zmienialiśmy. Dane pobierzesz jako czas-na-stronie-portal-ofert-pracy.csv (wiersz = sesja: wersja, czas, odsłony i znacznik bota, którego analityk w praktyce nie zna).
Rysunek 1: jak wygląda czas na stronie
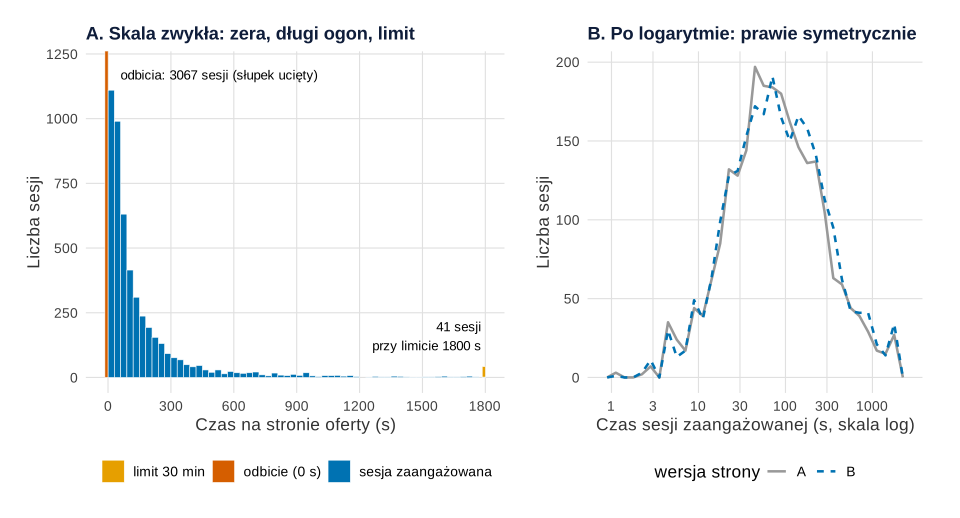
set.seed(660)).Co widać. Przy zerze stoi słupek 3067 odbić (38.89% sesji w A i 37.58% w B), dalej ciągnie się długi prawy ogon: skośność wynosi 4.60 w A i 4.37 w B. Przy 1800 s jest 41 sesji zatrzymanych na limicie (15 w A, 26 w B). Średnia w A to 100.23 s, a mediana – 25 s. Na osi logarytmicznej (panel B) sesje zaangażowane układają się prawie symetrycznie (skośność logarytmów 0.03), czyli zbliżony do rozkładu lognormalnego. Limpert i in. (2001) zauważają, że takie wielkości opisuje się zwykle średnią ± SD bez sprawdzenia rozkładu.
Jak może zmylić. Zero nie znaczy „użytkownik spędził 0 s”: system nie zna czasu na ostatniej stronie sesji, więc odbicie to brak pomiaru. Wartość 1800 s znaczy „co najmniej 30 minut” – to obserwacja ocenzurowana, a nie ucięta (różnicę wyjaśnia hasło dane ucięte a ocenzurowane). Każda miara traktuje te dwie umowy inaczej.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: średnia, mediana, średnia ucinana i geometryczna
Każda z czterech miar odpowiada na inne pytanie. Średnia to łączny czas podzielony przez liczbę sesji (ważna, gdy liczy się suma). Mediana opisuje typową sesję. Średnia ucinana 20% odrzuca 20% najkrótszych i 20% najdłuższych sesji. Średnia geometryczna to exp ze średniej logarytmów; przy zerach nie istnieje, więc liczymy ją tylko dla sesji zaangażowanych. Przedziały daje bootstrap: 2000 prób losowanych osobno w każdej wersji (mechanizm: bootstrap – wizualizacja na obrazkach).
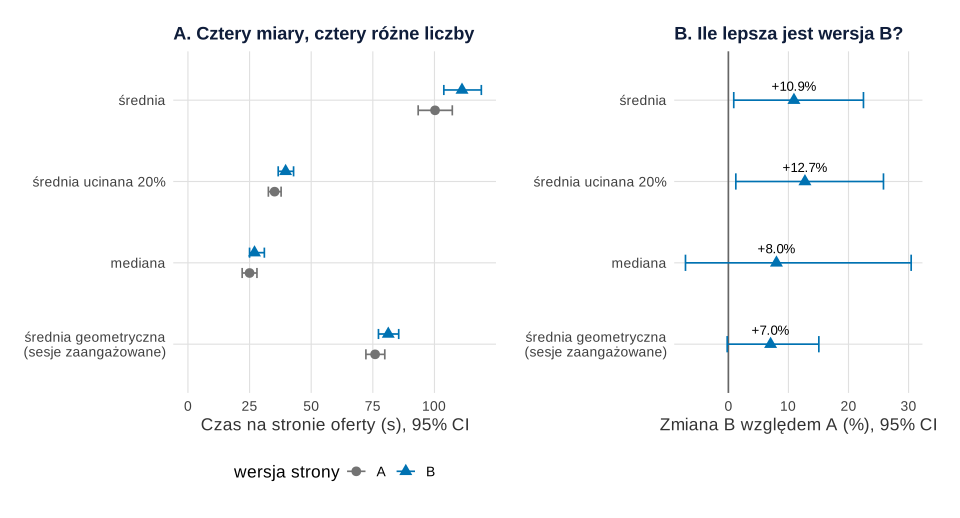
set.seed(660)).Co widać. Ten sam zbiór daje cztery „czasy na stronie”: od 25 s (mediana w A) do 111.17 s (średnia w B); średnia ucinana (35.14 i 39.62 s) z dołu ucina głównie zera. Zmiana B względem A wynosi +10.9% dla średniej (95% CI [0.9, 22.5]), +12.7% dla średniej ucinanej [1.2, 25.8], +8.0% dla mediany [−7.1, 30.4] i +7.0% dla średniej geometrycznej [−0.2, 15.1].
Jak może zmylić. Różne procenty to różne pytania, nie błąd. Mediana skacze o całe sekundy (25 → 27 s) i przy 38% zer leży nisko, więc jej przedział jest bardzo szeroki. Wilcox i Keselman (2003) pokazują, że odporne miary położenia, jak średnia ucinana, często dają porównaniom większą moc niż zwykła średnia. Średnia zawiera jednak także boty – wrócimy do nich na rysunku 4.
Podpis do pracy:
Test A/B: siedem analiz tych samych danych
Te same 8022 sesje analizujemy siedmioma sposobami. Próg winsoryzacji (1026.4 s) to 99. centyl czasu z 14 dni przed testem, ustalony przed wynikami.
| Analiza | Co porównuje | Wynik B względem A | 95% CI | p |
|---|---|---|---|---|
| Test t Welcha, surowe sekundy | średnie | +10.94 s | [0.82, 21.06] | .034 |
| Bootstrap różnicy średnich | średnie | +10.94 s | [0.98, 21.48] | – |
| Welch po winsoryzacji (1026.4 s) | średnie z przyciętym ogonem | +9.46 s | [1.24, 17.69] | .024 |
| Bootstrap różnicy median | mediany | +2 s | [−2, 7] | – |
| Welch na ln(czas), sesje zaangażowane | średnie geometryczne (iloraz) | × 1.070 | [0.998, 1.148] | .057 |
| Różnica odsetków odbić | odsetek sesji z 0 s | −1.31 pp | [−3.43, 0.82] | .229 |
| Test Manna–Whitneya | P(B > A) + ½ P(remis) | .512 | – | .049 |
Co z tego wynika. Cztery analizy wskazują na przewagę B (p < .05 albo przedział bez zera), trzy nie. Przy 4000 sesjach test Welcha na surowych sekundach dobrze opisuje różnicę średnich – bootstrap daje prawie ten sam przedział. Bootstrap przydaje się przy medianie, która nie ma prostego wzoru na błąd standardowy; Efron (1979) wśród pierwszych przykładów metody podał właśnie wariancję mediany. W 19.9% prób mediana B nie była wyższa.
Welch na logarytmach mówi, że sesje zaangażowane w B trwały o 7.0% dłużej – to iloraz średnich geometrycznych, nie zwykłych średnich (transformacja logarytmiczna); Feng i in. (2013) znaleźli w publikacjach wiele błędnych interpretacji takich analiz. Jeśli B zmienia, kto odbija, porównujemy przy tym różnych ludzi. Odbicia i czas lepiej opisać razem modelem dwuczęściowym, jak we wpisie przychód na klienta z wieloma zerami.
Test Manna–Whitneya nie porównuje median: Divine i in. (2018) pokazują, że testuje P(X < Y) + ½ P(X = Y), czyli szansę, że losowa sesja B jest dłuższa niż losowa sesja A. Tu wynosi ona .512. Fagerland (2012) pokazuje, że w dużych próbach ze skośnymi rozkładami test ten daje często dużo mniejsze p niż test t nawet przy równych średnich i medianach, gdy różni się rozrzut.
Rysunek 3: moc i fałszywe alarmy w 1000 testach
Która analiza jest najlepsza? Symulujemy po 1000 testów generatorem z przykładu (bez botów). W scenariuszu „efekt jak w teście” prawdziwa różnica średnich to 7.0 s, median 3 s, a iloraz średnich geometrycznych 1.057. „Dłuższy ogon B” ma te same odbicia i medianę sesji zaangażowanych, ale odchylenie logarytmów 1.45 zamiast 1.25.
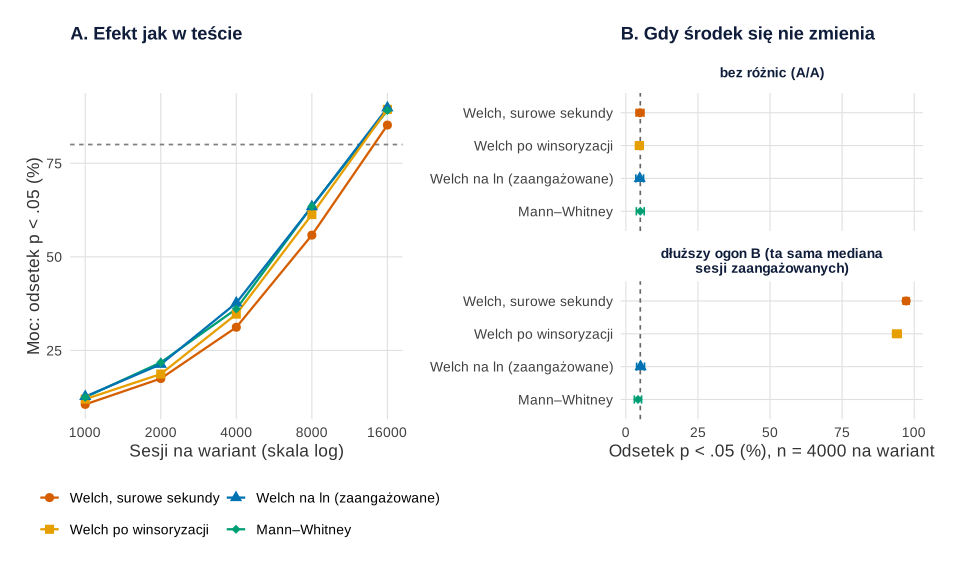
set.seed(660)).Co widać – panel A. Przy 4000 sesji na wersję moc wynosi zaledwie 31.2% (Welch na surowych), 34.7% (po winsoryzacji), 37.7% (na logarytmach) i 36.1% (Mann–Whitney). Test był za krótki: dopiero 16 000 sesji na wersję daje 85.2–89.8%.
Co widać – panel B. Gdy wersje się nie różnią, każda analiza daje fałszywy alarm w 4.7–5.0% testów (błąd Monte Carlo 0.7 pp). Przy dłuższym ogonie B Welch na surowych odrzuca H0 w 97.2% testów, po winsoryzacji w 94.0%, a Welch na logarytmach w 5.1% i Mann–Whitney w 4.2%. Wszystkie mają rację: średnia B jest wyższa o 20.6 s, średnia geometryczna się nie zmienia, szansa przewagi B wynosi .500, a mediana wszystkich sesji spada o 4 s.
Pokrycie przedziałów (100 i 1000 sesji na wersję, błąd Monte Carlo 0.7 pp): Welch dla różnicy średnich 95.2% i 95.5%, bootstrap percentylowy średnich 93.3% i 94.2%, bootstrap median 95.4% i 95.8%, iloraz średnich geometrycznych 96.5% i 94.0%. Przedział t działa mimo skośności, a przy małej próbie bootstrap percentylowy bywa za wąski. Moc zależy jednak od ręcznie ustalonych parametrów – u siebie powtórz symulację na danych historycznych. Przedział mediany wykluczał zero tylko w 9.4% testów przy 1000 sesjach.
Rysunek 4: 22 sesje botów i winsoryzacja ustalona z góry
Wiemy, które sesje to boty, więc porównujemy wynik z nimi i bez nich.
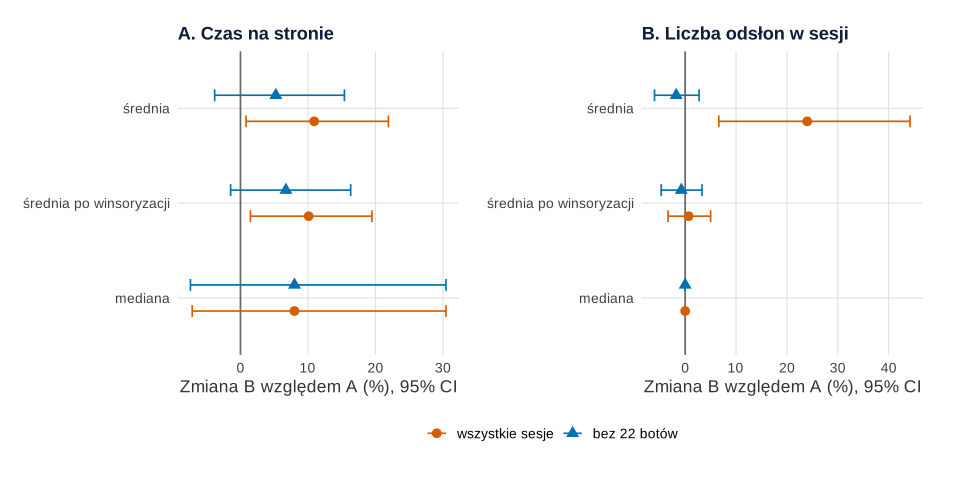
set.seed(660)).Co widać. Panel B: boty zawyżają średnią liczbę odsłon w B o 24.0% (95% CI [6.6, 44.2], p = .008; bez nich −1.8%). Winsoryzacja na progu 10 odsłon (99. centyl sprzed testu) prawie je neutralizuje: +0.7%, p = .736. Panel A: przy czasie boty siedzą przy limicie 1800 s, a winsoryzacja obniża je tylko do 1026.4 s. Średnia po winsoryzacji rośnie o 10.1% z botami (p = .024) i o 6.7% bez nich (p = .125). Bez botów nieistotne są też Welch na surowych (+5.2%, p = .283) i Mann–Whitney (p = .090). Mediana się nie rusza (+8.0%), ale ma najszerszy przedział.
Jak może zmylić. Winsoryzacja chroni przed kilkoma ogromnymi wartościami, nie przed 18 sesjami jednego robota w jednej wersji. Sygnał ostrzegawczy był w danych: ponad 50 odsłon miały 4 sesje w A i 18 w B, a żadna inna sesja nie przekroczyła 28 odsłon. Próg ustal przed testem, wspólny dla obu wersji: André (2022) pokazuje, że reguła wykluczania obserwacji, która nie jest ślepa na hipotezę, może zawyżać odsetek fałszywych alarmów (zob. obserwacja odstająca).
Rysunek 5: którą miarę wybrać
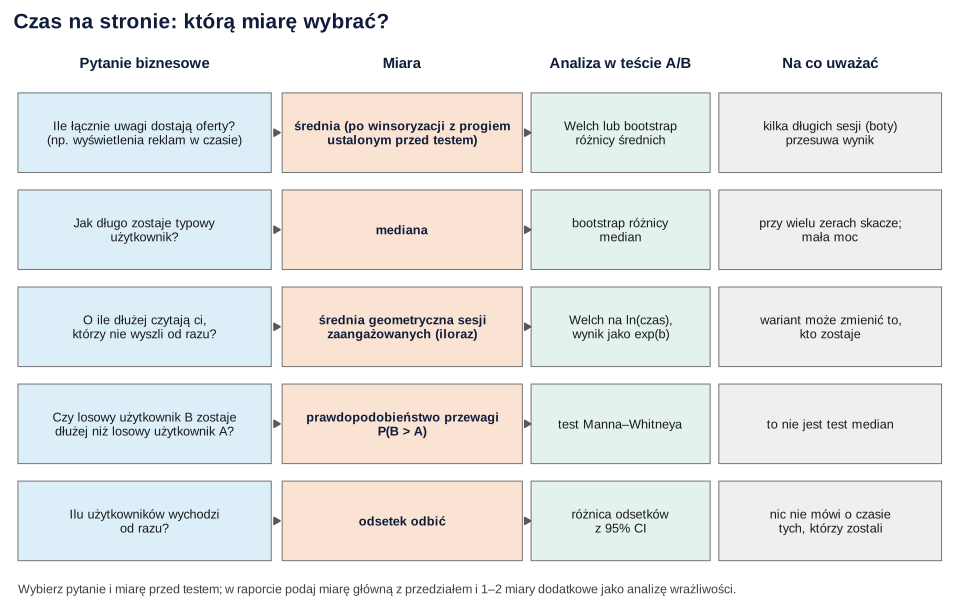
Co widać. Karta zaczyna od pytania, nie od testu. Portal sprzedający wyświetlenia reklam potrzebuje sumy czasu, czyli średniej (po winsoryzacji); pytanie „czy oferta jest czytana” lepiej opisze iloraz średnich geometrycznych razem z odsetkiem odbić.
Co z tym zrobić w firmie
- Nie wdrażaj wersji B na podstawie tego testu. Istotny wynik średniej zrobiły boty, a sam test miał przy tym efekcie tylko 31–38% mocy. Powtórz go na 16 000 sesji na wersję (ok. 8 tygodni przy tym ruchu).
- Czas na stronie traktuj jako metrykę pomocniczą. Dłuższe czytanie może znaczyć ciekawszą albo mniej jasną ofertę; główną metryką powinny być kliknięcia „Aplikuj”. Kohavi i in. (2020) opisują, jak dobrać ogólne kryterium oceny testu i metryki pomocnicze.
- Zapisz plan analizy przed startem: miarę główną, próg winsoryzacji z okresu przed testem i miary dodatkowe. Zmiana metryki po zobaczeniu p to jedna z pułapek testów A/B; przy wielu metrykach naraz zob. test A/B z wieloma wariantami.
- Przed odczytem wyników porównaj ogon rozkładu w wersjach – nierówna liczba skrajnych sesji to sygnał do sprawdzenia filtru botów.
Jak opisać w pracy
W Metodzie podaj definicję metryki (odbicia, limit sesji), miarę główną, próg winsoryzacji i jego źródło, metodę przedziałów i filtr botów; w Wynikach – miarę główną z 95% CI, pozostałe jako analizę wrażliwości. Więcej o pracach na danych firmowych: statystyka w pracy z zarządzania i ekonomii.
Kod R: rozkład, miary, bootstrap, symulacja i boty
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają przepisy 2, 3 i 5, a przepis 4 korzysta z funkcji przepisu 3. Wszystko liczymy w bazowym R (t.test(), wilcox.test(), prop.test(), bootstrap pętlą replicate()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p4, p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1–5; każdy zaczyna od własnego set.seed(660) (przepis 3 ustawia je przed każdym blokiem symulacji). Ziarno 660 ustalono raz i nie zmieniano go. Ręcznie ustalono: 4000 sesji na wersję w teście i 4000 w okresie przed testem, odsetek odbić (38% w A, 37% w B), medianę czasu sesji zaangażowanych (75 s w A, o 6% więcej w B), odchylenie logarytmów (1.25; w scenariuszu „dłuższy ogon B” 1.45), limit 1800 s, model liczby odsłon (1 + ujemny dwumianowy ze średnią rosnącą z czasem), 22 sesje botów (4 w A, 18 w B; 1500–2400 s, 60–240 odsłon) i progi winsoryzacji jako 99. centyl okresu przed testem. Efekt wersji B i liczbę botów poprawiono po pierwszym uruchomieniu, żeby różnice między metodami były wyraźne. Powtórzenia: bootstrap 2000 prób (przepisy 2 i 5), symulacja mocy 1000 testów w każdym punkcie, pokrycie 1000 testów × 300 prób bootstrapowych. Całość liczy się w około minutę.
1. Paleta, dane i rozkład czasu: Rysunek 1
R
# Rysunek 1. Fikcyjny portal z ogłoszeniami o pracę: czas na stronie oferty w teście A/B (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie --------------------------------------------------------------
n_sesji  <- 4000                         # sesji na wariant w 14 dniach testu
limit    <- 1800                         # sesja kończy się po 30 min bezczynności: czas ograniczony do 1800 s (cenzurowanie)
p_odbicia <- c(A = 0.38, B = 0.37)       # odbicie = jedna odsłona, czas zapisany jako 0 s
mediana_zaang <- c(A = 75, B = 75 * 1.06) # mediana czasu sesji zaangażowanych (s); wersja B: +6%
sigma    <- 1.25                         # SD logarytmu czasu sesji zaangażowanych

sesje <- function(wariant, n) {          # jedna sesja = jeden użytkownik
  odbicie <- rbinom(n, 1, p_odbicia[[wariant]])
  czas <- pmin(pmax(1, round(rlnorm(n, log(mediana_zaang[[wariant]]), sigma))), limit)
  czas[odbicie == 1] <- 0
  odslony <- ifelse(odbicie == 1, 1, 1 + rnbinom(n, mu = 1.3 * (pmax(czas, 1) / 75)^0.5, size = 1.2))
  data.frame(wariant = wariant, czas = czas, odslony = odslony, bot = 0)
}
set.seed(660)
portal <- rbind(sesje("A", n_sesji), sesje("B", n_sesji))
przed_testem <- sesje("A", n_sesji)      # 14 dni przed testem: stara wersja strony
# 22 sesje botów, których nie wyłapał filtr: długie sesje i dziesiątki odsłon. Ręcznie: 4 sesje w A
# i 18 w B (jeden robot z jednym ciasteczkiem wraca wiele razy, a losujemy użytkowników, więc zostaje w B)
boty <- data.frame(wariant = rep(c("A", "B"), c(4, 18)), czas = pmin(limit, round(runif(22, 1500, 2400))),
                   odslony = sample(60:240, 22, replace = TRUE), bot = 1)
portal <- rbind(portal, boty)
portal$sesja <- seq_len(nrow(portal))
write.csv(portal[, c("sesja", "wariant", "czas", "odslony", "bot")], "czas-na-stronie-portal-ofert-pracy.csv", row.names = FALSE)

# Progi winsoryzacji ustalone PRZED testem: 99. centyl z okresu przed testem
prog_czas <- unname(quantile(przed_testem$czas, 0.99))
prog_odslony <- unname(quantile(przed_testem$odslony, 0.99))
c(prog_czas = prog_czas, prog_odslony = prog_odslony)

# Opis rozkładu w wariantach
skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3
opis <- function(x) c(n = length(x), odbicia_proc = 100 * mean(x == 0), srednia = mean(x), mediana = median(x),
                      sd = sd(x), maks = max(x), przy_limicie = sum(x == limit), skosnosc = skosnosc(x),
                      skosnosc_ln_zaang = skosnosc(log(x[x > 0])))
round(sapply(split(portal$czas, portal$wariant), opis), 2)
# Liczba odsłon na sesję
round(sapply(split(portal$odslony, portal$wariant), function(x) c(srednia = mean(x), mediana = median(x),
                                                                    maks = max(x), skosnosc = skosnosc(x))), 2)

# Rysunek 1A: czas w sekundach (odbicia jako osobny słupek przy zerze, limit 30 min)
portal$rodzaj <- ifelse(portal$czas == 0, "odbicie (0 s)", ifelse(portal$czas == limit, "limit 30 min", "sesja zaangażowana"))
pA <- ggplot(portal, aes(czas, fill = rodzaj)) +
  geom_histogram(breaks = c(-15, 0.5, seq(30, 1770, by = 30), 1785, 1800.5), closed = "right", colour = "white", linewidth = 0.2) +
  scale_fill_manual(values = c("odbicie (0 s)" = kol[["cynober"]], "sesja zaangażowana" = kol[["niebieski"]],
                               "limit 30 min" = kol[["pomarancz"]]), name = NULL) +
  scale_x_continuous(breaks = seq(0, 1800, 300)) +
  coord_cartesian(ylim = c(0, 1200)) +
  annotate("text", x = 60, y = 1170, hjust = 0, size = 3.5, label = sprintf("odbicia: %d sesji (słupek ucięty)", sum(portal$czas == 0))) +
  annotate("text", x = 1780, y = 160, hjust = 1, size = 3.5, label = sprintf("%d sesji\nprzy limicie 1800 s", sum(portal$czas == limit))) +
  labs(x = "Czas na stronie oferty (s)", y = "Liczba sesji", title = "A. Skala zwykła: zera, długi ogon, limit") + motyw
# Rysunek 1B: sesje zaangażowane w skali logarytmicznej, osobno w wariantach
zaang <- portal[portal$czas > 0, ]
pB <- ggplot(zaang, aes(czas, colour = wariant, linetype = wariant)) +
  geom_freqpoly(breaks = 10^seq(0, log10(1800) + 0.1, by = 0.1), linewidth = 0.9) +
  scale_x_log10(breaks = c(1, 3, 10, 30, 100, 300, 1000), labels = c("1", "3", "10", "30", "100", "300", "1000")) +
  scale_colour_manual(values = c(A = kol[["szary"]], B = kol[["niebieski"]]), name = "wersja strony") +
  scale_linetype_manual(values = c(A = "solid", B = "22"), name = "wersja strony") +
  labs(x = "Czas sesji zaangażowanej (s, skala log)", y = "Liczba sesji", title = "B. Po logarytmie: prawie symetrycznie") + motyw
p1 <- pA + pB + plot_layout(widths = c(1.25, 1))
p1   # zapis: ggsave("czas-na-stronie-rozklad.svg", p1, width = 10, height = 5.4)
Wynik w R
   prog_czas prog_odslony
     1026.38        10.00
                        A       B
n                 4004.00 4018.00
odbicia_proc        38.89   37.58
srednia            100.23  111.17
mediana             25.00   27.00
sd                 222.27  240.02
maks              1800.00 1800.00
przy_limicie        15.00   26.00
skosnosc             4.60    4.37
skosnosc_ln_zaang    0.03    0.03
              A      B
srednia    2.14   2.65
mediana    1.00   1.00
maks     209.00 219.00
skosnosc  29.55  15.66
2. Cztery miary, bootstrap i siedem analiz testu: Rysunek 2 i tabela
R
# Rysunek 2 i tabela testów. Cztery miary położenia z bootstrapem i siedem odpowiedzi na pytanie „czy B jest lepsza?”
# Korzysta z obiektów przepisu 1: portal, prog_czas, kol, motyw. Losuje (bootstrap) – własne ziarno.
library(ggplot2)
library(patchwork)

a <- portal$czas[portal$wariant == "A"]
b <- portal$czas[portal$wariant == "B"]
miary <- function(x) c("średnia" = mean(x), "średnia ucinana 20%" = mean(x, trim = 0.2), "mediana" = median(x),
                       "średnia geometryczna\n(sesje zaangażowane)" = exp(mean(log(x[x > 0]))))
round(rbind(A = miary(a), B = miary(b)), 2)

# Bootstrap: 2000 prób, losowanie sesji ze zwracaniem osobno w każdym wariancie, przedziały percentylowe 95%
set.seed(660)
B_prob <- 2000
boot_a <- t(replicate(B_prob, miary(sample(a, replace = TRUE))))
boot_b <- t(replicate(B_prob, miary(sample(b, replace = TRUE))))
przedzial <- function(m) apply(m, 2, quantile, c(0.025, 0.975))
roznica_proc <- 100 * (boot_b / boot_a - 1)                       # zmiana B względem A (%)
wyniki <- data.frame(miara = names(miary(a)), A = miary(a), B = miary(b),
                     zmiana_proc = 100 * (miary(b) / miary(a) - 1),
                     dolna = przedzial(roznica_proc)[1, ], gorna = przedzial(roznica_proc)[2, ], row.names = NULL)
transform(wyniki, A = round(A, 2), B = round(B, 2), zmiana_proc = round(zmiana_proc, 1), dolna = round(dolna, 1), gorna = round(gorna, 1))

# Siedem analiz tego samego testu A/B
welch <- t.test(b, a)                                             # surowe sekundy
w_a <- pmin(a, prog_czas); w_b <- pmin(b, prog_czas)
welch_w <- t.test(w_b, w_a)                                       # winsoryzacja z progiem ustalonym przed testem
welch_ln <- t.test(log(b[b > 0]), log(a[a > 0]))                  # ln czasu, tylko sesje zaangażowane
odbicia <- prop.test(c(sum(b == 0), sum(a == 0)), c(length(b), length(a)), correct = FALSE)
mw <- wilcox.test(b, a, exact = FALSE)                            # Mann–Whitney (U Wilcoxona)
p_przewagi <- unname(mw$statistic) / (length(a) * length(b))      # P(B > A) + P(B = A) / 2
boot_srednia <- boot_b[, 1] - boot_a[, 1]; boot_mediana <- boot_b[, 3] - boot_a[, 3]
tabela <- data.frame(
  analiza = c("Welch: różnica średnich (s)", "bootstrap: różnica średnich (s)", "Welch po winsoryzacji (s)",
              "bootstrap: różnica median (s)", "Welch na ln: iloraz średnich geometr.", "odsetek odbić: różnica (pp)",
              "Mann–Whitney: P(B > A)"),
  wynik = c(diff(rev(welch$estimate)), mean(b) - mean(a), diff(rev(welch_w$estimate)), median(b) - median(a),
            exp(diff(rev(welch_ln$estimate))), 100 * diff(rev(odbicia$estimate)), p_przewagi),
  dolna = c(welch$conf.int[1], quantile(boot_srednia, 0.025), welch_w$conf.int[1], quantile(boot_mediana, 0.025),
            exp(welch_ln$conf.int[1]), 100 * odbicia$conf.int[1], NA),
  gorna = c(welch$conf.int[2], quantile(boot_srednia, 0.975), welch_w$conf.int[2], quantile(boot_mediana, 0.975),
            exp(welch_ln$conf.int[2]), 100 * odbicia$conf.int[2], NA),
  p = c(welch$p.value, NA, welch_w$p.value, NA, welch_ln$p.value, odbicia$p.value, mw$p.value))
transform(tabela, wynik = round(wynik, 3), dolna = round(dolna, 3), gorna = round(gorna, 3), p = round(p, 3))
# Odsetek prób bootstrapowych, w których mediana B nie była wyższa niż mediana A
round(100 * mean(boot_mediana <= 0), 1)

# Rysunek 2A: miary w obu wariantach z 95% przedziałem bootstrapowym
dl <- rbind(data.frame(wariant = "A", miara = names(miary(a)), wartosc = miary(a), dolna = przedzial(boot_a)[1, ], gorna = przedzial(boot_a)[2, ]),
            data.frame(wariant = "B", miara = names(miary(b)), wartosc = miary(b), dolna = przedzial(boot_b)[1, ], gorna = przedzial(boot_b)[2, ]))
dl$miara <- factor(dl$miara, levels = rev(names(miary(a))))
pA <- ggplot(dl, aes(wartosc, miara, colour = wariant, shape = wariant)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", position = position_dodge(width = 0.5)) +
  geom_point(size = 3, position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = c(A = "grey45", B = kol[["niebieski"]]), name = "wersja strony") +
  scale_shape_manual(values = c(A = 16, B = 17), name = "wersja strony") +
  scale_x_continuous(limits = c(0, NA)) +
  labs(x = "Czas na stronie oferty (s), 95% CI", y = NULL, title = "A. Cztery miary, cztery różne liczby") + motyw
# Rysunek 2B: zmiana B względem A (%) z 95% przedziałem bootstrapowym
wyniki$miara <- factor(wyniki$miara, levels = rev(names(miary(a))))
pB <- ggplot(wyniki, aes(zmiana_proc, miara)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 3, colour = kol[["niebieski"]], shape = 17) +
  geom_text(aes(label = sprintf("%+.1f%%", zmiana_proc)), vjust = -1, size = 3.5) +
  labs(x = "Zmiana B względem A (%), 95% CI", y = NULL, title = "B. Ile lepsza jest wersja B?") +
  motyw + theme(axis.text.y = element_blank())
p2 <- pA + pB + plot_layout(widths = c(1.3, 1))
p2   # zapis: ggsave("czas-na-stronie-miary-bootstrap.svg", p2, width = 10, height = 5.4)
Wynik w R
  średnia średnia ucinana 20% mediana
A  100.23               35.14      25
B  111.17               39.62      27
  średnia geometryczna\n(sesje zaangażowane)
A                                      75.92
B                                      81.26
                                       miara      A      B zmiana_proc dolna
1                                    średnia 100.23 111.17        10.9   0.9
2                        średnia ucinana 20%  35.14  39.62        12.7   1.2
3                                    mediana  25.00  27.00         8.0  -7.1
4 średnia geometryczna\n(sesje zaangażowane)  75.92  81.26         7.0  -0.2
  gorna
1  22.5
2  25.8
3  30.4
4  15.1
                                analiza  wynik  dolna  gorna     p
1           Welch: różnica średnich (s) 10.940  0.815 21.064 0.034
2       bootstrap: różnica średnich (s) 10.940  0.983 21.475    NA
3             Welch po winsoryzacji (s)  9.464  1.240 17.688 0.024
4         bootstrap: różnica median (s)  2.000 -2.000  7.000    NA
5 Welch na ln: iloraz średnich geometr.  1.070  0.998  1.148 0.057
6           odsetek odbić: różnica (pp) -1.305 -3.432  0.821 0.229
7                Mann–Whitney: P(B > A)  0.512     NA     NA 0.049
[1] 19.9
3. Symulacja mocy i fałszywych alarmów: Rysunek 3
R
# Rysunek 3. Symulacja: moc i odsetek fałszywych alarmów pięciu analiz przy skośnym czasie na stronie
# Korzysta z obiektów przepisu 1: kol, motyw. Losuje – własne ziarno. Liczy się ok. 15 s.
library(ggplot2)
library(patchwork)

# Generator sesji: odbicia (0 s), lognormalny czas sesji zaangażowanych, limit 1800 s
czasy <- function(n, p_odbicia, mediana, sigma, limit = 1800) {
  czas <- pmin(pmax(1, round(rlnorm(n, log(mediana), sigma))), limit)
  czas[runif(n) < p_odbicia] <- 0
  czas
}
scenariusze <- list(
  "bez różnic (A/A)"                = list(A = c(0.38, 75, 1.25), B = c(0.38, 75, 1.25)),
  "efekt jak w teście"              = list(A = c(0.38, 75, 1.25), B = c(0.37, 79.5, 1.25)),
  "dłuższy ogon B" = list(A = c(0.38, 75, 1.25), B = c(0.38, 75, 1.45)))
set.seed(660)
prog <- unname(quantile(czasy(1e6, 0.38, 75, 1.25), 0.99))        # próg winsoryzacji: 99. centyl starej wersji
# Szybki test Manna–Whitneya dla czasu w pełnych sekundach (0–1800): zlicza pary bez tworzenia rang
mann_whitney <- function(a, b, maks = 1800) {
  ca <- tabulate(a + 1, maks + 1); cb <- tabulate(b + 1, maks + 1)
  W <- sum(cb * (cumsum(ca) - ca)) + sum(cb * ca) / 2               # pary B > A + połowa remisów
  na <- length(a); nb <- length(b); N <- na + nb; t <- ca + cb
  v <- na * nb / 12 * ((N + 1) - sum(t^3 - t) / (N * (N - 1)))      # wariancja W z poprawką na remisy
  2 * pnorm(-abs(W - na * nb / 2) / sqrt(v))
}
# Sprawdzenie: to samo p co wilcox.test() bez poprawki na ciągłość
a <- czasy(500, 0.38, 75, 1.25); b <- czasy(500, 0.37, 79.5, 1.25)
c(szybki = mann_whitney(a, b), wilcox.test = wilcox.test(b, a, exact = FALSE, correct = FALSE)$p.value)
analizy <- function(a, b) c(
  "Welch, surowe sekundy"      = t.test(b, a)$p.value,
  "Welch po winsoryzacji"      = t.test(pmin(b, prog), pmin(a, prog))$p.value,
  "Welch na ln (zaangażowane)" = t.test(log(b[b > 0]), log(a[a > 0]))$p.value,
  "Mann–Whitney"               = mann_whitney(a, b))
symuluj <- function(scen, n, R = 1000) {
  s <- scenariusze[[scen]]
  p <- replicate(R, analizy(czasy(n, s$A[1], s$A[2], s$A[3]), czasy(n, s$B[1], s$B[2], s$B[3])))
  data.frame(scenariusz = scen, n = n, analiza = rownames(p), odrzucenia = rowMeans(p < .05), row.names = NULL)
}
set.seed(660)
moc <- do.call(rbind, lapply(c(1000, 2000, 4000, 8000, 16000), function(n) symuluj("efekt jak w teście", n)))
set.seed(660)
inne <- do.call(rbind, lapply(c("bez różnic (A/A)", "dłuższy ogon B"), symuluj, n = 4000))
wynik <- rbind(moc, inne)
wynik$blad_mc <- sqrt(wynik$odrzucenia * (1 - wynik$odrzucenia) / 1000)   # błąd Monte Carlo odsetka
transform(wynik, odrzucenia = round(100 * odrzucenia, 1), blad_mc = round(100 * blad_mc, 1))

# Co jest prawdą w populacji? Średnia, mediana i średnia geometryczna sesji zaangażowanych (1 mln sesji)
set.seed(660)
prawda <- sapply(scenariusze, function(s) {
  a <- czasy(1e6, s$A[1], s$A[2], s$A[3]); b <- czasy(1e6, s$B[1], s$B[2], s$B[3])
  c(roznica_srednich = mean(b) - mean(a), roznica_median = median(b) - median(a),
    iloraz_geom = exp(mean(log(b[b > 0])) - mean(log(a[a > 0]))),
    P_B_wieksze = mean(b > a) + 0.5 * mean(b == a))   # pary: i-ta sesja B z i-tą sesją A
})
round(prawda, 3)

# Rysunek 3A: moc w funkcji liczby sesji na wariant
ksztalty <- c("Welch, surowe sekundy" = 16, "Welch po winsoryzacji" = 15, "Welch na ln (zaangażowane)" = 17, "Mann–Whitney" = 18)
kolory <- c("Welch, surowe sekundy" = kol[["cynober"]], "Welch po winsoryzacji" = kol[["pomarancz"]],
            "Welch na ln (zaangażowane)" = kol[["niebieski"]], "Mann–Whitney" = kol[["zielony"]])
pA <- ggplot(moc, aes(n, 100 * odrzucenia, colour = analiza, shape = analiza)) +
  geom_hline(yintercept = 80, colour = "grey50", linetype = "22") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  scale_x_log10(breaks = c(1000, 2000, 4000, 8000, 16000)) +
  scale_colour_manual(values = kolory, breaks = names(kolory), name = NULL) +
  scale_shape_manual(values = ksztalty, breaks = names(kolory), name = NULL) +
  labs(x = "Sesji na wariant (skala log)", y = "Moc: odsetek p < .05 (%)", title = "A. Efekt jak w teście") +
  motyw + guides(colour = guide_legend(ncol = 2), shape = guide_legend(ncol = 2))
# Rysunek 3B: odsetek odrzuceń H0 przy 4000 sesji na wariant: brak różnic i dłuższy ogon przy tej samej medianie sesji zaangażowanych
inne$scenariusz <- factor(inne$scenariusz, levels = c("bez różnic (A/A)", "dłuższy ogon B"),
                          labels = c("bez różnic (A/A)", "dłuższy ogon B (ta sama mediana\nsesji zaangażowanych)"))
pB <- ggplot(inne, aes(100 * odrzucenia, analiza, colour = analiza, shape = analiza)) +
  geom_vline(xintercept = 5, colour = "grey40", linetype = "22") +
  geom_errorbar(aes(xmin = 100 * (odrzucenia - 1.96 * sqrt(odrzucenia * (1 - odrzucenia) / 1000)),
                     xmax = 100 * (odrzucenia + 1.96 * sqrt(odrzucenia * (1 - odrzucenia) / 1000))), width = 0.25, orientation = "y") +
  geom_point(size = 2.8) +
  facet_wrap(~ scenariusz, ncol = 1) +
  scale_colour_manual(values = kolory, guide = "none") + scale_shape_manual(values = ksztalty, guide = "none") +
  labs(x = "Odsetek p < .05 (%), n = 4000 na wariant", y = NULL, title = "B. Gdy środek się nie zmienia") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.1, 1)) & theme(legend.position = "bottom")
p3   # zapis: ggsave("czas-na-stronie-symulacja-mocy.svg", p3, width = 10, height = 6)
Wynik w R
     szybki wilcox.test
  0.1406758   0.1406758
           scenariusz     n                    analiza odrzucenia blad_mc
1  efekt jak w teście  1000      Welch, surowe sekundy       10.6     1.0
2  efekt jak w teście  1000      Welch po winsoryzacji       12.0     1.0
3  efekt jak w teście  1000 Welch na ln (zaangażowane)       12.7     1.1
4  efekt jak w teście  1000               Mann–Whitney       12.5     1.0
5  efekt jak w teście  2000      Welch, surowe sekundy       17.5     1.2
6  efekt jak w teście  2000      Welch po winsoryzacji       18.7     1.2
7  efekt jak w teście  2000 Welch na ln (zaangażowane)       21.3     1.3
8  efekt jak w teście  2000               Mann–Whitney       21.8     1.3
9  efekt jak w teście  4000      Welch, surowe sekundy       31.2     1.5
10 efekt jak w teście  4000      Welch po winsoryzacji       34.7     1.5
11 efekt jak w teście  4000 Welch na ln (zaangażowane)       37.7     1.5
12 efekt jak w teście  4000               Mann–Whitney       36.1     1.5
13 efekt jak w teście  8000      Welch, surowe sekundy       55.8     1.6
14 efekt jak w teście  8000      Welch po winsoryzacji       61.3     1.5
15 efekt jak w teście  8000 Welch na ln (zaangażowane)       63.4     1.5
16 efekt jak w teście  8000               Mann–Whitney       63.5     1.5
17 efekt jak w teście 16000      Welch, surowe sekundy       85.2     1.1
18 efekt jak w teście 16000      Welch po winsoryzacji       89.4     1.0
19 efekt jak w teście 16000 Welch na ln (zaangażowane)       89.8     1.0
20 efekt jak w teście 16000               Mann–Whitney       89.1     1.0
21   bez różnic (A/A)  4000      Welch, surowe sekundy        4.9     0.7
22   bez różnic (A/A)  4000      Welch po winsoryzacji        4.7     0.7
23   bez różnic (A/A)  4000 Welch na ln (zaangażowane)        4.8     0.7
24   bez różnic (A/A)  4000               Mann–Whitney        5.0     0.7
25     dłuższy ogon B  4000      Welch, surowe sekundy       97.2     0.5
26     dłuższy ogon B  4000      Welch po winsoryzacji       94.0     0.8
27     dłuższy ogon B  4000 Welch na ln (zaangażowane)        5.1     0.7
28     dłuższy ogon B  4000               Mann–Whitney        4.2     0.6
                 bez różnic (A/A) efekt jak w teście dłuższy ogon B
roznica_srednich            0.063              7.015         20.576
roznica_median              0.000              3.000         -4.000
iloraz_geom                 1.004              1.057          0.995
P_B_wieksze                 0.500              0.509          0.500
4. Pokrycie przedziałów ufności
R
# Tabela pokrycia. Czy 95% przedziały naprawdę obejmują prawdę w 95% testów? 1000 testów na każdą liczebność
# Korzysta z obiektów przepisu 3: czasy, scenariusze, prawda. Losuje – własne ziarno. Liczy się ok. 45 s.
s <- scenariusze[["efekt jak w teście"]]
cel <- prawda[, "efekt jak w teście"]
jeden_test <- function(n, B = 300) {
  a <- czasy(n, s$A[1], s$A[2], s$A[3]); b <- czasy(n, s$B[1], s$B[2], s$B[3])
  ci_welch <- t.test(b, a)$conf.int
  ci_ln <- exp(t.test(log(b[b > 0]), log(a[a > 0]))$conf.int)
  bs <- replicate(B, { ba <- sample(a, replace = TRUE); bb <- sample(b, replace = TRUE)
                       c(mean(bb) - mean(ba), median(bb) - median(ba)) })
  ci_bs <- apply(bs, 1, quantile, c(0.025, 0.975))
  c("Welch: różnica średnich"           = unname(ci_welch[1] <= cel[["roznica_srednich"]] & cel[["roznica_srednich"]] <= ci_welch[2]),
    "bootstrap: różnica średnich"       = unname(ci_bs[1, 1] <= cel[["roznica_srednich"]] & cel[["roznica_srednich"]] <= ci_bs[2, 1]),
    "bootstrap: różnica median"         = unname(ci_bs[1, 2] <= cel[["roznica_median"]] & cel[["roznica_median"]] <= ci_bs[2, 2]),
    "Welch na ln: iloraz geometr."      = unname(ci_ln[1] <= cel[["iloraz_geom"]] & cel[["iloraz_geom"]] <= ci_ln[2]),
    "mediana: przedział wyklucza 0"     = unname(ci_bs[1, 2] > 0 | ci_bs[2, 2] < 0))
}
set.seed(660)
pokrycie <- sapply(c(100, 1000), function(n) rowMeans(replicate(1000, jeden_test(n))))
colnames(pokrycie) <- c("n = 100", "n = 1000")
round(100 * pokrycie, 1)
# Błąd Monte Carlo odsetka 95% przy 1000 testach (pp)
round(100 * sqrt(0.95 * 0.05 / 1000), 1)
Wynik w R
                              n = 100 n = 1000
Welch: różnica średnich          95.2     95.5
bootstrap: różnica średnich      93.3     94.2
bootstrap: różnica median        95.4     95.8
Welch na ln: iloraz geometr.     96.5     94.0
mediana: przedział wyklucza 0     4.8      9.4
[1] 0.7
5. Boty, winsoryzacja i mediana: Rysunek 4
R
# Rysunek 4. 22 sesje botów: jak zmieniają wynik testu średnia, średnia po winsoryzacji i mediana
# Korzysta z obiektów przepisu 1: portal, prog_czas, prog_odslony, kol, motyw. Losuje (bootstrap) – własne ziarno.
library(ggplot2)
library(patchwork)

zmiana <- function(a, b, prog) c("średnia" = mean(b) / mean(a), "średnia po winsoryzacji" = mean(pmin(b, prog)) / mean(pmin(a, prog)),
                                 "mediana" = median(b) / median(a))
porownaj <- function(dane, zmienna, prog, opis) {
  a <- dane[[zmienna]][dane$wariant == "A"]; b <- dane[[zmienna]][dane$wariant == "B"]
  bs <- replicate(2000, zmiana(sample(a, replace = TRUE), sample(b, replace = TRUE), prog))
  data.frame(metryka = zmienna, dane = opis, miara = names(zmiana(a, b, prog)),
             zmiana_proc = 100 * (zmiana(a, b, prog) - 1),
             dolna = 100 * (apply(bs, 1, quantile, 0.025) - 1), gorna = 100 * (apply(bs, 1, quantile, 0.975) - 1),
             p_welch = c(t.test(b, a)$p.value, t.test(pmin(b, prog), pmin(a, prog))$p.value, NA),
             p_mw = c(wilcox.test(b, a, exact = FALSE)$p.value, NA, NA), row.names = NULL)
}
bez_botow <- portal[portal$bot == 0, ]
set.seed(660)
boty_wynik <- rbind(porownaj(portal, "czas", prog_czas, "wszystkie sesje"),
                    porownaj(bez_botow, "czas", prog_czas, "bez 22 botów"),
                    porownaj(portal, "odslony", prog_odslony, "wszystkie sesje"),
                    porownaj(bez_botow, "odslony", prog_odslony, "bez 22 botów"))
transform(boty_wynik, zmiana_proc = round(zmiana_proc, 1), dolna = round(dolna, 1), gorna = round(gorna, 1),
          p_welch = round(p_welch, 3), p_mw = round(p_mw, 3))
# Średnia liczba odsłon i średni czas w wariantach: z botami i bez
round(rbind(z_botami = tapply(portal$odslony, portal$wariant, mean), bez_botow = tapply(bez_botow$odslony, bez_botow$wariant, mean)), 3)
round(rbind(z_botami = tapply(portal$czas, portal$wariant, mean), bez_botow = tapply(bez_botow$czas, bez_botow$wariant, mean)), 2)
# Sygnał ostrzegawczy bez wiedzy o botach: ogon liczby odsłon w każdym wariancie
table(wariant = portal$wariant, ponad_50_odslon = portal$odslony > 50)
max(portal$odslony[portal$odslony <= 50])                          # najwięcej odsłon poniżej 50: przerwa w rozkładzie

# Rysunek 4: zmiana B względem A (%) z 95% przedziałem bootstrapowym, z botami i bez
boty_wynik$miara <- factor(boty_wynik$miara, levels = rev(c("średnia", "średnia po winsoryzacji", "mediana")))
boty_wynik$dane <- factor(boty_wynik$dane, levels = c("wszystkie sesje", "bez 22 botów"))
rysuj <- function(m, tytul) {
  ggplot(boty_wynik[boty_wynik$metryka == m, ], aes(zmiana_proc, miara, colour = dane, shape = dane)) +
    geom_vline(xintercept = 0, colour = "grey40") +
    geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", position = position_dodge(width = 0.55)) +
    geom_point(size = 3, position = position_dodge(width = 0.55)) +
    scale_colour_manual(values = c("wszystkie sesje" = kol[["cynober"]], "bez 22 botów" = kol[["niebieski"]]), name = NULL) +
    scale_shape_manual(values = c("wszystkie sesje" = 16, "bez 22 botów" = 17), name = NULL) +
    labs(x = "Zmiana B względem A (%), 95% CI", y = NULL, title = tytul) + motyw
}
p4 <- rysuj("czas", "A. Czas na stronie") + rysuj("odslony", "B. Liczba odsłon w sesji") +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("czas-na-stronie-boty-winsoryzacja.svg", p4, width = 10, height = 5)
Wynik w R
   metryka            dane                   miara zmiana_proc dolna gorna
1     czas wszystkie sesje                 średnia        10.9   0.8  21.9
2     czas wszystkie sesje średnia po winsoryzacji        10.1   1.5  19.5
3     czas wszystkie sesje                 mediana         8.0  -7.1  30.4
4     czas    bez 22 botów                 średnia         5.2  -3.8  15.4
5     czas    bez 22 botów średnia po winsoryzacji         6.7  -1.5  16.3
6     czas    bez 22 botów                 mediana         8.0  -7.4  30.4
7  odslony wszystkie sesje                 średnia        24.0   6.6  44.2
8  odslony wszystkie sesje średnia po winsoryzacji         0.7  -3.4   5.0
9  odslony wszystkie sesje                 mediana         0.0   0.0   0.0
10 odslony    bez 22 botów                 średnia        -1.8  -6.0   2.7
11 odslony    bez 22 botów średnia po winsoryzacji        -0.8  -4.7   3.3
12 odslony    bez 22 botów                 mediana         0.0   0.0   0.0
   p_welch  p_mw
1    0.034 0.049
2    0.024    NA
3       NA    NA
4    0.283 0.090
5    0.125    NA
6       NA    NA
7    0.008 0.550
8    0.736    NA
9       NA    NA
10   0.430 0.776
11   0.703    NA
12      NA    NA
              A     B
z_botami  2.135 2.648
bez_botow 1.988 1.954
               A      B
z_botami  100.23 111.17
bez_botow  98.58 103.73
       ponad_50_odslon
wariant FALSE TRUE
      A  4000    4
      B  4000   18
[1] 28
6. Grafika: karta „którą miarę wybrać”: Rysunek 5
R
# Rysunek 5. Grafika: karta „którą miarę wybrać” – od pytania biznesowego do miary, analizy i pułapki
# Samodzielny przepis: niczego nie losuje i nie korzysta z innych przepisów.
library(ggplot2)

karta <- data.frame(
  y = 5:1,
  pytanie = c("Ile łącznie uwagi dostają oferty?\n(np. wyświetlenia reklam w czasie)",
              "Jak długo zostaje typowy\nużytkownik?",
              "O ile dłużej czytają ci,\nktórzy nie wyszli od razu?",
              "Czy losowy użytkownik B zostaje\ndłużej niż losowy użytkownik A?",
              "Ilu użytkowników wychodzi\nod razu?"),
  miara = c("średnia (po winsoryzacji z progiem\nustalonym przed testem)",
            "mediana",
            "średnia geometryczna sesji\nzaangażowanych (iloraz)",
            "prawdopodobieństwo przewagi\nP(B > A)",
            "odsetek odbić"),
  analiza = c("Welch lub bootstrap\nróżnicy średnich",
              "bootstrap różnicy\nmedian",
              "Welch na ln(czas),\nwynik jako exp(b)",
              "test Manna–Whitneya",
              "różnica odsetków\nz 95% CI"),
  pulapka = c("kilka długich sesji (boty)\nprzesuwa wynik",
              "przy wielu zerach skacze;\nmała moc",
              "wariant może zmienić to,\nkto zostaje",
              "to nie jest test median",
              "nic nie mówi o czasie\ntych, którzy zostali"))
kolumny <- data.frame(x = c(1.6, 4.55, 7.05, 9.45), tytul = c("Pytanie biznesowe", "Miara", "Analiza w teście A/B", "Na co uważać"),
                      szer = c(2.9, 2.75, 2.05, 2.55), tlo = c("#DCEEF8", "#FBE3D3", "#E3F2EC", "#EFEFEF"))
pola <- merge(karta, kolumny, by = NULL)
pola$tekst <- ifelse(pola$tytul == "Pytanie biznesowe", pola$pytanie,
              ifelse(pola$tytul == "Miara", pola$miara, ifelse(pola$tytul == "Analiza w teście A/B", pola$analiza, pola$pulapka)))
pola$pogrub <- pola$tytul == "Miara"
p6 <- ggplot() +
  geom_tile(data = pola, aes(x, y, width = szer, height = 0.82, fill = tlo), colour = "grey45", linewidth = 0.35) +
  geom_text(data = pola[!pola$pogrub, ], aes(x, y, label = tekst), size = 3.35, lineheight = 0.92, colour = "grey10") +
  geom_text(data = pola[pola$pogrub, ], aes(x, y, label = tekst), size = 3.35, lineheight = 0.92, colour = "#0f1d3a", fontface = "bold") +
  geom_text(data = kolumny, aes(x, 5.72, label = tytul), fontface = "bold", size = 3.9, colour = "#0f1d3a") +
  annotate("segment", x = 3.08, xend = 3.15, y = 5:1, yend = 5:1, arrow = arrow(length = unit(0.18, "cm"), type = "closed"), colour = "grey35") +
  annotate("segment", x = 5.95, xend = 6.02, y = 5:1, yend = 5:1, arrow = arrow(length = unit(0.18, "cm"), type = "closed"), colour = "grey35") +
  annotate("text", x = 0.15, y = 0.3, hjust = 0, size = 3.3, colour = "grey25",
           label = "Wybierz pytanie i miarę przed testem; w raporcie podaj miarę główną z przedziałem i 1–2 miary dodatkowe jako analizę wrażliwości.") +
  scale_fill_identity() +
  coord_cartesian(xlim = c(0.1, 10.75), ylim = c(0.15, 5.95), expand = FALSE) +
  labs(title = "Czas na stronie: którą miarę wybrać?") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 12, 8, 10))
p6   # zapis: ggsave("czas-na-stronie-karta-ktora-miara.svg", p6, width = 10, height = 6.4)
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – szary (wersja B / A)" = c("#0072B2", "#737373"),
             "cynober – niebieski (odbicia / sesje; z botami / bez)" = c("#D55E00", "#0072B2"),
             "niebieski – pomarańczowy (sesje / limit 30 min)" = c("#0072B2", "#E69F00"),
             "cynober – pomarańczowy (Welch surowe / po winsoryzacji)" = c("#D55E00", "#E69F00"),
             "niebieski – zielony (Welch na ln / Mann–Whitney)" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony (po winsoryzacji / Mann–Whitney)" = c("#E69F00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                        widzenie_typowe
niebieski – szary (wersja B / A)                                   41.5
cynober – niebieski (odbicia / sesje; z botami / bez)             114.6
niebieski – pomarańczowy (sesje / limit 30 min)                   120.2
cynober – pomarańczowy (Welch surowe / po winsoryzacji)            33.4
niebieski – zielony (Welch na ln / Mann–Whitney)                   70.1
pomarańczowy – zielony (po winsoryzacji / Mann–Whitney)            88.7
czerwony – zielony (do unikania)                                  121.7
                                                        deuteranopia protanopia
niebieski – szary (wersja B / A)                                45.1       38.2
cynober – niebieski (odbicia / sesje; z botami / bez)          108.3       91.9
niebieski – pomarańczowy (sesje / limit 30 min)                121.5      109.3
cynober – pomarańczowy (Welch surowe / po winsoryzacji)         18.4       24.9
niebieski – zielony (Welch na ln / Mann–Whitney)                55.4       58.0
pomarańczowy – zielony (po winsoryzacji / Mann–Whitney)         66.3       51.5
czerwony – zielony (do unikania)                                21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, testy t Welcha, test Manna–Whitneya, test różnicy odsetków i bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Mann–Whitney porównał mediany”. Nie porównał – testuje przewagę losowej sesji jednej wersji nad drugą. W symulacji z dłuższym ogonem mediana wszystkich sesji spadła o 4 s, a test odrzucał H0 tylko w 4.2% testów.
- Wynik z logarytmów opisany jako zmiana średniej. exp(b) to iloraz średnich geometrycznych; zwykła średnia może zmienić się o inny procent.
- Próg winsoryzacji dobrany po wynikach albo osobno w każdej wersji – to ukryte p-hakowanie.
- Mediana liczby odsłon. Gdy co najmniej połowa sesji ma 1 odsłonę, mediana wynosi 1 w obu wersjach i nic nie mówi.
- Brak analizy mocy. Przy 4000 sesjach na wersję mały efekt wykrywa co trzeci test.
Najczęstsze pytania
Średnia czy mediana czasu na stronie w teście A/B?
Zależy od pytania. Średnia odpowiada na pytanie o łączny czas (np. wyświetlenia reklam), mediana – o typową sesję. Przy wielu odbiciach mediana leży nisko i ma szeroki przedział: w przykładzie +8.0%, 95% CI [−7.1, 30.4]. Miarę główną wybierz przed testem, a drugą podaj jako analizę wrażliwości.
Czy Mann–Whitney w teście A/B porównuje mediany czasu?
Nie. Testuje, czy losowa obserwacja z jednej grupy jest częściej większa niż z drugiej (P(X < Y) + ½ P(X = Y)) (Divine i in., 2018). W symulacji z dłuższym ogonem w wersji B mediana wszystkich sesji spadła o 4 s, a test odrzucał H0 tylko w 4.2% testów. Raportuj go z prawdopodobieństwem przewagi.
Jak interpretować test t na logarytmie czasu?
exp(różnicy średnich logarytmów) to iloraz średnich geometrycznych, nie zwykłych średnich. W przykładzie sesje zaangażowane trwały w wersji B 1.070 raza dłużej (95% CI [0.998, 1.148]). Logarytm nie istnieje dla zera, więc odbicia analizuj osobno (Feng i in., 2013).
Jak bootstrapować różnicę median w teście A/B?
Losuj ze zwracaniem sesje (albo użytkowników) osobno w każdej wersji, w każdej próbie policz obie mediany i ich różnicę, a z 2000 różnic weź 2.5. i 97.5. centyl. W przykładzie różnica median wyniosła 2 s, 95% CI [−2, 7]. Przy 1000 sesjach na wersję taki przedział obejmował prawdę w 95.8% symulowanych testów.
Co zrobić z botami i bardzo długimi sesjami?
Ustal przed testem filtr botów i próg winsoryzacji, wspólny dla obu wersji, np. 99. centyl z okresu przed testem. W przykładzie winsoryzacja zneutralizowała boty w liczbie odsłon (+24.0% → +0.7%), ale nie w czasie, bo boty siedziały przy limicie sesji. Przed odczytem wyników porównaj ogon rozkładu w wersjach (André, 2022).
Powiązane hasła
Przeczytaj też
Bootstrap – wizualizacja na obrazkach
Kulki losowane ze zwracaniem, rozkład średniej i mediany, 1000 badań o tym, kiedy przedział percentylowy zawodzi, różnica median i korelacja – pięć rysunków z kodem R.
Czytaj →PoradnikWskaźniki ilorazowe w testach A/B – CTR i średni koszyk
Losujesz użytkowników, a liczysz wyświetlenia i zamówienia: naiwny przedział, metoda delta, bootstrap po użytkownikach i 1000 testów A/A – z kodem R.
Czytaj →PoradnikPrzychód z zerami: dwie części i Tweedie
12 000 graczy gry mobilnej, 93% zer: logit × gamma, smearing, Tweedie z profilem p, kalibracja i test A/B przychodu – z kodem R.
Czytaj →Analizujesz test A/B ze skośną metryką w pracy dyplomowej?
Pomożemy wybrać miarę główną, zaplanować liczebność, policzyć przedziały bootstrapowe i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- André, Q. (2022). Outlier exclusion procedures must be blind to the researcher’s hypothesis. Journal of Experimental Psychology: General, 151(1), 213–223. https://doi.org/10.1037/xge0001069 ● Otwarty dostęp: pełny tekst
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies—a paradox of statistical practice? BMC Medical Research Methodology, 12(1), Article 78. https://doi.org/10.1186/1471-2288-12-78 ● Otwarty dostęp
- Feng, C., Wang, H., Lu, N., & Tu, X. M. (2013). Log transformation: Application and interpretation in biomedical research. Statistics in Medicine, 32(2), 230–239. https://doi.org/10.1002/sim.5486
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Limpert, E., Stahel, W. A., & Abbt, M. (2001). Log-normal distributions across the sciences: Keys and clues. BioScience, 51(5), 341–352. https://doi.org/10.1641/0006-3568(2001)051[0341:lndats]2.0.co;2
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods: Measures of central tendency. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
Cytowania BibTeX
@article{andre2022outlier, author={André, Quentin}, title={{Outlier exclusion procedures must be blind to the researcher’s hypothesis}}, journal={Journal of Experimental Psychology: General}, year={2022}, volume={151}, number={1}, pages={213--223}, doi={10.1037/xge0001069}}@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{fagerland2012ttests, author={Fagerland, Morten W.}, title={{t-tests, non-parametric tests, and large studies—a paradox of statistical practice?}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={78}, doi={10.1186/1471-2288-12-78}}@article{feng2013log, author={Feng, Changyong and Wang, Hongyue and Lu, Naiji and Tu, Xin M.}, title={{Log transformation: Application and interpretation in biomedical research}}, journal={Statistics in Medicine}, year={2013}, volume={32}, number={2}, pages={230--239}, doi={10.1002/sim.5486}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{limpert2001log, author={Limpert, Eckhard and Stahel, Werner A. and Abbt, Markus}, title={{Log-normal distributions across the sciences: Keys and clues}}, journal={BioScience}, year={2001}, volume={51}, number={5}, pages={341--352}, doi={10.1641/0006-3568(2001)051[0341:lndats]2.0.co;2}}@article{wilcox2003modern, author={Wilcox, Rand R. and Keselman, H. J.}, title={{Modern robust data analysis methods: Measures of central tendency}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={254--274}, doi={10.1037/1082-989x.8.3.254}}