Bootstrap: jedna próba udaje tysiące badań
Badania nie powtórzysz tysiąc razy, więc bootstrap robi to na niby. Losuje ze zwracaniem nowe próby z Twoich danych i w każdej liczy tę samą statystykę. Efron (1979) zaproponował to jako ogólny sposób przybliżania rozkładu statystyki z próby samymi danymi. Jednym z jego przykładów była wariancja mediany.
Procedurę w R z pakietem boot i testem permutacyjnym znajdziesz we wpisie bootstrap i test permutacyjny krok po kroku, a okno w SPSS – we wpisie bootstrap w SPSS. Tu pokazujemy sam mechanizm na rysunkach z serii „wizualizacja na obrazkach”.
Wszystkie dane są fikcyjne i wylosowane w kodzie. Każdy blok kodu zaczyna od set.seed(599). Ziarno ustalono raz i nie zmieniano go po obejrzeniu wyników; ręcznie dobrane parametry populacji wymieniamy przy kodzie. Odsetki z symulacji podajemy z błędem Monte Carlo, czyli niepewnością samej symulacji: √(p(1 − p)/1000), przy 1000 badaniach do 1.1 punktu procentowego (pp).
Rysunek 1: dwanaście kulek i losowanie ze zwracaniem
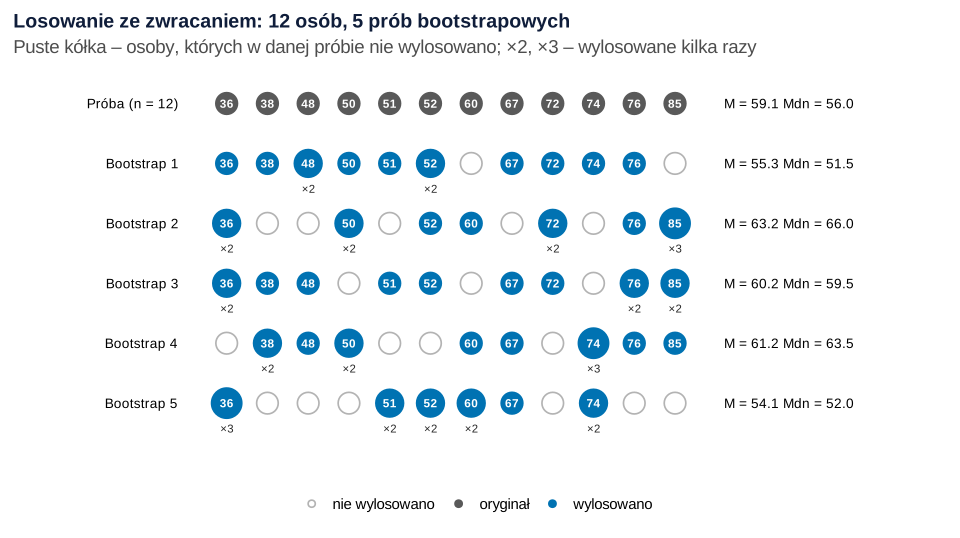
set.seed(599)).Dwanaście osób rozwiązało test wiedzy (0–100 punktów). Wyniki to 36, 38, 48, 50, 51, 52, 60, 67, 72, 74, 76 i 85: M = 59.08, Mdn = 56.00, SD = 15.69. Dane pobierzesz jako plik bootstrap-12-wynikow.csv.
Co widać. Każdy rząd to 12 losowań z „urny”, do której wylosowana kulka wraca. Dlatego wynik 36 trafił do próby 5 trzy razy, a 85 – trzy razy do próby 2. W próbach brakowało od 2 do 6 osób. Średnio poza próbą zostaje (11/12)12 = 35.2% osób. Średnie prób wahały się od 54.08 do 63.25, a mediany od 51.5 do 66.0.
Czego ten wykres nie pokazuje. Nowych osób. Żadna próba bootstrapowa nie zawiera wyniku spoza tych dwunastu: nie ma 30 ani 90, choć w populacji takie wyniki się zdarzają. Bootstrap przybliża zmienność statystyki tylko na tyle, na ile 12 osób przypomina populację. W analizie losuje się tysiące prób, nie pięć (rysunek 2).
Podpis do pracy (np. do prezentacji na obronę albo aneksu):
Zdanie do Metody:
Rysunek 2: rozkład bootstrapowy średniej i mediany
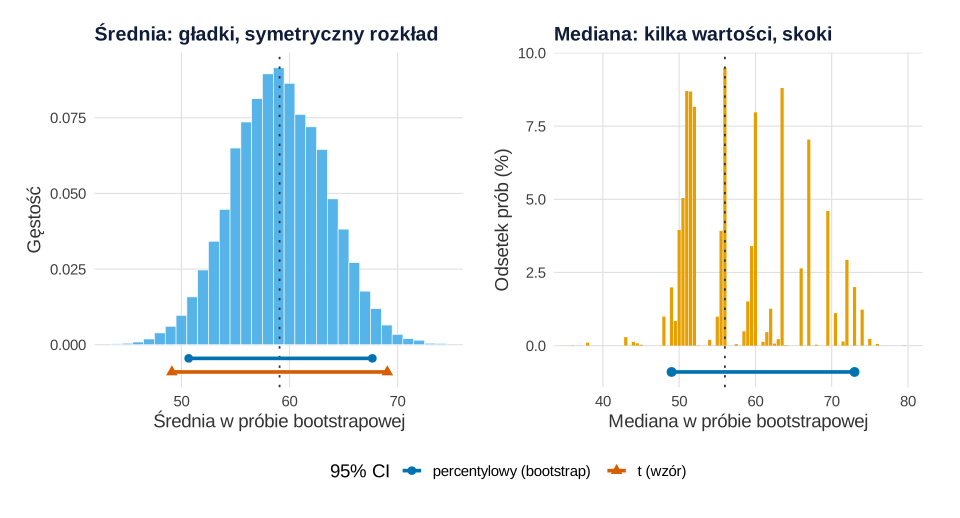
Co widać. Średnie z 10 000 prób układają się w gładki, symetryczny pagórek. Jego odchylenie standardowe to bootstrapowy błąd standardowy: 4.35 punktu, a obciążenie (średnia prób minus średnia z danych) – 0.04. Przedział percentylowy to 2.5. i 97.5. percentyl tych średnich: [50.67, 67.67]. Zwykły przedział t [49.11, 69.05] ma szerokość 19.94 punktu, a percentylowy – 17.00.
Prawy panel wygląda zupełnie inaczej. Mediana z 12 liczb to średnia dwóch środkowych, więc w 10 000 prób pojawiło się tylko 43 różnych wartości. Najczęstsze to 56 (9.5% prób), 63.5 (8.8%) i 51 (8.7%). Granice przedziału percentylowego [49.00, 73.00] to średnie dwóch sąsiednich wyników z próby (48 i 50 oraz 72 i 74). Bootstrapowy błąd standardowy mediany wynosi 7.41, a obciążenie 2.16.
Dlaczego przedział percentylowy jest węższy od t. Błąd standardowy z bootstrapu (4.35) prawie dokładnie równa się s/√n z mianownikiem n zamiast n − 1 (4.34). Wzór daje 4.53. Do tego percentyle bootstrapu odpowiadają w przybliżeniu mnożnikowi 1.96 z rozkładu normalnego, a przedział t przy 11 stopniach swobody używa 2.20. Skąd biorą się grubsze ogony rozkładu t, pokazuje wpis skąd się biorą rozkłady t, χ² i F. Przedział BCa dla średniej wyszedł tu identyczny jak percentylowy. Korekty obciążenia i przyspieszenia (szacowanego metodą jackknife) były bliskie zera. Jak działa ta korekta, opisuje hasło przedział bootstrapowy BCa. Efron (1987) przedstawił BCa jako przedział, który sam uwzględnia transformacje i korekty obciążenia.
Czego ten wykres nie pokazuje. Prawdziwego rozkładu średniej w populacji. Histogram jest wyśrodkowany na średniej z naszej próby (59.08), a nie na średniej populacji (60). Bootstrap mówi, jak bardzo wynik się chwieje, a nie gdzie leży prawda. Przy 12 osobach przedział percentylowy jest też za krótki (rysunek 3).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: kiedy bootstrap zawodzi – 1000 badań
Czy przedział „95%” obejmuje prawdziwą wartość w 95% badań? Sprawdzamy to symulacją, w której prawdę znamy. Dla każdej liczebności (6, 12, 24, 48 i 96 osób) losujemy 1000 badań z populacji o rozkładzie normalnym ze średnią i medianą 60. W każdym badaniu liczymy przedział t oraz percentylowe przedziały bootstrapowe dla średniej i mediany z 1000 prób. Drugi scenariusz to maksimum. Tramwaj kursuje co 20 minut, a czas czekania ma rozkład równomierny od 0 do 20 min. Szukamy przedziału dla najdłuższego możliwego czekania, czyli 20 min.
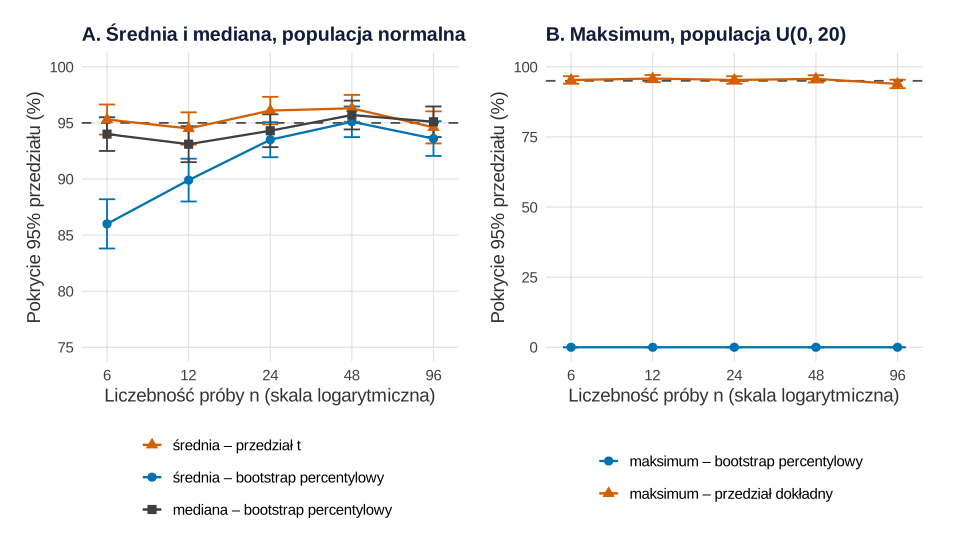
Co widać. Przedział t dla średniej trzyma 95% przy każdej liczebności (od 94.5% do 96.3%). Bootstrap percentylowy dla średniej przy 6 osobach obejmuje prawdę tylko w 86.0% badań, przy 12 – w 89.9%, a do okolic 95% dochodzi dopiero przy 48 osobach (95.1%). Powód to rachunek z rysunku 2: według przybliżenia z × s × √((n − 1)/n)/√n przedział percentylowy ma przy n = 6 tylko 0.696 szerokości przedziału t, przy n = 12 – 0.853 (dokładnie tyle co 17.00/19.94 na rysunku 2), a przy n = 96 już 0.982. Mediana wypadła lepiej, niż sugerowałyby jej „schodki”: od 93.1% do 95.7%. W panelu B bootstrap zawodzi całkowicie. Przedział percentylowy dla maksimum nie objął 20 min ani razu, przy żadnej liczebności (0%). Próba bootstrapowa nie może dać wartości większej niż największa obserwacja, a ta zawsze leży poniżej 20. Prosty przedział dokładny dla rozkładu równomiernego, od maksimum z próby do maksimum podzielonego przez 0.051/n, trafił w 93.9–95.8% badań.
Czego ten wykres nie pokazuje. Danych skośnych. Tu populacja jest normalna, więc przedział t jest dokładny z założenia. Symulacje dla danych silnie skośnych, przy których zawodzi także t, są we wpisach o bootstrapie w SPSS i przedziale ufności w obrazkach. Wynik zgadza się z przeglądem Hesterberga (2015): połączenie zwykłego bootstrapu z przedziałem percentylowym jest przy małych próbach mniej dokładne niż przedział t, a przy większych – dokładniejsze. Bickel i Freedman (1981) wykazali, że przybliżenie bootstrapowe jest asymptotycznie poprawne w wielu sytuacjach, ale podali też kontrprzykłady, w których zawodzi. Maksimum to podręcznikowy przypadek takiej porażki.
Podpis do pracy:
Zdanie do Metody (uzasadnienie wyboru przedziału przy małej próbie):
Rysunek 4: bootstrap różnicy median
Różnica median nie ma prostego wzoru na błąd standardowy – tu bootstrap jest naturalny. Przykład: czas wypełnienia formularza zgłoszeniowego w starej wersji (n = 18, Mdn = 12.40 min) i w nowej (n = 22, Mdn = 10.25 min). Losujemy osobno w każdej grupie (argument strata), żeby każda próba bootstrapowa miała 18 + 22 osoby. Dane: bootstrap-czas-formularza.csv.
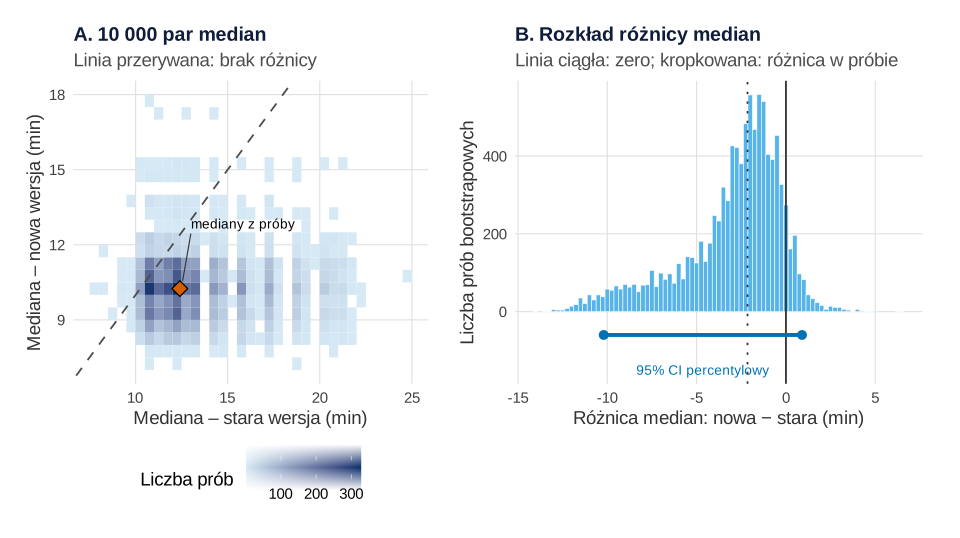
Co widać. Lewy panel pokazuje, skąd bierze się niepewność różnicy. Mediana nowej wersji jest stabilna (pionowo wąsko), a mediana starej wersji rozciąga się szeroko w prawo. Kilka długich czasów w starej grupie sprawia, że jej mediana skacze. Różnica w próbie to −2.15 min, a bootstrapowy błąd standardowy – 2.84 min. Rozkład różnicy ma długi lewy ogon, dlatego przedział percentylowy [−10.20, 0.90] jest mocno niesymetryczny wokół −2.15 min. Przedział BCa to [−9.95, 1.10]. Oba obejmują zero, a w 9.0% prób nowa wersja nie była szybsza.
Czego ten wykres nie pokazuje. Zmiany u każdej osoby – różnica median opisuje środek rozkładów. Obciążenie −0.83 min przy różnicy −2.15 min ostrzega, że przy 18 osobach rozkład mediany jest nieregularny. Przedział jest wtedy przybliżony, nawet z korektą BCa. Inną miarą przesunięcia, z prostszym przedziałem, jest estymator Hodgesa–Lehmanna, a hipotezę o braku różnicy sprawdzisz testem permutacyjnym.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: bootstrap korelacji – losuj całe pary
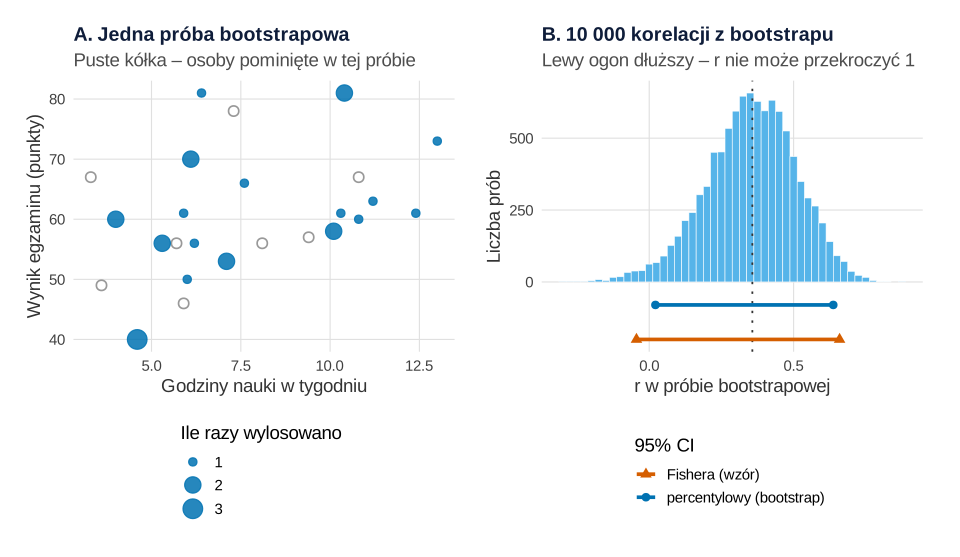
Dwadzieścia pięć osób podało liczbę godzin nauki w tygodniu przed egzaminem, a obok mamy ich wynik (populacja: ρ = .50). Dane: bootstrap-godziny-i-wynik.csv.
Co widać. Losujemy osoby, a nie liczby: każdy punkt przenosi oba wyniki tej samej osoby, więc związek zostaje zachowany. W tej jednej próbie pominięto 8 osób, a r wyniosło .473. W próbie badanej r = .357, bootstrapowy błąd standardowy – .156. Rozkład 10 000 korelacji ma dłuższy lewy ogon (skośność −0.29), bo r nie przekroczy 1. Przedział percentylowy [.022, .637] i BCa [.011, .631] wykluczają zero. Przedział z transformacji Fishera [−.044, .659] go nie wyklucza.
Czego ten wykres nie pokazuje. Który przedział jest bliżej prawdy. Sprawdziliśmy to w 1000 badaniach na danych normalnych z ρ = .50. Przedział Fishera objął prawdziwą korelację w 95.6% badań przy n = 15, w 95.2% przy n = 30 i w 95.0% przy n = 60. Bootstrap percentylowy osiągnął 92.1%, 92.9% i 92.9% (błąd Monte Carlo 0.81–0.85 pp). Przy danych normalnych bootstrap był więc za wąski, a jego „istotność” to w dużej części efekt zbyt krótkiego przedziału. Metodę wybierz przed analizą i nie zmieniaj jej na tę, która daje p < .05. Przy danych skośnych albo z obserwacjami odstającymi bootstrap trzeba uzasadnić. Więcej o przedziałach korelacji – we wpisie korelacje na wykresie.
Podpis do pracy:
Zdanie do Wyników:
Co zrobić w praktyce
- Sprawdź, czy bootstrap jest potrzebny. Dla średniej z danych bez silnej skośności wystarczy przedział t, a dla korelacji – przedział Fishera. Bootstrap przydaje się tam, gdzie wzoru brak: przy medianie, różnicy median czy efekcie pośrednim (mediacja w obrazkach).
- Losuj to, co było losowane w badaniu. Całe osoby (pary wyników), osobno w grupach o ustalonej liczebności, całe klasy przy danych zagnieżdżonych. Przy szeregach czasowych potrzebny jest bootstrap blokowy, a gdy zakładasz konkretny model – bootstrap parametryczny.
- Nie licz na bootstrap przy kilku osobach ani dla statystyk zależnych od jednej skrajnej obserwacji (maksimum, minimum, skrajne centyle). Zobacz wpis analiza na małej próbie.
- Wybierz rodzaj przedziału przed analizą i podaj go w Metodzie razem z liczbą prób i ziarnem. DiCiccio i Efron (1996) opisują BCa i inne ulepszone przedziały bootstrapowe, których celem jest wyraźnie większa dokładność niż w przedziale „oszacowanie ± z × SE”. Pełny wykład metod zawierają podręczniki Efrona i Tibshiraniego (1993) oraz Davisona i Hinkleya (1997).
- Pokaż rozkład bootstrapowy (rysunek 2 lub 4) w aneksie, gdy jest skośny albo schodkowy – widać wtedy, skąd niesymetryczny przedział. Ogólne zasady rysunków są we wpisie wykresy w pracy dyplomowej.
Zdanie do pracy dyplomowej (Metoda, opis analiz):
Ten sam mechanizm stoi za bootstrapem w modelach strukturalnych (bootstrap w SEM). Inne wpisy z serii wizualizacja na obrazkach pokazują między innymi moderację i metaanalizę.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom bloki po kolei w jednej sesji R: blok 1 tworzy motyw motyw, paletę kol i 12 wyników x, z których korzystają następne. Każdy blok, który losuje, zaczyna od set.seed(599), więc po bloku 1 da się go powtórzyć niezależnie od pozostałych. Blok z rysunkiem kończy się nazwą wykresu (p1–p5); zapis do SVG – ggsave() z komentarza. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Ręcznie ustalono: populację wyników testu N(60, 15) i n = 12; liczebności w symulacji (6–96), 1000 badań i 1000 prób bootstrapowych na badanie; rozkład czasu czekania U(0, 20); parametry czasu wypełnienia formularza (rozkład log-normalny z medianami 14 i 11 min, σ logarytmu 0.45, n = 18 i 22); korelację ρ = .50 i n = 25 (godziny: średnia 8, SD 3; wynik: średnia 60, SD 12). Parametry i ziarno ustalono przed obliczeniami i nie zmieniano ich po obejrzeniu wyników.
1. Motyw, paleta, 12 wyników i pięć prób bootstrapowych: rysunek 1
R
# Rysunek 1. Losowanie ze zwracaniem na 12 kulkach (dane fikcyjne: wynik testu wiedzy 0–100 punktów)
library(ggplot2)

# Motyw i paleta Okabe–Ito (niebieski, cynober i pomarańczowy rozróżnialne także przy deuteranopii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol <- c(boot = "#0072B2", t = "#D55E00", trzeci = "#E69F00", jasny = "#56B4E9", szary = "grey60")

# Populacja fikcyjna: wyniki testu ~ N(60, 15), więc średnia i mediana populacji = 60
set.seed(599)                                   # ziarno ustalone raz, bez dobierania pod wynik
x <- sort(round(rnorm(12, mean = 60, sd = 15)))  # nasza jedyna próba: 12 osób
x
round(c(srednia = mean(x), mediana = median(x), SD = sd(x)), 2)

# Pięć prób bootstrapowych: 12 losowań ze zwracaniem z tych samych 12 osób
proby <- t(replicate(5, sample(1:12, size = 12, replace = TRUE)))
licz <- t(apply(proby, 1, tabulate, nbins = 12))  # ile razy wylosowano każdą osobę
dimnames(licz) <- list(paste("próba", 1:5), paste0("os", 1:12))
licz
data.frame(proba = 1:5, srednia = round(apply(proby, 1, function(i) mean(x[i])), 2),
           mediana = apply(proby, 1, function(i) median(x[i])), pominieto_osob = rowSums(licz == 0))
round(c(oczekiwany_odsetek_pominietych = (1 - 1/12)^12), 3)   # osoba nie trafia do próby z p = (11/12)^12

# Dane do rysunku: wiersz 0 = oryginał, wiersze 1–5 = próby bootstrapowe
d1 <- rbind(data.frame(wiersz = 0, osoba = 1:12, ile = 1),
            do.call(rbind, lapply(1:5, function(b) data.frame(wiersz = b, osoba = 1:12, ile = licz[b, ]))))
d1$wartosc <- x[d1$osoba]
d1$stan <- ifelse(d1$wiersz == 0, "oryginał", ifelse(d1$ile == 0, "nie wylosowano", "wylosowano"))
opis <- data.frame(wiersz = 0:5, etykieta = c("Próba (n = 12)", paste("Bootstrap", 1:5)),
                   statystyki = c(sprintf("M = %.1f   Mdn = %.1f", mean(x), median(x)),
                                  sprintf("M = %.1f   Mdn = %.1f", apply(proby, 1, function(i) mean(x[i])),
                                          apply(proby, 1, function(i) median(x[i])))))
p1 <- ggplot(d1, aes(osoba, -wiersz)) +
  geom_point(aes(fill = stan, colour = stan, size = pmax(ile, 1)), shape = 21, stroke = 0.9) +
  geom_text(aes(label = wartosc), data = subset(d1, ile > 0), colour = "white", size = 3.1, fontface = "bold") +
  geom_text(aes(label = paste0("×", ile)), data = subset(d1, ile > 1 & wiersz > 0),
            nudge_y = -0.42, size = 3, colour = "grey15") +
  geom_text(data = opis, aes(x = -0.2, y = -wiersz, label = etykieta), hjust = 1, size = 3.6, inherit.aes = FALSE) +
  geom_text(data = opis, aes(x = 13.2, y = -wiersz, label = statystyki), hjust = 0, size = 3.6, inherit.aes = FALSE) +
  scale_fill_manual(values = c(`oryginał` = "grey35", wylosowano = kol[["boot"]], `nie wylosowano` = "white"), name = NULL) +
  scale_colour_manual(values = c(`oryginał` = "grey35", wylosowano = kol[["boot"]], `nie wylosowano` = "grey70"), name = NULL) +
  scale_size_continuous(range = c(7, 10), guide = "none") +
  scale_x_continuous(limits = c(-3.2, 17.5), breaks = NULL) +
  scale_y_continuous(breaks = NULL, expand = expansion(add = 0.6)) +
  labs(x = NULL, y = NULL, title = "Losowanie ze zwracaniem: 12 osób, 5 prób bootstrapowych",
       subtitle = "Puste kółka – osoby, których w danej próbie nie wylosowano; ×2, ×3 – wylosowane kilka razy") +
  motyw + theme(panel.grid.major = element_blank())
p1   # zapis: ggsave("bootstrap-12-kulek.svg", p1, width = 10, height = 5.6)
Wynik w R
 [1] 36 38 48 50 51 52 60 67 72 74 76 85
srednia mediana      SD
  59.08   56.00   15.69
        os1 os2 os3 os4 os5 os6 os7 os8 os9 os10 os11 os12
próba 1   1   1   2   1   1   2   0   1   1    1    1    0
próba 2   2   0   0   2   0   1   1   0   2    0    1    3
próba 3   2   1   1   0   1   1   0   1   1    0    2    2
próba 4   0   2   1   2   0   0   1   1   0    3    1    1
próba 5   3   0   0   0   2   2   2   1   0    2    0    0
        proba srednia mediana pominieto_osob
próba 1     1   55.33    51.5              2
próba 2     2   63.25    66.0              5
próba 3     3   60.17    59.5              3
próba 4     4   61.17    63.5              4
próba 5     5   54.08    52.0              6
oczekiwany_odsetek_pominietych
                         0.352
2. Rozkład bootstrapowy średniej i mediany: rysunek 2
R
# Rysunek 2. Rozkład bootstrapowy średniej i mediany z 12 wyników (kontynuacja: x, kol, motyw z bloku 1)
library(boot)
library(patchwork)
set.seed(599)
B <- 10000                                       # liczba prób bootstrapowych
b_sr <- boot(x, function(d, i) mean(d[i]), R = B)
b_md <- boot(x, function(d, i) median(d[i]), R = B)

# Bootstrapowy błąd standardowy i obciążenie; dla średniej porównanie z SE ze wzoru s / √n
round(c(SE_boot_srednia = sd(b_sr$t), SE_wzor = sd(x) / sqrt(12), SE_wzor_z_n = sd(x) * sqrt(11 / 12) / sqrt(12),
        obciazenie_srednia = mean(b_sr$t) - mean(x), SE_boot_mediana = sd(b_md$t),
        obciazenie_mediana = mean(b_md$t) - median(x)), 2)

# Przedziały 95%: percentylowy i BCa (boot.ci) oraz zwykły przedział t dla średniej
ci_sr <- boot.ci(b_sr, conf = .95, type = c("perc", "bca"))
ci_md <- boot.ci(b_md, conf = .95, type = c("perc", "bca"))
ci_t <- t.test(x)$conf.int
przedzialy <- rbind(srednia_t = ci_t[1:2], srednia_percentylowy = ci_sr$percent[4:5], srednia_BCa = ci_sr$bca[4:5],
                    mediana_percentylowy = ci_md$percent[4:5], mediana_BCa = ci_md$bca[4:5])
colnames(przedzialy) <- c("dolna", "gorna")
cbind(round(przedzialy, 2), szerokosc = round(przedzialy[, 2] - przedzialy[, 1], 2))
round(c(mnoznik_z = qnorm(.975), mnoznik_t_df11 = qt(.975, 11)), 2)   # percentyle bootstrapu ≈ z, przedział t używa t

# Mediana z 12 liczb przyjmuje niewiele wartości: ile różnych median w 10 000 prób i jak częste są trzy najczęstsze
length(unique(b_md$t))
head(sort(round(100 * table(b_md$t) / B, 1), decreasing = TRUE), 3)

# Wykres: lewy panel – histogram średnich, prawy – słupki częstości median (wartości dyskretne)
pod <- function(lo, hi, y, typ) data.frame(lo = lo, hi = hi, y = y, typ = typ)
odc_sr <- rbind(pod(ci_sr$percent[4], ci_sr$percent[5], -0.0045, "percentylowy (bootstrap)"),
                pod(ci_t[1], ci_t[2], -0.009, "t (wzór)"))
odc_md <- pod(ci_md$percent[4], ci_md$percent[5], -0.9, "percentylowy (bootstrap)")
p2a <- ggplot(data.frame(t = b_sr$t), aes(t)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 1, fill = kol[["jasny"]], colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = mean(x), linetype = "dotted", colour = "grey20") +
  geom_segment(data = odc_sr, aes(x = lo, xend = hi, y = y, yend = y, colour = typ), linewidth = 1.3, inherit.aes = FALSE) +
  geom_point(data = rbind(transform(odc_sr, v = lo), transform(odc_sr, v = hi)),
             aes(v, y, colour = typ, shape = typ), size = 2.6, inherit.aes = FALSE) +
  scale_colour_manual(values = c(`percentylowy (bootstrap)` = kol[["boot"]], `t (wzór)` = kol[["t"]]), name = "95% CI") +
  scale_shape_manual(values = c(`percentylowy (bootstrap)` = 16, `t (wzór)` = 17), name = "95% CI") +
  labs(x = "Średnia w próbie bootstrapowej", y = "Gęstość", title = "Średnia: gładki, symetryczny rozkład") + motyw
d_md <- as.data.frame(table(mediana = b_md$t)); d_md$mediana <- as.numeric(as.character(d_md$mediana))
d_md$procent <- 100 * d_md$Freq / B
p2b <- ggplot(d_md, aes(mediana, procent)) +
  geom_col(width = 0.42, fill = kol[["trzeci"]]) +
  geom_vline(xintercept = median(x), linetype = "dotted", colour = "grey20") +
  geom_segment(data = odc_md, aes(x = lo, xend = hi, y = y, yend = y), colour = kol[["boot"]], linewidth = 1.3, inherit.aes = FALSE) +
  geom_point(data = data.frame(v = c(odc_md$lo, odc_md$hi), y = odc_md$y), aes(v, y), colour = kol[["boot"]],
             size = 2.6, inherit.aes = FALSE) +
  labs(x = "Mediana w próbie bootstrapowej", y = "Odsetek prób (%)", title = "Mediana: kilka wartości, skoki") + motyw
p2 <- p2a + p2b + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("bootstrap-srednia-i-mediana.svg", p2, width = 10, height = 5.4)
Wynik w R
   SE_boot_srednia            SE_wzor        SE_wzor_z_n obciazenie_srednia
              4.35               4.53               4.34               0.04
   SE_boot_mediana obciazenie_mediana
              7.41               2.16
                     dolna gorna szerokosc
srednia_t            49.11 69.05     19.94
srednia_percentylowy 50.67 67.67     17.00
srednia_BCa          50.67 67.67     17.00
mediana_percentylowy 49.00 73.00     24.00
mediana_BCa          48.00 72.00     24.00
     mnoznik_z mnoznik_t_df11
          1.96           2.20
[1] 43

  56 63.5   51
 9.5  8.8  8.7
3. Symulacja 1000 badań: pokrycie przedziałów dla średniej, mediany i maksimum: rysunek 3
R
# Rysunek 3. Kiedy bootstrap zawodzi: pokrycie 95% przedziałów w 1000 badaniach (kontynuacja: kol, motyw)
library(patchwork)
set.seed(599)
badania <- 1000; B <- 1000; ns <- c(6, 12, 24, 48, 96)
mediana_wierszy <- function(M) {                 # szybka mediana każdego wiersza (bez pętli po wierszach)
  S <- matrix(M[order(row(M), M)], nrow = nrow(M), byrow = TRUE); k <- ncol(M)
  if (k %% 2) S[, (k + 1) / 2] else (S[, k / 2] + S[, k / 2 + 1]) / 2
}
tabela <- function(d) {                          # pokrycie w % w układzie: wiersz = n, kolumna = metoda
  w <- reshape(transform(d[, c("n", "metoda", "pokrycie")], pokrycie = round(100 * pokrycie, 1)),
               idvar = "n", timevar = "metoda", direction = "wide")
  names(w) <- sub("^pokrycie\\.", "", names(w)); print(w, row.names = FALSE)
}
perc <- function(v) quantile(v, c(.025, .975), names = FALSE)   # przedział percentylowy

# A. Populacja jak w bloku 1: N(60, 15) – średnia = mediana = 60
wyn_A <- do.call(rbind, lapply(ns, function(n) {
  traf <- replicate(badania, {
    x <- rnorm(n, 60, 15)
    M <- matrix(x[sample.int(n, B * n, replace = TRUE)], nrow = B)   # B prób bootstrapowych naraz
    ct <- t.test(x)$conf.int; cs <- perc(rowMeans(M)); cm <- perc(mediana_wierszy(M))
    c(srednia_t = ct[1] <= 60 & 60 <= ct[2], srednia_percentylowy = cs[1] <= 60 & 60 <= cs[2],
      mediana_percentylowy = cm[1] <= 60 & 60 <= cm[2])
  })
  data.frame(n = n, metoda = rownames(traf), pokrycie = rowMeans(traf))
}))
wyn_A$blad_MC <- sqrt(wyn_A$pokrycie * (1 - wyn_A$pokrycie) / badania)
tabela(wyn_A)
round(100 * max(wyn_A$blad_MC), 2)               # największy błąd Monte Carlo (pp)

# Dlaczego percentylowy jest za wąski przy małym n: dla średniej ≈ z × s × √((n − 1)/n) / √n zamiast t × s / √n
round(data.frame(n = ns, szerokosc_percentylowy_do_t = qnorm(.975) * sqrt((ns - 1) / ns) / qt(.975, ns - 1)), 3)

# B. Maksimum: czas czekania na tramwaj kursujący co 20 min ~ U(0, 20); parametr = 20 min
wyn_B <- do.call(rbind, lapply(ns, function(n) {
  traf <- replicate(badania, {
    x <- runif(n, 0, 20)
    M <- matrix(x[sample.int(n, B * n, replace = TRUE)], nrow = B)
    cb <- perc(M[cbind(1:B, max.col(M, ties.method = "first"))])
    c(maksimum_percentylowy = cb[1] <= 20 & 20 <= cb[2],
      maksimum_dokladny = max(x) <= 20 & 20 <= max(x) / 0.05^(1 / n))   # przedział [max, max / 0.05^(1/n)]
  })
  data.frame(n = n, metoda = rownames(traf), pokrycie = rowMeans(traf))
}))
wyn_B$blad_MC <- sqrt(wyn_B$pokrycie * (1 - wyn_B$pokrycie) / badania)
tabela(wyn_B)

# Wykres: pokrycie z ±2 błędami Monte Carlo
etyk <- c(srednia_t = "średnia – przedział t", srednia_percentylowy = "średnia – bootstrap percentylowy",
          mediana_percentylowy = "mediana – bootstrap percentylowy",
          maksimum_percentylowy = "maksimum – bootstrap percentylowy", maksimum_dokladny = "maksimum – przedział dokładny")
kolory3 <- c(kol[["t"]], kol[["boot"]], "grey25", kol[["boot"]], kol[["t"]]); names(kolory3) <- etyk
ksztalty <- c(17, 16, 15, 16, 17); names(ksztalty) <- etyk
rys_pokr <- function(d, tytul, lim) {
  d$metoda <- factor(etyk[d$metoda], levels = etyk[etyk %in% etyk[unique(d$metoda)]])
  ggplot(d, aes(n, 100 * pokrycie, colour = metoda, shape = metoda)) +
    geom_hline(yintercept = 95, linetype = "dashed", colour = "grey30") +
    geom_errorbar(aes(ymin = 100 * (pokrycie - 2 * blad_MC), ymax = 100 * (pokrycie + 2 * blad_MC)), width = 0.06) +
    geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
    scale_x_log10(breaks = ns) + scale_y_continuous(limits = lim) +
    scale_colour_manual(values = kolory3, name = NULL) + scale_shape_manual(values = ksztalty, name = NULL) +
    guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
    labs(x = "Liczebność próby n (skala logarytmiczna)", y = "Pokrycie 95% przedziału (%)", title = tytul) + motyw
}
p3 <- rys_pokr(wyn_A, "A. Średnia i mediana, populacja normalna", c(75, 100)) +
  rys_pokr(wyn_B, "B. Maksimum, populacja U(0, 20)", c(0, 100))
p3   # zapis: ggsave("bootstrap-pokrycie-1000-badan.svg", p3, width = 10, height = 5.8)
Wynik w R
  n srednia_t srednia_percentylowy mediana_percentylowy
  6      95.3                 86.0                 94.0
 12      94.5                 89.9                 93.1
 24      96.1                 93.5                 94.3
 48      96.3                 95.1                 95.7
 96      94.6                 93.6                 95.1
[1] 1.1
   n szerokosc_percentylowy_do_t
1  6                       0.696
2 12                       0.853
3 24                       0.928
4 48                       0.964
5 96                       0.982
  n maksimum_percentylowy maksimum_dokladny
  6                     0              95.3
 12                     0              95.8
 24                     0              95.3
 48                     0              95.7
 96                     0              93.9
4. Bootstrap różnicy median w dwóch grupach: rysunek 4
R
# Rysunek 4. Bootstrap różnicy median w dwóch grupach (kontynuacja: kol, motyw; dane fikcyjne)
# Czas wypełnienia formularza zgłoszeniowego (min): stara wersja (n = 18) i nowa wersja (n = 22)
library(boot)
library(patchwork)
set.seed(599)
dane4 <- data.frame(wersja = rep(c("stara", "nowa"), c(18, 22)),
                    czas = round(c(rlnorm(18, log(14), 0.45), rlnorm(22, log(11), 0.45)), 1))
aggregate(czas ~ wersja, dane4, function(v) round(c(n = length(v), mediana = median(v), srednia = mean(v)), 2))
roznica <- function(d, i) {                      # mediana(nowa) − mediana(stara) w próbie bootstrapowej
  d <- d[i, ]; c(median(d$czas[d$wersja == "nowa"]) - median(d$czas[d$wersja == "stara"]),
                 median(d$czas[d$wersja == "stara"]), median(d$czas[d$wersja == "nowa"]))
}
b4 <- boot(dane4, roznica, R = 10000, strata = factor(dane4$wersja))   # losowanie osobno w każdej grupie
round(c(roznica_w_probie = b4$t0[1], SE_boot = sd(b4$t[, 1]), obciazenie = mean(b4$t[, 1]) - b4$t0[1]), 2)
ci4 <- boot.ci(b4, conf = .95, type = c("perc", "bca"), index = 1)
round(rbind(percentylowy = c(dolna = ci4$percent[4], gorna = ci4$percent[5]), BCa = ci4$bca[4:5]), 2)
round(100 * mean(b4$t[, 1] >= 0), 1)             # % prób bootstrapowych, w których nowa wersja nie była szybsza

# Wykres: A – pary median z każdej próby bootstrapowej, B – rozkład ich różnicy
d4 <- data.frame(stara = b4$t[, 2], nowa = b4$t[, 3], roznica = b4$t[, 1])
p4a <- ggplot(d4, aes(stara, nowa)) +
  geom_bin_2d(binwidth = c(0.5, 0.5)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey30") +
  annotate("point", x = b4$t0[2], y = b4$t0[3], shape = 23, size = 4, fill = kol[["t"]], colour = "black") +
  annotate("text", x = b4$t0[2] + 0.6, y = b4$t0[3] + 2.6, label = "mediany z próby", hjust = 0, size = 3.6) +
  annotate("segment", x = b4$t0[2] + 0.6, xend = b4$t0[2] + 0.15, y = b4$t0[3] + 2.2, yend = b4$t0[3] + 0.3,
           colour = "grey20", linewidth = 0.4) +
  scale_fill_gradient(low = "#D6E9F5", high = "#08306B", name = "Liczba prób") +
  labs(x = "Mediana – stara wersja (min)", y = "Mediana – nowa wersja (min)",
       title = "A. 10 000 par median", subtitle = "Linia przerywana: brak różnicy") + motyw +
  theme(legend.key.width = unit(1.2, "cm"))
p4b <- ggplot(d4, aes(roznica)) +
  geom_histogram(binwidth = 0.25, fill = kol[["jasny"]], colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 0, colour = "grey20") +
  geom_vline(xintercept = b4$t0[1], linetype = "dotted", colour = "grey20") +
  annotate("segment", x = ci4$percent[4], xend = ci4$percent[5], y = -60, yend = -60, colour = kol[["boot"]], linewidth = 1.4) +
  annotate("point", x = ci4$percent[4:5], y = -60, colour = kol[["boot"]], size = 2.6) +
  annotate("text", x = mean(ci4$percent[4:5]), y = -150, label = "95% CI percentylowy", colour = kol[["boot"]], size = 3.6) +
  labs(x = "Różnica median: nowa − stara (min)", y = "Liczba prób bootstrapowych",
       title = "B. Rozkład różnicy median", subtitle = "Linia ciągła: zero; kropkowana: różnica w próbie") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1, 1.15))
p4   # zapis: ggsave("bootstrap-roznica-median.svg", p4, width = 10, height = 5.6)
Wynik w R
  wersja czas.n czas.mediana czas.srednia
1   nowa  22.00        10.25        12.28
2  stara  18.00        12.40        15.18
roznica_w_probie          SE_boot       obciazenie
           -2.15             2.84            -0.83
              dolna gorna
percentylowy -10.20   0.9
BCa           -9.95   1.1
[1] 9
5. Bootstrap korelacji i pokrycie przedziałów w 1000 badaniach: rysunek 5
R
# Rysunek 5. Bootstrap korelacji: losujemy całe pary (kontynuacja: kol, motyw; dane fikcyjne)
# 25 osób: liczba godzin nauki w tygodniu przed egzaminem i wynik egzaminu (populacja: ρ = .50)
library(boot)
library(patchwork)
set.seed(599)
n5 <- 25; rho <- .5
z1 <- rnorm(n5); z2 <- rho * z1 + sqrt(1 - rho^2) * rnorm(n5)
dane5 <- data.frame(godziny = round(8 + 3 * z1, 1), wynik = round(60 + 12 * z2))
ct <- cor.test(dane5$godziny, dane5$wynik)       # r Pearsona i przedział z transformacji Fishera
b5 <- boot(dane5, function(d, i) cor(d$godziny[i], d$wynik[i]), R = 10000)
ci5 <- boot.ci(b5, conf = .95, type = c("perc", "bca"))
round(c(r = unname(ct$estimate), SE_boot = sd(b5$t), obciazenie = mean(b5$t) - b5$t0), 3)
round(rbind(Fisher = c(dolna = ct$conf.int[1], gorna = ct$conf.int[2]), percentylowy = ci5$percent[4:5], BCa = ci5$bca[4:5]), 3)
round(c(skosnosc_rozkladu_r = mean((b5$t - mean(b5$t))^3) / sd(b5$t)^3), 2)

# Jedna próba bootstrapowa do lewego panelu (wiersze losowane razem: para zostaje parą)
i1 <- sample.int(n5, n5, replace = TRUE)
dane5$ile <- tabulate(i1, nbins = n5)
round(c(r_w_tej_probie = cor(dane5$godziny[i1], dane5$wynik[i1]), pominieto_osob = sum(dane5$ile == 0)), 3)

# Pokrycie w 1000 badaniach: przedział Fishera vs bootstrap percentylowy (dane normalne, ρ = .50)
set.seed(599)
pokr5 <- t(sapply(c(15, 30, 60), function(n) {
  traf <- replicate(1000, {
    a <- rnorm(n); b <- rho * a + sqrt(1 - rho^2) * rnorm(n)
    I <- matrix(sample.int(n, 1000 * n, replace = TRUE), nrow = 1000)
    A <- matrix(a[I], nrow = 1000); Bm <- matrix(b[I], nrow = 1000)
    r_b <- (rowMeans(A * Bm) - rowMeans(A) * rowMeans(Bm)) /
      sqrt((rowMeans(A^2) - rowMeans(A)^2) * (rowMeans(Bm^2) - rowMeans(Bm)^2))
    cf <- cor.test(a, b)$conf.int; cp <- quantile(r_b, c(.025, .975), na.rm = TRUE)
    c(Fisher = cf[1] <= rho & rho <= cf[2], percentylowy = cp[[1]] <= rho & rho <= cp[[2]])
  })
  c(n = n, round(100 * rowMeans(traf), 1))
}))
pokr5
round(100 * sqrt(pokr5[, "percentylowy"] / 100 * (1 - pokr5[, "percentylowy"] / 100) / 1000), 2)   # błąd MC (pp)

# Wykres
p5a <- ggplot(dane5, aes(godziny, wynik)) +
  geom_point(data = subset(dane5, ile == 0), shape = 21, size = 3, colour = "grey60", fill = "white", stroke = 0.9) +
  geom_point(data = subset(dane5, ile > 0), aes(size = ile), colour = kol[["boot"]], alpha = 0.85) +
  scale_size_continuous(range = c(2.5, 6.5), breaks = 1:max(dane5$ile), name = "Ile razy wylosowano") +
  labs(x = "Godziny nauki w tygodniu", y = "Wynik egzaminu (punkty)", title = "A. Jedna próba bootstrapowa",
       subtitle = "Puste kółka – osoby pominięte w tej próbie") + motyw
odc5 <- data.frame(lo = c(ci5$percent[4], ct$conf.int[1]), hi = c(ci5$percent[5], ct$conf.int[2]),
                   y = c(-80, -200), typ = c("percentylowy (bootstrap)", "Fishera (wzór)"))
p5b <- ggplot(data.frame(r = b5$t), aes(r)) +
  geom_histogram(binwidth = 0.025, fill = kol[["jasny"]], colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = b5$t0, linetype = "dotted", colour = "grey20") +
  geom_segment(data = odc5, aes(x = lo, xend = hi, y = y, yend = y, colour = typ), linewidth = 1.3, inherit.aes = FALSE) +
  geom_point(data = rbind(transform(odc5, v = lo), transform(odc5, v = hi)), aes(v, y, colour = typ, shape = typ),
             size = 2.6, inherit.aes = FALSE) +
  scale_colour_manual(values = c(`percentylowy (bootstrap)` = kol[["boot"]], `Fishera (wzór)` = kol[["t"]]), name = "95% CI") +
  scale_shape_manual(values = c(`percentylowy (bootstrap)` = 16, `Fishera (wzór)` = 17), name = "95% CI") +
  labs(x = "r w próbie bootstrapowej", y = "Liczba prób", title = "B. 10 000 korelacji z bootstrapu",
       subtitle = "Lewy ogon dłuższy – r nie może przekroczyć 1") + motyw +
  theme(legend.direction = "vertical")
p5 <- p5a + p5b
p5   # zapis: ggsave("bootstrap-korelacja.svg", p5, width = 10, height = 5.8)
Wynik w R
         r    SE_boot obciazenie
     0.357      0.156     -0.004
              dolna gorna
Fisher       -0.044 0.659
percentylowy  0.022 0.637
BCa           0.011 0.631
skosnosc_rozkladu_r
              -0.29
r_w_tej_probie pominieto_osob
         0.473          8.000
      n Fisher percentylowy
[1,] 15   95.6         92.1
[2,] 30   95.2         92.9
[3,] 60   95.0         92.9
[1] 0.85 0.81 0.81
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (bootstrap / wzór)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (średnia / mediana)" = c("#0072B2", "#E69F00"),
             "cynober – ciemnoszary (t / mediana, rys. 3A)" = c("#D55E00", "#404040"),
             "niebieski – jasnoniebieski (przedział / histogram)" = c("#0072B2", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {                         # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                   widzenie_typowe deuteranopia
niebieski – cynober (bootstrap / wzór)                       114.6        108.3
niebieski – pomarańczowy (średnia / mediana)                 120.2        121.5
cynober – ciemnoszary (t / mediana, rys. 3A)                  81.3         69.9
niebieski – jasnoniebieski (przedział / histogram)            26.4         24.7
czerwony – zielony (do unikania)                             121.7         21.1
                                                   protanopia
niebieski – cynober (bootstrap / wzór)                   91.9
niebieski – pomarańczowy (średnia / mediana)            109.3
cynober – ciemnoszary (t / mediana, rys. 3A)             57.6
niebieski – jasnoniebieski (przedział / histogram)       24.6
czerwony – zielony (do unikania)                         31.6
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Bootstrap policzono pakietem boot, a symulacje – funkcjami pakietów base i stats. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Bootstrap stworzył 10 000 nowych obserwacji”. Wszystkie próby pochodzą z tych samych osób (rysunek 1).
- Przedział percentylowy przy kilku osobach. Przy n = 6 obejmował średnią w 86.0% badań zamiast 95% (rysunek 3).
- Bootstrap maksimum, minimum albo skrajnych centyli. Pokrycie 0% w każdej symulacji (rysunek 3).
- Losowanie pojedynczych wartości zamiast całych osób albo z całej próby, gdy grupy miały ustaloną liczebność (rysunki 4 i 5).
- Wybór przedziału po wyniku. Bootstrap „dał istotność”, Fisher nie – a w symulacji to Fisher trzymał 95% (rysunek 5).
Najczęstsze pytania
Dlaczego przedział percentylowy jest węższy od przedziału t przy kilku osobach?
Bo bootstrapowy błąd standardowy średniej odpowiada wzorowi z mianownikiem n zamiast n − 1, a percentyle bootstrapu – mnożnikowi z rozkładu normalnego (1.96) zamiast t (2.20 przy 11 stopniach swobody). Przy 12 osobach przedział percentylowy miał 17.00 punktu szerokości, a t – 19.94. W 1000 symulowanych badaniach z 6 osobami percentylowy objął prawdziwą średnią w 86.0% przypadków, a t – w 95.3%.
Czy bootstrap da przedział ufności dla największego wyniku w populacji?
Nie. Próba bootstrapowa nie może zawierać wartości większej niż największa obserwacja, więc rozkład bootstrapowy maksimum nigdy nie sięga prawdziwej granicy. W symulacji czasu czekania na tramwaj (0–20 min) przedział percentylowy dla maksimum nie objął 20 min w żadnym z 1000 badań, przy każdej liczebności od 6 do 96. Ten sam problem dotyczy minimum i skrajnych centyli.
Dlaczego rozkład bootstrapowy mediany ma przerwy i skoki?
Mediana z 12 liczb to średnia dwóch środkowych wyników, więc może przyjąć tylko kilkadziesiąt wartości – w 10 000 prób było ich 43, a najczęstsza (56) wystąpiła w 9.5% prób. Granice przedziału percentylowego to wtedy wyniki z próby albo średnie dwóch sąsiednich. W symulacji z rozkładu normalnego przedział dla mediany mimo to obejmował prawdziwą wartość w 93.1–95.7% badań.
Co zrobić, gdy bootstrapowy przedział dla korelacji wyklucza zero, a przedział Fishera nie?
Raportuj przedział wybrany przed analizą i nie zmieniaj metody na tę, która daje istotność. W przykładzie r = .36: przedział percentylowy [.02, .64] wykluczał zero, a przedział Fishera [−.04, .66] nie. W 1000 badaniach na danych normalnych przedział Fishera obejmował prawdziwą korelację w 95.0–95.6% przypadków, a percentylowy – w 92.1–92.9%, więc był za wąski.
Ile osób zostaje poza jedną próbą bootstrapową?
Przy 12 osobach średnio (11/12)^12 = 35.2%. W pięciu przykładowych próbach z 12 wyników pominięto od 2 do 6 osób, a inne trafiły do próby dwa lub trzy razy. Dlatego każda próba bootstrapowa ma inną średnią i medianę – i właśnie ten rozrzut szacuje niepewność wyniku.
Powiązane hasła
Przeczytaj też
Bootstrap i test permutacyjny krok po kroku
Bootstrap różnicy median i korelacji z BCa, test permutacyjny zamiast testu t, liczba permutacji i kiedy bootstrap zawodzi – na jednym przykładzie w R.
Czytaj →PoradnikBootstrap w SPSS krok po kroku
Okno Bootstrap od pliku .sav po zdanie APA: liczba prób, ziarno, BCa, losowanie warstwowe i kolumny Bias oraz Std. Error.
Czytaj →PoradnikPrzedział ufności w obrazkach
Sto przedziałów na jednym wykresie, szerokość a liczebność, poziom ufności, skośne dane, SD i przedział predykcji – sześć symulacji z kodem R.
Czytaj →Nie wiesz, czy w Twojej pracy potrzebny jest bootstrap?
Pomożemy dobrać metodę przedziału ufności do danych i liczebności próby, policzyć ją w R, SPSS albo jamovi i opisać wynik tak, żebyś umiał(a) go wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bickel, P. J., & Freedman, D. A. (1981). Some asymptotic theory for the bootstrap. The Annals of Statistics, 9(6), 1196–1217. https://doi.org/10.1214/aos/1176345637 ● Otwarty dostęp
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/cbo9780511802843 ● Otwarty dostęp: pełny tekst
- DiCiccio, T. J., & Efron, B. (1996). Bootstrap confidence intervals. Statistical Science, 11(3), 189–228. https://doi.org/10.1214/ss/1032280214 ● Otwarty dostęp
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Efron, B. (1987). Better bootstrap confidence intervals. Journal of the American Statistical Association, 82(397), 171–185. https://doi.org/10.1080/01621459.1987.10478410
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall.
- Hesterberg, T. C. (2015). What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum. The American Statistician, 69(4), 371–386. https://doi.org/10.1080/00031305.2015.1089789 ● Otwarty dostęp
Cytowania BibTeX
@article{bickel1981some, author={Bickel, Peter J. and Freedman, David A.}, title={{Some asymptotic theory for the bootstrap}}, journal={The Annals of Statistics}, year={1981}, volume={9}, number={6}, pages={1196--1217}, doi={10.1214/aos/1176345637}}@book{davison1997bootstrap, author={Davison, A. C. and Hinkley, D. V.}, title={{Bootstrap methods and their application}}, year={1997}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511802843}}@article{diciccio1996bootstrap, author={DiCiccio, Thomas J. and Efron, Bradley}, title={{Bootstrap confidence intervals}}, journal={Statistical Science}, year={1996}, volume={11}, number={3}, pages={189--228}, doi={10.1214/ss/1032280214}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{efron1987better, author={Efron, Bradley}, title={{Better bootstrap confidence intervals}}, journal={Journal of the American Statistical Association}, year={1987}, volume={82}, number={397}, pages={171--185}, doi={10.1080/01621459.1987.10478410}}@book{efron1993introduction, author={Efron, Bradley and Tibshirani, Robert J.}, title={{An introduction to the bootstrap}}, year={1993}, publisher={Chapman \& Hall}}@article{hesterberg2015what, author={Hesterberg, Tim C.}, title={{What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum}}, journal={The American Statistician}, year={2015}, volume={69}, number={4}, pages={371--386}, doi={10.1080/00031305.2015.1089789}}