Metaanaliza na pięciu rysunkach
Czym jest metaanaliza i jak ją przeprowadzić od pytania badawczego do raportu PRISMA, opisuje wpis metaanaliza krok po kroku. Gotowe liczby bez programowania da kalkulator metaanalizy, a obsługę modułu MAJOR – wpis metaanaliza w jamovi. Tu pokazujemy na rysunkach, co dzieje się w środku: wagi, heterogeniczność, przedział predykcji i skutki selektywnej publikacji.
Dane są fikcyjne, więc znamy prawdę. Przykład: 12 badań porównujących ośmiotygodniowy program aktywności fizycznej z grupą kontrolną. Wynikiem są objawy depresyjne, a dodatnie g Hedgesa oznacza mniej objawów po programie. Parametry ustawiliśmy ręcznie: średni prawdziwy efekt 0.40, rozrzut prawdziwych efektów τ = 0.20, 15–80 osób w grupie. Badaniu 12 nadaliśmy 350 osób w grupie i prawdziwy efekt 0.10, żeby różnica między modelami była wyraźna. Ziarno 601 ustalono raz i nie zmieniano go. Dane pobierzesz jako metaanaliza-12-badan.csv. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: ten sam las, dwa modele
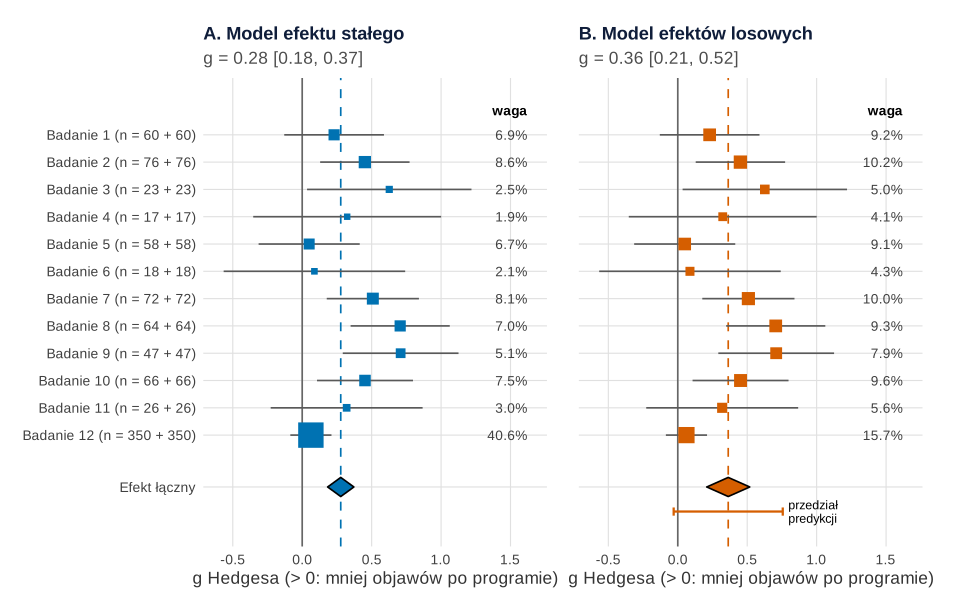
set.seed(601)).Co widać. Każdy kwadrat to wynik jednego badania z 95% przedziałem ufności, a romb na dole – wynik łączny (Lewis i Clarke, 2001). Oba panele mają te same punkty i te same wąsy. Różnią się tylko wagi, czyli rozmiar kwadratów. W modelu efektu stałego waga to odwrotność wariancji, więc duże badanie 12 dostaje 40.6% całej wagi, a najmniejsze badanie 4 – 1.9%. Efekt łączny to średnia ważona ciągnięta w stronę badania 12 (g = 0.06): g = 0.28, 95% CI [0.18, 0.37]. W modelu efektów losowych do wariancji każdego badania dochodzi ten sam składnik τ² = 0.034. Wagi się wyrównują: badanie 12 ma 15.7%, badanie 4 – 4.1%. Romb przesuwa się do g = 0.36, 95% CI [0.21, 0.52], i jest szerszy. Oba wyniki są istotne (z = 5.76 i 4.60, p < .001).
Czego ten wykres nie pokazuje. Borenstein i in. (2010) podkreślają, że oba modele stosują podobne wzory, ale opierają się na zupełnie innych założeniach: model efektu stałego zakłada jeden wspólny efekt, model efektów losowych – rozkład efektów. Wyboru dokonuje się przed analizą, na podstawie tego, czy badania są „wymienne”, a nie po tym, który romb wygląda lepiej. Wyrównanie wag ma koszt: zyskują małe badania, najbardziej podatne na selektywną publikację (rysunek 4). Jak czytać pozostałe elementy lasu, opisuje hasło wykres lasu (forest plot).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: jak wygląda I² ≈ 0%, 50% i 80%
W rysunku 1 heterogeniczność wyniosła Q(11) = 24.94, p = .009, τ = 0.18, I² = 51.5%. Co to znaczy na obrazku? Wylosowaliśmy 15 badań (20–100 osób w grupie) i policzyliśmy je trzy razy. Za każdym razem użyliśmy tych samych liczb losowych, a zmienialiśmy tylko τ. Wartości τ ustawiono ręcznie tak, by teoretyczne I² wynosiło 0%, 50% i 80%: przy typowej wariancji wewnątrz badań 0.035 daje to τ = 0, 0.188 i 0.375. Ponieważ dane są fikcyjne, na wykresie widać też prawdziwy efekt każdego badania (puste kółko).
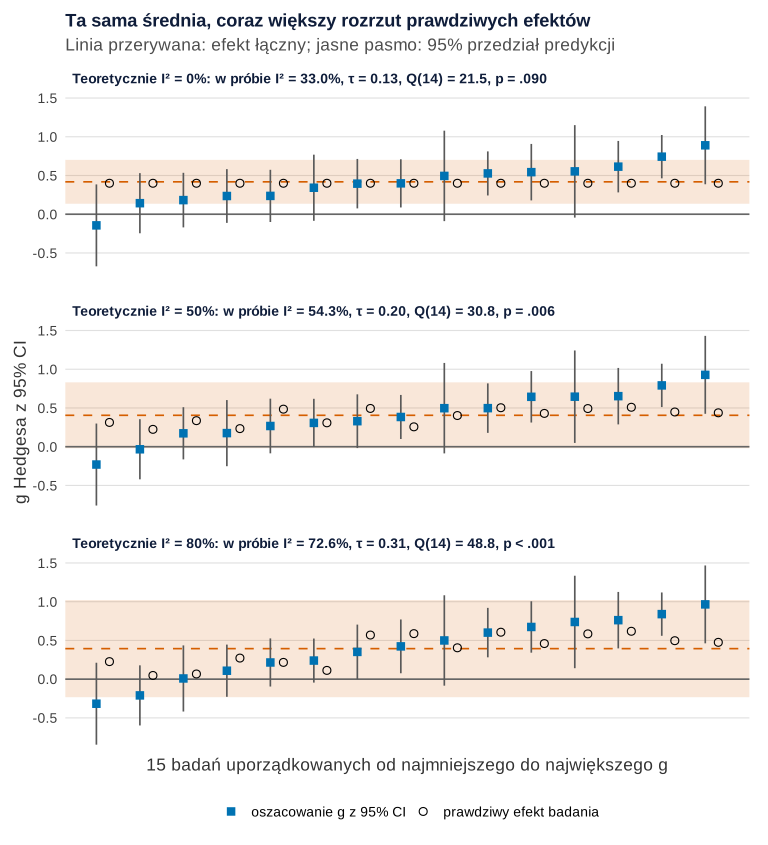
set.seed(601)).Co widać. W górnym panelu wszystkie prawdziwe efekty są równe 0.40, a mimo to kwadraty rozsypują się od −0.14 do 0.89. To sam błąd losowy małych badań. Im wyżej w panelach, tym bliżej siebie leżą puste kółka. W dolnym rozrzut kółek jest prawdziwy, a kwadraty rozsypują się jeszcze szerzej. Liczby: w próbie I² = 33.0%, 54.3% i 72.6%, τ = 0.13, 0.20 i 0.31, Q(14) = 21.46 (p = .090), 30.75 (p = .006) i 48.84 (p < .001). Efekt łączny prawie się nie zmienia (0.42, 0.41, 0.39), a przedział predykcji (jasne pasmo) rośnie od [0.14, 0.70] do [−0.23, 1.02].
Czego ten wykres nie pokazuje. Górny panel to ważna lekcja: przy braku heterogeniczności I² z 15 badań wyszło 33%, a jego 95% przedział ufności to [0, 76.6]. W dolnym panelu przedział I² to [48.2, 90.0]. Etykiety „niska, umiarkowana, wysoka” dla 25%, 50% i 75% Higgins i in. (2003) zaproponowali jako wstępne. Na prawdziwych danych nie widzisz pustych kółek, a I² nie mówi, jak szeroko rozchodzą się efekty. Borenstein i in. (2017) pokazują, że to samo I² = 50% może oznaczać efekty od 40 do 60 punktów albo od 10 do 90. Ten zakres podaje dopiero przedział predykcji. Więcej o obu miarach w haśle I² i τ² w metaanalizie, a o szukaniu źródeł rozrzutu – we wpisie metaregresja i analiza moderatorów (to moderacja na poziomie badań, por. moderacja – wizualizacja na obrazkach).
Podpis do pracy (np. w aneksie):
Zdanie do Wyników:
Rysunek 3: przedział ufności a przedział predykcji
Pod rombem na rysunku 1B narysowaliśmy dłuższy odcinek. To przedział predykcji. Panel A rysunku 3 pokazuje, co opisuje każdy z dwóch przedziałów. Panel B to symulacja: dla k = 5, 10, 20 i 40 badań wykonujemy po 1000 metaanaliz z prawdziwym średnim efektem 0.40 i τ = 0.20. Po każdej losujemy prawdziwy efekt „kolejnego badania” i sprawdzamy, który przedział go objął. Dla szybkości model liczymy ręcznie estymatorem DerSimoniana–Lairda. Na danych z rysunku 1 funkcja daje to samo co rma(method = "DL"): g = 0.366, τ² = 0.0406. Przedział predykcji liczymy z rozkładem t o k − 2 stopniach swobody, jak proponują Riley i in. (2011). Pakiet metafor na rysunku 1 domyślnie używa rozkładu normalnego.
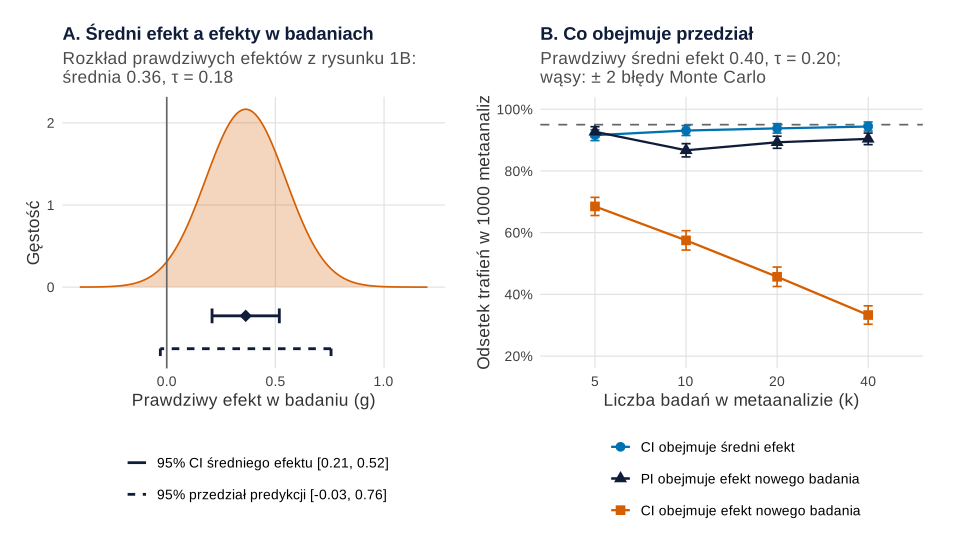
set.seed(601)).Co widać. Panel A: przedział ufności [0.21, 0.52] mówi, gdzie jest średnia krzywej. Przedział predykcji [−0.03, 0.76] mówi, gdzie leży większość samej krzywej, czyli efekty w poszczególnych badaniach. Panel B pokazuje różnicę w liczbach. Przedział ufności obejmuje średni efekt w 91.6–94.4% metaanaliz, zgodnie z przeznaczeniem. Efekt kolejnego badania obejmuje jednak tylko w 68.5% przy pięciu badaniach i w 33.3% przy czterdziestu. Im więcej badań, tym węższy przedział ufności i tym gorzej opisuje on pojedyncze badanie. Przedział predykcji trafia w 86.7–92.7% przypadków. Błąd Monte Carlo każdego odsetka wynosi najwyżej 1.6 punktu procentowego.
Czego ten wykres nie pokazuje. Nawet przedział predykcji trafiał nieco rzadziej, niż obiecuje (86.7% przy dziesięciu badaniach). To skutek niepewnego oszacowania τ² przy niewielu badaniach. Obie wersje przedziału są przybliżeniami i zakładają normalny rozkład prawdziwych efektów. Riley i in. (2011) przypominają, że efekt łączny to tylko średni efekt w badaniach, a przedział predykcji przybliża efekt w nowym kontekście. IntHout i in. (2016) podają, że w 72.4% istotnych metaanaliz Cochrane z I² > 0 przedział predykcji obejmował zero lub efekt przeciwny. Pokrycie zwykłego przedziału ufności pokazuje wpis przedział ufności w obrazkach.
Podpis do pracy (np. na obronę):
Zdanie do Dyskusji:
Rysunek 4: lejek bez selekcji i z selekcją
Teraz błąd publikacji. Symulujemy 80 badań tego samego programu (10–150 osób w grupie) o jednym prawdziwym efekcie 0.15. Regułę publikacji ustawiliśmy ręcznie i celowo skrajną: do druku trafia tylko wynik istotny (p < .05) w oczekiwanym kierunku. Opublikowano 16 badań, 64 zostały w szufladzie.
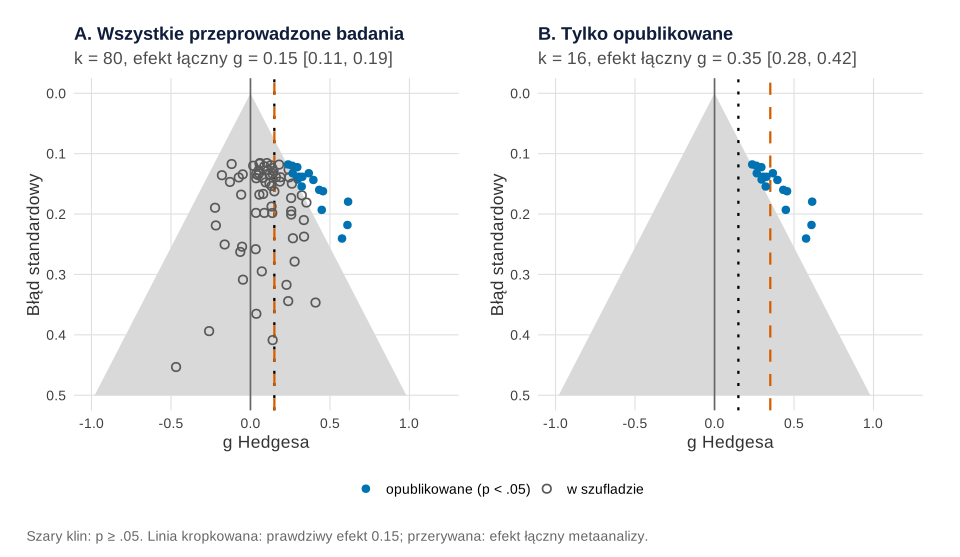
set.seed(601)).Co widać. Na wykresie lejkowym duże badania (mały błąd standardowy) są u góry, małe u dołu. Szary klin to obszar wyników nieistotnych. W panelu A badania rozkładają się symetrycznie wokół 0.15, a metaanaliza wszystkich 80 daje g = 0.15, 95% CI [0.11, 0.19]. W panelu B zostają tylko punkty za prawą krawędzią klina. Efekt łączny rośnie do 0.35 [0.28, 0.42], czyli ponad dwa razy. Przedział nie obejmuje prawdy. Najsilniej zawyżone są małe badania: jedyne opublikowane z mniej niż 40 osobami w grupie ma g = 0.58, a 16 małych badań z szuflady – średnio 0.06. Heterogeniczność znika (τ² = 0, I² = 0%), bo selekcja wycina rozrzut. Test Eggera na opublikowanych: z = 2.46, p = .014.
Czego ten wykres nie pokazuje. W prawdziwej metaanalizie masz tylko panel B, bez pustych kółek. Klin istotności pomaga zgadywać, czego brakuje. Peters i in. (2008) zauważają, że jeśli „dziury” leżą w obszarze nieistotnym, przemawia to za błędem publikacji, a jeśli w obszarze istotnym – raczej za innymi przyczynami, np. różną jakością badań. Sterne i in. (2011) przestrzegają, by asymetrii nie utożsamiać z błędem publikacji. Test Eggera był tu istotny, ale często ma małą moc. Jak korygować wynik (trim-and-fill, PET-PEESE, model selekcji), opisuje wpis błąd publikacji w metaanalizie – metody.
Podpis do pracy:
Zdanie do Metody i Wyników:
Rysunek 5: 1000 metaanaliz i selektywna publikacja
Rysunek 4 to jedna literatura. Czy to przypadek? Symulacja: dla trzech prawdziwych efektów (δ = 0, 0.2, 0.5, τ = 0.10) i czterech liczb opublikowanych badań (5, 10, 20, 40) wykonujemy po 1000 metaanaliz. Raz trafiają do nich wszystkie badania, raz tylko istotne i dodatnie. Badania mają 10–100 osób w grupie, a ich wyniki losujemy z przybliżonego rozkładu normalnego.
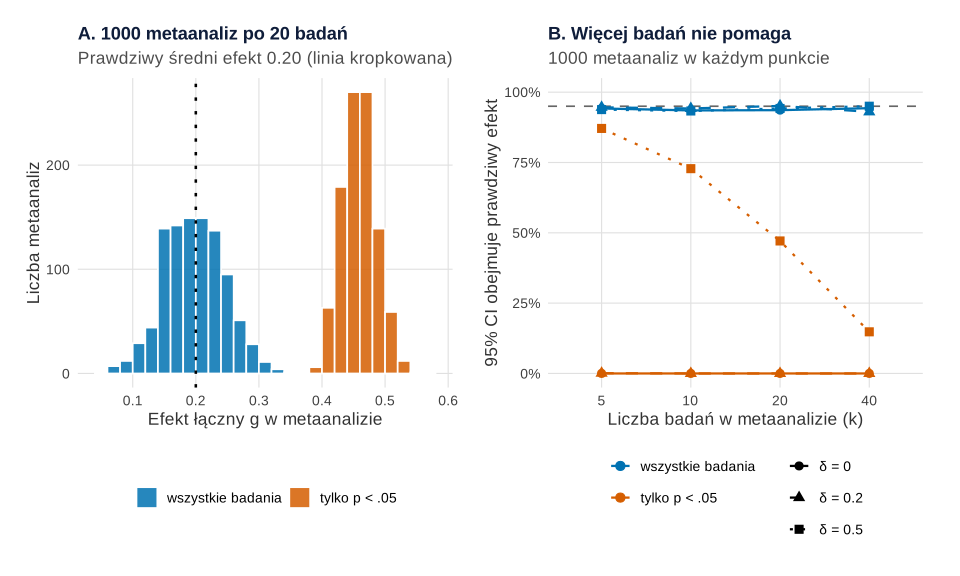
set.seed(601)).Co widać. Panel A: bez selekcji 1000 efektów łącznych skupia się wokół prawdziwego 0.20 (średnio 0.198). Z selekcją histogram przesuwa się prawie w całości (od 0.38 do 0.57, średnio 0.459), a żadna z 1000 metaanaliz nie trafiła przedziałem w 0.20. Panel B pokazuje to dla wszystkich warunków. Bez selekcji przedział trafia w 93.0–95.1% przypadków. Z selekcją przy δ = 0 średni efekt łączny wynosi 0.43–0.44, a pokrycie 0%: z niczego powstaje „umiarkowany efekt”. Żeby zebrać 20 istotnych wyników przy zerowym efekcie, trzeba było średnio 439 badań. Przy δ = 0.5 (wyższa moc) zawyżenie jest mniejsze (o 0.09), ale pokrycie spada z 87.1% przy 5 badaniach do 14.8% przy 40. Więcej badań zwęża przedział wokół złej wartości.
Czego ten wykres nie pokazuje. To scenariusz skrajny: w praktyce część wyników nieistotnych też się ukazuje, więc zawyżenie bywa mniejsze. Selekcja ma jeszcze jeden skutek: przy prawdziwym τ² = 0.01 średnie oszacowanie τ² wynosiło bez selekcji 0.010–0.020, a z selekcją przy δ = 0 i 0.2 najwyżej 0.0012. Literatura wygląda na zgodną. Zawyżenie pojedynczych badań przy niskiej mocy pokazuje wpis moc testu w obrazkach, a skalę d – wielkość efektu w obrazkach.
Podpis do pracy (np. na obronę lub do Dyskusji):
Zdanie do Dyskusji:
Co zrobić w praktyce
- Do Wyników – wykres lasu w wersji z rysunku 1B: kwadraty proporcjonalne do wag, romb i przedział predykcji pod nim. W tekście efekt łączny z CI, τ, I² z przedziałem i przedział predykcji.
- Do Metody – model wybrany przed analizą z uzasadnieniem (rysunek 1), estymator τ² i sposób liczenia przedziału predykcji.
- Do oceny błędu publikacji – lejek z obszarem nieistotności (rysunek 4) i przeszukanie literatury nieopublikowanej. Testy i korekty traktuj jako analizę wrażliwości.
- Do Dyskusji albo na obronę – rysunki 3 i 5: wynik „istotny i precyzyjny” nie gwarantuje efektu w nowym badaniu.
Niepewność efektu łącznego można też oszacować bootstrapem – mechanizm pokazuje wpis bootstrap – wizualizacja na obrazkach.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, przepis 3 – funkcję dl() używaną w przepisie 5. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1–5), zaczyna się od własnego set.seed(601), więc skopiowany osobno (z przepisem 1, a przepis 5 także z 3) da te same liczby co na stronie. Ziarno 601 ustalono raz i nie zmieniano go. Ręcznie ustalono: średni efekt 0.40, τ = 0.20, 15–80 osób w grupie oraz badanie 12 (350 osób w grupie, efekt 0.10) w przepisie 1; trzy wartości τ dające teoretyczne I² 0%, 50% i 80% w przepisie 2; liczby badań 5–40 i 1000 powtórzeń w przepisach 3 i 5; efekt 0.15, 80 badań i regułę „tylko p < .05” w przepisie 4; efekty 0, 0.2 i 0.5 oraz τ = 0.10 w przepisie 5. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane, dwa modele i dwa lasy: Rysunek 1
R
# Rysunek 1. Wykres lasu 12 fikcyjnych badań: model efektu stałego i model efektów losowych
library(metafor)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(staly = "#0072B2", losowy = "#D55E00", szary = "grey55", ciemny = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03
p_apa <- function(p) ifelse(p < .001, "p < .001", paste("p =", bz(p, 3)))
romb <- function(m, lo, hi, y, h = 0.35)          # wierzchołki rombu efektu łącznego
  data.frame(x = c(lo, m, hi, m), y = c(y, y + h, y, y - h))

# 12 fikcyjnych badań: 8-tygodniowy program aktywności fizycznej vs grupa kontrolna, wynik –
# objawy depresyjne (skala 0–60, SD ≈ 9). Parametry ustalone ręcznie: średni prawdziwy efekt 0.40 SD,
# rozrzut prawdziwych efektów tau = 0.20, 15–80 osób w grupie; badanie 12 – duże (350 osób w grupie)
# z prawdziwym efektem 0.10, żeby różnica między modelami była widoczna.
set.seed(601)                                    # ziarno ustalone raz, bez dobierania pod wynik
k <- 12
n_gr <- c(sample(15:80, k - 1, replace = TRUE), 350)
theta <- c(0.40 + 0.20 * rnorm(k - 1), 0.10)     # prawdziwe efekty badań (w SD)
dane <- do.call(rbind, lapply(1:k, function(i) {
  kontr <- rnorm(n_gr[i], 24, 9); akt <- rnorm(n_gr[i], 24 - 9 * theta[i], 9)
  data.frame(badanie = i, n_kontr = n_gr[i], m_kontr = round(mean(kontr), 2), sd_kontr = round(sd(kontr), 2),
             n_akt = n_gr[i], m_akt = round(mean(akt), 2), sd_akt = round(sd(akt), 2))
}))
write.csv(dane, "metaanaliza-12-badan.csv", row.names = FALSE)

# g Hedgesa: kontrolna minus aktywność, więc dodatnie g = mniej objawów po programie
es <- escalc(measure = "SMD", m1i = m_kontr, sd1i = sd_kontr, n1i = n_kontr,
             m2i = m_akt, sd2i = sd_akt, n2i = n_akt, data = dane)
fe <- rma(yi, vi, data = es, method = "FE")      # model efektu stałego (wspólnego)
re <- rma(yi, vi, data = es, method = "REML")    # model efektów losowych
pi_re <- predict(re)                              # przedział predykcji

es$se <- sqrt(es$vi)
es$waga_staly <- weights(fe); es$waga_losowy <- weights(re)   # wagi w procentach
print(data.frame(badanie = es$badanie, n_na_grupe = es$n_kontr, g = round(es$yi, 2), SE = round(es$se, 3),
                 waga_staly = round(es$waga_staly, 1), waga_losowy = round(es$waga_losowy, 1)), row.names = FALSE)
modele <- rbind(staly = c(g = fe$b[1], SE = fe$se, CI_dolna = fe$ci.lb, CI_gorna = fe$ci.ub, z = fe$zval, p = fe$pval),
                losowy = c(re$b[1], re$se, re$ci.lb, re$ci.ub, re$zval, re$pval))
round(modele[, 1:5], 3)
p_apa(modele[, "p"])
round(c(Q = re$QE, df = re$k - 1, p_Q = re$QEp, tau2 = re$tau2, tau = sqrt(re$tau2), I2 = re$I2,
        PI_dolna = pi_re$pi.lb, PI_gorna = pi_re$pi.ub), 3)
round(c(waga_max_staly = max(es$waga_staly), waga_max_losowy = max(es$waga_losowy),
        waga_min_staly = min(es$waga_staly), waga_min_losowy = min(es$waga_losowy)), 1)

# Dwa panele tego samego lasu: rozmiar kwadratu = waga badania w danym modelu
las <- function(waga, m, lo, hi, tytul, kolor, pi = NULL) {
  d <- data.frame(y = k:1 + 1.5, g = es$yi, lo = es$yi - 1.96 * es$se, hi = es$yi + 1.96 * es$se, waga = waga,
                  etykieta = sprintf("Badanie %d (n = %d + %d)", es$badanie, es$n_kontr, es$n_akt))
  p <- ggplot(d) +
    geom_vline(xintercept = 0, colour = "grey40") +
    geom_vline(xintercept = m, colour = kolor, linetype = "dashed") +
    geom_errorbar(aes(y = y, xmin = lo, xmax = hi), width = 0, orientation = "y", colour = "grey35") +
    geom_point(aes(x = g, y = y, size = waga), shape = 15, colour = kolor) +
    geom_text(aes(x = 1.62, y = y, label = sprintf("%.1f%%", waga)), hjust = 1, size = 3.6, colour = "grey25") +
    geom_polygon(data = romb(m, lo, hi, 0.6), aes(x, y), fill = kolor, colour = "black") +
    annotate("text", x = 1.62, y = k + 2.4, label = "waga", hjust = 1, size = 3.6, fontface = "bold") +
    scale_size_area(max_size = 9, limits = c(0, 45), guide = "none") +
    scale_y_continuous(breaks = c(k:1 + 1.5, 0.6), labels = c(d$etykieta, "Efekt łączny"),
                       limits = c(-0.8, k + 2.8)) +
    scale_x_continuous(limits = c(-0.6, 1.65), breaks = seq(-0.5, 1.5, 0.5)) +
    labs(x = "g Hedgesa (> 0: mniej objawów po programie)", y = NULL, title = tytul,
         subtitle = sprintf("g = %.2f [%.2f, %.2f]", m, lo, hi)) + motyw
  if (!is.null(pi)) p <- p + geom_errorbar(data = data.frame(y = -0.3, lo = pi[1], hi = pi[2]), aes(y = y, xmin = lo, xmax = hi),
                                           width = 0.3, orientation = "y", colour = kolor, linewidth = 0.8)
  p
}
pa <- las(es$waga_staly, fe$b[1], fe$ci.lb, fe$ci.ub, "A. Model efektu stałego", kol[["staly"]])
pb <- las(es$waga_losowy, re$b[1], re$ci.lb, re$ci.ub, "B. Model efektów losowych", kol[["losowy"]],
          pi = c(pi_re$pi.lb, pi_re$pi.ub)) +
  annotate("text", x = pi_re$pi.ub + 0.04, y = -0.3, label = "przedział\npredykcji", hjust = 0, size = 3.3, lineheight = 0.9) +
  theme(axis.text.y = element_blank())
p1 <- pa + pb + plot_layout(widths = c(1, 1))
p1   # zapis: ggsave("metaanaliza-las-staly-i-losowy.svg", p1, width = 10, height = 6.4)
Wynik w R
 badanie n_na_grupe    g    SE waga_staly waga_losowy
       1         60 0.23 0.183        6.9         9.2
       2         76 0.45 0.164        8.6        10.2
       3         23 0.63 0.302        2.5         5.0
       4         17 0.32 0.345        1.9         4.1
       5         58 0.05 0.186        6.7         9.1
       6         18 0.09 0.333        2.1         4.3
       7         72 0.51 0.169        8.1        10.0
       8         64 0.71 0.182        7.0         9.3
       9         47 0.71 0.213        5.1         7.9
      10         66 0.45 0.176        7.5         9.6
      11         26 0.32 0.279        3.0         5.6
      12        350 0.06 0.076       40.6        15.7
           g    SE CI_dolna CI_gorna     z
staly  0.277 0.048    0.183    0.372 5.761
losowy 0.363 0.079    0.209    0.518 4.601
     staly     losowy
"p < .001" "p < .001"
       Q       df      p_Q     tau2      tau       I2 PI_dolna PI_gorna
  24.943   11.000    0.009    0.034    0.184   51.452   -0.029    0.756
 waga_max_staly waga_max_losowy  waga_min_staly waga_min_losowy
           40.6            15.7             1.9             4.1
2. Trzy poziomy heterogeniczności: Rysunek 2
R
# Rysunek 2. Jak wygląda rozrzut przy I² ≈ 0%, 50% i 80%: te same badania, różne tau
# (korzysta z kol, motyw, bz() i p_apa() z przepisu 1)
library(metafor)
library(ggplot2)

# 15 fikcyjnych badań, 20–100 osób w grupie. Te same liczby losowe w trzech scenariuszach – zmienia się
# tylko rozrzut prawdziwych efektów tau, ustalony ręcznie tak, by teoretyczne I² wyniosło 0%, 50% i 80%.
set.seed(601)
k <- 15; mu <- 0.40
n_gr <- sample(20:100, k, replace = TRUE)
v <- 2 / n_gr + mu^2 / (4 * n_gr)                  # przybliżona wariancja g przy efekcie 0.40
z_prawdziwy <- rnorm(k); z_blad <- rnorm(k)
w <- 1 / v
s2 <- (k - 1) * sum(w) / (sum(w)^2 - sum(w^2))     # „typowa” wariancja wewnątrz badań (Higgins i Thompson)
I2_cel <- c(0, 0.5, 0.8)
tau <- sqrt(s2 * I2_cel / (1 - I2_cel))            # I² = tau² / (tau² + s2)
round(c(typowa_wariancja = s2, tau_I2_0 = tau[1], tau_I2_50 = tau[2], tau_I2_80 = tau[3]), 3)

sc <- do.call(rbind, lapply(seq_along(tau), function(j) {
  prawdziwy <- mu + tau[j] * z_prawdziwy            # prawdziwy efekt badania (znany, bo dane są fikcyjne)
  g <- prawdziwy + sqrt(v) * z_blad                  # oszacowanie = prawdziwy efekt + błąd losowy
  m <- rma(g, v, method = "REML"); pr <- predict(m); ci_I2 <- confint(m)$random["I^2(%)", 2:3]
  data.frame(scenariusz = j, badanie = 1:k, prawdziwy, g, se = sqrt(v), tau_prawdziwe = tau[j], I2_cel = 100 * I2_cel[j],
             M = m$b[1], CI_dolna = m$ci.lb, CI_gorna = m$ci.ub, Q = m$QE, p_Q = m$QEp,
             tau2 = m$tau2, I2 = m$I2, I2_dolna = ci_I2[[1]], I2_gorna = ci_I2[[2]], PI_dolna = c(pr$pi.lb), PI_gorna = c(pr$pi.ub))   # c() usuwa atrybuty
}))
pods <- unique(sc[, c("scenariusz", "tau_prawdziwe", "I2_cel", "M", "CI_dolna", "CI_gorna", "Q", "p_Q",
                      "tau2", "I2", "I2_dolna", "I2_gorna", "PI_dolna", "PI_gorna")])
print(round(pods, 3), row.names = FALSE)
p_apa(pods$p_Q)
# Zakres oszacowań g i prawdziwych efektów w każdym scenariuszu
round(do.call(rbind, lapply(split(sc, sc$scenariusz), function(d)
  c(g_min = min(d$g), g_max = max(d$g), prawdziwy_min = min(d$prawdziwy), prawdziwy_max = max(d$prawdziwy)))), 2)

sc$panel <- factor(sc$scenariusz, labels = sprintf("Teoretycznie I² = %d%%: w próbie I² = %.1f%%, τ = %.2f, Q(%d) = %.1f, %s",
                                                   pods$I2_cel, pods$I2, sqrt(pods$tau2), k - 1, pods$Q, p_apa(pods$p_Q)))
sc <- sc[order(sc$scenariusz, sc$g), ]
sc$pozycja <- ave(sc$g, sc$scenariusz, FUN = seq_along)   # badania posortowane w każdym panelu
pasy <- data.frame(panel = levels(sc$panel), M = pods$M, PI_dolna = pods$PI_dolna, PI_gorna = pods$PI_gorna)
p2 <- ggplot(sc, aes(pozycja, g)) +
  geom_rect(data = pasy, aes(xmin = -Inf, xmax = Inf, ymin = PI_dolna, ymax = PI_gorna), inherit.aes = FALSE,
            fill = kol[["losowy"]], alpha = 0.15) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_hline(data = pasy, aes(yintercept = M), colour = kol[["losowy"]], linetype = "dashed") +
  geom_errorbar(aes(ymin = g - 1.96 * se, ymax = g + 1.96 * se), width = 0, colour = "grey35") +
  geom_point(aes(shape = "oszacowanie g z 95% CI"), size = 2.6, colour = kol[["staly"]]) +
  geom_point(aes(y = prawdziwy, shape = "prawdziwy efekt badania"), size = 2.4, colour = "black",
             position = position_nudge(x = 0.3)) +
  scale_shape_manual(values = c("oszacowanie g z 95% CI" = 15, "prawdziwy efekt badania" = 1), name = NULL) +
  facet_wrap(~ panel, ncol = 1) +
  scale_x_continuous(breaks = NULL) +
  labs(x = "15 badań uporządkowanych od najmniejszego do największego g", y = "g Hedgesa z 95% CI",
       title = "Ta sama średnia, coraz większy rozrzut prawdziwych efektów",
       subtitle = "Linia przerywana: efekt łączny; jasne pasmo: 95% przedział predykcji") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.8)))
p2   # zapis: ggsave("metaanaliza-i2-trzy-scenariusze.svg", p2, width = 8, height = 8.4)
Wynik w R
typowa_wariancja         tau_I2_0        tau_I2_50        tau_I2_80
           0.035            0.000            0.188            0.375
 scenariusz tau_prawdziwe I2_cel     M CI_dolna CI_gorna      Q   p_Q  tau2
          1         0.000      0 0.419    0.301    0.536 21.461 0.090 0.017
          2         0.188     50 0.406    0.262    0.549 30.754 0.006 0.042
          3         0.375     80 0.394    0.209    0.579 48.838 0.000 0.093
     I2 I2_dolna I2_gorna PI_dolna PI_gorna
 32.960     0.00   76.588    0.135    0.702
 54.331    15.46   84.251   -0.020    0.831
 72.642    48.22   90.006   -0.233    1.021
[1] "p = .090" "p = .006" "p < .001"
  g_min g_max prawdziwy_min prawdziwy_max
1 -0.14  0.89          0.40          0.40
2 -0.23  0.93          0.22          0.51
3 -0.32  0.97          0.05          0.62
3. Przedział predykcji i 1000 metaanaliz: Rysunek 3
R
# Rysunek 3. Przedział ufności a przedział predykcji: rozkład prawdziwych efektów i 1000 metaanaliz
# (korzysta z kol, motyw, bz(), es, re i pi_re z przepisu 1)
library(metafor)
library(ggplot2)
library(patchwork)

# Model efektów losowych liczony ręcznie (estymator DerSimoniana–Lairda) – szybki, więc nadaje się do symulacji
dl <- function(y, v) {
  w <- 1 / v; k <- length(y)
  Q <- sum(w * (y - sum(w * y) / sum(w))^2)
  tau2 <- max(0, (Q - (k - 1)) / (sum(w) - sum(w^2) / sum(w)))
  ws <- 1 / (v + tau2); M <- sum(ws * y) / sum(ws); se <- sqrt(1 / sum(ws))
  c(M = M, se = se, tau2 = tau2, k = k)
}
# Sprawdzenie na 12 badaniach z rysunku 1: to samo co metafor::rma(yi, vi, data = es, method = "DL")
round(dl(es$yi, es$vi), 4)
round(c(rma_DL_M = coef(rma(yi, vi, data = es, method = "DL"))[[1]],
        rma_DL_tau2 = rma(yi, vi, data = es, method = "DL")$tau2), 4)

# A: co opisuje każdy przedział – wokół efektu łącznego z rysunku 1 (REML) rysujemy rozkład
# prawdziwych efektów N(M, tau²), 95% przedział ufności średniej i 95% przedział predykcji
M <- re$b[1]; tau_re <- sqrt(re$tau2)
siatka <- data.frame(x = seq(-0.4, 1.2, length.out = 200))
siatka$gestosc <- dnorm(siatka$x, M, tau_re)
przedzialy <- data.frame(y = c(-0.35, -0.75), lo = c(re$ci.lb, pi_re$pi.lb), hi = c(re$ci.ub, pi_re$pi.ub),
                         etykieta = c(sprintf("95%% CI średniego efektu [%.2f, %.2f]", re$ci.lb, re$ci.ub),
                                      sprintf("95%% przedział predykcji [%.2f, %.2f]", pi_re$pi.lb, pi_re$pi.ub)))
pa <- ggplot(siatka, aes(x, gestosc)) +
  geom_area(fill = kol[["losowy"]], alpha = 0.25) + geom_line(colour = kol[["losowy"]]) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(data = przedzialy, aes(y = y, xmin = lo, xmax = hi, linetype = etykieta), width = 0.18,
                orientation = "y", inherit.aes = FALSE, linewidth = 1, colour = kol[["ciemny"]]) +
  annotate("point", x = M, y = -0.35, shape = 18, size = 4, colour = kol[["ciemny"]]) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  guides(linetype = guide_legend(ncol = 1)) +
  labs(x = "Prawdziwy efekt w badaniu (g)", y = "Gęstość", title = "A. Średni efekt a efekty w badaniach",
       subtitle = sprintf("Rozkład prawdziwych efektów z rysunku 1B:\nśrednia %.2f, τ = %.2f", M, tau_re)) +
  motyw

# B: 1000 metaanaliz na każdą liczbę badań k. Prawdziwy średni efekt 0.40 i tau = 0.20 (jak przy losowaniu
# danych do rysunku 1), 15–80 osób w grupie. Po każdej metaanalizie losujemy „nowe badanie” i sprawdzamy,
# czy jego prawdziwy efekt mieści się w 95% CI średniej i w 95% przedziale predykcji (t z k − 2 df).
set.seed(601)
R <- 1000; mu <- 0.40; tau <- 0.20
sym <- do.call(rbind, lapply(c(5, 10, 20, 40), function(kk) {
  traf <- replicate(R, {
    n <- sample(15:80, kk, replace = TRUE)
    th <- rnorm(kk, mu, tau); v <- 2 / n + th^2 / (4 * n)
    y <- rnorm(kk, th, sqrt(v))
    f <- dl(y, v)
    nowy <- rnorm(1, mu, tau)                                  # prawdziwy efekt w kolejnym badaniu
    ci <- f[["M"]] + c(-1, 1) * qnorm(.975) * f[["se"]]
    pi <- f[["M"]] + c(-1, 1) * qt(.975, kk - 2) * sqrt(f[["tau2"]] + f[["se"]]^2)
    c(CI_srednia = ci[1] <= mu & mu <= ci[2], CI_nowe = ci[1] <= nowy & nowy <= ci[2],
      PI_nowe = pi[1] <= nowy & nowy <= pi[2])
  })
  data.frame(k = kk, przedzial = rownames(traf), pokrycie = rowMeans(traf))
}))
sym$blad_MC <- sqrt(sym$pokrycie * (1 - sym$pokrycie) / R)    # błąd Monte Carlo odsetka
print(transform(sym, pokrycie = round(pokrycie, 3), blad_MC = round(blad_MC, 3)), row.names = FALSE)

sym$przedzial <- factor(sym$przedzial, c("CI_srednia", "PI_nowe", "CI_nowe"),
                        c("CI obejmuje średni efekt", "PI obejmuje efekt nowego badania",
                          "CI obejmuje efekt nowego badania"))
pb <- ggplot(sym, aes(factor(k), pokrycie, colour = przedzial, shape = przedzial, group = przedzial)) +
  geom_hline(yintercept = 0.95, colour = "grey40", linetype = "dashed") +
  geom_line(linewidth = 0.8) +
  geom_errorbar(aes(ymin = pokrycie - 2 * blad_MC, ymax = pokrycie + 2 * blad_MC), width = 0.1) +
  geom_point(size = 3) +
  scale_colour_manual(values = c(kol[["staly"]], kol[["ciemny"]], kol[["losowy"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_y_continuous(limits = c(0.2, 1), labels = function(x) paste0(round(100 * x), "%")) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Liczba badań w metaanalizie (k)", y = "Odsetek trafień w 1000 metaanaliz",
       title = "B. Co obejmuje przedział", subtitle = "Prawdziwy średni efekt 0.40, τ = 0.20;\nwąsy: ± 2 błędy Monte Carlo") +
  motyw
p3 <- pa + pb
p3   # zapis: ggsave("metaanaliza-przedzial-predykcji.svg", p3, width = 10, height = 5.8)
Wynik w R
      M      se    tau2       k
 0.3660  0.0828  0.0406 12.0000
   rma_DL_M rma_DL_tau2
     0.3660      0.0406
  k  przedzial pokrycie blad_MC
  5 CI_srednia    0.916   0.009
  5    CI_nowe    0.685   0.015
  5    PI_nowe    0.927   0.008
 10 CI_srednia    0.931   0.008
 10    CI_nowe    0.575   0.016
 10    PI_nowe    0.867   0.011
 20 CI_srednia    0.938   0.008
 20    CI_nowe    0.457   0.016
 20    PI_nowe    0.893   0.010
 40 CI_srednia    0.944   0.007
 40    CI_nowe    0.333   0.015
 40    PI_nowe    0.904   0.009
4. Lejek: wszystkie i opublikowane badania: Rysunek 4
R
# Rysunek 4. Wykres lejkowy: wszystkie przeprowadzone badania i tylko te „opublikowane” (p < .05)
# (korzysta z kol, motyw, bz() i p_apa() z przepisu 1)
library(metafor)
library(ggplot2)
library(patchwork)

# 80 fikcyjnych badań tego samego programu, 10–150 osób w grupie, jeden prawdziwy efekt 0.15 (bez heterogeniczności).
# Reguła publikacji ustalona ręcznie i skrajna: do druku trafia tylko wynik istotny (p < .05) w oczekiwanym kierunku.
set.seed(601)
k <- 80; delta <- 0.15
n_gr <- sample(10:150, k, replace = TRUE)
wsz <- do.call(rbind, lapply(1:k, function(i) {
  kontr <- rnorm(n_gr[i], 24, 9); akt <- rnorm(n_gr[i], 24 - 9 * delta, 9)
  data.frame(n = n_gr[i], m1 = mean(kontr), s1 = sd(kontr), m2 = mean(akt), s2 = sd(akt))
}))
wsz <- escalc(measure = "SMD", m1i = m1, sd1i = s1, n1i = n, m2i = m2, sd2i = s2, n2i = n, data = wsz)
wsz$se <- sqrt(wsz$vi)
wsz$p <- 2 * pnorm(-abs(wsz$yi / wsz$se))
wsz$opublikowane <- wsz$p < .05 & wsz$yi > 0
table(opublikowane = wsz$opublikowane)

m_wsz <- rma(yi, vi, data = wsz, method = "REML")
m_pub <- rma(yi, vi, data = wsz, subset = opublikowane, method = "REML")
eg <- regtest(m_pub)                              # test Eggera na opublikowanych
round(rbind(wszystkie = c(k = m_wsz$k, g = m_wsz$b[1], CI_dolna = m_wsz$ci.lb, CI_gorna = m_wsz$ci.ub,
                          tau2 = m_wsz$tau2, I2 = m_wsz$I2),
            opublikowane = c(m_pub$k, m_pub$b[1], m_pub$ci.lb, m_pub$ci.ub, m_pub$tau2, m_pub$I2)), 3)
round(c(Egger_z = eg$zval, Egger_p = eg$pval), 3)
# Średni efekt w małych i dużych badaniach (granica: 40 osób w grupie)
wsz$wielkosc <- ifelse(wsz$n < 40, "male", "duze")
table(wsz$wielkosc, wsz$opublikowane)
round(tapply(wsz$yi, wsz[c("wielkosc", "opublikowane")], mean), 2)

# Lejek: oś pionowa – błąd standardowy (odwrócona, duże badania na górze); szary klin – wyniki nieistotne (p ≥ .05)
se_max <- 0.5
klin <- data.frame(x = c(-1.96 * se_max, 0, 1.96 * se_max), y = c(se_max, 0, se_max))
lejek <- function(d, m, tytul) {
  ggplot(d, aes(yi, se)) +
    geom_polygon(data = klin, aes(x, y), fill = "grey85") +
    geom_vline(xintercept = 0, colour = "grey40") +
    geom_vline(xintercept = delta, colour = "black", linetype = "dotted", linewidth = 0.8) +
    geom_vline(xintercept = m$b[1], colour = kol[["losowy"]], linetype = "dashed", linewidth = 0.8) +
    geom_point(aes(shape = opublikowane, colour = opublikowane), size = 2.4, stroke = 0.9) +
    scale_shape_manual(values = c(`TRUE` = 16, `FALSE` = 1), labels = c(`TRUE` = "opublikowane (p < .05)",
                                                                       `FALSE` = "w szufladzie"), name = NULL, drop = FALSE) +
    scale_colour_manual(values = c(`TRUE` = kol[["staly"]], `FALSE` = "grey35"),
                        labels = c(`TRUE` = "opublikowane (p < .05)", `FALSE` = "w szufladzie"), name = NULL, drop = FALSE) +
    scale_y_reverse(limits = c(se_max, 0)) +
    scale_x_continuous(limits = c(-1, 1.2)) +
    labs(x = "g Hedgesa", y = "Błąd standardowy", title = tytul,
         subtitle = sprintf("k = %d, efekt łączny g = %.2f [%.2f, %.2f]", m$k, m$b[1], m$ci.lb, m$ci.ub)) +
    motyw + theme(legend.position = "bottom")
}
wsz$opublikowane <- factor(wsz$opublikowane, c(TRUE, FALSE))
pa <- lejek(wsz, m_wsz, "A. Wszystkie przeprowadzone badania")
pb <- lejek(wsz[wsz$opublikowane == "TRUE", ], m_pub, "B. Tylko opublikowane") +
  theme(legend.position = "none")
p4 <- pa + pb + plot_layout(guides = "collect") +
  plot_annotation(caption = "Szary klin: p ≥ .05. Linia kropkowana: prawdziwy efekt 0.15; przerywana: efekt łączny metaanalizy.")
p4   # zapis: ggsave("metaanaliza-lejek-selekcja.svg", p4, width = 10, height = 5.8)
Wynik w R
opublikowane
FALSE  TRUE
   64    16
              k     g CI_dolna CI_gorna  tau2    I2
wszystkie    80 0.150    0.114    0.187 0.002 8.939
opublikowane 16 0.351    0.279    0.423 0.000 0.000
Egger_z Egger_p
  2.463   0.014

       FALSE TRUE
  duze    48   15
  male    16    1
        opublikowane
wielkosc FALSE TRUE
    duze  0.10 0.38
    male  0.06 0.58
5. 1000 metaanaliz z selekcją i bez: Rysunek 5
R
# Rysunek 5. 1000 metaanaliz z selektywną publikacją i bez niej: obciążenie i pokrycie przedziału
# (korzysta z kol, motyw i funkcji dl() z przepisu 3)
library(ggplot2)
library(patchwork)

# Jedna metaanaliza: k opublikowanych badań, 10–100 osób w grupie, prawdziwe efekty N(delta, tau²) z tau = 0.10.
# g losujemy z przybliżonego rozkładu normalnego. Selekcja: badanie trafia do metaanalizy tylko wtedy,
# gdy p < .05 i efekt jest dodatni – „szuflada” rośnie, dopóki nie zbierze się k takich wyników.
jedna <- function(k, delta, selekcja, tau = 0.10) {
  y <- v <- numeric(0); przepr <- 0
  while (length(y) < k) {
    n <- sample(10:100, 200, replace = TRUE)
    th <- rnorm(200, delta, tau); vv <- 2 / n + th^2 / (4 * n)
    yy <- rnorm(200, th, sqrt(vv))
    ok <- if (selekcja) yy / sqrt(vv) > qnorm(.975) else rep(TRUE, 200)
    ile <- min(sum(ok), k - length(y))
    if (ile > 0) { idx <- which(ok)[1:ile]; y <- c(y, yy[idx]); v <- c(v, vv[idx]); przepr <- przepr + max(idx) }
    else przepr <- przepr + 200
  }
  f <- dl(y, v)
  c(f[c("M", "se", "tau2")], przeprowadzone = przepr,
    trafia = abs(f[["M"]] - delta) <= qnorm(.975) * f[["se"]])
}

set.seed(601)
R <- 1000
war <- expand.grid(k = c(5, 10, 20, 40), delta = c(0, 0.2, 0.5), selekcja = c(FALSE, TRUE))
wyn <- do.call(rbind, lapply(seq_len(nrow(war)), function(i) {
  s <- t(replicate(R, jedna(war$k[i], war$delta[i], war$selekcja[i])))
  data.frame(war[i, ], sr_M = mean(s[, "M"]), obciazenie = mean(s[, "M"]) - war$delta[i],
             pokrycie = mean(s[, "trafia"]), blad_MC = sqrt(mean(s[, "trafia"]) * (1 - mean(s[, "trafia"])) / R),
             sr_tau2 = mean(s[, "tau2"]), sr_przeprowadzonych = mean(s[, "przeprowadzone"]),
             M_rozklad = I(list(s[, "M"])))
}))
print(with(wyn, data.frame(k, delta, selekcja, sr_M = round(sr_M, 3), obciazenie = round(obciazenie, 3),
                           pokrycie = round(pokrycie, 3), blad_MC = round(blad_MC, 3), sr_tau2 = round(sr_tau2, 4),
                           badan_przepr = round(sr_przeprowadzonych))), row.names = FALSE)

# A: rozkład 1000 efektów łącznych przy delta = 0.2 i k = 20
wyb <- wyn[wyn$k == 20 & wyn$delta == 0.2, ]
hist_d <- data.frame(M = unlist(wyb$M_rozklad),
                     wariant = factor(rep(ifelse(wyb$selekcja, "tylko p < .05", "wszystkie badania"), each = R),
                                      c("wszystkie badania", "tylko p < .05")))
round(do.call(rbind, tapply(hist_d$M, hist_d$wariant, range)), 2)   # najmniejszy i największy efekt łączny
pa <- ggplot(hist_d, aes(M, fill = wariant)) +
  geom_histogram(aes(linetype = wariant), binwidth = 0.02, boundary = 0, colour = "white", alpha = 0.85,
                 position = "identity") +
  geom_vline(xintercept = 0.2, colour = "black", linetype = "dotted", linewidth = 0.9) +
  scale_fill_manual(values = c("tylko p < .05" = kol[["losowy"]], "wszystkie badania" = kol[["staly"]]), name = NULL) +
  scale_linetype_manual(values = c("tylko p < .05" = "solid", "wszystkie badania" = "solid"), guide = "none") +
  labs(x = "Efekt łączny g w metaanalizie", y = "Liczba metaanaliz",
       title = "A. 1000 metaanaliz po 20 badań", subtitle = "Prawdziwy średni efekt 0.20 (linia kropkowana)") +
  motyw

# B: odsetek metaanaliz, których 95% CI obejmuje prawdziwy efekt, a liczba badań
wyn$scenariusz <- factor(sprintf("δ = %.1f, %s", wyn$delta, ifelse(wyn$selekcja, "tylko p < .05", "wszystkie")),
                         sprintf("δ = %.1f, %s", rep(c(0, 0.2, 0.5), 2), rep(c("wszystkie", "tylko p < .05"), each = 3)))
pb <- ggplot(wyn, aes(factor(k), pokrycie, group = scenariusz, colour = selekcja, linetype = factor(delta),
                      shape = factor(delta))) +
  geom_hline(yintercept = 0.95, colour = "grey40", linetype = "dashed") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  scale_colour_manual(values = c(`FALSE` = kol[["staly"]], `TRUE` = kol[["losowy"]]),
                      labels = c(`FALSE` = "wszystkie badania", `TRUE` = "tylko p < .05"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), labels = c("δ = 0", "δ = 0.2", "δ = 0.5"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), labels = c("δ = 0", "δ = 0.2", "δ = 0.5"), name = NULL) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) paste0(round(100 * x), "%")) +
  guides(colour = guide_legend(ncol = 1, order = 1), linetype = guide_legend(ncol = 1, order = 2),
         shape = guide_legend(ncol = 1, order = 2)) +
  labs(x = "Liczba badań w metaanalizie (k)", y = "95% CI obejmuje prawdziwy efekt",
       title = "B. Więcej badań nie pomaga", subtitle = "1000 metaanaliz w każdym punkcie") +
  motyw
p5 <- pa + pb
p5   # zapis: ggsave("metaanaliza-1000-metaanaliz.svg", p5, width = 10, height = 6)
Wynik w R
  k delta selekcja   sr_M obciazenie pokrycie blad_MC sr_tau2 badan_przepr
  5   0.0    FALSE  0.001      0.001    0.942   0.007  0.0197            5
 10   0.0    FALSE -0.002     -0.002    0.935   0.008  0.0137           10
 20   0.0    FALSE -0.002     -0.002    0.936   0.008  0.0117           20
 40   0.0    FALSE  0.000      0.000    0.943   0.007  0.0110           40
  5   0.2    FALSE  0.200      0.000    0.946   0.007  0.0174            5
 10   0.2    FALSE  0.197     -0.003    0.942   0.007  0.0152           10
 20   0.2    FALSE  0.198     -0.002    0.951   0.007  0.0115           20
 40   0.2    FALSE  0.202      0.002    0.930   0.008  0.0101           40
  5   0.5    FALSE  0.497     -0.003    0.938   0.008  0.0186            5
 10   0.5    FALSE  0.501      0.001    0.933   0.008  0.0150           10
 20   0.5    FALSE  0.501      0.001    0.942   0.007  0.0122           20
 40   0.5    FALSE  0.497     -0.003    0.950   0.007  0.0106           40
  5   0.0     TRUE  0.440      0.440    0.000   0.000  0.0011          118
 10   0.0     TRUE  0.436      0.436    0.000   0.000  0.0002          221
 20   0.0     TRUE  0.434      0.434    0.000   0.000  0.0000          439
 40   0.0     TRUE  0.433      0.433    0.000   0.000  0.0000          865
  5   0.2     TRUE  0.460      0.260    0.001   0.001  0.0012           24
 10   0.2     TRUE  0.459      0.259    0.000   0.000  0.0004           49
 20   0.2     TRUE  0.459      0.259    0.000   0.000  0.0001           97
 40   0.2     TRUE  0.458      0.258    0.000   0.000  0.0000          193
  5   0.5     TRUE  0.591      0.091    0.871   0.011  0.0066            8
 10   0.5     TRUE  0.588      0.088    0.728   0.014  0.0035           15
 20   0.5     TRUE  0.585      0.085    0.471   0.016  0.0016           30
 40   0.5     TRUE  0.586      0.086    0.148   0.011  0.0009           61
                  [,1] [,2]
wszystkie badania 0.06 0.38
tylko p < .05     0.38 0.57
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (efekt stały / losowy; wszystkie / tylko p < .05)" = c("#0072B2", "#D55E00"),
             "granat – cynober (PI / CI dla nowego badania)" = c("#0f1d3a", "#D55E00"),
             "niebieski – granat (CI dla średniej / PI)" = c("#0072B2", "#0f1d3a"),
             "niebieski – szary (opublikowane / w szufladzie)" = c("#0072B2", "#595959"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                      widzenie_typowe
niebieski – cynober (efekt stały / losowy; wszystkie / tylko p < .05)           114.6
granat – cynober (PI / CI dla nowego badania)                                   101.6
niebieski – granat (CI dla średniej / PI)                                        41.3
niebieski – szary (opublikowane / w szufladzie)                                  42.2
czerwony – zielony (do unikania)                                                121.7
                                                                      deuteranopia
niebieski – cynober (efekt stały / losowy; wszystkie / tylko p < .05)        108.3
granat – cynober (PI / CI dla nowego badania)                                 96.6
niebieski – granat (CI dla średniej / PI)                                     40.8
niebieski – szary (opublikowane / w szufladzie)                               45.3
czerwony – zielony (do unikania)                                              21.1
                                                                      protanopia
niebieski – cynober (efekt stały / losowy; wszystkie / tylko p < .05)       91.9
granat – cynober (PI / CI dla nowego badania)                               81.5
niebieski – granat (CI dla średniej / PI)                                   41.3
niebieski – szary (opublikowane / w szufladzie)                             39.9
czerwony – zielony (do unikania)                                            31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Wielkości efektu, modele metaanalizy, przedziały predykcji i test Eggera – pakiet metafor; losowania i ręczny estymator DerSimoniana–Lairda – pakiet stats. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.2.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Wybór modelu po obejrzeniu wyniku (rysunek 1).
- I² jako miara wielkości rozrzutu. Podawaj τ i przedział predykcji (rysunki 2 i 3).
- Przedział ufności zamiast przedziału predykcji w zdaniu o „skuteczności w praktyce”. Przy 40 badaniach CI objął efekt nowego badania tylko w 33% symulacji (rysunek 3).
- Niskie I² i nieistotny test Eggera jako dowód braku problemu. Selekcja wycina heterogeniczność (rysunki 4 i 5).
- „Więcej badań wyrówna błąd publikacji”. Przy selekcji pokrycie spada wraz z liczbą badań (rysunek 5).
Najczęstsze pytania
Dlaczego w modelu efektów losowych duże badanie ma mniejszą wagę?
Bo do wariancji każdego badania dochodzi ten sam składnik τ², opisujący rozrzut prawdziwych efektów. Różnice w precyzji badań tracą wtedy na znaczeniu i wagi się wyrównują. W przykładzie z 12 badaniami największe badanie miało 40.6% wagi w modelu efektu stałego i 15.7% w modelu efektów losowych, a efekt łączny przesunął się z g = 0.28 do 0.36. Model wybiera się przed analizą, na podstawie założeń, a nie wyniku (Borenstein i in., 2010).
Czy I² może być wysokie, choć badania mierzą ten sam efekt?
Tak, zwłaszcza przy niewielu badaniach. W symulacji 15 badań z jednym prawdziwym efektem 0.40 I² wyniosło 33.0%, a jego 95% przedział ufności sięgał od 0 do 76.6%. Dlatego obok I² podawaj τ, przedział ufności I² i przedział predykcji.
Co pokazuje przedział predykcji na wykresie lasu?
Zakres, w którym spodziewamy się prawdziwego efektu w nowym, podobnym badaniu. Przedział ufności dotyczy tylko średniego efektu. W przykładzie średni efekt to g = 0.36, 95% CI [0.21, 0.52], a 95% przedział predykcji [−0.03, 0.76]. W symulacji przy 40 badaniach przedział ufności objął efekt nowego badania w 33.3% metaanaliz, a przedział predykcji – w 90.4%.
Czy dołożenie kolejnych badań do metaanalizy zmniejsza skutki błędu publikacji?
Nie. Gdy publikowane są tylko wyniki istotne, każde nowe badanie jest tak samo zawyżone. W 1000 symulowanych metaanaliz przy prawdziwym efekcie 0.5 przedział ufności obejmował prawdę w 87.1% przypadków przy 5 badaniach i tylko w 14.8% przy 40, a przy efekcie 0 – w żadnym przypadku. Przedział zwęża się wokół złej wartości.
Jak na wykresie lejkowym rozpoznać brakujące badania nieistotne?
Dorysuj obszar wyników nieistotnych (klin wokół zera). Jeśli opublikowane badania leżą tuż za jego krawędzią, a wnętrze, zwłaszcza w dolnej części lejka, jest puste, to przemawia za błędem publikacji (Peters i in., 2008). Asymetria może mieć też inne przyczyny, więc to sygnał, nie dowód (Sterne i in., 2011).
Powiązane hasła
Przeczytaj też
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikBłąd publikacji w metaanalizie – metody
Lejek i test Eggera, trim-and-fill, PET-PEESE, model selekcji, p-curve i fail-safe N porównane na jednej symulacji w R, z wzorem opisu.
Czytaj →PoradnikMetaanaliza w jamovi (MAJOR) krok po kroku
Moduł MAJOR w jamovi: okno Mean Differences, ustawienia domyślne, tabele modelu losowego i heterogeniczności, przedział predykcji, test Eggera i fail-safe N, diagnostyka wpływu – z liczbami z metafor.
Czytaj →Robisz metaanalizę do pracy i nie wiesz, jak pokazać wyniki?
Pomożemy policzyć wielkości efektu, dobrać model, ocenić heterogeniczność i błąd publikacji oraz przygotować wykres lasu i lejka z opisem – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2010). A basic introduction to fixed-effect and random-effects models for meta-analysis. Research Synthesis Methods, 1(2), 97–111. https://doi.org/10.1002/jrsm.12
- Borenstein, M., Higgins, J. P. T., Hedges, L. V., & Rothstein, H. R. (2017). Basics of meta-analysis: I² is not an absolute measure of heterogeneity. Research Synthesis Methods, 8(1), 5–18. https://doi.org/10.1002/jrsm.1230 ● Otwarty dostęp: pełny tekst
- Higgins, J. P. T., Thompson, S. G., Deeks, J. J., & Altman, D. G. (2003). Measuring inconsistency in meta-analyses. BMJ, 327(7414), 557–560. https://doi.org/10.1136/bmj.327.7414.557 ● Otwarty dostęp: pełny tekst
- IntHout, J., Ioannidis, J. P. A., Rovers, M. M., & Goeman, J. J. (2016). Plea for routinely presenting prediction intervals in meta-analysis. BMJ Open, 6(7), Article e010247. https://doi.org/10.1136/bmjopen-2015-010247 ● Otwarty dostęp
- Lewis, S., & Clarke, M. (2001). Forest plots: Trying to see the wood and the trees. BMJ, 322(7300), 1479–1480. https://doi.org/10.1136/bmj.322.7300.1479 ● Otwarty dostęp: pełny tekst
- Peters, J. L., Sutton, A. J., Jones, D. R., Abrams, K. R., & Rushton, L. (2008). Contour-enhanced meta-analysis funnel plots help distinguish publication bias from other causes of asymmetry. Journal of Clinical Epidemiology, 61(10), 991–996. https://doi.org/10.1016/j.jclinepi.2007.11.010
- Riley, R. D., Higgins, J. P. T., & Deeks, J. J. (2011). Interpretation of random effects meta-analyses. BMJ, 342, Article d549. https://doi.org/10.1136/bmj.d549
- Sterne, J. A. C., Sutton, A. J., Ioannidis, J. P. A., Terrin, N., Jones, D. R., Lau, J., Carpenter, J., Rücker, G., Harbord, R. M., Schmid, C. H., Tetzlaff, J., Deeks, J. J., Peters, J., Macaskill, P., Schwarzer, G., Duval, S., Altman, D. G., Moher, D., & Higgins, J. P. T. (2011). Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials. BMJ, 343, Article d4002. https://doi.org/10.1136/bmj.d4002 ● Otwarty dostęp
Cytowania BibTeX
@article{borenstein2010basic, author={Borenstein, Michael and Hedges, Larry V. and Higgins, Julian P. T. and Rothstein, Hannah R.}, title={{A basic introduction to fixed-effect and random-effects models for meta-analysis}}, journal={Research Synthesis Methods}, year={2010}, volume={1}, number={2}, pages={97--111}, doi={10.1002/jrsm.12}}@article{borenstein2017basics, author={Borenstein, Michael and Higgins, Julian P. T. and Hedges, Larry V. and Rothstein, Hannah R.}, title={{Basics of meta-analysis: I² is not an absolute measure of heterogeneity}}, journal={Research Synthesis Methods}, year={2017}, volume={8}, number={1}, pages={5--18}, doi={10.1002/jrsm.1230}}@article{higgins2003measuring, author={Higgins, Julian P. T. and Thompson, Simon G. and Deeks, Jonathan J. and Altman, Douglas G.}, title={{Measuring inconsistency in meta-analyses}}, journal={BMJ}, year={2003}, volume={327}, number={7414}, pages={557--560}, doi={10.1136/bmj.327.7414.557}}@article{inthout2016plea, author={IntHout, Joanna and Ioannidis, John P. A. and Rovers, Maroeska M. and Goeman, Jelle J.}, title={{Plea for routinely presenting prediction intervals in meta-analysis}}, journal={BMJ Open}, year={2016}, volume={6}, number={7}, eid={e010247}, doi={10.1136/bmjopen-2015-010247}}@article{lewis2001forest, author={Lewis, Steff and Clarke, Mike}, title={{Forest plots: Trying to see the wood and the trees}}, journal={BMJ}, year={2001}, volume={322}, number={7300}, pages={1479--1480}, doi={10.1136/bmj.322.7300.1479}}@article{peters2008contour, author={Peters, Jaime L. and Sutton, Alex J. and Jones, David R. and Abrams, Keith R. and Rushton, Lesley}, title={{Contour-enhanced meta-analysis funnel plots help distinguish publication bias from other causes of asymmetry}}, journal={Journal of Clinical Epidemiology}, year={2008}, volume={61}, number={10}, pages={991--996}, doi={10.1016/j.jclinepi.2007.11.010}}@article{riley2011interpretation, author={Riley, Richard D. and Higgins, Julian P. T. and Deeks, Jonathan J.}, title={{Interpretation of random effects meta-analyses}}, journal={BMJ}, year={2011}, volume={342}, eid={d549}, doi={10.1136/bmj.d549}}@article{sterne2011recommendations, author={Sterne, Jonathan A. C. and Sutton, Alex J. and Ioannidis, John P. A. and Terrin, Norma and Jones, David R. and Lau, Joseph and Carpenter, James and Rücker, Gerta and Harbord, Roger M. and Schmid, Christopher H. and Tetzlaff, Jennifer and Deeks, Jonathan J. and Peters, Jaime and Macaskill, Petra and Schwarzer, Guido and Duval, Sue and Altman, Douglas G. and Moher, David and Higgins, Julian P. T.}, title={{Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials}}, journal={BMJ}, year={2011}, volume={343}, eid={d4002}, doi={10.1136/bmj.d4002}}