Moc jako pole pod krzywą
Moc testu to prawdopodobieństwo, że test odrzuci hipotezę zerową, jeśli w populacji istnieje efekt o założonej wielkości. Definicję, wzory i opis analizy mocy w pracy znajdziesz w słowniku i w poradniku o doborze liczebności próby. Tutaj teorię rysujemy: α, β, moc i zawyżony efekt to pola pod krzywymi albo chmury punktów z symulacji. Kiedy raz zobaczysz te pola, łatwo zrozumiesz, dlaczego mała próba szkodzi nawet wtedy, gdy wynik wyszedł istotny.
Wpis prowadzi przez pięć rysunków dla najprostszego przypadku: testu t dla prób niezależnych, dwóch grup o tej samej liczebności i dwustronnej hipotezy. Przy każdym rysunku są cztery części: co widać, czego wykres nie pokazuje, gotowy podpis i zdanie do pracy. Ogólne zasady rysowania są we wpisie wykresy w pracy dyplomowej. Wszystkie liczby pochodzą z kodu w sekcji Kod R. Symulacje mają jedno ziarno (568), ustalone z góry i niedobierane pod wynik. Przy odsetkach z symulacji podajemy błąd Monte Carlo (MC).
Rysunek 1: dwa rozkłady, trzy pola
Wyobraź sobie badanie z dwiema grupami po 20 osób. Prawdziwy efekt wynosi d = 0.5, test jest dwustronny, α = .05. Statystyka t z takiego badania ma inny rozkład w zależności od tego, która hipoteza jest prawdziwa. Przy braku efektu (H0) to zwykły rozkład t z 38 stopniami swobody, skupiony wokół zera. Przy efekcie (H1) to rozkład t niecentralny, przesunięty o parametr niecentralności d·√(n/2) = 1.58 (więcej o tym parametrze w haśle o parametrze niecentralności).
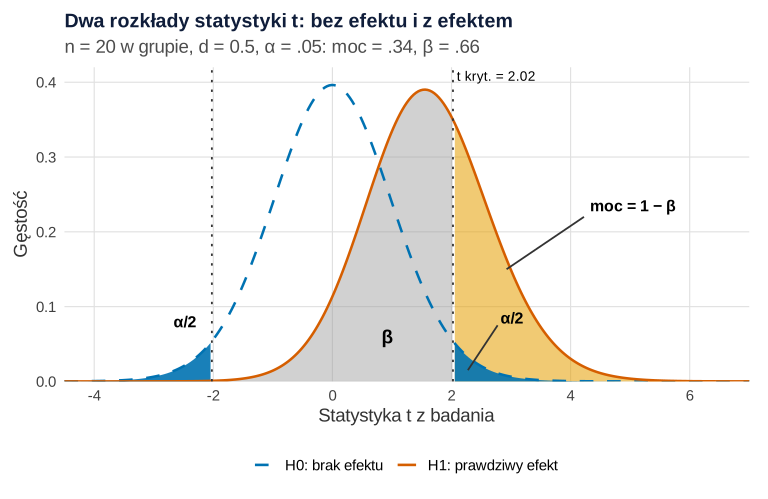
Co widać. Pionowe linie to wartości krytyczne ±2.02. Ciemne pola w ogonach krzywej H0 to poziom istotności α, po .025 z każdej strony – tak często test „widzi” efekt, którego nie ma. Szare pole pod krzywą H1 między liniami to β, czyli prawdopodobieństwo przeoczenia prawdziwego efektu (błąd II rodzaju): .66. Żółte pole to moc, 1 − β = .34. Sprawdzenie symulacją 10 000 takich badań dało 33.0% wyników istotnych (błąd MC 0.5 pp), zgodnie ze wzorem w granicach dwóch błędów MC.
Czego ten wykres nie pokazuje. Krzywa H1 zakłada, że prawdziwe d wynosi dokładnie 0.5. W prawdziwym badaniu tego nie wiesz – moc to zawsze moc dla założonego efektu. Nie dotyczy też danych, które już zebrałeś. To rozkłady statystyki testowej z wielu wyobrażonych powtórzeń badania, a nie rozkłady wyników osób w dwóch grupach.
Podpis do pracy (np. w rozdziale o planie badania):
Zdanie do pracy.
Rysunek 2: co przesuwa krzywe – n, d i α
Moc rośnie, gdy krzywa H1 odsuwa się od H0, i maleje, gdy wartości krytyczne odsuwają się od zera. Rysunek 2 pokazuje trzy zmiany względem punktu wyjścia, każdą osobno.
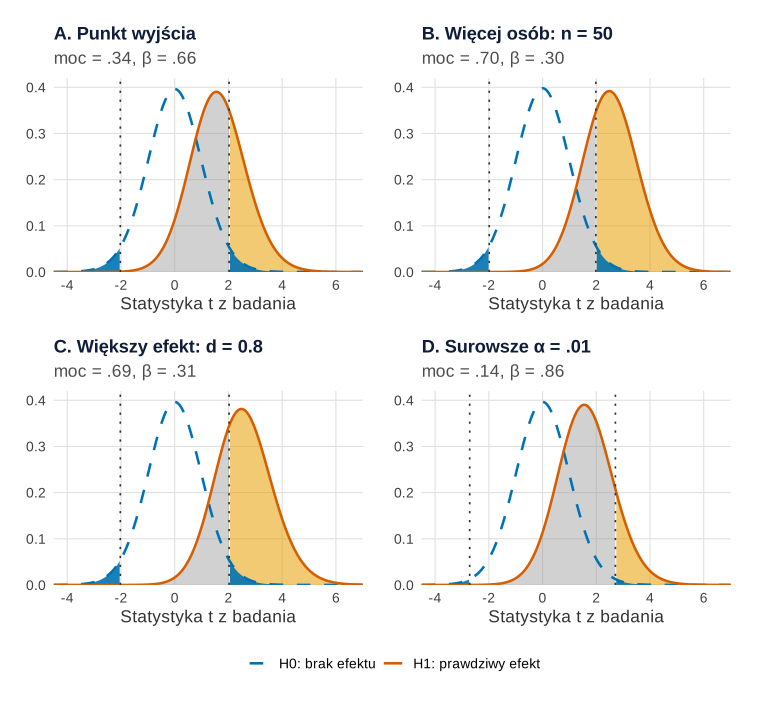
Co widać. W panelu B (50 zamiast 20 osób w grupie) krzywa H1 przesuwa się w prawo, bo parametr niecentralności rośnie z pierwiastkiem z n: z 1.58 do 2.50. Moc rośnie do .70. W panelu C większy efekt (d = 0.8 przy 20 osobach) daje prawie to samo przesunięcie (2.53) i prawie tę samą moc (.69). Liczebność i efekt działają więc przez tę samą wielkość. W panelu D krzywe stoją w miejscu, ale wartości krytyczne odsuwają się do ±2.71. Surowsze α obcina żółte pole i moc spada do .14.
Czego ten wykres nie pokazuje. Zmiana d w panelu C wygląda na tak samo łatwą jak zmiana n, ale to złudzenie: wielkości efektu zwykle nie wybierasz. Możesz ją zwiększyć tylko pośrednio – rzetelniejszym pomiarem, planem wewnątrzobiektowym albo kontrolą zmiennej towarzyszącej, które zmniejszają szum. Wykres nie pokazuje też kosztu niższego α: mniej fałszywych alarmów oznacza więcej przeoczeń, co ma znaczenie przy wielokrotnych testach i poprawkach typu Bonferroniego. Test jednostronny usunąłby lewą linię krytyczną i przysunął prawą bliżej zera, ale tylko wtedy, gdy kierunek ustalisz przed badaniem.
Podpis do pracy.
Zdanie do pracy.
Rysunek 3: krzywe mocy – wzór i symulacja
Jeśli zsumujesz żółte pola dla kolejnych liczebności, dostaniesz krzywą mocy. Rysunek 3 pokazuje ją dla trzech wartości d, które Cohen (1992) nazwał efektem małym, średnim i dużym. Linie pochodzą ze wzoru (funkcja power.t.test(), niecentralny rozkład t). Punkty to wyniki symulacji: dla każdej z 18 kombinacji d i n wylosowaliśmy 4 000 badań i policzyliśmy odsetek wyników z p < .05.
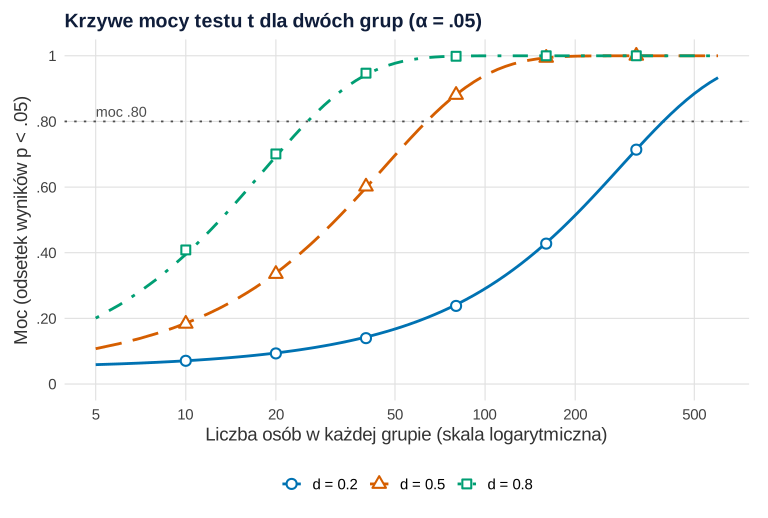
Co widać. Punkty leżą na liniach: największa różnica między symulacją a wzorem to 0.013, a błąd MC pojedynczego punktu nie przekracza 0.8 pp. Do mocy .80 potrzeba 26 osób w grupie przy d = 0.8, 64 przy d = 0.5 i 394 przy d = 0.2. Krzywe mają ten sam kształt, tylko przesunięty. Potrzebna liczebność rośnie mniej więcej z kwadratem odwrotności efektu: efekt 2.5 razy mniejszy (0.5 → 0.2) wymaga około 6 razy większej próby (64 → 394).
Czego ten wykres nie pokazuje. Krzywe dotyczą jednego testu przy spełnionych założeniach (rozkład normalny, równe wariancje, równe grupy). Przy innych planach – interakcja, model mieszany, odpadanie osób – moc trzeba policzyć osobno, często symulacją (zob. moc dla interakcji i moc dla modelu mieszanego). Nie podpowiada też, które d wybrać – to decyzja merytoryczna, nie konwencja Cohena. Lakens (2022) opisuje sześć sposobów uzasadnienia liczebności, z których analiza mocy a priori jest tylko jednym.
Podpis do pracy.
Zdanie do pracy.
Moc dla innych testów policzysz w kalkulatorze mocy dla ANOVA, χ² i regresji, a bez kodu – w module jpower w jamovi (analiza mocy w jamovi). Ćwiczenia z rozwiązaniami są w zbiorze zadań z mocy i liczebności.
Rysunek 4: klątwa zwycięzcy przy niskiej mocy
Niska moc to nie tylko przeoczone efekty. Button i in. (2013) wskazują, że małe próby prowadzą też do zawyżonych oszacowań wielkości efektu i niskiej powtarzalności wyników. Rysunek 4 pokazuje ten mechanizm. Prawdziwy efekt to d = 0.3. Symulujemy po 10 000 badań w dwóch planach: 30 osób w grupie (moc .21) i 176 osób w grupie (moc .80). Na rysunku jest pierwszych 300 badań z każdego planu, a statystyki liczymy ze wszystkich 10 000.
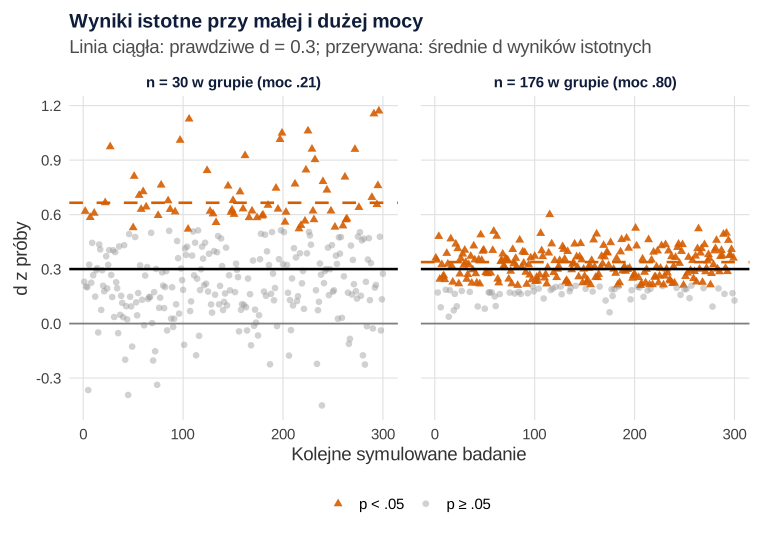
Co widać. W lewym panelu wyniki istotne (21.3% badań, błąd MC 0.4 pp) leżą wyłącznie w górnej części chmury. Przy 30 osobach w grupie żadne dodatnie d mniejsze niż 0.52 nie dało p < .05. Średnie d wszystkich badań wynosi 0.31, czyli prawie dokładnie tyle, ile prawda. Średnie d wyników istotnych to już 0.67. Gelman i Carlin (2014) nazywają ten iloraz błędem typu M (współczynnikiem przesady). Tu wynosi on 2.23. Zdarza się też błąd typu S: 9 z 2128 istotnych wyników (0.4%) miało zły znak. W prawym panelu, przy mocy .80, średnia istotnych to 0.34, a przesada spada do 1.13.
Czego ten wykres nie pokazuje. Nie wiadomo, czy Twój istotny wynik jest zawyżony – zawyżona jest średnia wyników, które przeszły próg, a w literaturze dokłada się do tego błąd publikacji. Ioannidis (2008) pokazuje, że efekty „odkryte” po przekroczeniu progu istotności w badaniach o niskiej mocy powinny być zawyżone. Inny przykład tego zjawiska – wybór najsilniejszego z 20 predyktorów – opisuje hasło klątwa zwycięzcy, a wzory na oba błędy – hasło błędy typu S i typu M.
Podpis do pracy (np. w rozdziale teoretycznym lub w dyskusji):
Zdanie do pracy (do Dyskusji, gdy planujesz na podstawie jednego opublikowanego badania):
Rysunek 5: dlaczego „moc po fakcie” nic nie mówi
Gdy promotor prosi o „moc badania” po fakcie, program wstawia do wzoru d z próby i podaje tzw. moc obserwowaną. Hoenig i Heisey (2001) nazywają takie wyjaśnianie wyniku nieistotnego podejściem z gruntu błędnym. Rysunek 5 pokazuje dlaczego: to samo badanie (32 osoby w grupie, d = 0.5, prawdziwa moc .50) powtórzone 10 000 razy, a w każdym powtórzeniu policzona „moc po fakcie”.
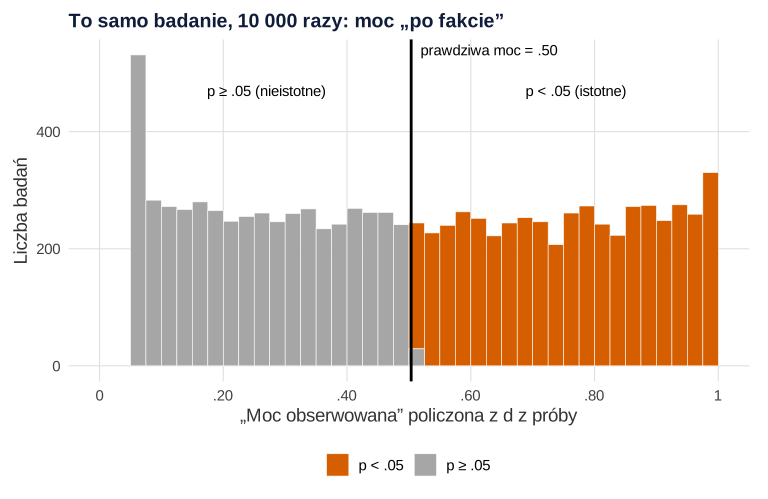
Co widać. Prawdziwa moc jest jedna (.50), a „moc obserwowana” rozkłada się prawie równomiernie od .05 do 1. W 19.0% powtórzeń wyszła poniżej .20, w 21.2% powyżej .80. Zgadza się to z analizą Yuana i Maxwella (2005): przy znanej wariancji i prawdziwej mocy .50 rozkład mocy post hoc jest jednostajny, a nasz test t z szacowaną wariancją daje obraz bardzo podobny. Do tego histogram dzieli się na kolory dokładnie na linii .50. Moc obserwowana to tylko inny zapis wartości p: przy 32 osobach w grupie p = .05 zawsze daje moc około .50, p = .20 – .25, a p = .01 – .74. Wynik nieistotny zawsze ma więc „niską moc”, a liczba ta nic nie dodaje do p.
Czego ten wykres nie pokazuje. Co podać zamiast tej liczby. Po badaniu lepiej sprawdzają się przedział ufności dla efektu i analiza wrażliwości (jakie efekty badanie mogło wykryć z mocą .80). Gotowe zdania i odpowiedź dla recenzenta są we wpisie moc po fakcie – co podać zamiast. Precyzję oszacowania można też zaplanować z góry (liczebność z precyzji, AIPE).
Podpis do pracy (np. w aneksie, jako odpowiedź na uwagę recenzenta):
Zdanie do pracy.
Moc w pracy dyplomowej: który rysunek gdzie
- Plan badania lub Metoda: zwykle wystarczy jedno zdanie o analizie mocy a priori (efekt, jego źródło, α, moc, test, program). Rysunek 3 z jedną krzywą dla Twojego d przydaje się, gdy uzasadniasz kompromis, np. dlaczego zbadasz 40, a nie 64 osoby w grupie.
- Rozdział teoretyczny: rysunki 1 i 2 tłumaczą α, β i moc; w pracy empirycznej raczej w aneksie.
- Dyskusja: rysunek 4 albo samo zdanie o błędzie typu M, gdy Twój efekt jest dużo większy niż w literaturze albo gdy planowałeś na podstawie małego pilotażu.
- Nigdy: moc obserwowana jako argument za „trendem”. W tym miejscu podaj przedział ufności i analizę wrażliwości.
Paletę sprawdzono w symulacji deuteranopii (przepis 6), a każdą informację niesie też typ linii, kształt punktu albo etykieta. Jak wygląda sam efekt d = 0.2, 0.5 i 0.8 na rozkładach wyników, pokazuje wpis wielkość efektu w obrazkach. O interpretacji samych miar efektu piszemy w poradniku wielkość efektu – interpretacja, a o rozkładzie p pod H0 i H1 – we wpisie wartość p.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje paletę, motyw i funkcje, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane są symulowane w kodzie, więc nic nie trzeba pobierać. Ziarno losowania 568 ustalono z góry, jednakowe we wszystkich przepisach z symulacją, i nie dobierano go pod wynik. Ręcznie wybrano tylko parametry przykładów: d = 0.5 i 20 osób w grupie (rysunek 1), d = 0.3 i 30 osób w grupie, czyli moc około .20 (rysunek 4), oraz 32 osoby w grupie, czyli moc około .50 (rysunek 5). Liczba powtórzeń: 10 000 (rysunki 1, 4 i 5) i 4 000 na punkt (rysunek 3); każdy przepis liczy się w kilka sekund.
1. Dwa rozkłady statystyki t, pola α, β i moc: Rysunek 1
R
# Rysunek 1. Rozkład statystyki t pod H0 i pod H1: pola α, β i moc (test t dla dwóch grup)
library(ggplot2)
# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw) i prosty motyw
kol <- c(H0 = "#0072B2", H1 = "#D55E00", moc = "#E69F00", alfa = "#0072B2", beta = "grey60")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", size = rel(1.0)), panel.grid.minor = element_blank(),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .34 zamiast 0.34

# Pola pod krzywymi dla jednego planu badania: n osób w każdej grupie, prawdziwe d, poziom alfa
pola <- function(n, d, alfa = .05) {
  df <- 2 * n - 2; ncp <- d * sqrt(n / 2); t_kr <- qt(1 - alfa / 2, df)
  moc <- pt(t_kr, df, ncp, lower.tail = FALSE) + pt(-t_kr, df, ncp)   # oba ogony pod H1
  c(n = n, d = d, alfa = alfa, df = df, ncp = ncp, t_kr = t_kr, beta = 1 - moc, moc = moc)
}
# Krzywe gęstości t pod H0 (centralny rozkład t) i pod H1 (niecentralny rozkład t)
krzywe <- function(n, d, alfa = .05, od = -4.5, do = 7) {
  p <- pola(n, d, alfa); t <- seq(od, do, length.out = 301)
  data.frame(t = t, h0 = dt(t, p[["df"]]), h1 = dt(t, p[["df"]], p[["ncp"]]), t_kr = p[["t_kr"]])
}
rysuj_pola <- function(n, d, alfa = .05, tytul = NULL, etykiety = TRUE, krotko = FALSE) {
  p <- pola(n, d, alfa); k <- krzywe(n, d, alfa); tk <- p[["t_kr"]]
  g <- ggplot(k, aes(t)) +
    geom_area(data = subset(k, t >= tk), aes(y = h1), fill = kol[["moc"]], alpha = 0.55) +     # moc
    geom_area(data = subset(k, abs(t) < tk), aes(y = h1), fill = kol[["beta"]], alpha = 0.45) + # β
    geom_area(data = subset(k, t >= tk), aes(y = h0), fill = kol[["alfa"]], alpha = 0.9) +      # α/2 prawy
    geom_area(data = subset(k, t <= -tk), aes(y = h0), fill = kol[["alfa"]], alpha = 0.9) +     # α/2 lewy
    geom_line(aes(y = h0, linetype = "H0: brak efektu"), colour = kol[["H0"]], linewidth = 0.9) +
    geom_line(aes(y = h1, linetype = "H1: prawdziwy efekt"), colour = kol[["H1"]], linewidth = 0.9) +
    geom_vline(xintercept = c(-tk, tk), linetype = "dotted", colour = "grey20") +
    scale_linetype_manual(values = c("H0: brak efektu" = "dashed", "H1: prawdziwy efekt" = "solid"), name = NULL) +
    scale_x_continuous(breaks = seq(-4, 7, 2)) +
    coord_cartesian(ylim = c(0, 0.42), expand = FALSE) +
    labs(x = "Statystyka t z badania", y = "Gęstość", title = tytul,
         subtitle = if (krotko) sprintf("moc = %s, β = %s", bz(p[["moc"]]), bz(p[["beta"]])) else
           sprintf("n = %d w grupie, d = %.1f, α = %s: moc = %s, β = %s", n, d, sub("^0", "", format(alfa)),
                   bz(p[["moc"]]), bz(p[["beta"]]))) + motyw +
    guides(linetype = guide_legend(override.aes = list(colour = unname(kol[c("H0", "H1")]))))
  if (etykiety) g <- g +
    annotate("segment", x = tk + 2.2, xend = tk + 0.9, y = 0.22, yend = 0.15, colour = "grey20") +
    annotate("text", x = tk + 2.3, y = 0.235, label = "moc = 1 − β", fontface = "bold", size = 4.2, hjust = 0) +
    annotate("text", x = tk - 1.1, y = 0.06, label = "β", fontface = "bold", size = 5) +
    annotate("segment", x = tk + 0.75, xend = tk + 0.25, y = 0.075, yend = 0.015, colour = "grey20") +
    annotate("text", x = tk + 0.8, y = 0.085, label = "α/2", fontface = "bold", size = 4.2, hjust = 0) +
    annotate("text", x = -tk - 0.45, y = 0.08, label = "α/2", fontface = "bold", size = 4.2) +
    annotate("text", x = tk, y = 0.415, label = paste0("t kryt. = ", sprintf("%.2f", tk)), size = 3.6,
             hjust = -0.05, vjust = 1)
  g
}

# Plan bazowy: 20 osób w grupie, prawdziwe d = 0.5, α = .05, test dwustronny
round(pola(20, 0.5), 3)
power.t.test(n = 20, delta = 0.5, sd = 1, sig.level = .05, strict = TRUE)$power   # kontrola: to samo

# Sprawdzenie symulacją: 10 000 badań z prawdziwym efektem d = 0.5
set.seed(568)
R <- 10000; n <- 20
t_sym <- replicate(R, t.test(rnorm(n, 0.5), rnorm(n, 0), var.equal = TRUE)$statistic)
moc_sym <- mean(abs(t_sym) > qt(.975, 2 * n - 2))
c(moc_symulacja = round(moc_sym, 3), blad_MC = round(sqrt(moc_sym * (1 - moc_sym) / R), 4))

p1 <- rysuj_pola(20, 0.5, tytul = "Dwa rozkłady statystyki t: bez efektu i z efektem")
p1   # zapis: ggsave("rozklady-h0-h1.svg", p1, width = 8, height = 5.2)
Wynik w R
     n      d   alfa     df    ncp   t_kr   beta    moc
20.000  0.500  0.050 38.000  1.581  2.024  0.662  0.338
[1] 0.337939
moc_symulacja       blad_MC
       0.3300        0.0047
2. Co przesuwa moc – liczebność, efekt i α: Rysunek 2
R
# Rysunek 2. Co przesuwa moc: liczebność, wielkość efektu i poziom α (kontynuacja: pola(), rysuj_pola(), motyw)
library(patchwork)
plany <- data.frame(panel = c("A. Punkt wyjścia", "B. Więcej osób: n = 50", "C. Większy efekt: d = 0.8",
                              "D. Surowsze α = .01"),
                    n = c(20, 50, 20, 20), d = c(0.5, 0.5, 0.8, 0.5), alfa = c(.05, .05, .05, .01))
wyniki <- t(mapply(pola, plany$n, plany$d, plany$alfa))
cbind(plany["panel"], round(wyniki[, c("ncp", "t_kr", "beta", "moc")], 3))

panele <- lapply(seq_len(nrow(plany)), function(i)
  rysuj_pola(plany$n[i], plany$d[i], plany$alfa[i], tytul = plany$panel[i], etykiety = FALSE, krotko = TRUE) +
    labs(y = NULL))
p2 <- wrap_plots(panele, ncol = 2, guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("co-przesuwa-moc.svg", p2, width = 8, height = 7.4)
Wynik w R
                      panel   ncp  t_kr  beta   moc
1          A. Punkt wyjścia 1.581 2.024 0.662 0.338
2    B. Więcej osób: n = 50 2.500 1.984 0.303 0.697
3 C. Większy efekt: d = 0.8 2.530 2.024 0.307 0.693
4       D. Surowsze α = .01 1.581 2.712 0.856 0.144
3. Krzywe mocy ze wzoru i z symulacji: Rysunek 3
R
# Rysunek 3. Krzywe mocy dla d = 0.2, 0.5 i 0.8: wzór (power.t.test) i punkty z symulacji (kontynuacja: motyw, bz())
library(ggplot2)
efekty <- c(0.2, 0.5, 0.8)
kol_d <- c("d = 0.2" = "#0072B2", "d = 0.5" = "#D55E00", "d = 0.8" = "#009E73")
siatka <- expand.grid(n = unique(round(exp(seq(log(5), log(600), length.out = 80)))), d = efekty)
siatka$moc <- mapply(function(n, d) power.t.test(n = n, delta = d, strict = TRUE)$power, siatka$n, siatka$d)

# Symulacja: dla każdego d i n – 4 000 badań, test t dla prób niezależnych (wariancje równe)
moc_sym <- function(n, d, R = 4000) {
  x <- matrix(rnorm(R * n, d), R); y <- matrix(rnorm(R * n, 0), R)
  sp <- sqrt((apply(x, 1, var) + apply(y, 1, var)) / 2)
  t <- (rowMeans(x) - rowMeans(y)) / (sp * sqrt(2 / n))
  mean(abs(t) > qt(.975, 2 * n - 2))
}
set.seed(568)
punkty <- expand.grid(n = c(10, 20, 40, 80, 160, 320), d = efekty)
punkty$symulacja <- mapply(moc_sym, punkty$n, punkty$d)
punkty$wzor <- mapply(function(n, d) power.t.test(n = n, delta = d, strict = TRUE)$power, punkty$n, punkty$d)
punkty$blad_MC <- sqrt(punkty$symulacja * (1 - punkty$symulacja) / 4000)
print(within(punkty, { symulacja <- round(symulacja, 3); wzor <- round(wzor, 3); blad_MC <- round(blad_MC, 4) }),
      row.names = FALSE)
c(najwieksza_roznica = round(max(abs(punkty$symulacja - punkty$wzor)), 3), najwiekszy_blad_MC = round(max(punkty$blad_MC), 4))

# Liczebność w grupie potrzebna do mocy .80 i .90
sapply(efekty, function(d) c(d = d, n_80 = ceiling(power.t.test(power = .80, delta = d)$n),
                             n_90 = ceiling(power.t.test(power = .90, delta = d)$n)))

siatka$efekt <- factor(paste("d =", siatka$d)); punkty$efekt <- factor(paste("d =", punkty$d))
p3 <- ggplot(siatka, aes(n, moc, colour = efekt)) +
  geom_hline(yintercept = 0.8, linetype = "dotted", colour = "grey30") +
  geom_line(aes(linetype = efekt), linewidth = 1) +
  geom_point(data = punkty, aes(y = symulacja, shape = efekt), size = 2.8, fill = "white", stroke = 1.1) +
  scale_colour_manual(values = kol_d, name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash"), name = NULL) +
  scale_shape_manual(values = c(21, 24, 22), name = NULL) +
  scale_x_log10(breaks = c(5, 10, 20, 50, 100, 200, 500)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = function(x) ifelse(x == 0, "0", ifelse(x == 1, "1", bz(x)))) +
  annotate("text", x = 5, y = 0.83, label = "moc .80", hjust = 0, size = 3.8, colour = "grey30") +
  labs(x = "Liczba osób w każdej grupie (skala logarytmiczna)", y = "Moc (odsetek wyników p < .05)",
       title = "Krzywe mocy testu t dla dwóch grup (α = .05)") + motyw
p3   # zapis: ggsave("krzywe-mocy.svg", p3, width = 8, height = 5.4)
Wynik w R
   n   d symulacja  wzor blad_MC
  10 0.2     0.071 0.071  0.0041
  20 0.2     0.093 0.095  0.0046
  40 0.2     0.140 0.143  0.0055
  80 0.2     0.238 0.242  0.0067
 160 0.2     0.428 0.430  0.0078
 320 0.2     0.714 0.714  0.0071
  10 0.5     0.184 0.185  0.0061
  20 0.5     0.335 0.338  0.0075
  40 0.5     0.602 0.598  0.0077
  80 0.5     0.881 0.882  0.0051
 160 0.5     0.994 0.994  0.0012
 320 0.5     1.000 1.000  0.0000
  10 0.8     0.408 0.395  0.0078
  20 0.8     0.701 0.693  0.0072
  40 0.8     0.947 0.942  0.0035
  80 0.8     0.999 0.999  0.0006
 160 0.8     1.000 1.000  0.0000
 320 0.8     1.000 1.000  0.0000
najwieksza_roznica najwiekszy_blad_MC
            0.0130             0.0078
      [,1] [,2] [,3]
d      0.2  0.5  0.8
n_80 394.0 64.0 26.0
n_90 527.0 86.0 34.0
4. Klątwa zwycięzcy: oszacowania d przy mocy .21 i .80: Rysunek 4
R
# Rysunek 4. Klątwa zwycięzcy: oszacowania d w 10 000 badań przy mocy około .20 i .80 (kontynuacja: motyw, bz())
library(ggplot2)
d_prawdziwe <- 0.3
n_male <- 30                                                         # moc ≈ .21
n_duze <- ceiling(power.t.test(power = .80, delta = d_prawdziwe)$n) # moc ≈ .80
c(n_male = n_male, moc_male = round(power.t.test(n = n_male, delta = d_prawdziwe)$power, 3),
  n_duze = n_duze, moc_duze = round(power.t.test(n = n_duze, delta = d_prawdziwe)$power, 3))

# R badań z dwiema grupami po n osób; zwraca d z próby i p z testu t (wariancje równe)
badania <- function(n, d, R = 10000) {
  x <- matrix(rnorm(R * n, d), R); y <- matrix(rnorm(R * n, 0), R)
  sp <- sqrt((apply(x, 1, var) + apply(y, 1, var)) / 2)
  d_obs <- (rowMeans(x) - rowMeans(y)) / sp
  t <- d_obs / sqrt(2 / n)
  data.frame(d_obs = d_obs, p = 2 * pt(-abs(t), 2 * n - 2))
}
set.seed(568)
sym <- rbind(cbind(plan = "male", badania(n_male, d_prawdziwe)),
             cbind(plan = "duze", badania(n_duze, d_prawdziwe)))
sym$istotny <- sym$p < .05

podsum <- function(s) {
  ist <- s[s$istotny, ]
  c(istotne = mean(s$istotny), sr_d_wszystkie = mean(s$d_obs), sr_d_istotne = mean(ist$d_obs),
    przesada_typ_M = mean(abs(ist$d_obs)) / d_prawdziwe, zly_znak_typ_S = mean(ist$d_obs < 0),
    min_d_istotne_dodatnie = min(ist$d_obs[ist$d_obs > 0]))
}
round(sapply(split(sym, sym$plan)[c("male", "duze")], podsum), 3)
c(istotne_male = sum(sym$istotny[sym$plan == "male"]),
  istotne_ze_zlym_znakiem = sum(sym$istotny & sym$plan == "male" & sym$d_obs < 0))
q <- mean(sym$istotny[sym$plan == "male"])
round(c(blad_MC_odsetka_istotnych = sqrt(q * (1 - q) / 10000)), 4)

# Na rysunku: pierwsze 300 badań z każdego planu (statystyki wyżej – ze wszystkich 10 000)
pokaz <- do.call(rbind, lapply(split(sym, sym$plan), function(s) cbind(s[1:300, ], nr = 1:300)))
etyk <- c(male = sprintf("n = %d w grupie (moc %s)", n_male, bz(power.t.test(n = n_male, delta = d_prawdziwe)$power)),
          duze = sprintf("n = %d w grupie (moc %s)", n_duze, bz(power.t.test(n = n_duze, delta = d_prawdziwe)$power)))
pokaz$plan <- factor(pokaz$plan, names(etyk), etyk)
pokaz$wynik <- factor(ifelse(pokaz$istotny, "p < .05", "p ≥ .05"), c("p < .05", "p ≥ .05"))
srednie <- aggregate(d_obs ~ plan, subset(sym, istotny), mean)       # średnia istotnych ze wszystkich 10 000 badań
srednie$plan <- factor(etyk[srednie$plan], etyk)
p4 <- ggplot(pokaz, aes(nr, d_obs)) +
  geom_point(aes(shape = wynik, colour = wynik, alpha = wynik), size = 1.9) +
  geom_hline(yintercept = d_prawdziwe, linewidth = 0.9, colour = "black") +
  geom_hline(data = srednie, aes(yintercept = d_obs), linetype = "dashed", linewidth = 0.9, colour = "#D55E00") +
  geom_hline(yintercept = 0, colour = "grey50") +
  facet_wrap(~ plan, ncol = 2) +
  scale_shape_manual(values = c("p < .05" = 17, "p ≥ .05" = 16), name = NULL) +
  scale_colour_manual(values = c("p < .05" = "#D55E00", "p ≥ .05" = "grey60"), name = NULL) +
  scale_alpha_manual(values = c("p < .05" = 0.9, "p ≥ .05" = 0.45), name = NULL) +
  scale_y_continuous(breaks = seq(-0.6, 1.4, 0.3)) +
  labs(x = "Kolejne symulowane badanie", y = "d z próby",
       title = "Wyniki istotne przy małej i dużej mocy",
       subtitle = "Linia ciągła: prawdziwe d = 0.3; przerywana: średnie d wyników istotnych") +
  motyw + theme(panel.spacing = unit(1.2, "lines"))
p4   # zapis: ggsave("klatwa-zwyciezcy.svg", p4, width = 8, height = 5.6)
Wynik w R
  n_male moc_male   n_duze moc_duze
  30.000    0.207  176.000    0.801
                        male  duze
istotne                0.213 0.806
sr_d_wszystkie         0.306 0.302
sr_d_istotne           0.665 0.338
przesada_typ_M         2.233 1.128
zly_znak_typ_S         0.004 0.000
min_d_istotne_dodatnie 0.517 0.210
           istotne_male istotne_ze_zlym_znakiem
                   2128                       9
blad_MC_odsetka_istotnych
                   0.0041
5. Moc obserwowana w 10 000 powtórzeń badania: Rysunek 5
R
# Rysunek 5. „Moc post hoc” z obserwowanego efektu w 10 000 badaniach o prawdziwej mocy .50 (kontynuacja: motyw, bz())
library(ggplot2)
n <- 32; d_prawdziwe <- 0.5
moc_prawdziwa <- power.t.test(n = n, delta = d_prawdziwe, strict = TRUE)$power
round(moc_prawdziwa, 3)

set.seed(568)
R <- 10000
x <- matrix(rnorm(R * n, d_prawdziwe), R); y <- matrix(rnorm(R * n, 0), R)
d_obs <- (rowMeans(x) - rowMeans(y)) / sqrt((apply(x, 1, var) + apply(y, 1, var)) / 2)
p <- 2 * pt(-abs(d_obs / sqrt(2 / n)), 2 * n - 2)
# „moc obserwowana”: moc policzona tak, jakby d z próby było prawdziwym efektem
moc_obs <- sapply(abs(d_obs), function(d) power.t.test(n = n, delta = d, strict = TRUE)$power)

c(srednia = mean(moc_obs), mediana = median(moc_obs), ponizej_20 = mean(moc_obs < .20),
  powyzej_80 = mean(moc_obs > .80), istotne = mean(p < .05)) |> round(3)
# Moc obserwowana zależy tylko od p (przy danym n): kilka par p → moc
p_wybrane <- c(.01, .05, .20, .50)
d_z_p <- qt(1 - p_wybrane / 2, 2 * n - 2) * sqrt(2 / n)
round(cbind(p = p_wybrane, d = d_z_p, moc_obs = sapply(d_z_p, function(d) power.t.test(n = n, delta = d, strict = TRUE)$power)), 3)

dane5 <- data.frame(moc_obs = moc_obs, wynik = factor(ifelse(p < .05, "p < .05", "p ≥ .05"), c("p < .05", "p ≥ .05")))
p5 <- ggplot(dane5, aes(moc_obs, fill = wynik)) +
  geom_histogram(breaks = seq(0, 1, 0.025), colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = moc_prawdziwa, linewidth = 1) +
  annotate("text", x = moc_prawdziwa + 0.015, y = Inf, vjust = 1.5, hjust = 0, size = 3.9,
           label = paste0("prawdziwa moc = ", bz(moc_prawdziwa))) +
  annotate("text", x = c(0.27, 0.77), y = 470, label = c("p ≥ .05 (nieistotne)", "p < .05 (istotne)"), size = 3.9) +
  scale_fill_manual(values = c("p < .05" = "#D55E00", "p ≥ .05" = "grey65"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = function(x) ifelse(x == 0, "0", ifelse(x == 1, "1", bz(x)))) +
  labs(x = "„Moc obserwowana” policzona z d z próby", y = "Liczba badań",
       title = "To samo badanie, 10 000 razy: moc „po fakcie”") + motyw
p5   # zapis: ggsave("moc-obserwowana.svg", p5, width = 8, height = 5.2)
Wynik w R
[1] 0.504
   srednia    mediana ponizej_20 powyzej_80    istotne
     0.512      0.506      0.190      0.212      0.503
        p     d moc_obs
[1,] 0.01 0.664   0.744
[2,] 0.05 0.500   0.503
[3,] 0.20 0.324   0.247
[4,] 0.50 0.170   0.102
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (H0 / H1)" = c("#0072B2", "#D55E00"),
             "pomarańcz – szary (moc / β)" = c("#E69F00", "#999999"),
             "cynober – szary (istotne / nie)" = c("#D55E00", "#999999"),
             "zielony – niebieski (d = 0.8 / 0.2)" = c("#009E73", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                    widzenie_typowe deuteranopia protanopia
niebieski – cynober (H0 / H1)                 114.6        108.3       91.9
pomarańcz – szary (moc / β)                    76.8         73.9       70.0
cynober – szary (istotne / nie)                77.2         62.9       56.0
zielony – niebieski (d = 0.8 / 0.2)            70.1         55.4       58.0
czerwony – zielony (do unikania)              121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (rozkłady, power.t.test() i symulacje – pakiet stats). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Moc bez wielkości efektu. „Badanie miało moc .80” nic nie znaczy, dopóki nie dodasz: dla jakiego d, przy jakim α i w jakim teście.
- Efekt do analizy mocy wzięty z jednego małego badania. Taki efekt jest najpewniej zawyżony (rysunek 4), więc planowana próba wyjdzie za mała.
- Moc obserwowana dla wyniku nieistotnego. To inny zapis wartości p (rysunek 5). Podaj przedział ufności i analizę wrażliwości.
- Surowsze α bez większej próby. Przy poprawce na wiele testów moc pojedynczego testu spada (rysunek 2D). Uwzględnij to już na etapie planu.
- Test jednostronny wybrany po zobaczeniu danych. Wtedy faktyczne α się podwaja.
Najczęstsze pytania
Jak na wykresie odróżnić α, β i moc testu?
Narysuj dwa rozkłady statystyki testowej: przy braku efektu (H0) i przy założonym efekcie (H1), oraz wartości krytyczne. α to pole pod krzywą H0 za wartościami krytycznymi, β to pole pod krzywą H1 między nimi, a moc to reszta pola pod krzywą H1, czyli 1 − β. Przy 20 osobach w grupie i d = 0.5 β = .66, a moc = .34.
Dlaczego obniżenie α do .01 zmniejsza moc?
Bo wartości krytyczne odsuwają się od zera (w teście t z 38 stopniami swobody z 2.02 do 2.71), a rozkład przy prawdziwym efekcie zostaje na miejscu. Mniejsza jego część leży za progiem: w przykładzie moc spada z .34 do .14. Mniej fałszywych alarmów oznacza więcej przeoczonych efektów, chyba że zwiększysz liczebność.
Czy istotny wynik z małego badania dobrze szacuje wielkość efektu?
Zwykle go zawyża. Przy mocy .21 próg istotności przechodzą tylko te próby, w których efekt przypadkowo wyszedł duży. W naszej symulacji przy prawdziwym d = 0.3 i 30 osobach w grupie istotne badania dawały średnio d = 0.67. To ponad dwukrotne zawyżenie (błąd typu M), a 9 z 2128 istotnych wyników miało zły znak.
Dlaczego moc obliczona po badaniu nie mówi, jaka była prawdziwa moc?
Bo liczy się ją z efektu zaobserwowanego, który zmienia się od próby do próby. W 10 000 powtórzeń badania o prawdziwej mocy .50 „moc obserwowana” była rozrzucona prawie równomiernie od .05 do 1: w 19% badań wyszła poniżej .20, w 21% powyżej .80. Przy danym n zależy ona wyłącznie od wartości p, np. p = .05 daje około .50.
Jak zwiększyć moc, jeśli nie mogę zbadać więcej osób?
Zmniejsz szum zamiast powiększać próbę: rzetelniejszy pomiar, plan wewnątrzobiektowy albo zmienna towarzysząca znana przed badaniem zwiększają standaryzowany efekt widziany przez test. Test jednostronny pomaga tylko wtedy, gdy kierunek ustalono przed zebraniem danych. Jeśli to nie wystarczy, napisz uczciwie, jakie efekty badanie mogło wykryć (analiza wrażliwości).
Powiązane hasła
Przeczytaj też
Podział na medianie – wizualizacja
Schodek zamiast prostej, 1000 badań przed podziałem i po nim, krzywe mocy, pozorny efekt przy dwóch podziałach i mediana a próg – pięć rysunków z kodem R.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikMoc po fakcie – co podać zamiast
Dlaczego moc post hoc to inny zapis p, co zrobić z kolumną Observed Power w SPSS i co podać zamiast: przedział ufności, analizę wrażliwości i odpowiedź dla promotora – z R.
Czytaj →PoradnikWielokrotne testy w obrazkach
Pięć symulacji w R: 20 testów bez efektu, krzywa FWER, histogram wartości p, progi Holma i BH oraz ogród ścieżek – z kodem i podpisami.
Czytaj →PoradnikWielkość efektu w obrazkach: d = 0.2, 0.5 i 0.8
Nakładanie rozkładów, U3 i przewaga sprawdzone symulacją, d z małej i dużej próby, r na wykresie rozrzutu i OR jako słupki ryzyka – z kodem R.
Czytaj →Planujesz badanie i nie wiesz, ile osób potrzeba?
Pomożemy dobrać wielkość efektu, policzyć moc albo zrobić analizę wrażliwości i opisać uzasadnienie liczebności w pracy – tak, żebyś umiał(a) je wyjaśnić promotorowi i recenzentowi.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Ioannidis, J. P. A. (2008). Why most discovered true associations are inflated. Epidemiology, 19(5), 640–648. https://doi.org/10.1097/ede.0b013e31818131e7
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Yuan, K.-H., & Maxwell, S. (2005). On the post hoc power in testing mean differences. Journal of Educational and Behavioral Statistics, 30(2), 141–167. https://doi.org/10.3102/10769986030002141
Cytowania BibTeX
@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{ioannidis2008why, author={Ioannidis, John P. A.}, title={{Why most discovered true associations are inflated}}, journal={Epidemiology}, year={2008}, volume={19}, number={5}, pages={640--648}, doi={10.1097/ede.0b013e31818131e7}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{yuan2005post, author={Yuan, Ke-Hai and Maxwell, Scott}, title={{On the post hoc power in testing mean differences}}, journal={Journal of Educational and Behavioral Statistics}, year={2005}, volume={30}, number={2}, pages={141--167}, doi={10.3102/10769986030002141}}