Co to są błędy typu S i typu M?
Błędy typu S i typu M to dwie miary jakości wyniku istotnego, które zaproponowali Gelman i Carlin (2014) jako uzupełnienie klasycznego błędu I i II rodzaju. Pytają nie o to, czy efekt wykryto, lecz o to, czy wynik istotny dobrze go opisuje.
- Błąd typu S (ang. sign) – prawdopodobieństwo, że istotne oszacowanie ma przeciwny znak niż prawdziwy efekt.
- Błąd typu M (ang. magnitude), czyli współczynnik przesady – średnio ile razy istotne oszacowanie jest większe od prawdziwego efektu.
Obie wielkości zależą od prawdziwego efektu i błędu standardowego, a więc od mocy testu. Lu, Qiu i Deng (2019) wyprowadzili wzór zamknięty na oczekiwany błąd typu M i zbadali matematyczne własności obu miar, m.in. ich monotoniczność.
Przykład w R
Załóżmy, że trening poprawia wynik o d = 0.2, a badanie ma 20 osób w grupie. Błąd standardowy d wynosi wtedy około 0.32, a moc tylko 9.7%. Spośród wyników istotnych 4.9% ma zły znak, a ich średnia wartość bezwzględna jest 3.8 razy większa od prawdy – zamiast d = 0.2 raportuje się średnio d ≈ 0.76. Przy 200 osobach w grupie moc rośnie do 52%, błąd typu S praktycznie znika, a przesada spada do 1.39. Ten sam mechanizm przy małych próbach pokazuje wpis analiza na małej próbie.
Na rysunku
Oba błędy zależą tylko od jednej liczby: ilorazu prawdziwego efektu i błędu standardowego, a więc od mocy. Rysunek pokazuje je jako krzywe policzone ze wzorów, bez losowania.
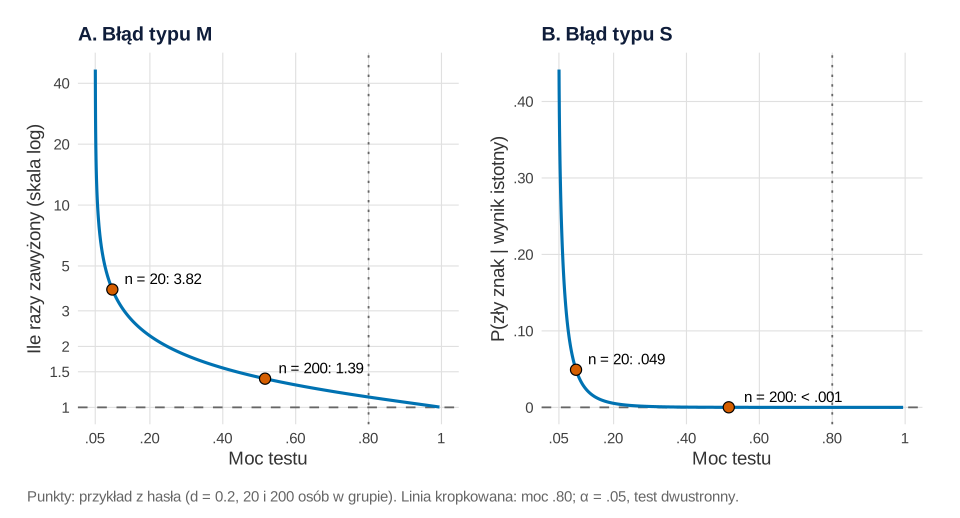
Co widać. Współczynnik przesady maleje razem z mocą: przy mocy .17 wynik istotny jest średnio 2.49 razy większy od prawdy, przy .32 – 1.74 razy, przy .52 – 1.39 razy, a przy .80 nadal 1.13 razy. Błąd znaku znika znacznie szybciej: przy mocy .08 wynosi .088, przy .17 już .009. Punkty to przykład z hasła; wzór daje dla 20 osób w grupie przesadę 3.82, a symulacja – 3.817.
Na co uważać. Na osi jest moc dla prawdziwego efektu, którego nie znamy. Moc policzona z własnego, istotnego wyniku jest już zawyżona tą samą przesadą, więc wstawienie jej do wykresu zaniża błędy S i M. Dlatego Gelman i Carlin (2014) liczą je dla efektu wziętego z innych źródeł. Krzywe zakładają też rozkład normalny oszacowania i brak innych źródeł selekcji, np. błędu publikacji, który działa niezależnie. Jak wygląda sama przesada na chmurze oszacowań, pokazuje wpis Moc testu w obrazkach.
Podpis do pracy (np. przy uzasadnieniu liczebności):
Kod nie losuje: liczy moc, błąd typu S i oczekiwany błąd typu M ze wzorów dla rozkładu normalnego oszacowania. Rysunek na stronie różni się od wyniku kodu tylko motywem (krój i kolor czcionki, siatka).
R – kod rysunku
# Rysunek 1. Współczynnik przesady (błąd typu M) i P(zły znak) (błąd typu S) w funkcji mocy
# Wzory analityczne dla oszacowania ~ N(D, s), test dwustronny, alfa = .05 (Gelman i Carlin, 2014)
library(ggplot2)
library(patchwork)
z <- qnorm(0.975)
sm <- function(lam) {                    # lam = D / s (prawdziwy efekt w jednostkach błędu standardowego)
  moc <- pnorm(lam - z) + pnorm(-lam - z)
  typ_S <- pnorm(-lam - z) / moc
  # E|oszacowanie| wśród istotnych, podzielone przez D (wartości w jednostkach s)
  gora <- lam * pnorm(lam - z) + dnorm(z - lam)          # E[X; X > z], X ~ N(lam, 1)
  dol  <- -lam * pnorm(-z - lam) + dnorm(-z - lam)       # E[-X; X < -z]
  data.frame(lam, moc, typ_S, typ_M = (gora + dol) / (moc * lam))
}
siatka <- sm(seq(0.05, 4.5, by = 0.01))
przyklad <- sm(0.2 / sqrt(2 / c(20, 200)))               # d = 0.2 przy 20 i 200 osobach w grupie
przyklad$n <- c(20, 200)
round(przyklad, 3)
round(sm(c(0.5, 1, 1.5, 2, 2.8)), 3)                      # kilka punktów z krzywych

pM <- data.frame(moc = przyklad$moc, wart = przyklad$typ_M, etyk = sprintf("n = %d: %.2f", przyklad$n, przyklad$typ_M))
pS <- data.frame(moc = przyklad$moc, wart = przyklad$typ_S,
                 etyk = sprintf("n = %d: %s", przyklad$n, ifelse(przyklad$typ_S < .001, "< .001",
                                                                 sub("^0", "", sprintf("%.3f", przyklad$typ_S)))))
osx <- scale_x_continuous(limits = c(0.05, 1), breaks = c(0.05, 0.2, 0.4, 0.6, 0.8, 1),
                          labels = c(".05", ".20", ".40", ".60", ".80", "1"))
motyw <- theme_minimal(base_size = 14) + theme(panel.grid.minor = element_blank())
pA <- ggplot(siatka, aes(moc, typ_M)) +
  geom_hline(yintercept = 1, linetype = "dashed", colour = "grey40") +     # brak przesady
  geom_vline(xintercept = 0.8, linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 1.1, colour = "#0072B2") +
  geom_point(data = pM, aes(y = wart), shape = 21, size = 3.5, fill = "#D55E00", colour = "black") +
  geom_text(data = pM, aes(y = wart, label = etyk), hjust = -0.15, vjust = -0.5, size = 4) +
  osx + scale_y_log10(breaks = c(1, 1.5, 2, 3, 5, 10, 20, 40), labels = c("1", "1.5", "2", "3", "5", "10", "20", "40")) +
  labs(x = "Moc testu", y = "Ile razy zawyżony (skala log)", title = "A. Błąd typu M") + motyw
pB <- ggplot(siatka, aes(moc, typ_S)) +
  geom_hline(yintercept = 0, linetype = "dashed", colour = "grey40") +
  geom_vline(xintercept = 0.8, linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 1.1, colour = "#0072B2") +
  geom_point(data = pS, aes(y = wart), shape = 21, size = 3.5, fill = "#D55E00", colour = "black") +
  geom_text(data = pS, aes(y = wart, label = etyk), hjust = -0.15, vjust = -0.5, size = 4) +
  osx + scale_y_continuous(breaks = seq(0, 0.4, 0.1), labels = c("0", ".10", ".20", ".30", ".40")) +
  labs(x = "Moc testu", y = "P(zły znak | wynik istotny)", title = "B. Błąd typu S") + motyw
p1 <- pA + pB + plot_annotation(caption = paste("Punkty: przykład z hasła (d = 0.2, 20 i 200 osób w grupie).",
                                                "Linia kropkowana: moc .80; α = .05, test dwustronny."))
p1   # zapis: ggsave("bledy-typu-s-i-m-a-moc.svg", p1, width = 10, height = 5.4)
Wynik w R
    lam   moc typ_S typ_M   n
1 0.632 0.097 0.049 3.824  20
2 2.000 0.516 0.000 1.386 200
  lam   moc typ_S typ_M
1 0.5 0.079 0.088 4.789
2 1.0 0.170 0.009 2.491
3 1.5 0.323 0.001 1.741
4 2.0 0.516 0.000 1.386
5 2.8 0.800 0.000 1.125
Dlaczego to ważne
Przy niskiej mocy próg istotności przechodzą tylko te badania, w których szum przypadkiem powiększył efekt. Jeśli takie wyniki trafiają do druku, a nieistotne nie (błąd publikacji), literatura zawiera zawyżone efekty. To jedna z przyczyn kryzysu replikacyjnego, a błąd typu M w praktyce opisuje też klątwa zwycięzcy.
Jak opisać w pracy
Gelman i Carlin (2014) zalecają obliczenia projektowe: przyjmij wiarygodny efekt z niezależnych źródeł, a nie z własnego wyniku, i policz dla niego moc oraz oba błędy.
Błędy typu S i M w R
Kod liczy moc, prawdopodobieństwo błędu typu S i współczynnik przesady (typ M) dla prawdziwego d = 0.2 przy 20 i 200 osobach w grupie – wzorem i symulacją 100 000 powtórzeń badania.
Obliczenia projektowe dla dwóch liczebności
R
# Błędy typu S i M: obliczenia projektowe (Gelman i Carlin, 2014)
D <- 0.2; n <- 20                       # prawdziwe d i liczebność grupy
s <- sqrt(2 / n)                        # przybliżony błąd standardowy d
z <- qnorm(0.975)
moc <- pnorm(D / s - z) + pnorm(-D / s - z)
typ_s <- pnorm(-D / s - z) / moc
set.seed(526)
d_obs <- rnorm(100000, D, s)            # oszacowania z wielu powtórzeń badania
ist <- abs(d_obs) > z * s               # wyniki istotne
round(c(SE = s, moc = moc, typ_S = typ_s,
        typ_M = mean(abs(d_obs[ist])) / D), 3)
n2 <- 200; s2 <- sqrt(2 / n2)           # ta sama analiza dla n = 200
d2 <- rnorm(100000, D, s2); ist2 <- abs(d2) > z * s2
round(c(moc = mean(ist2), typ_S = mean(d2[ist2] < 0) ,
        typ_M = mean(abs(d2[ist2])) / D), 3)
Wynik w R
   SE   moc typ_S typ_M
0.316 0.097 0.049 3.817
  moc typ_S typ_M
0.517 0.000 1.386
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów); Rysunek 1 narysowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym błąd typu S różni się od błędu I rodzaju?
Błąd I rodzaju to wynik istotny, gdy efektu nie ma. Błąd typu S zakłada, że efekt istnieje, i pyta, jak często wynik istotny wskazuje zły kierunek. Przy d = 0.2 i 20 osobach w grupie dotyczyło to 4.9% wyników istotnych.
Czy błąd typu M można policzyć z własnego wyniku?
Nie powinno się. Obliczenia wymagają wiarygodnego efektu z niezależnych źródeł, np. metaanalizy. Wstawienie własnego, prawdopodobnie zawyżonego oszacowania zaniża przesadę – podobnie jak w analizie mocy post hoc.
Jak zmniejszyć błędy typu S i M?
Zwiększ moc: większa próba, rzetelniejszy pomiar, mniej szumu. W przykładzie zwiększenie próby z 20 do 200 osób w grupie obniżyło przesadę z 3.8 do 1.39, a błąd typu S praktycznie zniknął.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Lu, J., Qiu, Y., & Deng, A. (2019). A note on Type S/M errors in hypothesis testing. British Journal of Mathematical and Statistical Psychology, 72(1), 1–17. https://doi.org/10.1111/bmsp.12132
Cytowania BibTeX
@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{lu2019note, author={Lu, Jiannan and Qiu, Yixuan and Deng, Alex}, title={{A note on Type S/M errors in hypothesis testing}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2019}, volume={72}, number={1}, pages={1--17}, doi={10.1111/bmsp.12132}}