Kiedy próba jest „mała”
Nie ma progu, poniżej którego próba staje się mała. Dwadzieścia osób może wystarczyć, żeby opisać jedną grupę albo wykazać bardzo duży efekt, ale zwykle nie wystarczy, żeby wykazać umiarkowaną różnicę między dwiema grupami. O tym, czy próba jest za mała, decyduje pytanie badawcze i wielkość efektu, której szukasz. Dlatego w tym wpisie „mała próba” oznacza 10–30 osób w grupie albo w całym badaniu. Taka liczba często zostaje po pilotażu, w badaniu jednej klasy, jednego oddziału szpitalnego albo w trudno dostępnej grupie.
Tu nie liczymy, ile osób potrzebujesz – to opisują wpisy ile osób do ankiety w pracy licencjackiej i dobór liczebności próby oraz kalkulator liczebności próby. Ten wpis jest dla sytuacji, w której dane już masz albo więcej osób po prostu nie ma. Lakens (2022) uznaje ograniczone zasoby za uprawnione uzasadnienie liczebności, pod warunkiem że pokażesz, co taka próba może, a czego nie może wykazać. Tym się tu zajmujemy.
Przykład: pilotaż treningu uważności na 20 osobach
Studentka sprawdza w pilotażu czterotygodniowy trening uważności. Dziesięć osób losowo trafia do treningu, dziesięć do grupy kontrolnej. Po czterech tygodniach mierzy stres na skali 0–40 i pyta, czy ktoś ma problemy ze snem (tak/nie). Dane są symulowane i można je pobrać w pliku CSV. Wszystkie liczby w tekście pochodzą z kodu na końcu strony.
W grupie kontrolnej średni stres wyniósł M = 22.80 (SD = 6.37), a po treningu M = 15.70 (SD = 7.33). Test t Welcha: różnica −7.10 punktu, 95% CI [−13.56, −0.64], t(17.66) = −2.31, p = .033, d Cohena = −1.03, 95% CI [−1.96, −0.08]. Wynik jest istotny, a efekt „duży”. Brzmi świetnie, ale przy 20 osobach trzeba go czytać ostrożniej niż przy 200.
Co realnie da się wykazać przy 10–30 osobach
Moc testu to szansa, że badanie wykaże efekt, który naprawdę istnieje. Tabela 1 pokazuje, jak wygląda ona przy małych grupach w porównaniu dwóch grup testem t. Ostatni wiersz to dla porównania liczebność, która daje moc .80 dla efektu umiarkowanego.
| n w grupie | Najmniejsze d wykrywalne z mocą .80 | Moc dla d = 0.5 | Moc dla d = 0.8 | 95% CI, gdy z próby wyjdzie d = 0.5 |
|---|---|---|---|---|
| 10 | 1.32 | .18 | .39 | [−0.40, 1.38] |
| 15 | 1.06 | .26 | .56 | [−0.23, 1.22] |
| 20 | 0.91 | .34 | .69 | [−0.13, 1.13] |
| 30 | 0.74 | .48 | .86 | [−0.02, 1.01] |
| 64 | 0.50 | .80 | .99 | [0.15, 0.85] |
Przy 10 osobach w grupie badanie ma 18% szans na wykrycie efektu umiarkowanego i 39% na wykrycie dużego. Z mocą .80 wykryje dopiero efekt d = 1.32, czyli różnicę większą niż jedno odchylenie standardowe. Nawet przy 30 osobach w grupie umiarkowany efekt wykryjesz rzadziej niż w co drugim badaniu. Ostatnia kolumna pokazuje drugą stronę tego samego problemu. Jeśli z próby wyjdzie d = 0.5, to przy 10 osobach w grupie przedział ufności sięga od małego efektu przeciwnego do bardzo dużego. Takie badanie niewiele mówi o wielkości efektu.
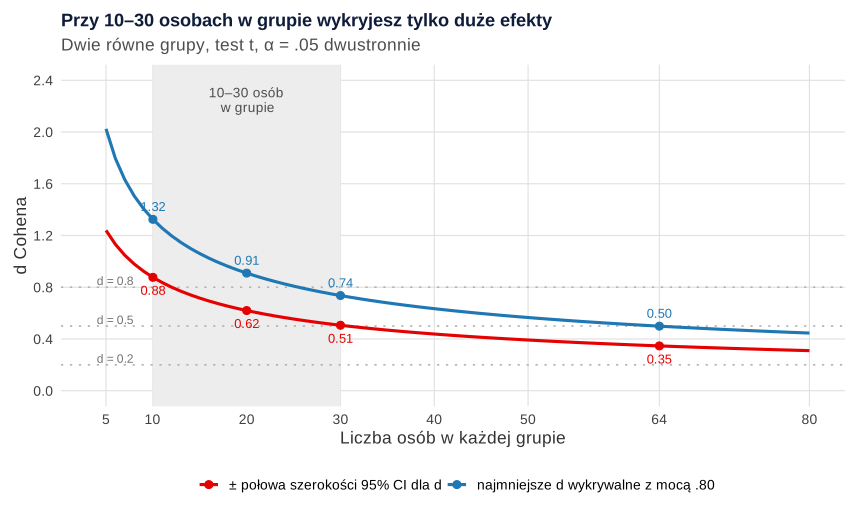
Z korelacją jest podobnie. Przy N = 20 test z mocą .80 wykryje dopiero r = .59, a przy N = 30 – r = .49. Wynik r = .30 przy 30 osobach ma 95% CI [−.07, .60]. Dla porównania korelację .30 z mocą .80 wykrywa się przy 85 osobach. Przedział dla własnych danych policzysz w kalkulatorze przedziału ufności.
Wynik istotny przy małej próbie też bywa mylący
Mała próba szkodzi nie tylko przez to, że łatwo przeoczyć efekt. Button i in. (2013) pokazali, że przy niskiej mocy maleje też szansa, że wynik istotny odzwierciedla prawdziwy efekt, a wielkości efektów bywają przeszacowane. Gelman i Carlin (2014) nazwali to błędem typu M (od magnitude): spośród hałaśliwych badań próg istotności przechodzą tylko te, w których efekt wyszedł przypadkiem duży.
Sprawdziliśmy to w symulacji. Przy prawdziwym d = 0.5 i 10 osobach w grupie istotnych było 18.4% z 20 000 badań. Średnie d wśród nich wyniosło 1.24, czyli 2.49 raza więcej niż prawda. Najmniejsze istotne d to 0.94. Mniejszy efekt przy tej liczebności po prostu nie może być istotny. Rysunek 2 pokazuje 25 takich badań. Istotne są dwa i oba przeszacowują efekt.
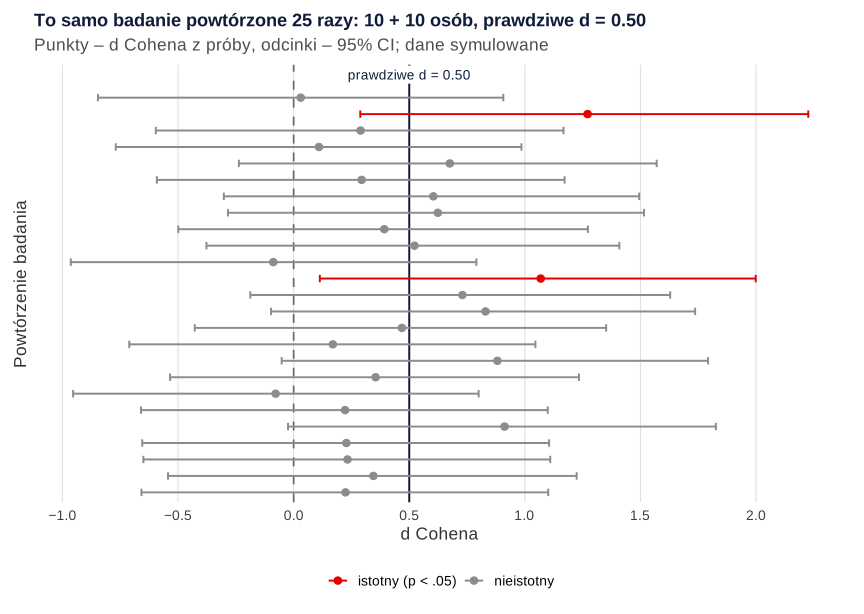
W naszym pilotażu jest tak samo. Do symulacji wpisaliśmy różnicę 4 punktów, a z próby wyszło 7.10. Przedział dla d od −1.96 do −0.08 mówi uczciwie, że efekt może być zarówno ogromny, jak i znikomy. Dlatego w pracy nie pisz, że trening „silnie obniża stres”. Napisz, że kierunek wyniku jest obiecujący, a wielkość efektu – nieznana.
Testy dokładne i bootstrap: co dają, a czego nie
Przy małej próbie promotor często radzi „test dokładny” albo „bootstrap”. Oba podejścia mają sens, ale żadne nie dodaje informacji, których w danych nie ma.
Test permutacyjny nie zakłada rozkładu normalnego. Rozkład statystyki przy hipotezie zerowej powstaje z przetasowania etykiet grup. Przy losowym przydziale wynik jest dokładny (Ernst, 2004). W pilotażu jest 184 756 sposobów podziału 20 osób na dwie grupy po 10. Komputer sprawdzi je wszystkie, a dokładne p wynosi .036, prawie tyle samo co w teście Welcha. Test dokładny chroni więc przed błędem I rodzaju, ale nie zwiększa mocy. Przy bardzo małych grupach ma też twardą granicę. Przy 3 + 3 osobach podziałów jest tylko 20, więc najmniejsze możliwe p dwustronne to .100. Takie badanie nie da wyniku istotnego, nawet gdy grupy w ogóle na siebie nie zachodzą. Przy 4 + 4 minimum to .029, a przy 5 + 5 – .008.
Test dokładny Fishera stosuje się, gdy w tabeli 2 × 2 są małe liczebności. Szczegóły i regułę Cochrana omawia wpis chi-kwadrat czy test Fishera. W pilotażu problemy ze snem zgłosiło 8 z 10 osób z grupy kontrolnej i 3 z 10 po treningu (80% wobec 30%). Test Fishera dał p = .070, warunkowy iloraz szans OR = 8.15, 95% CI [0.88, 127.06]. Przedział sięga od braku efektu do efektu ogromnego. Test Fishera jest przy tym zachowawczy, bo z powodu dyskretności rozkładu rzeczywisty poziom błędu jest niższy niż .05. Lydersen i in. (2009) zalecają zamiast niego testy bezwarunkowe albo poprawkę mid-p. Tu mid-p wynosi .038. Wariant testu wybierz jednak w planie analizy, zanim zobaczysz wynik. Przejście na mid-p dlatego, że daje p < .05, to szukanie istotności.
Bootstrap losuje próby ze zwracaniem z tych 20 osób. Nie tworzy nowych danych, więc nie zastąpi większej próby. Hesterberg (2015) pokazuje, że przy małych próbach popularny przedział percentylowy jest mniej dokładny niż zwykły przedział t. W pilotażu przedział percentylowy dla różnicy wynosi [−12.80, −1.50] i jest węższy od przedziału Welcha [−13.56, −0.64]. To nie jest zysk, tylko zaniżona niepewność. Sprawdziliśmy w symulacji przy 10 osobach w grupie, jak często 95% CI obejmuje prawdziwą różnicę. Przedział Welcha zrobił to w 95.5% powtórzeń przy rozkładzie normalnym i w 96.9% przy skośnym. Bootstrap percentylowy – tylko w 92.1% i 91.0%. Przedział BCa ([−13.00, −1.70]) poprawia przesunięcie i skośność, ale przy 10 osobach w grupie też opiera się na niewielu obserwacjach.
Wniosek praktyczny: przy 10–30 osobach w grupie test Welcha albo test permutacyjny są zwykle wystarczające. Rozkład skośny nie wymusza testu nieparametrycznego (zob. test t przy rozkładzie nienormalnym i testy nieparametryczne krok po kroku). Żadna z tych metod nie zamieni małej próby w dużą.
Wielkość efektu z przedziałem zamiast „brak istotności”
Najczęstszy błąd przy małej próbie to zdanie „nie stwierdzono różnic, więc trening nie działa”. Przy mocy .18 brak istotności jest wynikiem spodziewanym nawet wtedy, gdy efekt istnieje. Cumming (2014) zaleca, by zamiast samego testu raportować wielkość efektu z przedziałem ufności i interpretować cały przedział. Przy małej próbie przedział będzie szeroki i to jest uczciwa informacja: badanie nie rozstrzyga pytania.
Nie licz też „mocy obserwowanej” z efektu z próby. Hoenig i Heisey (2001) pokazali, że taka moc wynika wprost z wartości p i niczego nie dodaje (zob. analiza mocy post hoc). Zamiast niej podaj najmniejszy efekt, który próba mogła wykryć, np. „przy 10 osobach w grupie badanie miało moc .80 dopiero dla d = 1.32”. Jak opisać wynik nieistotny krok po kroku, pokazuje wpis jak opisać wynik nieistotny.
Kiedy zrezygnować z testów
Test statystyczny ma sens, gdy chcesz uogólnić wynik z próby na populację. Czasem lepszy jest inny plan:
- Badasz całą małą zbiorowość, np. wszystkich 15 pracowników działu. Nie ma populacji, na którą trzeba uogólniać, więc wystarczą statystyki opisowe: liczebności, odsetki, mediany i rozstępy.
- Pytasz „jak” i „dlaczego”, a nie „o ile”. Wtedy seria pogłębionych wywiadów może dać więcej niż ankieta z testami. Malterud i in. (2016) proponują pojęcie mocy informacyjnej. Im więcej istotnych dla celu informacji niesie każdy uczestnik, tym mniej osób potrzeba. Więcej we wpisie ile wywiadów przeprowadzić.
- Masz kilka osób, ale wiele pomiarów, np. terapia u trzech dzieci. Pasuje tu badanie jednego przypadku albo studium przypadku.
- Pilotaż ma sprawdzić wykonalność: rekrutację, zrozumiałość narzędzia i odsetek rezygnacji. Testowanie skuteczności nie jest jego celem (zob. badanie pilotażowe).
Połączenie małej części ilościowej z wywiadami opisuje wpis o badaniach mieszanych.
Jak opisać małą próbę w pracy
Ogólne zasady pisania o ograniczeniach są we wpisie ograniczenia badania – jak je opisać. Samo zdanie „próba była mała” nic nie mówi. Napisz, jakie efekty badanie mogło wykryć, jak szerokie są przedziały i jakie wnioski z tego wynikają. Wzór dla pilotażu z przykładu:
W rozdziale metodologicznym podaj, skąd wzięła się liczebność i jaki test wybrano przed analizą. Testy dokładne i bootstrap opisz z liczbą permutacji lub prób oraz z ziarnem losowania.
Czego nie robić przy małej próbie
- Nie zmieniaj testu po zobaczeniu wyniku, np. z Fishera na mid-p, z t na Manna–Whitneya albo odwrotnie.
- Nie dziel 20 osób na podgrupy według płci, wieku czy stażu. Przy pięciu osobach w podgrupie test ma znikomą moc, a p z wielu porównań będzie przypadkowe.
- Nie dokładaj wielu predyktorów do regresji. Model z ośmioma zmiennymi na 25 obserwacjach dopasuje się do szumu.
- Nie pisz „trend w kierunku istotności” przy p = .07. Podaj efekt z przedziałem.
- Nie licz mocy z wyniku. Podaj najmniejszy wykrywalny efekt.
Jeśli nie wiesz, który test pasuje do Twoich danych, zacznij od kreatora wyboru testu.
Wszystkie obliczenia w R
Przepis 1 liczy tabelę 1 i symulację błędu typu M, przepis 2 – wszystkie liczby z pilotażu, przepis 3 – symulację pokrycia przedziałów, a przepis 4 rysuje oba rysunki. Kod uruchamiasz z folderu z danymi; plik CSV zapisuje przepis 2.
1. Moc, najmniejsze wykrywalne d i szerokość CI (tabela 1) oraz błąd typu M
R
# B314 – co da się wykazać przy małej próbie: moc, najmniejsze wykrywalne d i szerokość 95% CI
# Dwie równe grupy, test t, alfa = .05 (dwustronnie); bazowe R
# 95% CI dla d z niecentralnego rozkładu t (odwrócenie testu, jak w pakietach do wielkości efektu)
ci_d <- function(d, n1, n2, poziom = 0.95) {
  df <- n1 + n2 - 2; skala <- sqrt(1 / n1 + 1 / n2); t_obs <- d / skala
  a <- (1 - poziom) / 2
  f <- function(ncp, p) suppressWarnings(pt(t_obs, df, ncp)) - p
  c(dol = uniroot(f, c(-40, 40), p = 1 - a)$root * skala,
    gor = uniroot(f, c(-40, 40), p = a)$root * skala)
}
n <- c(10, 15, 20, 30, 64)
tab <- t(sapply(n, function(k) {
  ci <- ci_d(0.5, k, k)
  c(n_w_grupie = k, N = 2 * k,
    min_d_moc80 = power.t.test(n = k, power = 0.80, sig.level = 0.05)$delta,
    moc_d05 = power.t.test(n = k, delta = 0.5, sig.level = 0.05)$power,
    moc_d08 = power.t.test(n = k, delta = 0.8, sig.level = 0.05)$power,
    ci_dol = ci[["dol"]], ci_gor = ci[["gor"]])
}))
print(round(tab, 2))

# Korelacja: najmniejsze r wykrywalne z mocą .80 (przybliżenie Fishera z) i 95% CI dla r = .30
min_r <- function(N, moc = 0.80) tanh((qnorm(0.975) + qnorm(moc)) / sqrt(N - 3))
ci_r <- function(r, N) tanh(atanh(r) + c(-1, 1) * qnorm(0.975) / sqrt(N - 3))
kor <- t(sapply(c(10, 20, 30, 85), function(N) c(N = N, min_r = min_r(N), ci_r(0.30, N))))
colnames(kor) <- c("N", "min_r_moc80", "ci_dol_r03", "ci_gor_r03")
print(round(kor, 2))

# Błąd typu M (Gelman i Carlin, 2014): prawdziwe d = 0.5, n = 10 w grupie
set.seed(3141)
R <- 20000
d_obs <- p_obs <- numeric(R)
for (i in seq_len(R)) {
  x <- rnorm(10, 0.5); y <- rnorm(10, 0)
  sp <- sqrt((var(x) + var(y)) / 2)
  d_obs[i] <- (mean(x) - mean(y)) / sp
  p_obs[i] <- t.test(x, y, var.equal = TRUE)$p.value
}
istotne <- p_obs < 0.05
cat(sprintf("Odsetek wyników istotnych (empiryczna moc): %.3f\n", mean(istotne)))
cat(sprintf("Średnie d wśród wyników istotnych: %.2f; współczynnik zawyżenia: %.2f\n",
            mean(abs(d_obs[istotne])), mean(abs(d_obs[istotne])) / 0.5))
cat(sprintf("Najmniejsze d wśród wyników istotnych: %.2f\n", min(abs(d_obs[istotne]))))
cat(sprintf("Istotne ze złym znakiem (błąd typu S): %.4f wszystkich istotnych\n",
            mean(d_obs[istotne] < 0)))
Wynik w R
     n_w_grupie   N min_d_moc80 moc_d05 moc_d08 ci_dol ci_gor
[1,]         10  20        1.32    0.18    0.39  -0.40   1.38
[2,]         15  30        1.06    0.26    0.56  -0.23   1.22
[3,]         20  40        0.91    0.34    0.69  -0.13   1.13
[4,]         30  60        0.74    0.48    0.86  -0.02   1.01
[5,]         64 128        0.50    0.80    0.99   0.15   0.85
      N min_r_moc80 ci_dol_r03 ci_gor_r03
[1,] 10        0.79      -0.41       0.78
[2,] 20        0.59      -0.16       0.66
[3,] 30        0.49      -0.07       0.60
[4,] 85        0.30       0.09       0.48
Odsetek wyników istotnych (empiryczna moc): 0.184
Średnie d wśród wyników istotnych: 1.24; współczynnik zawyżenia: 2.49
Najmniejsze d wśród wyników istotnych: 0.94
Istotne ze złym znakiem (błąd typu S): 0.0076 wszystkich istotnych
2. Pilotaż 10 + 10: test Welcha, d z CI, test permutacyjny, Fisher z mid-p i bootstrap
R
# B314 – przykład: pilotaż treningu uważności, 10 + 10 osób (dane symulowane)
# Test t Welcha, d z 95% CI, dokładny test permutacyjny, test Fishera z mid-p, bootstrap
suppressPackageStartupMessages({ library(effectsize); library(boot) })
set.seed(3142)
n <- 10
grupa <- factor(rep(c("Kontrolna", "Trening"), each = n), levels = c("Kontrolna", "Trening"))
stres <- round(pmin(40, pmax(0, rnorm(2 * n, 21 - 4 * (grupa == "Trening"), 6))))
set.seed(3148)
sen <- c(rbinom(n, 1, 0.65), rbinom(n, 1, 0.30))          # 1 = problemy ze snem po 4 tygodniach
dane <- data.frame(id = seq_len(2 * n), grupa, stres, problemy_ze_snem = sen)
write.csv(dane, "../mala-proba-dane-przyklad.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Statystyki opisowe
print(aggregate(stres ~ grupa, dane, function(y) round(c(M = mean(y), SD = sd(y), Mdn = median(y)), 2)))

# Test t Welcha (Trening − Kontrolna) i d Cohena z 95% CI
x <- dane$stres[dane$grupa == "Trening"]; y <- dane$stres[dane$grupa == "Kontrolna"]
tw <- t.test(x, y)
round(c(roznica = unname(tw$estimate[1] - tw$estimate[2]), CI_dol = tw$conf.int[1], CI_gor = tw$conf.int[2],
        t = unname(tw$statistic), df = unname(tw$parameter), p = tw$p.value), 3)
d <- cohens_d(x, y, ci = 0.95)
round(c(d = d$Cohens_d, d_dol = d$CI_low, d_gor = d$CI_high), 2)

# Dokładny test permutacyjny: wszystkie podziały 20 osób na dwie grupy po 10
podzialy <- combn(2 * n, n)
cat("Liczba wszystkich podziałów:", ncol(podzialy), "\n")
suma <- sum(dane$stres)
s_tren <- colSums(matrix(dane$stres[podzialy], nrow = n))
roznice <- s_tren / n - (suma - s_tren) / n
obs <- mean(x) - mean(y)
p_perm <- mean(abs(roznice) >= abs(obs) - 1e-9)
cat(sprintf("Różnica średnich: %.2f; dokładne p permutacyjne (dwustronne): %.4f\n", obs, p_perm))

# Najmniejsze możliwe p w teście permutacyjnym przy bardzo małych grupach (dwustronnie)
for (k in 3:5) cat(sprintf("%d + %d osób: podziałów %d, najmniejsze p = %s\n",
                           k, k, choose(2 * k, k), sub("^0", "", sprintf("%.3f", 2 / choose(2 * k, k)))))

# Problemy ze snem: tabela 2 × 2, test Fishera i mid-p
tab <- table(dane$grupa, factor(dane$problemy_ze_snem, levels = c(1, 0), labels = c("tak", "nie")))
print(tab)
fi <- fisher.test(tab)
round(c(OR = unname(fi$estimate), CI_dol = fi$conf.int[1], CI_gor = fi$conf.int[2], p = fi$p.value), 3)
# mid-p: prawdopodobieństwa tabel bardziej skrajnych + połowa prawdopodobieństwa tabeli obserwowanej
a <- tab["Kontrolna", "tak"]; m1 <- sum(tab[, "tak"]); nk <- sum(tab["Kontrolna", ])
pr <- dhyper(0:min(m1, nk), nk, 2 * n - nk, m1); p_a <- dhyper(a, nk, 2 * n - nk, m1)
p_mid <- sum(pr[pr < p_a - 1e-12]) + 0.5 * sum(pr[abs(pr - p_a) <= 1e-12])
p3 <- function(p) sub("^0", "", sprintf("%.3f", p))           # p w stylu APA, bez zera wiodącego
cat(sprintf("Odsetek z problemami: kontrolna %.0f%%, trening %.0f%%; Fisher p = %s, mid-p = %s\n",
            100 * tab["Kontrolna", "tak"] / n, 100 * tab["Trening", "tak"] / n, p3(fi$p.value), p3(p_mid)))
# Najmniejsze p Fishera przy skrajnym wyniku 3/3 vs 0/3
cat(sprintf("Fisher, 3 z 3 vs 0 z 3: p = %s\n", p3(fisher.test(matrix(c(3, 0, 0, 3), 2))$p.value)))

# Bootstrap różnicy średnich (losowanie w obrębie grup), 9999 prób
set.seed(3143)
b <- boot(dane, function(d, i) { dd <- d[i, ]; mean(dd$stres[dd$grupa == "Trening"]) - mean(dd$stres[dd$grupa == "Kontrolna"]) },
          R = 9999, strata = dane$grupa)
ci_b <- boot.ci(b, type = c("perc", "bca"))
round(c(perc_dol = ci_b$percent[4], perc_gor = ci_b$percent[5], bca_dol = ci_b$bca[4], bca_gor = ci_b$bca[5],
        welch_dol = tw$conf.int[1], welch_gor = tw$conf.int[2]), 2)
Wynik w R
      grupa stres.M stres.SD stres.Mdn
1 Kontrolna   22.80     6.37     22.50
2   Trening   15.70     7.33     16.50
roznica  CI_dol  CI_gor       t      df       p
 -7.100 -13.564  -0.636  -2.311  17.657   0.033
    d d_dol d_gor
-1.03 -1.96 -0.08
Liczba wszystkich podziałów: 184756
Różnica średnich: -7.10; dokładne p permutacyjne (dwustronne): 0.0358
3 + 3 osób: podziałów 20, najmniejsze p = .100
4 + 4 osób: podziałów 70, najmniejsze p = .029
5 + 5 osób: podziałów 252, najmniejsze p = .008

            tak nie
  Kontrolna   8   2
  Trening     3   7
     OR  CI_dol  CI_gor       p
  8.153   0.882 127.056   0.070
Odsetek z problemami: kontrolna 80%, trening 30%; Fisher p = .070, mid-p = .038
Fisher, 3 z 3 vs 0 z 3: p = .100
 perc_dol  perc_gor   bca_dol   bca_gor welch_dol welch_gor
   -12.80     -1.50    -13.00     -1.70    -13.56     -0.64
3. Symulacja: jak często 95% CI obejmuje prawdziwą różnicę przy n = 10
R
# B314 – jak często 95% CI obejmuje prawdziwą różnicę średnich przy n = 10 w grupie?
# Porównanie: przedział t Welcha a bootstrap percentylowy (999 prób w obrębie grup), 2000 powtórzeń
set.seed(3149)
pokrycie <- function(los, prawda, n = 10, R = 2000, B = 999) {
  traf <- matrix(FALSE, R, 2, dimnames = list(NULL, c("Welch", "Bootstrap_perc")))
  for (r in seq_len(R)) {
    x <- los(n) + prawda; y <- los(n)
    ci_t <- t.test(x, y)$conf.int
    bx <- matrix(sample(x, n * B, replace = TRUE), B); by <- matrix(sample(y, n * B, replace = TRUE), B)
    ci_b <- quantile(rowMeans(bx) - rowMeans(by), c(0.025, 0.975))
    traf[r, ] <- c(ci_t[1] <= prawda && prawda <= ci_t[2], ci_b[1] <= prawda && prawda <= ci_b[2])
  }
  colMeans(traf)
}
lognorm <- function(n) rlnorm(n, 0, 0.8) - exp(0.8^2 / 2)    # skośny rozkład o średniej 0
wyn <- rbind(normalny = pokrycie(rnorm, 0.5), skosny = pokrycie(lognorm, 0.5))
print(round(wyn, 3))
Wynik w R
         Welch Bootstrap_perc
normalny 0.955          0.921
skosny   0.969          0.910
4. Rysunki 1 i 2
R
# B314 – rysunki do wpisu /blog/analiza-na-malej-probie/
# Uruchomienie z folderu kod/: PNG_DIR=<folder na podgląd> LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b314-rysunki.R > b314-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 14) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  png_dir <- Sys.getenv("PNG_DIR")
  if (nzchar(png_dir)) ggsave(file.path(png_dir, sub("\\.svg$", ".png", basename(plik))), wykres,
                              width = szer, height = wys, dpi = 100, bg = "white")
  cat(sprintf("Zapisano %s: width=\"%d\" height=\"%d\"\n", plik, round(szer * 100), round(wys * 100)))
}
ci_d <- function(d, n1, n2, poziom = 0.95) {          # 95% CI dla d z niecentralnego rozkładu t
  df <- n1 + n2 - 2; skala <- sqrt(1 / n1 + 1 / n2); t_obs <- d / skala; a <- (1 - poziom) / 2
  f <- function(ncp, p) suppressWarnings(pt(t_obs, df, ncp)) - p
  c(uniroot(f, c(-40, 40), p = 1 - a)$root, uniroot(f, c(-40, 40), p = a)$root) * skala
}
f2 <- function(x, k = 2) sub("^-", "−", formatC(x, format = "f", digits = k))

# ---------- Rysunek 1: 25 powtórzeń tego samego badania, n = 10 w grupie, prawdziwe d = 0.5
set.seed(3150)
badania <- do.call(rbind, lapply(1:25, function(i) {
  x <- rnorm(10, 0.5); y <- rnorm(10)
  d <- (mean(x) - mean(y)) / sqrt((var(x) + var(y)) / 2); ci <- ci_d(d, 10, 10)
  data.frame(nr = i, d = d, dol = ci[1], gor = ci[2])
}))
badania$wynik <- ifelse(badania$dol > 0, "istotny (p < .05)", "nieistotny")
cat(sprintf("Istotnych: %d z 25; d od %s do %s; średnie d istotnych: %s\n", sum(badania$dol > 0),
            f2(min(badania$d)), f2(max(badania$d)), f2(mean(badania$d[badania$dol > 0]))))
cat(sprintf("Średnia szerokość 95%% CI dla d: %s\n", f2(mean(badania$gor - badania$dol))))
r1 <- ggplot(badania, aes(d, factor(nr, levels = 25:1), colour = wynik)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = 2) +
  geom_vline(xintercept = 0.5, colour = KOLORY[["granat"]], linewidth = 0.7) +
  geom_errorbar(aes(xmin = dol, xmax = gor), width = 0.45, orientation = "y", linewidth = 0.7) +
  geom_point(size = 2.2) +
  annotate("label", x = 0.5, y = 26.4, label = "prawdziwe d = 0.50", size = 3.6, colour = KOLORY[["granat"]],
           fill = "white", linewidth = 0) +
  scale_colour_manual(values = c("istotny (p < .05)" = KOLORY[["akcent"]], "nieistotny" = "grey55"), name = NULL) +
  scale_x_continuous(breaks = seq(-1.5, 2.5, 0.5), labels = f2(seq(-1.5, 2.5, 0.5), 1)) +
  scale_y_discrete(expand = expansion(add = c(0.6, 2))) +
  labs(title = "To samo badanie powtórzone 25 razy: 10 + 10 osób, prawdziwe d = 0.50",
       subtitle = "Punkty – d Cohena z próby, odcinki – 95% CI; dane symulowane",
       x = "d Cohena", y = "Powtórzenie badania") +
  theme_metodolog(13) + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
zapisz_svg(r1, "../mala-proba-25-powtorzen-badania.svg", szer = 9, wys = 6.4)

# ---------- Rysunek 2: najmniejsze wykrywalne d i połowa szerokości 95% CI w zależności od n
siatka <- data.frame(n = 5:80)
siatka$min_d <- sapply(siatka$n, function(k) power.t.test(n = k, power = 0.8)$delta)
siatka$polowa_ci <- sapply(siatka$n, function(k) diff(ci_d(0, k, k)) / 2)
dl <- rbind(data.frame(n = siatka$n, y = siatka$min_d, miara = "najmniejsze d wykrywalne z mocą .80"),
            data.frame(n = siatka$n, y = siatka$polowa_ci, miara = "± połowa szerokości 95% CI dla d"))
pkt <- subset(dl, n %in% c(10, 20, 30, 64))
print(transform(pkt, y = round(y, 2)), row.names = FALSE)
r2 <- ggplot(dl, aes(n, y, colour = miara)) +
  annotate("rect", xmin = 10, xmax = 30, ymin = -Inf, ymax = Inf, fill = "grey93") +
  annotate("text", x = 20, y = 2.25, label = "10–30 osób\nw grupie", size = 3.6, colour = "grey30", lineheight = 0.9) +
  geom_hline(yintercept = c(0.2, 0.5, 0.8), colour = "grey70", linetype = 3) +
  geom_line(linewidth = 1.1) +
  geom_point(data = pkt, size = 2.4) +
  geom_text(data = pkt, aes(label = f2(y), vjust = ifelse(grepl("^najmn", miara), -0.9, 1.9)), size = 3.4, show.legend = FALSE) +
  annotate("text", x = 4, y = c(0.2, 0.5, 0.8) + 0.05, label = c("d = 0.2", "d = 0.5", "d = 0.8"),
           hjust = 0, size = 3.2, colour = "grey45") +
  scale_colour_manual(values = c(KOLORY[["akcent"]], KOLORY[["drugi"]]), name = NULL) +
  scale_x_continuous(breaks = c(5, 10, 20, 30, 40, 50, 64, 80)) +
  scale_y_continuous(limits = c(0, 2.4), breaks = seq(0, 2.4, 0.4), labels = f2(seq(0, 2.4, 0.4), 1)) +
  labs(title = "Przy 10–30 osobach w grupie wykryjesz tylko duże efekty",
       subtitle = "Dwie równe grupy, test t, α = .05 dwustronnie", x = "Liczba osób w każdej grupie", y = "d Cohena") +
  theme_metodolog(13)
zapisz_svg(r2, "../mala-proba-wykrywalny-efekt.svg", szer = 9, wys = 5.4)
Wynik w R
Istotnych: 2 z 25; d od −0.09 do 1.27; średnie d istotnych: 1.17
Średnia szerokość 95% CI dla d: 1.79
Zapisano ../mala-proba-25-powtorzen-badania.svg: width="900" height="640"
  n    y                               miara
 10 1.32 najmniejsze d wykrywalne z mocą .80
 20 0.91 najmniejsze d wykrywalne z mocą .80
 30 0.74 najmniejsze d wykrywalne z mocą .80
 64 0.50 najmniejsze d wykrywalne z mocą .80
 10 0.88    ± połowa szerokości 95% CI dla d
 20 0.62    ± połowa szerokości 95% CI dla d
 30 0.51    ± połowa szerokości 95% CI dla d
 64 0.35    ± połowa szerokości 95% CI dla d
Zapisano ../mala-proba-wykrywalny-efekt.svg: width="900" height="540"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki powstały w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Od ilu osób można liczyć testy statystyczne w pracy dyplomowej?
Nie ma minimalnej liczby, od której test „wolno” liczyć. Test da się policzyć przy kilku osobach, ale jego moc zależy od liczebności i wielkości efektu. Przy 10 osobach w grupie test t wykrywa z mocą .80 dopiero efekt d = 1.32, przy 30 – d = 0.74. Przed analizą sprawdź, jaki najmniejszy efekt Twoja próba może wykryć, i napisz to w pracy.
Czy przy małej próbie trzeba użyć testu nieparametrycznego?
Nie automatycznie. Mała próba nie jest sama w sobie powodem do zmiany testu. Test Welcha albo test permutacyjny dobrze kontrolują błąd I rodzaju także przy 10 osobach w grupie. Test nieparametryczny odpowiada na nieco inne pytanie i nie ma większej mocy. Wybierz test w planie analizy według pytania badawczego, a nie po obejrzeniu wyników.
Czy bootstrap naprawia zbyt małą próbę?
Nie. Bootstrap losuje ze zwracaniem z tych samych osób, więc nie tworzy nowej informacji. Przy małych próbach przedział percentylowy bywa za wąski: w naszej symulacji przy 10 osobach w grupie obejmował prawdziwą różnicę w 91–92% przypadków zamiast w 95%, a przedział t Welcha – w 95.5–96.9%.
Wynik wyszedł istotny na 20 osobach – czy to znaczy, że efekt jest duży?
Niekoniecznie. Przy małej próbie istotne wychodzą głównie te wyniki, w których efekt przypadkiem jest duży. W symulacji z prawdziwym d = 0.5 i 10 osobami w grupie istotne wyniki miały średnio d = 1.24, czyli 2.49 raza więcej niż prawda. Podaj przedział ufności dla d i opisz wielkość efektu jako niepewną.
Jak napisać w pracy, że próba była mała?
Zamiast samego zdania „próba była mała” podaj trzy rzeczy: skąd wzięła się liczebność, jaki najmniejszy efekt badanie mogło wykryć z mocą .80 i jak szerokie są przedziały ufności dla głównych wyników. Na tej podstawie napisz, które wnioski są wstępne, i zaproponuj, jak duża powinna być próba w kolejnym badaniu.
Powiązane hasła
Przeczytaj też
Ile osób do ankiety w pracy licencjackiej?
Liczebność w trzech krokach, zapas na odrzucone ankiety, pułapka nierównych grup i analiza wrażliwości, gdy ankiet jest za mało.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikJak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →PoradnikOgraniczenia badania – jak je opisać
Jak znaleźć ograniczenia, ocenić kierunek i wielkość błędu, wybrać najważniejsze i opisać je konkretnie. Przykład ankiety online z liczbami z R.
Czytaj →Masz mało danych i nie wiesz, co z nimi zrobić?
Sprawdzimy, jakie efekty może wykazać Twoja próba, dobierzemy analizę do liczebności i pomożemy uczciwie opisać wyniki i ograniczenia tak, żebyś umiał(a) je samodzielnie obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Ernst, M. D. (2004). Permutation methods: A basis for exact inference. Statistical Science, 19(4), 676–685. https://doi.org/10.1214/088342304000000396 ● Otwarty dostęp
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Hesterberg, T. C. (2015). What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum. The American Statistician, 69(4), 371–386. https://doi.org/10.1080/00031305.2015.1089789 ● Otwarty dostęp
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lydersen, S., Fagerland, M. W., & Laake, P. (2009). Recommended tests for association in 2 × 2 tables. Statistics in Medicine, 28(7), 1159–1175. https://doi.org/10.1002/sim.3531
- Malterud, K., Siersma, V. D., & Guassora, A. D. (2016). Sample size in qualitative interview studies: Guided by information power. Qualitative Health Research, 26(13), 1753–1760. https://doi.org/10.1177/1049732315617444
Cytowania BibTeX
@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{ernst2004permutation, author={Ernst, Michael D.}, title={{Permutation methods: A basis for exact inference}}, journal={Statistical Science}, year={2004}, volume={19}, number={4}, pages={676--685}, doi={10.1214/088342304000000396}}@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{hesterberg2015what, author={Hesterberg, Tim C.}, title={{What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum}}, journal={The American Statistician}, year={2015}, volume={69}, number={4}, pages={371--386}, doi={10.1080/00031305.2015.1089789}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lydersen2009recommended, author={Lydersen, Stian and Fagerland, Morten W. and Laake, Petter}, title={{Recommended tests for association in 2 × 2 tables}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={7}, pages={1159--1175}, doi={10.1002/sim.3531}}@article{malterud2016sample, author={Malterud, Kirsti and Siersma, Volkert Dirk and Guassora, Ann Dorrit}, title={{Sample size in qualitative interview studies: Guided by information power}}, journal={Qualitative Health Research}, year={2016}, volume={26}, number={13}, pages={1753--1760}, doi={10.1177/1049732315617444}}