Od czego zależy liczba osób w ankiecie
Nie istnieje jedna liczba, która pasuje do każdej pracy licencjackiej. Liczba ankiet zależy od tego, co chcesz z nimi zrobić. Inaczej liczysz próbę do korelacji dwóch skal, inaczej do porównania dwóch grup, a jeszcze inaczej do oszacowania odsetka. Jeśli promotor albo regulamin podają minimum, potraktuj je jako dolną granicę. Mimo to sprawdź, czy ta liczba wystarcza do Twojej głównej analizy.
Gotowe wartości dla typowych analiz zebraliśmy w haśle liczebność próby w ankiecie. Pełne omówienie analizy mocy, precyzji i uzasadnień liczebności znajdziesz w poradniku dobór liczebności próby. Tutaj dostajesz krótką procedurę dla pracy licencjackiej i plan awaryjny na sytuację, w której ankiet jest mniej, niż chciałeś.
Policz liczbę osób w trzech krokach
- Wybierz jedną, najważniejszą analizę. Zwykle to test głównej hipotezy, np. korelacja stresu z jakością snu albo porównanie dwóch grup. Liczebność ustalasz dla tej analizy, a nie dla całej ankiety.
- Przyjmij wielkość efektu i policz n. Najlepiej weź efekt z badań na podobnej próbie albo ustal najmniejszy interesujący efekt. Konwencje „mały, średni, duży” Cohena (1992) traktuj jako ostateczność. Potem wykonaj analizę mocy a priori, np. w kalkulatorze liczebności próby. Dla korelacji r = .30 przy α = .05 i mocy .80 wychodzi 85 osób.
- Dolicz zapas na odrzucone ankiety. Część formularzy będzie niepełna, część trzeba będzie usunąć przy czyszczeniu danych z ankiety online. Wynik z kroku 2 podziel przez odsetek ankiet, które zostaną. Jeśli spodziewasz się, że odpadnie 20%, zamiast 85 zbierz 107 ankiet.
Brysbaert (2019) proponuje d = 0.4 jako rozsądne pierwsze oszacowanie najmniejszego interesującego efektu w psychologii. Przy takim efekcie do porównania dwóch pomiarów u tych samych osób wystarcza nieco ponad 50 uczestników, ale gdy porównujesz różne grupy osób albo sprawdzasz interakcję, potrzeba już 100, 200 i więcej. Dlatego licencjat z porównaniem grup zwykle wymaga więcej ankiet niż licencjat z jedną korelacją.
Uważaj na podgrupy i nierówne grupy
Najczęstsza pułapka w pracy licencjackiej wygląda tak: ankietę wypełnia 100 osób, ale hipoteza dotyczy różnicy między kobietami a mężczyznami, a mężczyzn jest 15. O mocy porównania decyduje wtedy mniejsza grupa, a nie łączna liczba ankiet. Policzyliśmy w R, jaki najmniejszy efekt wykryje test t z mocą .80 przy 100 osobach:
| Podział 100 osób | Najmniejsze wykrywalne d |
|---|---|
| 50 i 50 | 0.57 |
| 75 i 25 | 0.65 |
| 85 i 15 | 0.79 |
Przy podziale 85 i 15 wykryjesz tylko efekt duży. Jeśli hipoteza dotyczy grup, zaplanuj rekrutację tak, żeby każda grupa była wystarczająco liczna. Pomagają w tym kanały rekrutacji opisane we wpisie gdzie znaleźć respondentów do ankiety.
Masz mniej ankiet, niż planowałeś? Zrób analizę wrażliwości
W pracy licencjackiej liczbę osób często wyznacza czas i dostęp do respondentów. Lakens (2022) traktuje ograniczenia zasobów jako jeden z uprawnionych sposobów uzasadnienia liczebności. Musisz jednak pokazać, jakie efekty taka próba może wykryć. Służy do tego analiza wrażliwości: zamiast pytać „ile osób potrzebuję?”, pytasz „jaki najmniejszy efekt wykryję przy osobach, które mam?”.
| N w analizie | Najmniejsze r | Najmniejsze d (dwie równe grupy) | Margines błędu odsetka |
|---|---|---|---|
| 60 | .35 | 0.74 | ±12.65 pp |
| 80 | .31 | 0.63 | ±10.96 pp |
| 100 | .28 | 0.57 | ±9.80 pp |
| 120 | .25 | 0.52 | ±8.95 pp |
| 150 | .23 | 0.46 | ±8.00 pp |
| 200 | .20 | 0.40 | ±6.93 pp |
Wszystkie wartości dotyczą α = .05 (dwustronnie) i mocy .80. Margines błędu policzono dla odsetka 50% i 95% poziomu ufności, więcej w haśle przedział ufności dla proporcji. Przy 100 osobach wykryjesz więc korelację od około .28 wzwyż. Słabszy związek może istnieć, ale badanie najpewniej go nie wykaże. Jak oceniać takie wartości, wyjaśniamy we wpisie czy korelacja .30 to dużo.
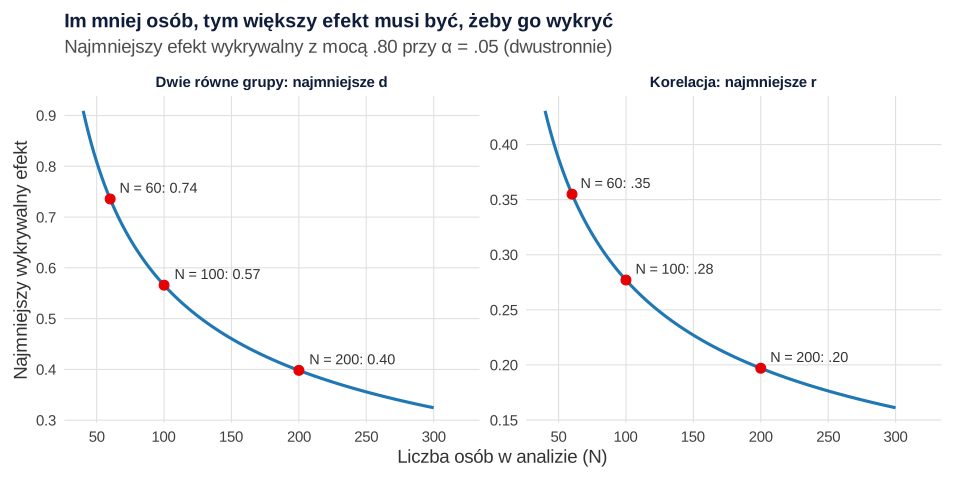
Nie licz natomiast mocy post hoc z uzyskanego wyniku. Hoenig i Heisey (2001) pokazują, że taka moc nie mówi nic nowego o wyniku nieistotnym. Analiza wrażliwości opiera się na efekcie ustalonym z góry, a nie na wyniku z Twoich danych.
Więcej ankiet nie naprawi doboru próby
Liczebność zmniejsza błąd losowy, ale nie usuwa obciążenia wynikającego z tego, kto wypełnił ankietę. Mercer i in. (2017) opisują, że przy braku losowego doboru wyniki mogą być obciążone przez samoselekcję uczestników. Jeśli zbierasz odpowiedzi na grupach studenckich w mediach społecznościowych, 300 ankiet nadal opisuje głównie te grupy. Napisz to wprost w ograniczeniach i nie uogólniaj wyników na wszystkich studentów. Więcej o tym w haśle reprezentatywność próby i w przewodniku ankiety i eksperymenty.
Jak to opisać w pracy
Gdy liczbę osób ustaliłeś przed badaniem:
Gdy liczbę osób wyznaczył czas zbierania danych:
Analiza wrażliwości w R
Kod liczy najmniejszy wykrywalny efekt dla kilku liczebności, porównanie grup nierównych i zapas na odrzucone ankiety. Wystarczą funkcje pakietu stats.
Najmniejszy wykrywalny efekt i zapas na odrzucone ankiety
R
za <- qnorm(.975); zb <- qnorm(.80)
min_r <- function(N) tanh((za + zb) / sqrt(N - 3))                     # korelacja (transformacja Fishera)
min_d <- function(n1, n2) uniroot(function(d) {                        # dwie grupy, test t
  df <- n1 + n2 - 2; ncp <- d * sqrt(n1 * n2 / (n1 + n2)); tk <- qt(.975, df)
  pt(tk, df, ncp, lower.tail = FALSE) + pt(-tk, df, ncp) - .80 }, c(.01, 3))$root
moe <- function(N) 100 * qnorm(.975) * sqrt(.25 / N)                    # margines błędu odsetka (p = 50%), w pp

N <- c(60, 80, 100, 120, 150, 200)
tab <- data.frame(N, r_min = min_r(N), d_min_rowne = sapply(N, function(x) min_d(x / 2, x / 2)),
                  margines_pp = moe(N))
print(round(tab, 2), row.names = FALSE)

# Te same 100 osób, ale grupy nierówne
round(c(grupy_50_50 = min_d(50, 50), grupy_75_25 = min_d(75, 25), grupy_85_15 = min_d(85, 15)), 2)

# Zapas na odrzucone ankiety: potrzebne n / (1 - odsetek odrzuconych)
n_r30 <- ceiling(((za + zb) / atanh(.30))^2 + 3)                       # korelacja r = .30
c(potrzebne = n_r30, zebrac_przy_20_proc = ceiling(n_r30 / (1 - .20)))
Wynik w R
   N r_min d_min_rowne margines_pp
  60  0.35        0.74       12.65
  80  0.31        0.63       10.96
 100  0.28        0.57        9.80
 120  0.25        0.52        8.95
 150  0.23        0.46        8.00
 200  0.20        0.40        6.93
grupy_50_50 grupy_75_25 grupy_85_15
       0.57        0.65        0.79
          potrzebne zebrac_przy_20_proc
                 85                 107
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
Najczęstsze pytania
Czy 100 osób wystarczy do ankiety w pracy licencjackiej?
Do korelacji umiarkowanej siły zwykle tak: przy 100 osobach wykryjesz z mocą .80 korelację od około r = .28. Do porównania dwóch grup po 50 osób wykryjesz dopiero d około 0.57, a przy grupach 85 i 15 – około 0.79. Liczy się więc to, co porównujesz, a nie sama liczba ankiet.
Co zrobić, gdy nie udało się zebrać zaplanowanej liczby ankiet?
Wykonaj analizę wrażliwości: policz, jaki najmniejszy efekt wykryje badanie przy liczbie osób, którą masz. Podaj ją w rozdziale metod i uwzględnij przy interpretacji wyników nieistotnych. Nie licz mocy post hoc z uzyskanego wyniku.
Czy niedokończone ankiety wliczają się do liczebności próby?
Do liczebności analizy wliczasz tylko osoby, których odpowiedzi trafiają do danej analizy. Ankiety przerwane przed kluczowymi pytaniami nie zwiększają mocy, dlatego przy planowaniu dolicz zapas na takie formularze. W pracy podaj, ile ankiet rozpoczęto, ile odrzucono i dlaczego.
Czy liczba osób w ankiecie musi być taka sama w obu grupach?
Nie musi, ale nierówne grupy obniżają moc porównania. O tym, jaki efekt wykryjesz, decyduje głównie mniejsza grupa. Jeśli hipoteza dotyczy różnic między grupami, zaplanuj rekrutację tak, żeby każda z nich była wystarczająco liczna.
Powiązane hasła
Przeczytaj też
Dobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikKalkulator liczebności próby
Ile osób do testu t, korelacji albo ankiety z marginesem błędu? Kalkulator zgodny z R, wzory, przykład i gotowy opis analizy mocy.
Czytaj →PoradnikGdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →Nie wiesz, czy Twoja próba wystarczy?
Policzymy liczebność dla Twojej hipotezy albo analizę wrażliwości dla ankiet, które już masz, i wyjaśnimy wynik tak, żebyś umiał(a) go opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Mercer, A. W., Kreuter, F., Keeter, S., & Stuart, E. A. (2017). Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference. Public Opinion Quarterly, 81(S1), 250–271. https://doi.org/10.1093/poq/nfw060 ● Otwarty dostęp
Cytowania BibTeX
@article{brysbaert2019how, author={Brysbaert, Marc}, title={{How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{mercer2017theory, author={Mercer, Andrew W. and Kreuter, Frauke and Keeter, Scott and Stuart, Elizabeth A.}, title={{Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={250--271}, doi={10.1093/poq/nfw060}}