Co to jest analiza mocy a priori?
Analiza mocy a priori (ang. a priori power analysis) to obliczenie, ilu osób potrzebujesz w badaniu, zanim zaczniesz zbierać dane. Punktem wyjścia są trzy decyzje: poziom istotności α, pożądana moc testu (1 − β), czyli prawdopodobieństwo wykrycia efektu, jeśli on naprawdę istnieje, oraz wielkość efektu, który chcesz umieć wykryć. Z tych trzech wartości i rodzaju testu wynika czwarta – wymagana liczebność próby.
W psychologii analizę mocy wykonuje się najczęściej w bezpłatnym programie G*Power. Wersja 3 obsługuje testy z rodzin t, F, χ² i z oraz niektóre testy dokładne i oferuje wszystkie typowe rodzaje analiz mocy (Faul i in., 2007). Wersję 3.1 rozszerzono o analizy dla korelacji oraz regresji liniowej, wielorakiej, logistycznej i Poissona (Faul i in., 2009). Program pobierzesz ze strony Uniwersytetu Heinricha Heinego w Düsseldorfie. Te same obliczenia wykonasz w R – kod z identycznymi wynikami znajdziesz w sekcji Przykład w R.
Analiza mocy a priori to tylko jeden ze sposobów uzasadnienia liczebności próby. Lakens (2022) opisuje sześć: zbadanie (prawie) całej populacji, ograniczenia zasobów, analizę mocy a priori, planowanie dokładności oszacowania, heurystyki oraz jawne przyznanie, że uzasadnienia brak. Analiza mocy pasuje wtedy, gdy celem badania jest test hipotezy – sprawdzenie, czy efekt określonej wielkości da się wykryć przy kontrolowanym ryzyku błędu (szerzej: dobór liczebności próby).
Cztery wielkości: α, moc, efekt i N
Analiza mocy wiąże ze sobą cztery wielkości. Gdy znasz trzy z nich, czwartą można obliczyć:
| Wielkość | Co oznacza | Typowy wybór w pracy dyplomowej |
|---|---|---|
| α (poziom istotności) | Akceptowane ryzyko błędu I rodzaju, czyli „wykrycia” efektu, którego nie ma | .05, test dwustronny |
| 1 − β (moc) | Prawdopodobieństwo wykrycia efektu o założonej wielkości; β to ryzyko błędu II rodzaju | .80 albo .90 |
| Wielkość efektu | Efekt, który badanie ma wykryć, w mierze standaryzowanej: d, f, ρ, f² | Uzasadniona literaturą albo najmniejszym efektem ważnym praktycznie |
| N | Liczebność próby – w G*Power w każdej grupie i łącznie | Wynik analizy a priori |
Para wartości α = .05 i 1 − β = .80 to konwencja. Lakens (2022) zauważa, że w praktyce działa ona jak dolny próg, który recenzenci przyjmują bez dodatkowego uzasadnienia. Jeśli możesz, uzasadnij swoje wybory – na przykład wyższą moc, gdy przeoczenie efektu byłoby kosztowne. O samym poziomie istotności i o teście jednostronnym i dwustronnym piszemy w osobnych hasłach.
G*Power oferuje pięć rodzajów analizy mocy (Kang, 2021). Każdy odpowiada na inne pytanie:
- A priori – ile osób potrzeba przy danym α, mocy i efekcie (planowanie badania);
- Sensitivity – jaki najmniejszy efekt wykryjesz przy danej liczebności (gdy próba jest z góry ograniczona);
- Post hoc – jaką moc miało badanie przy danym N i założonym efekcie;
- Compromise i Criterion – jakie α i moc da się osiągnąć przy ustalonym stosunku ryzyka błędów albo jakie α wynika z pozostałych parametrów (rzadko potrzebne w pracach dyplomowych).
Analiza mocy a priori w G*Power krok po kroku
Przykład: planujesz porównać poziom stresu w grupie po treningu i w grupie kontrolnej testem t dla prób niezależnych. Zakładasz efekt d = 0.5, test dwustronny, α = .05 i moc .80. W głównym oknie G*Power wybierasz kolejno trzy listy rozwijane i wpisujesz parametry (Kang, 2021):
- Test family:
t tests. - Statistical test:
Means: Difference between two independent means (two groups). - Type of power analysis:
A priori: Compute required sample size – given α, power, and effect size. - Input parameters: Tail(s) =
Two; Effect size d =0.5; α err prob =0.05; Power (1−β err prob) =0.80; Allocation ratio N2/N1 =1(grupy równej wielkości). - Kliknij Calculate i odczytaj pole Output parameters.
W polu wyników pojawią się: Noncentrality parameter δ = 2.83, Critical t = 1.98, Df = 126, Sample size group 1 = 64, Sample size group 2 = 64, Total sample size = 128 i Actual power = 0.801. Potrzebujesz więc 64 osób w każdej grupie, łącznie 128. Ten sam wynik (64, 64 i 128) pokazuje Kang (2021) na zrzutach ekranu z G*Power 3.1.9.7, a R daje identyczne wartości. Przy mocy .90 potrzeba już 86 osób w każdej grupie.
„Actual power” jest nieco wyższa niż .80, bo liczebność zaokrągla się w górę do pełnych osób. Jeśli nie znasz d, ale masz średnie i odchylenia standardowe z wcześniejszego badania, przycisk Determine otworzy kalkulator wielkości efektu. Przycisk X-Y plot for a range of values rysuje zależność liczebności od mocy albo od efektu – przydaje się do aneksu pracy.
Ustawienia G*Power dla najczęstszych analiz
W pracach z psychologii najczęściej planuje się porównania grup, korelacje i regresję. Tabela podaje ścieżkę w menu, miarę efektu i wymaganą liczebność dla efektu średniego według konwencji Cohena (1992), przy α = .05 (dwustronnie) i mocy .80. Liczebności obliczyliśmy w R tymi samymi metodami, których używa G*Power.
| Analiza | Test family → Statistical test | Miara efektu | Wymagane N |
|---|---|---|---|
| Test t, dwie grupy niezależne | t tests → Means: Difference between two independent means (two groups) | d = 0.5 | 64 w grupie (128) |
| Test t, pomiar przed i po (próby zależne) | t tests → Means: Difference between two dependent means (matched pairs) | dz = 0.5 | 34 |
| ANOVA jednoczynnikowa, 3 grupy | F tests → ANOVA: Fixed effects, omnibus, one-way | f = 0.25 | 53 w grupie (159) |
| Korelacja Pearsona | Exact → Correlation: Bivariate normal model | ρ = .30 | 84 |
| Regresja wieloraka, 3 predyktory | F tests → Linear multiple regression: Fixed model, R² deviation from zero | f² = 0.15 | 77 |
Zwróć uwagę na dwie pułapki. W próbach zależnych G*Power oczekuje dz, czyli różnicy średnich podzielonej przez odchylenie standardowe różnic, a nie zwykłego d. W ANOVA miarą efektu jest f Cohena, a nie η² – przeliczysz je wzorem:
W korelacji wymagana liczebność rośnie bardzo szybko, gdy związek słabnie: dla ρ = .20 potrzeba 193 osób, a dla ρ = .10 – aż 782. Dla bardziej złożonych planów, takich jak moderacja czy mediacja, przystępny przewodnik z przykładami w G*Power i R przygotowali Perugini, Gallucci i Costantini (2018).
Jak wybrać wielkość efektu?
To najważniejsza decyzja w całej analizie, bo wynik zależy od niej najsilniej. Rysunek 1 pokazuje, jak szybko rośnie wymagana liczebność, gdy oczekiwany efekt maleje.
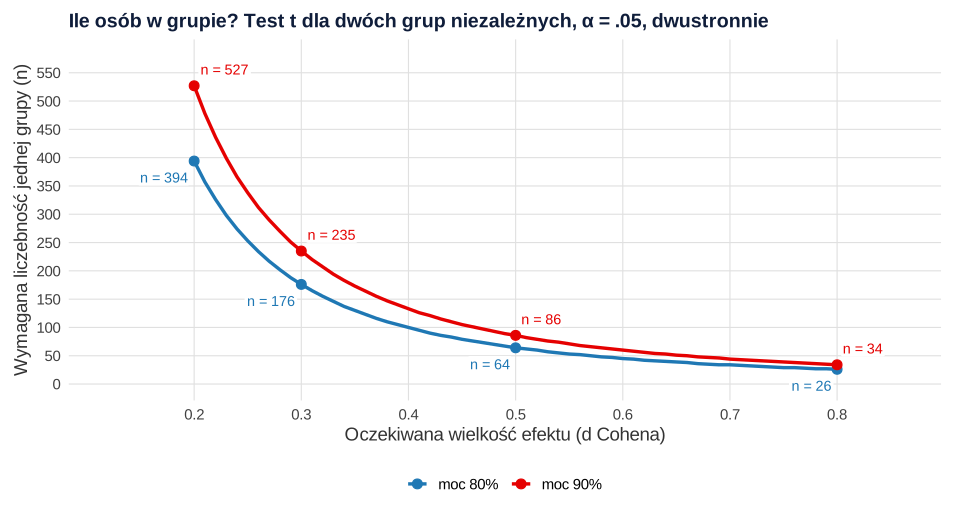
power.t.test().Dla d = 0.8 wystarczy 26 osób w grupie, dla d = 0.5 – 64, a dla d = 0.2 – aż 394. Zmniejszenie oczekiwanego efektu o połowę, z 0.4 do 0.2, zwiększa potrzebną liczebność mniej więcej czterokrotnie: ze 100 do 394 osób w grupie. Dlatego wartość efektu musi mieć uzasadnienie. Lakens (2022) wymienia kilka źródeł:
- Najmniejszy interesujący efekt (ang. smallest effect size of interest) – efekt, poniżej którego wynik nie miałby znaczenia teoretycznego ani praktycznego. Jeśli da się go uzgodnić, można zaprojektować badanie o wystarczającej mocy bez zgadywania prawdziwego efektu.
- Efekt z metaanalizy – najlepiej oszacowanie z badań najbardziej podobnych do Twojego (ta sama populacja, manipulacja i pomiar). Sprawdź, czy wyniki włączonych badań są jednorodne, i pamiętaj, że publikowanie głównie wyników istotnych (efekt szuflady) zawyża średni efekt w literaturze.
- Efekt z pojedynczego badania – jest niepewny. Lakens (2022) przestrzega zwłaszcza przed efektami z małych badań pilotażowych, które są zbyt nieprecyzyjne, by na nich planować.
- Konwencje Cohena – małe, średnie i duże efekty: d = 0.2, 0.5 i 0.8; f = 0.10, 0.25 i 0.40; ρ = .10, .30 i .50; f² = 0.02, 0.15 i 0.35 (Cohen, 1992). Traktuj je jako ostateczność i napisz w pracy wprost, że to założenie konwencjonalne (por. interpretacja d Cohena).
Co się stanie, jeśli prawdziwy efekt okaże się mniejszy, niż zakładasz? Badanie zaplanowane na d = 0.5 (64 osoby w grupie) ma wyraźnie mniejszą moc dla słabszych efektów:
| Prawdziwy efekt | d = 0.5 | d = 0.4 | d = 0.3 | d = 0.2 |
|---|---|---|---|---|
| Moc przy n = 64 w grupie | .80 | .61 | .39 | .20 |
Przy prawdziwym d = 0.3 takie badanie wykryje efekt tylko w 39% przypadków. Jeśli liczebność jest z góry ograniczona, odwróć pytanie i wykonaj analizę wrażliwości (w G*Power: Sensitivity: Compute required effect size – given α, power, and sample size). Przy 40 osobach w grupie, α = .05 i mocy .80 najmniejszy wykrywalny efekt to d = 0.63. Lakens (2022) zaleca taką analizę zwłaszcza wtedy, gdy liczebność wynika z ograniczeń zasobów.
Jak opisać analizę mocy w pracy (APA)
Opis powinien pozwolić czytelnikowi powtórzyć obliczenia. Podaj: rodzaj testu, α i liczbę stron testu, zakładaną moc, wielkość efektu wraz z uzasadnieniem, program i jego wersję, wynikową liczebność oraz zapas na rezygnacje i wykluczenia. Rekrutację z zapasem obliczysz wzorem (Kang, 2021):
gdzie r to przewidywany odsetek osób, które odpadną. Przy 15% rezygnacji: 64 / 0.85 = 75.3, czyli 76 osób w grupie. Gotowy opis do rozdziału metodologicznego:
Gdy liczebność wynikała z ograniczeń (np. dostępnej grupy studentów), opisz analizę wrażliwości:
Przykład w R
Kod odtwarza w R obliczenia z G*Power: funkcje power.t.test() i power.anova.test() z podstawowej instalacji R oraz dwie krótkie funkcje dla korelacji (rachunek dokładny, jak w rodzinie „Exact”) i regresji (rozkład F z parametrem niecentralności f² × N). Wszystkie liczby w haśle pochodzą z tego kodu.
Test t dla dwóch grup niezależnych
R
# G*Power: t tests → Means: Difference between two independent means (two groups) → A priori
power.t.test(delta = 0.5, sd = 1, sig.level = 0.05, power = 0.80,
             type = "two.sample", alternative = "two.sided")
ceiling(power.t.test(delta = 0.5, power = 0.80)$n)      # osób w każdej grupie
power.t.test(n = 64, delta = 0.5)$power                  # moc faktyczna (Actual power)
c(delta = 0.5 * sqrt(64 / 2), df = 2 * 64 - 2, t_kryt = qt(0.975, df = 126))   # pola Output w G*Power
ceiling(power.t.test(delta = 0.5, power = 0.90)$n)      # ta sama analiza dla mocy 90%
Wynik w R
     Two-sample t test power calculation

              n = 63.76576
          delta = 0.5
             sd = 1
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

[1] 64
[1] 0.8014586
     delta         df     t_kryt
  2.828427 126.000000   1.978971
[1] 86
Próby zależne, ANOVA, korelacja i regresja
R
# próby zależne (d_z = 0.5): t tests → Means: Difference between two dependent means (matched pairs)
ceiling(power.t.test(delta = 0.5, power = 0.80, type = "paired")$n)
# ANOVA jednoczynnikowa, 3 grupy, f = 0.25: F tests → ANOVA: Fixed effects, omnibus, one-way
k <- 3; f <- 0.25
power.anova.test(groups = k, between.var = k * f^2 / (k - 1), within.var = 1, power = 0.80)
# korelacja rho = .30: Exact → Correlation: Bivariate normal model (rachunek dokładny)
moc_korelacji <- function(N, rho, alfa = 0.05) {
  df <- N - 2; tk <- qt(1 - alfa / 2, df)
  calka <- function(w) {
    ncp <- rho / sqrt(1 - rho^2) * sqrt(w)
    (pt(-tk, df, ncp) + pt(tk, df, ncp, lower.tail = FALSE)) * dchisq(w, N - 1)
  }
  integrate(calka, qchisq(1e-9, N - 1), qchisq(1 - 1e-9, N - 1))$value
}
n_korelacji <- function(rho, moc = 0.80) {
  N <- floor(((qnorm(0.975) + qnorm(moc)) / atanh(rho))^2 + 3) - 10   # start poniżej przybliżenia Fishera
  while (moc_korelacji(N, rho) < moc) N <- N + 1
  N
}
sapply(c(rho_0.30 = 0.30, rho_0.20 = 0.20, rho_0.10 = 0.10), n_korelacji)
round(moc_korelacji(84, rho = 0.30), 4)                          # moc faktyczna przy N = 84
ceiling(((qnorm(0.975) + qnorm(0.80)) / atanh(0.30))^2 + 3)      # samo przybliżenie Fishera: o 1 osobę więcej
# regresja wieloraka, 3 predyktory, f2 = 0.15: F tests → Linear multiple regression: Fixed model, R² deviation from zero
moc_regresji <- function(N, f2, p, alfa = 0.05) {
  df2 <- N - p - 1
  pf(qf(1 - alfa, p, df2), p, df2, ncp = f2 * N, lower.tail = FALSE)
}
N <- 10; while (moc_regresji(N, f2 = 0.15, p = 3) < 0.80) N <- N + 1
c(N = N, moc = round(moc_regresji(N, f2 = 0.15, p = 3), 4))
Wynik w R
[1] 34

     Balanced one-way analysis of variance power calculation

         groups = 3
              n = 52.3966
    between.var = 0.09375
     within.var = 1
      sig.level = 0.05
          power = 0.8

NOTE: n is number in each group

rho_0.30 rho_0.20 rho_0.10
      84      193      782
[1] 0.8003
[1] 85
      N     moc
77.0000  0.8018
Analiza wrażliwości, mniejszy efekt i rezygnacje
R
ceiling(power.t.test(delta = 0.4, power = 0.80)$n)   # d = 0.4 zamiast 0.5
power.t.test(n = 40, power = 0.80)$delta        # najmniejsze d wykrywane z mocą 80% przy 40 osobach w grupie
sapply(c(d0.5 = 0.5, d0.4 = 0.4, d0.3 = 0.3, d0.2 = 0.2),
       function(d) round(power.t.test(n = 64, delta = d)$power, 2))   # moc przy n = 64, gdy prawdziwe d jest mniejsze
ceiling(64 / (1 - 0.15))                         # rekrutacja na grupę przy 15% rezygnacji
Wynik w R
[1] 100
[1] 0.634299
d0.5 d0.4 d0.3 d0.2
0.80 0.61 0.39 0.20
[1] 76
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje z pakietu stats); rysunek przygotowano w pakiecie ggplot2. Jeśli liczysz w G*Power, w pracy zacytuj program (Faul i in., 2007, 2009) i podaj jego wersję.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Efekt średni” bez uzasadnienia – konwencja Cohena zastępuje myślenie o tym, jaki efekt ma znaczenie. Napisz, skąd pochodzi założona wartość (Lakens, 2022).
- Efekt z małego pilotażu – oszacowanie z kilkunastu osób jest bardzo niepewne, a planowanie na zawyżonym efekcie daje badanie o zbyt małej mocy (zob. tabela powyżej).
- Zła miara efektu – wpisanie d zamiast dz w próbach zależnych albo η² zamiast f w ANOVA.
- Analiza dla innego testu niż planowany – na przykład moc dla testu t, gdy w pracy będzie ANOVA z trzema grupami, albo moc dla korelacji, gdy hipotezę sprawdzi regresja z kilkoma predyktorami. Interakcje i moderacja wymagają osobnej, zwykle znacznie większej próby (zob. analiza moderacji krok po kroku).
- Brak zapasu na rezygnacje i wykluczenia – jeśli usuniesz osoby z brakami danych albo nieuważnymi odpowiedziami, końcowe N spadnie poniżej wymaganego (Kang, 2021).
- Test jednostronny tylko po to, by zmniejszyć próbę – kierunek musi wynikać z hipotezy i być ustalony z góry, najlepiej w prerejestracji.
- Moc „obserwowana” po badaniu – moc policzona post hoc z uzyskanego efektu jest prostą funkcją wartości p i nie dodaje informacji. Po badaniu lepiej podać przedział ufności dla efektu albo analizę wrażliwości.
Najczęstsze pytania
Co to jest analiza mocy a priori?
To obliczenie liczebności próby przed rozpoczęciem badania. Podajesz poziom istotności α (zwykle .05), pożądaną moc (zwykle .80) i oczekiwaną wielkość efektu, a program – np. G*Power – zwraca wymagane N. Dzięki temu badanie ma rozsądną szansę wykryć efekt, jeśli on istnieje.
Jak obliczyć liczebność próby w G*Power?
Wybierz Test family (np. t tests), Statistical test (np. Means: Difference between two independent means (two groups)) i typ A priori: Compute required sample size. Wpisz liczbę stron testu, wielkość efektu, α i moc, a potem kliknij Calculate. Dla d = 0.5, α = .05 i mocy .80 otrzymasz 64 osoby w każdej grupie (łącznie 128).
Jaką wielkość efektu wpisać do G*Power?
Najlepiej najmniejszy efekt, który ma znaczenie teoretyczne lub praktyczne, albo oszacowanie z metaanalizy podobnych badań. Efekty z małych pilotaży są zbyt niepewne. Konwencje Cohena (d = 0.2, 0.5, 0.8) traktuj jako ostateczność i napisz to w pracy wprost.
Ile osób potrzeba do korelacji?
Przy α = .05 (test dwustronny) i mocy .80 do wykrycia korelacji ρ = .30 potrzeba 84 osób, przy ρ = .20 – 193, a przy ρ = .10 – aż 782. W G*Power wybierz rodzinę Exact i test Correlation: Bivariate normal model.
Czy można zrobić analizę mocy po badaniu?
Moc „obserwowana”, obliczona z uzyskanego efektu, jest prostą funkcją wartości p i nic nie dodaje do interpretacji. Po badaniu lepiej wykonać analizę wrażliwości – sprawdzić, jaki najmniejszy efekt dało się wykryć przy zebranej liczebności – i podać przedział ufności dla efektu.
Jak opisać analizę mocy w pracy magisterskiej?
Podaj test, α i liczbę stron testu, moc, wielkość efektu z uzasadnieniem, program z wersją, wynikowe N i zapas na rezygnacje, np. „analiza mocy a priori w G*Power 3.1 wykazała, że dla d = 0.50, α = .05 i mocy .80 potrzeba 64 osób w każdej grupie”. Opis umieść w podrozdziale o osobach badanych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Faul, F., Erdfelder, E., Buchner, A., & Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149–1160. https://doi.org/10.3758/BRM.41.4.1149 ● Otwarty dostęp
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146 ● Otwarty dostęp
- Kang, H. (2021). Sample size determination and power analysis using the G*Power software. Journal of Educational Evaluation for Health Professions, 18, Article 17. https://doi.org/10.3352/jeehp.2021.18.17 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Perugini, M., Gallucci, M., & Costantini, G. (2018). A practical primer to power analysis for simple experimental designs. International Review of Social Psychology, 31(1), Article 20. https://doi.org/10.5334/irsp.181 ● Otwarty dostęp
Cytowania BibTeX
@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{faul2009statistical, author={Faul, Franz and Erdfelder, Edgar and Buchner, Axel and Lang, Albert-Georg}, title={{Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses}}, journal={Behavior Research Methods}, year={2009}, volume={41}, number={4}, pages={1149--1160}, doi={10.3758/brm.41.4.1149}}@article{faul2007gpower, author={Faul, Franz and Erdfelder, Edgar and Lang, Albert-Georg and Buchner, Axel}, title={{G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={2}, pages={175--191}, doi={10.3758/bf03193146}}@article{kang2021sample, author={Kang, Hyun}, title={{Sample size determination and power analysis using the G*Power software}}, journal={Journal of Educational Evaluation for Health Professions}, year={2021}, volume={18}, eid={17}, doi={10.3352/jeehp.2021.18.17}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{perugini2018practical, author={Perugini, Marco and Gallucci, Marcello and Costantini, Giulio}, title={{A practical primer to power analysis for simple experimental designs}}, journal={International Review of Social Psychology}, year={2018}, volume={31}, number={1}, eid={20}, doi={10.5334/irsp.181}}