Co to jest parametr niecentralności?
Parametr niecentralności (ang. noncentrality parameter, NCP) mówi, jak daleko od zera przesuwa się rozkład statystyki testowej, gdy w populacji istnieje efekt. Przy prawdziwej hipotezie zerowej statystyka t ma zwykły rozkład t, a przy efekcie – niecentralny rozkład t. Moc testu to pole tego przesuniętego rozkładu poza wartościami krytycznymi wyznaczonymi przy H0. Tak liczą moc tablice Cohena (1988) i programy do analizy mocy a priori.
Wzory dla t i F
- Test t dla dwóch grup po n osób: δ = d·√(n/2), gdzie d to d Cohena.
- Test F w regresji: λ = f²·(u + v + 1), czyli f² razy liczebność próby (u, v – stopnie swobody), gdzie f² to f² Cohena. Moc to pole niecentralnego rozkładu F nad wartością krytyczną.
Symulacyjna analiza mocy
Gdy wzoru nie ma (skośne dane, braki, model wielopoziomowy), moc szacuje się symulacją: losujesz wiele zbiorów danych z założonego modelu, wykonujesz zaplanowaną analizę i liczysz odsetek wyników z p < α. Arnold i in. (2011) pokazują, że symulacja odtwarza klasyczne wyniki dla prostych schematów i sprawdza się np. przy randomizacji klastrów. Morris i in. (2019) zalecają planować symulację według schematu ADEMP (cele, mechanizm generowania danych, estymandy, metody, miary jakości) oraz starannie opisywać plan i wyniki symulacji. Dokładność samej symulacji opisuje błąd Monte Carlo.
Przykład
Dla d = 0.5 i 30 osób w grupie δ = 1.94, a moc dwustronnego testu t wynosi .478 (to samo daje pwr::pwr.t.test). Symulacja 5000 badań dała .487 (błąd Monte Carlo 0.007). W regresji z trzema predyktorami, N = 80 i f² = 0.15 λ = 12, a moc = .819. Przy skośnym rozkładzie wykładniczym z tym samym przesunięciem (por. test t przy rozkładzie nienormalnym) symulacja daje moc .51 dla testu t i .76 dla testu Manna–Whitneya – tego nie pokaże wzór dla rozkładu normalnego.
Na rysunku
Plan z przykładu (d = 0.5, test t dla dwóch grup, α = .05) na dwa sposoby. Panel A: 5000 symulowanych badań po 30 osób w grupie na tle dwóch rozkładów t – centralnego i niecentralnego. Panel B: moc dla 10–60 osób w grupie ze wzoru i z symulacji (2000 badań na punkt), także dla danych skośnych z rozkładu wykładniczego z tym samym przesunięciem.
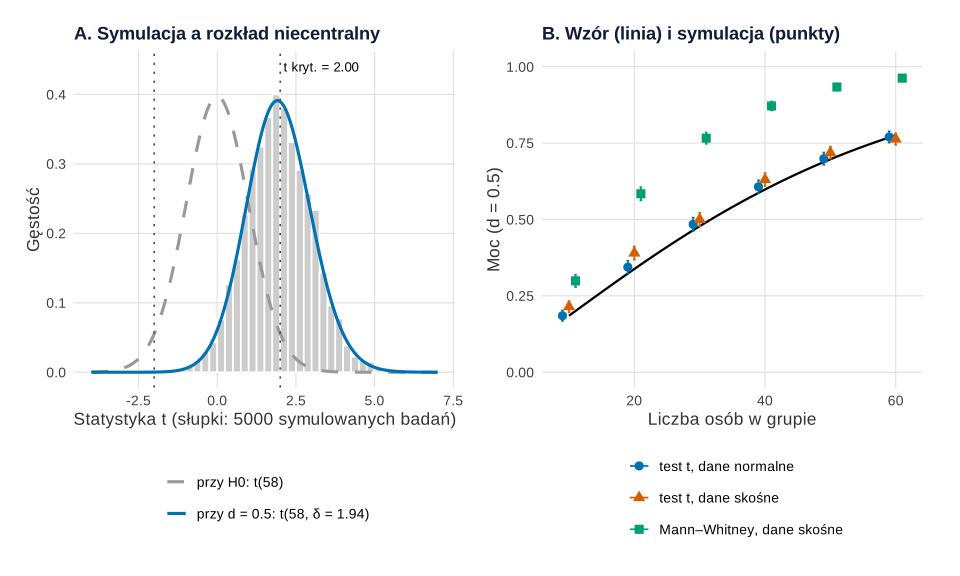
set.seed(707) i set.seed(7071)).Co widać. Histogram w panelu A leży pod niebieską krzywą niecentralnego rozkładu, a nie pod szarą krzywą rozkładu przy H0. Średnia symulowanych t wynosi 1.97, blisko δ = 1.94. Odsetek |t| > 2.00 to moc: .478 w symulacji i .478 ze wzoru. W panelu B kółka dla danych normalnych leżą na linii wzoru, np. .484 wobec .478 przy 30 osobach (błąd Monte Carlo 0.011). Przy danych skośnych test t ma moc bliską wzorowi (.500), a test Manna–Whitneya – .766. Przy 60 osobach w grupie jest to .963 wobec .775 ze wzoru.
Na co uważać. Zgodność w panelu B dotyczy tylko modelu, który wpisano do symulacji: dane wykładnicze to jeden z wielu możliwych kształtów, a przesunięcie o 0.5 SD – założenie. Przy danych normalnych symulacja niczego nie dodaje do wzoru; opłaca się dopiero wtedy, gdy wzór nie pasuje do danych lub analizy. Wąsy pokazują błąd samej symulacji, a nie niepewność co do efektu. Krzywe mocy w funkcji n, d i α dla danych normalnych pokazuje wpis moc testu w obrazkach, a pochodzenie rozkładu t – skąd się biorą rozkłady t, χ² i F.
Podpis do pracy:
Kod odtwarza rysunek i liczby z akapitu. Liczby różnią się nieco od przykładu powyżej, bo to inne losowania; ziarna 707 (A) i 7071 (B) ustalono raz i nie zmieniano. Kod definiuje sam paletę Okabe–Ito i motyw; rysunek na stronie różni się tylko krojem czcionki.
Kod R rysunku 1
# Rysunek 1. Rozkład t przy H0 i przy efekcie (niecentralny) na tle symulacji (A)
# oraz moc z wzoru i z symulacji w funkcji liczebności grupy (B)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
d <- 0.5; alfa <- 0.05

# A: 5000 statystyk t z badań 2 × 30 osób przy d = 0.5 a gęstości rozkładu t centralnego i niecentralnego
set.seed(707)
n <- 30; df <- 2 * n - 2; ncp <- d * sqrt(n / 2); tkr <- qt(1 - alfa / 2, df)
t_sym <- replicate(5000, t.test(rnorm(n, d), rnorm(n), var.equal = TRUE)$statistic)
round(c(ncp = ncp, t_kryt = tkr, sr_t_sym = mean(t_sym), moc_wzor = pt(tkr, df, ncp, lower.tail = FALSE) + pt(-tkr, df, ncp),
        moc_sym = mean(abs(t_sym) > tkr)), 3)
x <- seq(-4, 7, by = 0.02)
gest <- rbind(data.frame(t = x, g = dt(x, df), rozklad = "przy H0: t(58)"),
              data.frame(t = x, g = dt(x, df, ncp), rozklad = "przy d = 0.5: t(58, δ = 1.94)"))
gest$rozklad <- factor(gest$rozklad, levels = unique(gest$rozklad))
pA <- ggplot() +
  geom_histogram(aes(x = t_sym, y = after_stat(density)), breaks = seq(-4, 7, by = 0.25),
                 fill = "grey80", colour = "white") +
  geom_line(data = gest, aes(t, g, colour = rozklad, linetype = rozklad), linewidth = 1.1) +
  geom_vline(xintercept = c(-tkr, tkr), colour = "grey30", linetype = "dotted") +
  annotate("text", x = tkr + 0.1, y = 0.44, label = "t kryt. = 2.00", hjust = 0, size = 3.5) +
  scale_colour_manual(values = c("#999999", "#0072B2"), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = "A. Symulacja a rozkład niecentralny", x = "Statystyka t (słupki: 5000 symulowanych badań)",
       y = "Gęstość") +
  motyw

# B: moc w funkcji n – wzór (rozkład niecentralny) i symulacja: dane normalne oraz skośne (wykładnicze)
set.seed(7071)
R <- 2000
siatka_n <- seq(10, 60, by = 10)
sym <- do.call(rbind, lapply(siatka_n, function(k) {
  p <- replicate(R, {
    xn <- rnorm(k, d); yn <- rnorm(k)
    xe <- rexp(k) + d; ye <- rexp(k)                         # rozkład wykładniczy (SD = 1), przesunięcie 0.5
    c(t.test(xn, yn, var.equal = TRUE)$p.value, t.test(xe, ye, var.equal = TRUE)$p.value, wilcox.test(xe, ye)$p.value)
  })
  data.frame(n = k, metoda = c("test t, dane normalne", "test t, dane skośne", "Mann–Whitney, dane skośne"),
             moc = rowMeans(p < alfa))
}))
sym$mcse <- sqrt(sym$moc * (1 - sym$moc) / R)                  # błąd Monte Carlo
sym$metoda <- factor(sym$metoda, levels = c("test t, dane normalne", "test t, dane skośne", "Mann–Whitney, dane skośne"))
wzor <- data.frame(n = 10:60, moc = power.t.test(n = 10:60, delta = d, strict = TRUE)$power)
print(transform(sym, moc = round(moc, 3), mcse = round(mcse, 3), wzor = round(power.t.test(n = n, delta = d, strict = TRUE)$power, 3)),
      row.names = FALSE)
pB <- ggplot(sym, aes(n, moc)) +
  geom_line(data = wzor, aes(n, moc), colour = "black", linewidth = 0.8) +
  geom_errorbar(aes(ymin = moc - 1.96 * mcse, ymax = moc + 1.96 * mcse, colour = metoda), width = 1.2,
                position = position_dodge(width = 3)) +
  geom_point(aes(colour = metoda, shape = metoda), size = 2.8, position = position_dodge(width = 3)) +
  scale_colour_manual(values = c("#0072B2", "#D55E00", "#009E73"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  scale_y_continuous(limits = c(0, 1)) +
  labs(title = "B. Wzór (linia) i symulacja (punkty)", x = "Liczba osób w grupie", y = "Moc (d = 0.5)") +
  motyw
p1 <- pA + pB
p1   # zapis: ggsave("parametr-niecentralnosci-symulacja-mocy.svg", p1, width = 10, height = 6)
Wynik w R
     ncp   t_kryt sr_t_sym moc_wzor  moc_sym
   1.936    2.002    1.970    0.478    0.478
  n                    metoda   moc  mcse  wzor
 10     test t, dane normalne 0.185 0.009 0.185
 10       test t, dane skośne 0.214 0.009 0.185
 10 Mann–Whitney, dane skośne 0.299 0.010 0.185
 20     test t, dane normalne 0.344 0.011 0.338
 20       test t, dane skośne 0.390 0.011 0.338
 20 Mann–Whitney, dane skośne 0.584 0.011 0.338
 30     test t, dane normalne 0.484 0.011 0.478
 30       test t, dane skośne 0.500 0.011 0.478
 30 Mann–Whitney, dane skośne 0.766 0.009 0.478
 40     test t, dane normalne 0.607 0.011 0.598
 40       test t, dane skośne 0.630 0.011 0.598
 40 Mann–Whitney, dane skośne 0.872 0.007 0.598
 50     test t, dane normalne 0.699 0.010 0.697
 50       test t, dane skośne 0.719 0.010 0.697
 50 Mann–Whitney, dane skośne 0.933 0.006 0.697
 60     test t, dane normalne 0.770 0.009 0.775
 60       test t, dane skośne 0.763 0.010 0.775
 60 Mann–Whitney, dane skośne 0.963 0.004 0.775
Jak opisać w pracy
Na co uważać
- Za mało replikacji. Błąd Monte Carlo to √(moc·(1 − moc)/R); przy 1000 replikacjach wynosi do 0.016.
- Model danych to założenie. Symulacja jest tak dobra jak założony rozkład i wielkość efektu.
Moc z rozkładów niecentralnych i z symulacji w R
Kod liczy moc testów t i F z rozkładów niecentralnych (pt(), pf() z ncp), porównuje ją z pakietem pwr i szacuje moc symulacją. Liczby w tekście pochodzą z tego kodu.
Parametr niecentralności i symulacja mocy
R
set.seed(7070)
d <- 0.5; n <- 30; alfa <- 0.05                      # plan: dwie grupy po 30 osób, d = 0.5
df <- 2 * n - 2
ncp <- d * sqrt(n / 2)                               # parametr niecentralności rozkładu t
tkr <- qt(1 - alfa / 2, df)                          # wartość krytyczna przy H0
moc_t <- pt(tkr, df, ncp, lower.tail = FALSE) + pt(-tkr, df, ncp)
round(c(df = df, ncp = ncp, t_kryt = tkr, moc = moc_t), 4)
power.t.test(n = n, delta = d, sd = 1, sig.level = alfa)$power   # stats: bez dolnego ogona (strict = FALSE)
pwr::pwr.t.test(n = n, d = d, sig.level = alfa)$power            # i w pwr
u <- 3; N <- 80; v <- N - u - 1; f2 <- 0.15          # regresja: 3 predyktory, N = 80, f2 = 0.15
lambda <- f2 * (u + v + 1)                           # parametr niecentralności rozkładu F
round(c(lambda = lambda, moc = pf(qf(1 - alfa, u, v), u, v, lambda, lower.tail = FALSE)), 4)
pwr::pwr.f2.test(u = u, v = v, f2 = f2, sig.level = alfa)$power
R <- 5000                                            # liczba symulowanych badań
p_norm <- replicate(R, t.test(rnorm(n, d), rnorm(n), var.equal = TRUE)$p.value)
moc_sym <- mean(p_norm < alfa)
round(c(moc_sym = moc_sym, mcse = sqrt(moc_sym * (1 - moc_sym) / R)), 4)  # błąd Monte Carlo
p_sko <- replicate(R, {                              # rozkład wykładniczy (SD = 1), przesunięcie 0.5
  x <- rexp(n) + d; y <- rexp(n)
  c(t = t.test(x, y, var.equal = TRUE)$p.value, w = wilcox.test(x, y)$p.value)
})
round(rowMeans(p_sko < alfa), 4)                     # moc testu t i Manna–Whitneya przy skośności
Wynik w R
     df     ncp  t_kryt     moc
58.0000  1.9365  2.0017  0.4779
[1] 0.477841
[1] 0.4778965
 lambda     moc
12.0000  0.8191
[1] 0.8190542
moc_sym    mcse
 0.4870  0.0071
     t      w
0.5092 0.7634
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet pwr). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć parametr niecentralności dla testu t?
Dla dwóch grup po n osób δ = d·√(n/2). Przy d = 0.5 i 30 osobach w grupie δ = 1.94, a moc dwustronnego testu na poziomie .05 wynosi około .48.
Ile replikacji potrzeba w symulacyjnej analizie mocy?
Zależy od wymaganej precyzji. Błąd Monte Carlo to √(moc·(1 − moc)/R): przy 1000 replikacjach wynosi do 0.016, a przy 5000 – do 0.007.
Kiedy wybrać symulację zamiast wzoru?
Gdy dane mają być skośne, z brakami lub klastrami albo gdy planujesz test, dla którego nie ma gotowego wzoru. W prostych schematach symulacja powinna dać ten sam wynik co wzór – to dobry test kodu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Moc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikJak zaplanować badanie symulacyjne
Schemat ADEMP krok po kroku: cele, dane, estymandy, metody i miary jakości z błędem Monte Carlo, liczba powtórzeń i ziarna w SimDesign.
Czytaj →PoradnikLiczebność próby do SEM – symulacja Monte Carlo
Model populacyjny, simulateData() i pętla w lavaan: moc dla wybranej ścieżki, zbieżność, rozwiązania niewłaściwe, krzywa mocy i wzór opisu.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikAnaliza mocy dla modelu mieszanego
Własna pętla symulacyjna w lme4: parametry z pilotażu, siatka osób i prób, krzywa mocy, błąd Monte Carlo i analiza wrażliwości.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Arnold, B. F., Hogan, D. R., Colford, J. M., & Hubbard, A. E. (2011). Simulation methods to estimate design power: An overview for applied research. BMC Medical Research Methodology, 11(1), Article 94. https://doi.org/10.1186/1471-2288-11-94 ● Otwarty dostęp
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Morris, T. P., White, I. R., & Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086 ● Otwarty dostęp
Cytowania BibTeX
@article{arnold2011simulation, author={Arnold, Benjamin F. and Hogan, Daniel R. and Colford, John M. and Hubbard, Alan E.}, title={{Simulation methods to estimate design power: An overview for applied research}}, journal={BMC Medical Research Methodology}, year={2011}, volume={11}, number={1}, eid={94}, doi={10.1186/1471-2288-11-94}}@book{cohen1988statistical, author={Cohen, Jacob}, title={{Statistical power analysis for the behavioral sciences}}, year={1988}, edition={2}, publisher={Lawrence Erlbaum Associates}, url={https://openlibrary.org/books/OL2035961M}}@article{morris2019using, author={Morris, Tim P. and White, Ian R. and Crowther, Michael J.}, title={{Using simulation studies to evaluate statistical methods}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={11}, pages={2074--2102}, doi={10.1002/sim.8086}}