Jeden klocek: zmienna z
Tablice rozkładów t, χ² i F wyglądają jak trzy osobne światy. Tymczasem wszystkie trzy rozkłady buduje się z jednego klocka: zmiennej z o standardowym rozkładzie normalnym (średnia 0, odchylenie standardowe 1). Definicje, wzory i własności znajdziesz w hasłach rozkład t-Studenta, rozkład chi-kwadrat i rozkład F. Tutaj te rozkłady składamy w R z losowych liczb i sprawdzamy na rysunkach, że histogram z symulacji pokrywa się z krzywą z tablic.
Przepisy są trzy. Dodaj kwadraty k zmiennych z – dostaniesz χ²(k). Podziel jedną zmienną z przez pierwiastek z niezależnego χ² podzielonego przez jego stopnie swobody – dostaniesz t. Podziel dwa niezależne χ², każdy przez swoje stopnie swobody – dostaniesz F. Krzywa na rysunku to funkcja gęstości, a pole pod nią to prawdopodobieństwo.
Każda symulacja ma 20 000 powtórzeń. Przy odsetkach podajemy błąd Monte Carlo (MC): √(p(1 − p)/20 000), przy 5% to około 0.15 punktu procentowego (pp). Ziarno 576 ustaliliśmy z góry i nie dobieraliśmy go pod wynik. Cały kod jest w sekcji „Kod R” na końcu wpisu.
Rysunek 1: χ² to suma kwadratów zmiennych z
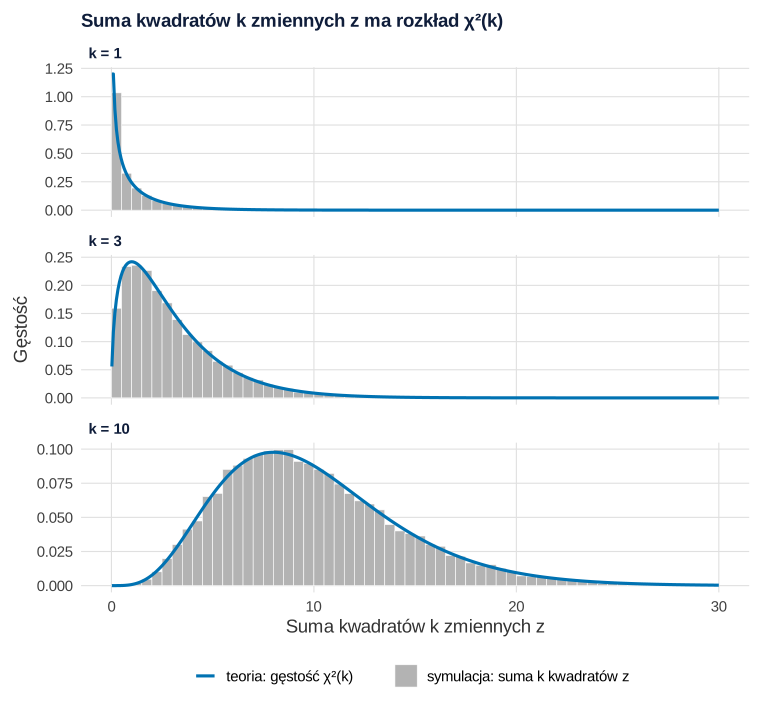
set.seed(576)).Co widać. Przy jednej zmiennej suma kwadratów to po prostu z², więc większość wyników leży blisko zera, a pojedyncze sięgają 10 i więcej. Przy trzech zmiennych rozkład ma garb, a przy dziesięciu zaczyna przypominać przesunięty dzwon. Średnie z symulacji wyniosły 1.010, 3.016 i 9.962, a wariancje 2.051, 5.973 i 19.918 – zgodnie z regułą „średnia k, wariancja 2k” (Forbes i in., 2010). Wartości krytyczne 3.841, 7.815 i 18.307 przekroczyło 5.135%, 4.940% i 4.925% sum (błąd MC 0.15–0.16 pp).
Czego ten wykres nie pokazuje. Skąd sumy kwadratów biorą się w danych. W teście chi-kwadrat niezależności sumuje się standaryzowane różnice liczebności obserwowanych i oczekiwanych. Pearson (1900) zaproponował to kryterium do oceny, czy odchylenia mogą wynikać z losowania. W tym teście rozkład χ² jest jednak tylko przybliżeniem, dobrym przy dużych liczebnościach oczekiwanych. Gdy odchylenia liczysz od średniej z próby, a nie od średniej populacji, jeden stopień swobody znika. Pokazujemy to na symulacji w haśle stopnie swobody. Jak wygląda sama tabela i jej reszty, zobaczysz we wpisie tabela krzyżowa na wykresie.
Podpis do pracy (np. w rozdziale teoretycznym albo w aneksie):
Zdanie do pracy (gdy sam sprawdzasz rozkład statystyki symulacją):
Rysunek 2: t to z podzielone przez niepewne SD
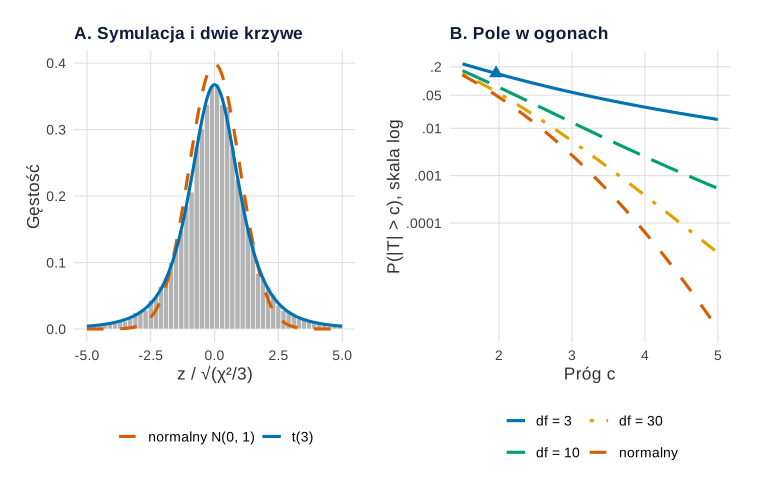
Co widać. Panel A: iloraz ma niższy szczyt i grubsze ogony niż rozkład normalny, a histogram leży na krzywej t(3). Kwantyl 97.5% wyniósł w symulacji 3.239, w teorii 3.182, a w rozkładzie normalnym tylko 1.960. Wynik |t| > 1.96 pojawił się w 14.54% prób (błąd MC 0.25 pp; teoria 14.49%). Panel B pokazuje, że różnica rośnie daleko w ogonie: |t| > 3 przy 3 df zdarza się w 5.77% przypadków, przy 10 df w 1.33%, przy 30 df w 0.54%, a w rozkładzie normalnym w 0.27%.
Ta sama konstrukcja kryje się w teście t. W statystyce (M − μ)/(s/√n) licznik po podzieleniu przez σ/√n jest zmienną z, a (n − 1)s²/σ² ma rozkład χ²(n − 1). Przy danych normalnych oba składniki są niezależne. Dlatego statystyka t z 20 000 prób po 4 osoby miała kwantyle −3.158 i 3.289, bliskie teoretycznym ±3.182 rozkładu t(3). Gosset opublikował ten wynik pod pseudonimem Student (1908). Zabell (2008) opisuje go jako pierwszy z dokładnych wyników dla małych prób, na których oparto współczesne wnioskowanie.
Czego ten wykres nie pokazuje. Że grube ogony mają koszt i zysk. Próg 1.96 przy 3 df prawie trzykrotnie zawyża błąd I rodzaju, więc wartości krytyczne t rosną przy małym n.
Podpis do pracy:
Zdanie do pracy (np. uzasadnienie, dlaczego przy małej próbie nie używasz progu 1.96):
Rysunek 3: F to iloraz dwóch χ²
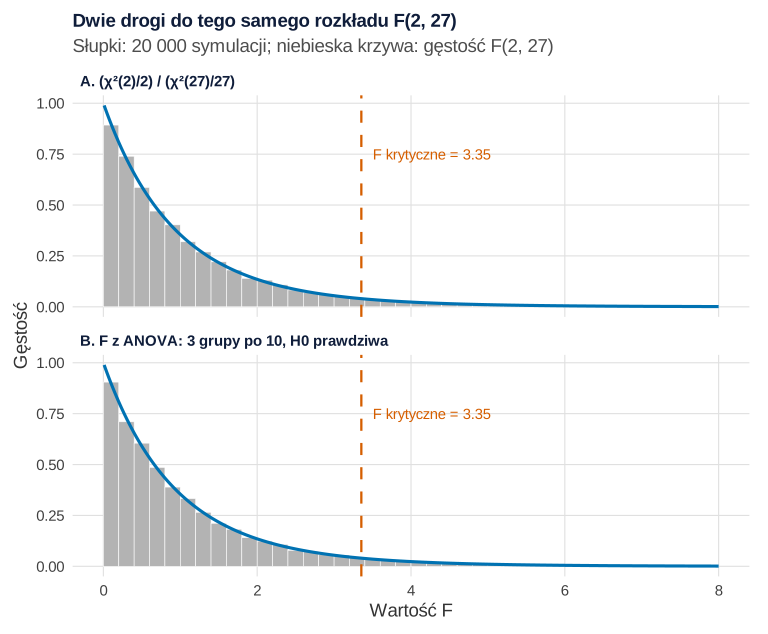
Co widać. Dwie drogi dają ten sam rozkład. Górny histogram to czysta konstrukcja: χ²(2)/2 podzielone przez χ²(27)/27. Dolny to statystyka F z 20 000 jednoczynnikowych ANOVA, w których trzy grupy po 10 osób losowano z tej samej populacji. Suma kwadratów międzygrupowa podzielona przez σ² ma tu rozkład χ²(2), a wewnątrzgrupowa – χ²(27). Wartość krytyczną 3.354 przekroczyło 5.04% ilorazów i 4.96% statystyk z ANOVA (błąd MC 0.15 pp). Średnie wyniosły 1.087 i 1.077 wobec teoretycznej 27/25 = 1.080 (Forbes i in., 2010).
Czego ten wykres nie pokazuje. Założeń, na których stoi ta zgodność. Obie grupy sum kwadratów mają rozkład χ² tylko przy danych normalnych o równych wariancjach (zob. homogeniczność wariancji). Rysunek pokazuje też tylko H0. Przy prawdziwej różnicy średnich statystyka F ma rozkład niecentralny, przesunięty w prawo – tak jak rozkład t na rysunkach we wpisie moc testu w obrazkach.
Podpis do pracy:
Zdanie do pracy:
Rysunek 4: kształt a stopnie swobody
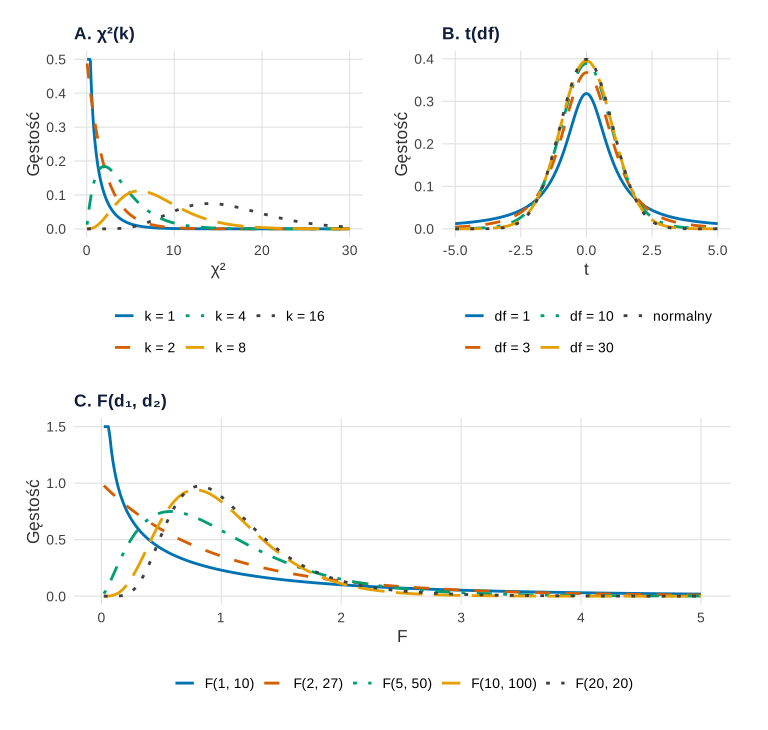
Co widać. Panel A: χ²(k) przesuwa się w prawo, bo jego średnia wynosi k, i rozszerza się (SD = √(2k): 1.414 przy k = 1, 5.657 przy k = 16). Skośność spada z 2.828 do 0.707. Panel B: im mniej stopni swobody, tym niższy szczyt i grubsze ogony rozkładu t. Wariancja wynosi 3.000 przy 3 df, 1.250 przy 10 i 1.071 przy 30 (w rozkładzie normalnym 1). Przy 1 df wariancja nie istnieje – to rozkład Cauchy’ego. Dwustronna wartość krytyczna spada z 12.706 (1 df) przez 3.182 i 2.228 do 2.042 (30 df). Panel C: rozkład F przy jednym lub dwóch df licznika maleje od zera, a przy większych ma garb blisko 1. Wartości krytyczne: 4.965 dla F(1, 10), 3.354 dla F(2, 27), 2.400 dla F(5, 50) i 1.927 dla F(10, 100).
Czego ten wykres nie pokazuje. Skąd w Twojej analizie biorą się konkretne df – to wyjaśnia hasło stopnie swobody (tabela z najczęstszymi testami). Na rysunku nie widać też, że kolejność df w F ma znaczenie: F(2, 27) i F(27, 2) to inne krzywe.
Podpis do pracy:
Zdanie do pracy:
Rysunek 5: wartość krytyczna i obszar odrzucenia
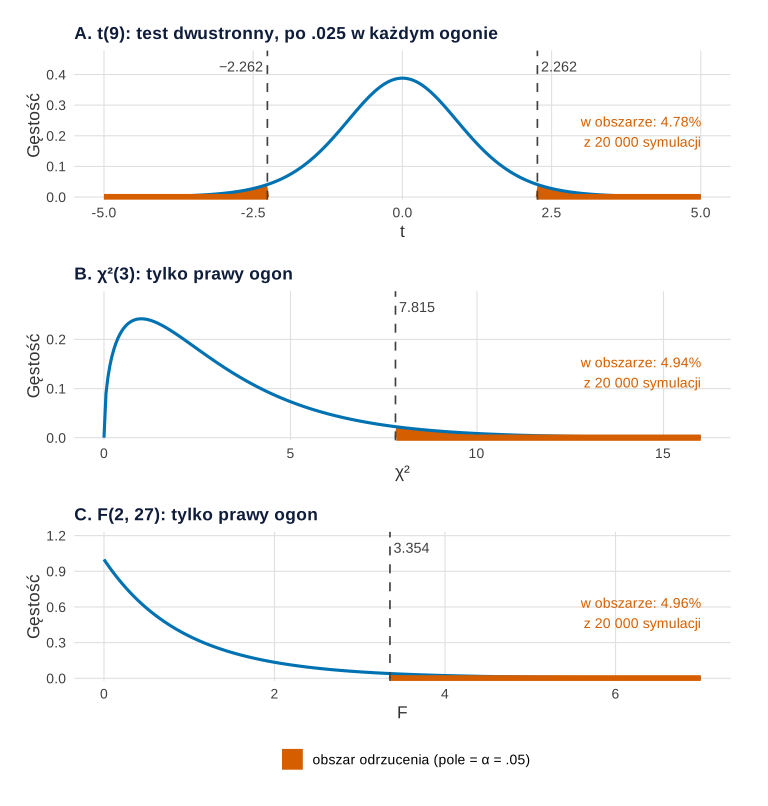
Co widać. Na każdym rozkładzie pole obszaru odrzucenia wynosi α = .05. W teście t dla jednej próby z 10 osobami (9 df) dzieli się je na dwa ogony po .025 poza ±2.262. W teście χ² i F obszar leży tylko w prawym ogonie, bo kłopot dla H0 to wyłącznie duże wartości. W symulacji przy prawdziwej H0 do obszaru trafiło 4.78% statystyk t z prób normalnych, 4.94% sum kwadratów z rysunku 1 i 4.96% statystyk F z rysunku 3 (błąd MC 0.15 pp). Odsetek 4.78% leży półtora błędu MC poniżej 5% – to zwykła losowość.
Czego ten wykres nie pokazuje. Wartości krytycznych dla Twoich df – te odczytasz z tablic rozkładów t, χ² i F (z kalkulatorem dla dowolnych df). Hasło wartość krytyczna wyjaśnia, jak decyzja przez próg odpowiada decyzji przez wartość p. Kiedy wolno umieścić całe α w jednym ogonie rozkładu t, opisuje hasło test jednostronny i dwustronny. Rysunek nie mówi też nic o mocy – to pole pod innym rozkładem.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: gdy dane nie są normalne
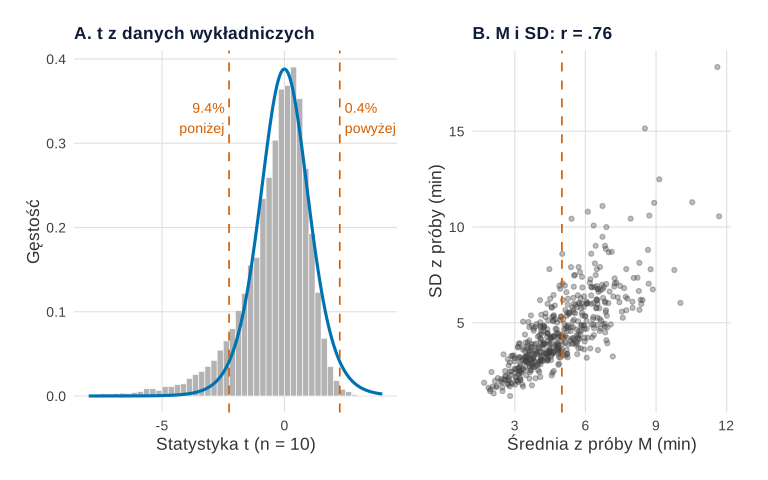
Co widać. Fikcyjny czas oczekiwania ma rozkład wykładniczy ze średnią 5 minut (skośność 2), a H0: μ = 5 jest prawdziwa. Histogram statystyki t nie pasuje do krzywej t(9): ma długi lewy ogon i krótki prawy (skośność −1.664). Dwustronny test przy α = .05 odrzucił H0 w 9.80% prób (błąd MC 0.21 pp): 9.41% w lewym ogonie i 0.38% w prawym. Jednostronny test „średnia mniejsza niż 5” odrzucał w 13.04% prób, a „większa niż 5” w 1.34%. Te same liczby dla populacji normalnej: 4.78%, 4.93% i 4.98%. Przyczynę widać w panelu B: w danych skośnych średnia i SD z próby są skorelowane (r = .76; w populacji normalnej .005). Gdy próba nie zawiera rzadkich dużych wartości, ma zarazem niską średnią i małe SD – a mała liczba w mianowniku wyolbrzymia ujemną różnicę. Rozpada się więc warunek z rysunku 2: licznik i mianownik nie są niezależne.
Czego ten wykres nie pokazuje. Że problem słabnie z liczebnością. Przy 40 osobach z tej samej populacji dwustronny test odrzucał w 6.67% prób, ale ogony wciąż były nierówne (5.82% wobec 0.86%). Boos i Hughes-Oliver (2000) pokazują, że to skośność populacji decyduje, jak duża musi być próba, by przedziały t miały właściwe pokrycie. Lumley i in. (2002) przypominają z kolei, że w dużych próbach test t jest trafny przy dowolnym rozkładzie. Pokrycie przedziałów przy skośnej populacji pokazujemy we wpisach przedział ufności w obrazkach i centralne twierdzenie graniczne. Przy małej, silnie skośnej próbie rozważ bootstrap albo test nieparametryczny – pamiętając, że odpowiadają na nieco inne pytanie.
Podpis do pracy:
Zdanie do pracy (ograniczenia przy małej, skośnej próbie):
Który rysunek gdzie w pracy
- Rozdział teoretyczny lub wprowadzenie do metod: rysunki 1–4. Wystarczy jeden – zwykle 2 albo 4 – z krótkim komentarzem o stopniach swobody.
- Metoda (plan analizy): zdanie z rysunku 5 o poziomie α i wartościach krytycznych, jeśli promotor ich wymaga. W Wynikach zamiast progu podaj dokładne p.
- Ograniczenia: rysunek 6 albo samo zdanie, gdy masz małą próbę i silnie skośną zmienną.
- Własna symulacja w pracy: zawsze liczba powtórzeń, ziarno i błąd Monte Carlo przy odsetkach.
Paletę sprawdziliśmy w symulacji deuteranopii i protanopii (przepis 7). Każdą informację niesie też typ linii, kształt albo etykieta. Inne „obrazkowe” wpisy z tej serii: moc testu i rozkład zmiennej na wykresie.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje paletę, motyw, liczbę powtórzeń R i funkcję blad_mc(), a przepisy 5 i 6 korzystają też z obiektów z przepisów 1 i 3. Każdy przepis z losowaniem zaczyna od set.seed(576). Każdy kończy się obiektem wykresu (p1–p6); do zapisu SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane są symulowane w kodzie, nic nie trzeba pobierać. Ręcznie wybrano tylko parametry przykładów: k = 1, 3 i 10 (rysunek 1), 3 df (rysunek 2), trzy grupy po 10 osób (rysunek 3), test t dla 10 osób (rysunek 5) i populację wykładniczą o średniej 5 przy n = 10 i 40 (rysunek 6). Liczba powtórzeń: 20 000 w każdej symulacji; cały kod liczy się w kilka sekund.
1. Motyw, paleta i χ² z sumy kwadratów: Rysunek 1
R
# Rysunek 1. Rozkład χ² z symulacji: suma kwadratów k niezależnych zmiennych z (k = 1, 3, 10)
library(ggplot2)

# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw) i prosty motyw
kol <- c(teoria = "#0072B2", akcent = "#D55E00", dane = "grey70", ciemny = "grey25",
         zielony = "#009E73", pomarancz = "#E69F00", fiolet = "#CC79A7")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", size = rel(1.0)), panel.grid.minor = element_blank(),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA))
R <- 20000                                    # liczba powtórzeń w każdej symulacji
blad_mc <- function(p, n = R) sqrt(p * (1 - p) / n)   # błąd Monte Carlo odsetka

set.seed(576)                                 # ziarno ustalone raz, bez dobierania pod wynik
ks <- c(1, 3, 10)
chi <- lapply(ks, function(k) {
  Z <- matrix(rnorm(R * k), nrow = R)         # R wierszy po k niezależnych zmiennych z
  rowSums(Z^2)                                # suma kwadratów w każdym wierszu
})
names(chi) <- paste0("k = ", ks)
chi3 <- chi[["k = 3"]]                        # przyda się w przepisach 3 i 5

# Średnia (teoria: k), wariancja (teoria: 2k) i odsetek ponad wartością krytyczną χ²(.95; k)
podsum1 <- t(sapply(seq_along(ks), function(i) {
  x <- chi[[i]]; k <- ks[i]; kr <- qchisq(.95, k); p <- mean(x > kr)
  c(k = k, srednia = mean(x), wariancja = var(x), krytyczna = kr,
    ponad_proc = 100 * p, blad_MC_pp = 100 * blad_mc(p))
}))
round(podsum1, 3)

# Histogram (gęstość) z symulacji i krzywa teoretyczna dchisq()
d1 <- do.call(rbind, lapply(seq_along(ks), function(i)
  data.frame(panel = names(chi)[i], x = chi[[i]][chi[[i]] < 30])))       # obcięcie osi do 30
krz1 <- do.call(rbind, lapply(ks, function(k) {
  x <- seq(0.02, 30, length.out = 400)
  data.frame(panel = paste0("k = ", k), x = x, y = pmin(dchisq(x, k), 1.2))
}))
d1$panel <- factor(d1$panel, levels = names(chi)); krz1$panel <- factor(krz1$panel, levels = names(chi))
p1 <- ggplot(d1, aes(x)) +
  geom_histogram(aes(y = after_stat(density), fill = "symulacja: suma k kwadratów z"),
                 binwidth = 0.5, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_line(data = krz1, aes(x, y, colour = "teoria: gęstość χ²(k)"), linewidth = 1.1) +
  facet_wrap(~ panel, ncol = 1, scales = "free_y") +
  scale_fill_manual(values = kol[["dane"]], name = NULL) +
  scale_colour_manual(values = kol[["teoria"]], name = NULL) +
  coord_cartesian(xlim = c(0, 30)) +
  labs(x = "Suma kwadratów k zmiennych z", y = "Gęstość",
       title = "Suma kwadratów k zmiennych z ma rozkład χ²(k)") + motyw
# p1   # wyświetl; zapis: ggsave("rozklady-chi-kwadrat-suma-kwadratow.svg", p1, width = 8, height = 7.4)
Wynik w R
      k srednia wariancja krytyczna ponad_proc blad_MC_pp
[1,]  1   1.010     2.051     3.841      5.135      0.156
[2,]  3   3.016     5.973     7.815      4.940      0.153
[3,] 10   9.962    19.918    18.307      4.925      0.153
2. Rozkład t z ilorazu z / √(χ²/k) i ze statystyki t: Rysunek 2
R
# Rysunek 2. Rozkład t z symulacji: z / √(χ²/k) i porównanie z rozkładem normalnym (kontynuacja: R, kol, motyw, blad_mc)
library(patchwork)
set.seed(576)
k <- 3
z  <- rnorm(R)                                # licznik: zmienna z
ch <- rowSums(matrix(rnorm(R * k), nrow = R)^2)   # mianownik: niezależny χ²(k)
t3 <- z / sqrt(ch / k)                        # z podzielone przez pierwiastek z (χ²/k)

# Ta sama konstrukcja ukryta w teście t: próba n = 4 z rozkładu normalnego, statystyka (M − μ)/(s/√n)
n <- 4
X <- matrix(rnorm(R * n, mean = 100, sd = 15), nrow = R)
t_proba <- (rowMeans(X) - 100) / (apply(X, 1, sd) / sqrt(n))
kwantyle <- c(.025, .05, .95, .975)
round(rbind(konstrukcja_z_chi2 = quantile(t3, kwantyle), statystyka_t_z_prob_n4 = quantile(t_proba, kwantyle),
            teoria_t3 = qt(kwantyle, 3), normalny_z = qnorm(kwantyle)), 3)

# Grube ogony: P(|T| > 1.96) w symulacji i w teorii; teoria dla kilku df
p_sym <- mean(abs(t3) > 1.96)
round(c(sym_t3_ponad_1.96 = p_sym, blad_MC = blad_mc(p_sym), teoria_t3 = 2 * pt(-1.96, 3)), 4)
ogony <- sapply(c(3, 10, 30, Inf), function(df) 2 * pt(-c(1.96, 3), df))
dimnames(ogony) <- list(c("P(|T| > 1.96)", "P(|T| > 3)"), c("df = 3", "df = 10", "df = 30", "normalny"))
round(ogony, 4)

# Panel A: histogram z symulacji, gęstość t(3) i gęstość normalna
xs <- seq(-5, 5, length.out = 401)
krz2 <- rbind(data.frame(x = xs, y = dt(xs, 3), krzywa = "t(3)"),
              data.frame(x = xs, y = dnorm(xs), krzywa = "normalny N(0, 1)"))
p2a <- ggplot(data.frame(t = t3[abs(t3) < 5]), aes(t)) +
  geom_histogram(aes(y = after_stat(density) * mean(abs(t3) < 5)), binwidth = 0.2, boundary = 0,
                 fill = kol[["dane"]], colour = "white", linewidth = 0.2) +
  geom_line(data = krz2, aes(x, y, colour = krzywa, linetype = krzywa), linewidth = 1.1) +
  scale_colour_manual(values = c("t(3)" = kol[["teoria"]], "normalny N(0, 1)" = kol[["akcent"]]), name = NULL) +
  scale_linetype_manual(values = c("t(3)" = "solid", "normalny N(0, 1)" = "dashed"), name = NULL) +
  labs(x = "z / √(χ²/3)", y = "Gęstość", title = "A. Symulacja i dwie krzywe") + motyw
# Panel B: pole w obu ogonach P(|T| > c) w skali logarytmicznej
cs <- seq(1.5, 5, by = 0.05)
og <- do.call(rbind, lapply(list(c(3, "df = 3"), c(10, "df = 10"), c(30, "df = 30"), c(Inf, "normalny")),
  function(a) data.frame(c = cs, p = 2 * pt(-cs, as.numeric(a[1])), rozklad = a[2])))
og$rozklad <- factor(og$rozklad, levels = c("df = 3", "df = 10", "df = 30", "normalny"))
p2b <- ggplot(og, aes(c, p, colour = rozklad, linetype = rozklad)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = data.frame(c = 1.96, p = p_sym, rozklad = factor("df = 3", levels = levels(og$rozklad))),
             shape = 17, size = 3.2, show.legend = FALSE) +
  scale_y_log10(breaks = c(.0001, .001, .01, .05, .2), labels = c(".0001", ".001", ".01", ".05", ".2")) +
  scale_colour_manual(values = c(kol[["teoria"]], kol[["zielony"]], kol[["pomarancz"]], kol[["akcent"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash", "dashed"), name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Próg c", y = "P(|T| > c), skala log", title = "B. Pole w ogonach") + motyw
p2 <- p2a + p2b
# p2   # zapis: ggsave("rozklady-t-grube-ogony.svg", p2, width = 8, height = 5.2)
Wynik w R
                         2.5%     5%   95% 97.5%
konstrukcja_z_chi2     -3.099 -2.351 2.341 3.239
statystyka_t_z_prob_n4 -3.158 -2.358 2.376 3.289
teoria_t3              -3.182 -2.353 2.353 3.182
normalny_z             -1.960 -1.645 1.645 1.960
sym_t3_ponad_1.96           blad_MC         teoria_t3
           0.1454            0.0025            0.1449
              df = 3 df = 10 df = 30 normalny
P(|T| > 1.96) 0.1449  0.0784  0.0593   0.0500
P(|T| > 3)    0.0577  0.0133  0.0054   0.0027
3. Rozkład F: iloraz dwóch χ² i statystyka F z ANOVA: Rysunek 3
R
# Rysunek 3. Rozkład F z symulacji: (χ²₁/d₁)/(χ²₂/d₂) i statystyka F z jednoczynnikowej ANOVA (kontynuacja: R, kol, motyw, blad_mc)
set.seed(576)
d1f <- 2; d2f <- 27                           # jak w ANOVA: 3 grupy po 10 osób → df = 2 i 27
F_konstr <- (rowSums(matrix(rnorm(R * d1f), nrow = R)^2) / d1f) /
            (rowSums(matrix(rnorm(R * d2f), nrow = R)^2) / d2f)

# ANOVA przy prawdziwej H0: trzy grupy po 10 osób z tej samej populacji (M = 50, SD = 10)
g <- 3; ng <- 10
Y <- array(rnorm(R * g * ng, mean = 50, sd = 10), dim = c(R, ng, g))   # [powtórzenie, osoba, grupa]
sr_gr  <- apply(Y, c(1, 3), mean)                                       # średnie grup
sr_ogl <- rowMeans(sr_gr)
SS_miedzy <- ng * rowSums((sr_gr - sr_ogl)^2)
SS_wewn   <- rowSums(sapply(1:g, function(j) rowSums((Y[, , j] - sr_gr[, j])^2)))
F_anova <- (SS_miedzy / (g - 1)) / (SS_wewn / (g * ng - g))
# kontrola na pierwszym powtórzeniu: ten sam F co w aov()
dane1 <- data.frame(y = as.vector(Y[1, , ]), grupa = factor(rep(1:g, each = ng)))
round(c(F_recznie = F_anova[1], F_aov = summary(aov(y ~ grupa, dane1))[[1]][["F value"]][1]), 4)

kr_F <- qf(.95, d1f, d2f)
p_k <- mean(F_konstr > kr_F); p_a <- mean(F_anova > kr_F)
round(c(krytyczna_F = kr_F, konstrukcja_ponad_proc = 100 * p_k, blad_MC_pp = 100 * blad_mc(p_k),
        anova_ponad_proc = 100 * p_a, blad_MC_pp = 100 * blad_mc(p_a),
        srednia_konstr = mean(F_konstr), srednia_anova = mean(F_anova), srednia_teoria = d2f / (d2f - 2)), 3)

d3 <- rbind(data.frame(F = F_konstr, zrodlo = "A. (χ²(2)/2) / (χ²(27)/27)"),
            data.frame(F = F_anova, zrodlo = "B. F z ANOVA: 3 grupy po 10, H0 prawdziwa"))
d3 <- d3[d3$F < 8, ]
xs <- seq(0.01, 8, length.out = 400)
krz3 <- data.frame(x = xs, y = df(xs, d1f, d2f))
p3 <- ggplot(d3, aes(F)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.2, boundary = 0,
                 fill = kol[["dane"]], colour = "white", linewidth = 0.2) +
  geom_line(data = krz3, aes(x, y), colour = kol[["teoria"]], linewidth = 1.1) +
  geom_vline(xintercept = kr_F, linetype = "dashed", colour = kol[["akcent"]], linewidth = 0.8) +
  annotate("text", x = kr_F + 0.15, y = 0.75, hjust = 0, size = 3.9, colour = kol[["akcent"]],
           label = sprintf("F krytyczne = %.2f", kr_F)) +
  facet_wrap(~ zrodlo, ncol = 1) +
  labs(x = "Wartość F", y = "Gęstość", title = "Dwie drogi do tego samego rozkładu F(2, 27)",
       subtitle = "Słupki: 20 000 symulacji; niebieska krzywa: gęstość F(2, 27)") + motyw
# p3   # zapis: ggsave("rozklady-f-iloraz-chi-kwadrat-i-anova.svg", p3, width = 8, height = 6.6)
Wynik w R
F_recznie     F_aov
   0.3359    0.3359
           krytyczna_F konstrukcja_ponad_proc             blad_MC_pp
                 3.354                  5.040                  0.155
      anova_ponad_proc             blad_MC_pp         srednia_konstr
                 4.960                  0.154                  1.087
         srednia_anova         srednia_teoria
                 1.077                  1.080
4. Kształt rozkładów a stopnie swobody: Rysunek 4
R
# Rysunek 4. Kształt rozkładów χ², t i F a stopnie swobody (same krzywe teoretyczne; kontynuacja: kol, motyw)
library(patchwork)
pal5 <- unname(kol[c("teoria", "akcent", "zielony", "pomarancz", "ciemny")])
lt5 <- c("solid", "dashed", "dotdash", "longdash", "dotted")
krzywe <- function(x, fun, etykiety) {
  d <- do.call(rbind, lapply(seq_along(fun), function(i) data.frame(x = x, y = fun[[i]](x), df = etykiety[i])))
  d$df <- factor(d$df, levels = etykiety); d
}
# χ²: k = 1, 2, 4, 8, 16 – średnia k, wariancja 2k
c4 <- krzywe(seq(0.05, 30, length.out = 400), lapply(c(1, 2, 4, 8, 16), function(k) function(x) dchisq(x, k)),
             paste0("k = ", c(1, 2, 4, 8, 16)))
p4a <- ggplot(c4, aes(x, pmin(y, 0.5), colour = df, linetype = df)) + geom_line(linewidth = 1) +
  scale_colour_manual(values = pal5, name = NULL) + scale_linetype_manual(values = lt5, name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "χ²", y = "Gęstość", title = "A. χ²(k)") + motyw
# t: df = 1, 3, 10, 30 i rozkład normalny
t4 <- krzywe(seq(-5, 5, length.out = 400),
             c(lapply(c(1, 3, 10, 30), function(v) function(x) dt(x, v)), list(function(x) dnorm(x))),
             c("df = 1", "df = 3", "df = 10", "df = 30", "normalny"))
p4b <- ggplot(t4, aes(x, y, colour = df, linetype = df)) + geom_line(linewidth = 1) +
  scale_colour_manual(values = pal5, name = NULL) + scale_linetype_manual(values = lt5, name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "t", y = "Gęstość", title = "B. t(df)") + motyw
# F: kilka par (d₁, d₂)
pary <- list(c(1, 10), c(2, 27), c(5, 50), c(10, 100), c(20, 20))
f4 <- krzywe(seq(0.02, 5, length.out = 400), lapply(pary, function(p) function(x) df(x, p[1], p[2])),
             sapply(pary, function(p) sprintf("F(%d, %d)", p[1], p[2])))
p4c <- ggplot(f4, aes(x, pmin(y, 1.5), colour = df, linetype = df)) + geom_line(linewidth = 1) +
  scale_colour_manual(values = pal5, name = NULL) + scale_linetype_manual(values = lt5, name = NULL) +
  guides(colour = guide_legend(nrow = 1), linetype = guide_legend(nrow = 1)) +
  labs(x = "F", y = "Gęstość", title = "C. F(d₁, d₂)") + motyw
p4 <- (p4a + p4b) / p4c

# Liczby do opisu: średnia i SD χ²(k), wariancja t, wartości krytyczne przy α = .05
round(sapply(c(1, 2, 4, 8, 16), function(k) c(k = k, srednia = k, SD = sqrt(2 * k), skosnosc = sqrt(8 / k),
                                             kryt_05 = qchisq(.95, k))), 3)
round(sapply(c(1, 3, 10, 30, Inf), function(v) c(df = v, wariancja = if (is.infinite(v)) 1 else if (v > 2) v / (v - 2) else NA,
                                               kryt_dwustronna = qt(.975, v))), 3)
round(sapply(pary, function(p) c(d1 = p[1], d2 = p[2], kryt_05 = qf(.95, p[1], p[2]))), 3)
# p4   # zapis: ggsave("rozklady-ksztalt-a-stopnie-swobody.svg", p4, width = 8, height = 7.6)
Wynik w R
          [,1]  [,2]  [,3]   [,4]   [,5]
k        1.000 2.000 4.000  8.000 16.000
srednia  1.000 2.000 4.000  8.000 16.000
SD       1.414 2.000 2.828  4.000  5.657
skosnosc 2.828 2.000 1.414  1.000  0.707
kryt_05  3.841 5.991 9.488 15.507 26.296
                  [,1]  [,2]   [,3]   [,4] [,5]
df               1.000 3.000 10.000 30.000  Inf
wariancja           NA 3.000  1.250  1.071 1.00
kryt_dwustronna 12.706 3.182  2.228  2.042 1.96
          [,1]   [,2] [,3]    [,4]   [,5]
d1       1.000  2.000  5.0  10.000 20.000
d2      10.000 27.000 50.0 100.000 20.000
kryt_05  4.965  3.354  2.4   1.927  2.124
5. Wartość krytyczna i obszar odrzucenia: Rysunek 5
R
# Rysunek 5. Wartość krytyczna i obszar odrzucenia na rozkładach t(9), χ²(3) i F(2, 27), α = .05
# (kontynuacja: R, kol, motyw, blad_mc, chi3 z przepisu 1, F_anova z przepisu 3)
library(patchwork)
set.seed(576)
n <- 10                                       # test t dla jednej próby: n = 10 → df = 9
X <- matrix(rnorm(R * n, mean = 100, sd = 15), nrow = R)
t_norm <- (rowMeans(X) - 100) / (apply(X, 1, sd) / sqrt(n))   # H0 prawdziwa (μ = 100)

kr <- c(t = qt(.975, 9), chi2 = qchisq(.95, 3), F = qf(.95, 2, 27))
odsetki <- c(t_dwustronnie = mean(abs(t_norm) > kr[["t"]]), chi2_prawy = mean(chi3 > kr[["chi2"]]),
             F_prawy = mean(F_anova > kr[["F"]]))
round(rbind(krytyczna = kr, w_obszarze_proc = 100 * odsetki, blad_MC_pp = 100 * blad_mc(odsetki)), 3)

rysuj_obszar <- function(x, y, w_obszarze, kryt, sym_proc, tytul, os_x) {
  d <- data.frame(x = x, y = y, obszar = w_obszarze)
  ogon <- d[d$obszar, ]
  ggplot(d, aes(x, y)) +
    geom_area(data = transform(d, y = ifelse(obszar, y, 0)), aes(fill = "obszar odrzucenia (pole = α = .05)")) +
    geom_line(colour = kol[["teoria"]], linewidth = 1.1) +
    geom_line(data = transform(ogon, y = 0), aes(group = x > 0), colour = kol[["akcent"]], linewidth = 2.2) +   # zasięg obszaru na osi
    geom_vline(xintercept = kryt, linetype = "dashed", colour = kol[["ciemny"]]) +
    annotate("text", x = kryt, y = max(y) * 1.1, hjust = ifelse(kryt < 0, 1.1, -0.1),
             label = sub("-", "−", sprintf("%.3f", kryt)), size = 3.8, colour = kol[["ciemny"]]) +
    annotate("text", x = max(x), y = max(y) * 0.55, hjust = 1, size = 3.7, colour = kol[["akcent"]],
             label = sprintf("w obszarze: %.2f%%\nz 20 000 symulacji", sym_proc)) +
    scale_fill_manual(values = kol[["akcent"]], name = NULL) +
    scale_y_continuous(expand = expansion(mult = c(0.02, 0.12))) +
    labs(x = os_x, y = "Gęstość", title = tytul) + motyw
}
xt <- seq(-5, 5, length.out = 301)
p5a <- rysuj_obszar(xt, dt(xt, 9), abs(xt) >= kr[["t"]], c(-1, 1) * kr[["t"]], 100 * odsetki[[1]],
                    "A. t(9): test dwustronny, po .025 w każdym ogonie", "t")
xc <- seq(0, 16, length.out = 301)
p5b <- rysuj_obszar(xc, dchisq(xc, 3), xc >= kr[["chi2"]], kr[["chi2"]], 100 * odsetki[[2]],
                    "B. χ²(3): tylko prawy ogon", "χ²")
xf <- seq(0, 7, length.out = 301)
p5c <- rysuj_obszar(xf, df(xf, 2, 27), xf >= kr[["F"]], kr[["F"]], 100 * odsetki[[3]],
                    "C. F(2, 27): tylko prawy ogon", "F")
p5 <- p5a / p5b / p5c + plot_layout(guides = "collect") & theme(legend.position = "bottom")
# p5   # zapis: ggsave("rozklady-wartosc-krytyczna-obszar-odrzucenia.svg", p5, width = 8, height = 8.4)
Wynik w R
                    t  chi2     F
krytyczna       2.262 7.815 3.354
w_obszarze_proc 4.780 4.940 4.960
blad_MC_pp      0.151 0.153 0.154
6. Statystyka t przy populacji wykładniczej: Rysunek 6
R
# Rysunek 6. Statystyka t, gdy dane nie są normalne: populacja wykładnicza, n = 10
# (kontynuacja: R, kol, motyw, blad_mc, t_norm i X z przepisu 5)
library(patchwork)
set.seed(576)
mu_w <- 5                                     # fikcyjny czas oczekiwania (min): rozkład wykładniczy, średnia 5, skośność 2
n <- 10
W <- matrix(rexp(R * n, rate = 1 / mu_w), nrow = R)
M_w <- rowMeans(W); s_w <- apply(W, 1, sd)
t_wykl <- (M_w - mu_w) / (s_w / sqrt(n))      # H0 prawdziwa: μ = 5
kr9 <- qt(.975, 9); kr9_1 <- qt(.95, 9)

# Odsetki odrzuceń przy α = .05 (nominalnie 5% dwustronnie i 5% w każdym teście jednostronnym)
bledy <- function(t) c(dwustronny = mean(abs(t) > kr9), lewy_ogon_2.5 = mean(t < -kr9), prawy_ogon_2.5 = mean(t > kr9),
                       jednostronny_mniej = mean(t < -kr9_1), jednostronny_wiecej = mean(t > kr9_1))
tab6 <- rbind(normalna = bledy(t_norm), wykladnicza = bledy(t_wykl))
round(100 * tab6, 2)
round(100 * blad_mc(tab6), 2)                 # błędy Monte Carlo (pp)
# Dlaczego: w populacji normalnej średnia i SD z próby są niezależne, w skośnej – nie
round(c(r_M_s_normalna = cor(rowMeans(X), apply(X, 1, sd)), r_M_s_wykladnicza = cor(M_w, s_w),
        skosnosc_t_normalna = mean(scale(t_norm)^3), skosnosc_t_wykladnicza = mean(scale(t_wykl)^3)), 3)
# Ta sama populacja, n = 40: test dwustronny i oba ogony
W40 <- matrix(rexp(R * 40, rate = 1 / mu_w), nrow = R)
t40 <- (rowMeans(W40) - mu_w) / (apply(W40, 1, sd) / sqrt(40)); kr39 <- qt(.975, 39)
round(100 * c(dwustronny = mean(abs(t40) > kr39), lewy_ogon_2.5 = mean(t40 < -kr39), prawy_ogon_2.5 = mean(t40 > kr39)), 2)

# Panel A: histogram t z populacji wykładniczej i krzywa t(9)
xs <- seq(-8, 4, length.out = 400)
p6a <- ggplot(data.frame(t = t_wykl[t_wykl > -8 & t_wykl < 4]), aes(t)) +
  geom_histogram(aes(y = after_stat(density) * mean(t_wykl > -8 & t_wykl < 4)), binwidth = 0.25, boundary = 0,
                 fill = kol[["dane"]], colour = "white", linewidth = 0.2) +
  geom_line(data = data.frame(x = xs, y = dt(xs, 9)), aes(x, y), colour = kol[["teoria"]], linewidth = 1.1) +
  geom_vline(xintercept = c(-1, 1) * kr9, linetype = "dashed", colour = kol[["akcent"]]) +
  annotate("text", x = -kr9 - 0.2, y = 0.33, hjust = 1, size = 3.7, colour = kol[["akcent"]],
           label = sprintf("%.1f%%\nponiżej", 100 * tab6["wykladnicza", "lewy_ogon_2.5"])) +
  annotate("text", x = kr9 + 0.2, y = 0.33, hjust = 0, size = 3.7, colour = kol[["akcent"]],
           label = sprintf("%.1f%%\npowyżej", 100 * tab6["wykladnicza", "prawy_ogon_2.5"])) +
  labs(x = "Statystyka t (n = 10)", y = "Gęstość", title = "A. t z danych wykładniczych") + motyw
# Panel B: średnia i SD w 500 pierwszych próbach (linia przerywana: μ = 5)
p6b <- ggplot(data.frame(M = M_w[1:500], s = s_w[1:500]), aes(M, s)) +
  geom_point(colour = kol[["ciemny"]], alpha = 0.35, size = 1.4) +
  geom_vline(xintercept = mu_w, linetype = "dashed", colour = kol[["akcent"]]) +
  labs(x = "Średnia z próby M (min)", y = "SD z próby (min)",
       title = paste0("B. M i SD: r = ", sub("^0", "", sprintf("%.2f", cor(M_w, s_w))))) + motyw
p6 <- p6a + p6b + plot_layout(widths = c(1.25, 1))
# p6   # zapis: ggsave("rozklady-t-skosna-populacja-n10.svg", p6, width = 8, height = 5)
Wynik w R
            dwustronny lewy_ogon_2.5 prawy_ogon_2.5 jednostronny_mniej
normalna          4.78          2.43           2.35               4.93
wykladnicza       9.80          9.41           0.38              13.04
            jednostronny_wiecej
normalna                   4.98
wykladnicza                1.34
            dwustronny lewy_ogon_2.5 prawy_ogon_2.5 jednostronny_mniej
normalna          0.15          0.11           0.11               0.15
wykladnicza       0.21          0.21           0.04               0.24
            jednostronny_wiecej
normalna                   0.15
wykladnicza                0.08
        r_M_s_normalna      r_M_s_wykladnicza    skosnosc_t_normalna
                 0.005                  0.761                  0.028
skosnosc_t_wykladnicza
                -1.664
    dwustronny  lewy_ogon_2.5 prawy_ogon_2.5
          6.67           5.82           0.86
7. Kontrola palety: deuteranopia i protanopia
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace (kontynuacja: kol)
library(colorspace)
pary <- list("niebieski – cynober (teoria / obszar odrzucenia)" = kol[c("teoria", "akcent")],
             "niebieski – szary (krzywa / słupki)" = kol[c("teoria", "dane")],
             "zielony – pomarańcz (df = 10 / df = 30)" = kol[c("zielony", "pomarancz")],
             "cynober – zielony (normalny / df = 10)" = kol[c("akcent", "zielony")],
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {                      # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                                 widzenie_typowe deuteranopia
niebieski – cynober (teoria / obszar odrzucenia)           114.6        108.3
niebieski – szary (krzywa / słupki)                         49.5         53.4
zielony – pomarańcz (df = 10 / df = 30)                     88.7         66.3
cynober – zielony (normalny / df = 10)                     102.4         53.5
czerwony – zielony (do unikania)                           121.7         21.1
                                                 protanopia
niebieski – cynober (teoria / obszar odrzucenia)       91.9
niebieski – szary (krzywa / słupki)                    44.9
zielony – pomarańcz (df = 10 / df = 30)                51.5
cynober – zielony (normalny / df = 10)                 37.3
czerwony – zielony (do unikania)                       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, gęstości, kwantyle i aov() – pakiety stats i base). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Próg 1.96 przy małej próbie. Przy 3 df daje rzeczywiste α = .145 (rysunek 2).
- Dzielenie p przez 2 w teście χ² albo F. Te testy już są prawostronne (rysunek 5).
- Zamienione df w F. F(2, 27) to nie F(27, 2) – podawaj df licznika i mianownika (rysunek 4).
- Stopnie swobody utożsamione z liczebnością. W teście χ² niezależności zależą od liczby kategorii, a nie od N.
- Wiara, że rozkład z tablic „działa zawsze”. Opisuje statystykę tylko przy spełnionych założeniach; przy małej skośnej próbie test t chybia w jednym ogonie (rysunek 6).
- Symulacja bez ziarna, liczby powtórzeń i błędu Monte Carlo.
Najczęstsze pytania
Jaki jest związek między rozkładem t, chi-kwadrat i F?
Wszystkie trzy powstają ze zmiennych o standardowym rozkładzie normalnym. Suma kwadratów k niezależnych zmiennych z ma rozkład χ²(k); zmienna z podzielona przez √(χ²/k) – rozkład t(k); iloraz (χ²₁/d₁)/(χ²₂/d₂) – rozkład F(d₁, d₂). Stąd kwadrat zmiennej t(k) ma rozkład F(1, k).
Skąd się biorą grube ogony rozkładu t?
Bo w mianowniku statystyki t stoi odchylenie standardowe z próby, które samo jest losowe i bywa zaniżone. Gdy jest za małe, iloraz wychodzi duży. W symulacji z 3 stopniami swobody wynik |t| > 1.96 pojawił się w 14.54% prób, a w rozkładzie normalnym zdarza się w 5%. Przy 30 df ten odsetek spada do 5.93%.
Czy rozkład chi-kwadrat jest zawsze prawoskośny?
Tak, bo suma kwadratów nie może być ujemna. Skośność wynosi jednak √(8/k): 2.83 przy k = 1 i 0.71 przy k = 16, więc przy wielu stopniach swobody rozkład coraz bardziej przypomina normalny. Średnia równa się k, a wariancja 2k.
Skąd się bierze rozkład F w analizie wariancji?
Gdy H0 jest prawdziwa, a dane są normalne o równych wariancjach, suma kwadratów międzygrupowa i wewnątrzgrupowa podzielone przez wariancję populacji to dwie niezależne zmienne χ². Statystyka F jest ilorazem tych zmiennych podzielonych przez ich df. W symulacji 20 000 jednoczynnikowych ANOVA (3 grupy po 10 osób) histogram F pokrył się z krzywą F(2, 27), a 4.96% wyników przekroczyło wartość krytyczną 3.354.
Co się dzieje z testem t, gdy dane nie mają rozkładu normalnego?
Statystyka t przestaje mieć rozkład t. Przy populacji wykładniczej i 10 osobach dwustronny test przy α = .05 odrzucał prawdziwą H0 w 9.80% prób, z czego 9.41% w lewym ogonie, a tylko 0.38% w prawym. Przy 40 osobach odsetek spadł do 6.67%. Przy dużych próbach test t jest trafny także przy nienormalnych danych (Lumley i in., 2002), ale przy małej, silnie skośnej próbie traktuj p ostrożnie.
Powiązane hasła
Przeczytaj też
Tablice rozkładów t, χ², F i z
Wartości krytyczne t, χ², F i z policzone w R oraz kalkulator wartości krytycznej i p dla dowolnych df z wykresem obszaru odrzucenia.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →PoradnikPrzedział ufności w obrazkach
Sto przedziałów na jednym wykresie, szerokość a liczebność, poziom ufności, skośne dane, SD i przedział predykcji – sześć symulacji z kodem R.
Czytaj →Nie wiesz, z którym rozkładem porównać swoją statystykę?
Pomożemy dobrać test do danych, sprawdzić założenia i opisać wyniki tak, żebyś umiał(a) wyjaśnić na obronie, skąd się wzięły stopnie swobody i wartość p.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Boos, D. D., & Hughes-Oliver, J. M. (2000). How large does n have to be for Z and t intervals? The American Statistician, 54(2), 121–128. https://doi.org/10.1080/00031305.2000.10474524
- Forbes, C., Evans, M., Hastings, N., & Peacock, B. (2010). Statistical distributions (4th ed.). Wiley. https://doi.org/10.1002/9780470627242
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Zabell, S. L. (2008). On Student’s 1908 article “The probable error of a mean”. Journal of the American Statistical Association, 103(481), 1–7. https://doi.org/10.1198/016214508000000030
Cytowania BibTeX
@article{boos2000how, author={Boos, Dennis D. and Hughes-Oliver, Jacqueline M.}, title={{How large does n have to be for Z and t intervals?}}, journal={The American Statistician}, year={2000}, volume={54}, number={2}, pages={121--128}, doi={10.1080/00031305.2000.10474524}}@book{forbes2010statistical, author={Forbes, Catherine and Evans, Merran and Hastings, Nicholas and Peacock, Brian}, title={{Statistical distributions (4th ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470627242}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{pearson1900criterion, author={Pearson, Karl}, title={{On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling}}, journal={The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science}, year={1900}, volume={50}, number={302}, pages={157--175}, doi={10.1080/14786440009463897}}@article{student1908probable, author={{Student}}, title={{The probable error of a mean}}, journal={Biometrika}, year={1908}, volume={6}, number={1}, pages={1--25}, doi={10.1093/biomet/6.1.1}}@article{zabell2008student, author={Zabell, S. L.}, title={{On Student’s 1908 article “The probable error of a mean”}}, journal={Journal of the American Statistical Association}, year={2008}, volume={103}, number={481}, pages={1--7}, doi={10.1198/016214508000000030}}