hist() w R tnie co 5 minut, a reguła Wanda – co 1.9 minuty. Przesunięcie granic o 2 minuty potrafi skasować drugi garb, a za szerokie pasmo gęstości kładzie 4.65% krzywej na ujemnym czasie. ECDF nie ma parametrów: odczytasz z niej medianę (12.1 min) i odsetek osób do progu (58.75% do 15 minut). Dla wyniku skali Likerta rysuj słupki – krzywa gęstości ukryła sufit, który osiągnęło 19.75% osób.Jeden rozkład, trzy rodzaje wykresów
Zanim policzysz średnią, warto zobaczyć, jak rozkładają się wyniki. Do tego służą trzy wykresy: histogram, krzywa gęstości (estymator jądrowy gęstości) i dystrybuanta empiryczna (ECDF). Definicje są w słowniku, a tu pokazujemy, jak każdy z tych wykresów może pokazać ten sam zbiór danych inaczej. Histogram zależy od szerokości przedziału i od tego, gdzie zaczyna się pierwszy przedział. Krzywa gęstości zależy od szerokości pasma. ECDF nie ma żadnego parametru do ustawienia, ale trudniej z niej odczytać kształt rozkładu.
Dane są fikcyjne i wygenerowane w R (ziarno 577, ustalone raz). Parametry rozkładów (mediany, rozproszenie, liczebności grup) i skali, a także progi do odczytu, ustawiliśmy ręcznie tak, żeby dwa garby i efekt sufitu były wyraźnie widoczne; ziarna nie zmienialiśmy. 400 osób wypełniło ankietę online: 230 na telefonie, 170 na komputerze. Pierwsza zmienna to czas wypełniania w minutach. Jest prawostronnie skośna i ma dwa garby, bo każde urządzenie ma inny typowy czas. Mediana wynosi 12.1 min, średnia 14.57 min, a zakres – od 4.1 do 42.3 min. Druga zmienna to wynik sumaryczny skali satysfakcji (5 pozycji 1–5, zakres 5–25) z efektem sufitu. Normalności i wykresu Q-Q tu nie omawiamy – opisują je wpis jak sprawdzić normalność rozkładu i hasło wykres kwantylowy (Q-Q). Ogólne zasady (podpis, osie, eksport) są we wpisie wykresy w pracy dyplomowej.
Rysunek 1: cztery szerokości przedziału
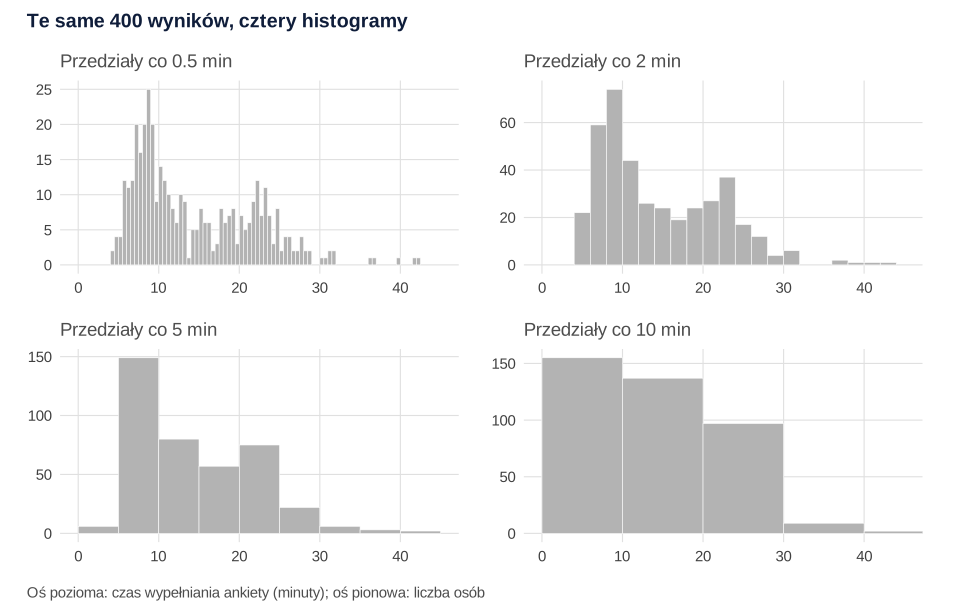
set.seed(577)).Co widać. To jeden zbiór liczb, a obrazy wyglądają jak cztery różne rozkłady. Przy przedziałach co 0.5 min jest ich 85, a słupek wyższy od obu sąsiadów pojawia się 14 razy – to w większości szum. Przy 2 min (22 przedziały) widać dwa wyraźne garby, wokół 9 i 23 minut, i kilka drobnych nierówności. Przy 5 min (9 przedziałów) drugi garb to tylko 75 osób po 57 osobach w poprzednim przedziale. Przy 10 min zostaje jeden schodek: 155, 137, 97 osób. Z takiego obrazu nikt nie zgadnie, że w danych są dwie grupy.
Czego ten wykres nie pokazuje. Nie mówi, która szerokość jest „prawdziwa”, bo żadna nie jest. Wąskie przedziały pokazują przypadkowe wahania, szerokie zlewają podgrupy. Pionowe osie mają różne skale (najwyższy słupek: 25, 74, 149 i 155 osób), więc wysokości słupków między panelami porównuj ostrożnie. Hasło histogram pokazuje to samo na innym przykładzie. Tu idziemy dalej: do reguł, punktu startowego i dwóch pozostałych wykresów.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 1: dane i cztery histogramy
Kod uruchamiaj po kolei w jednej sesji R – kolejne bloki korzystają z obiektów z bloku 1 (dane, motyw motyw, paleta kol, funkcja hist_w()). Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG (w kodzie – zakomentowane wywołanie ggsave()). Dane z bloku 1 pobierzesz jako plik rozklad-zmiennej-dane.csv (dane symulowane: id, urządzenie, czas w minutach, wynik skali satysfakcji).
1. Motyw, paleta, dane i cztery szerokości przedziału
R
# Rysunek 1. Ten sam zbiór, cztery szerokości przedziału (dane fikcyjne: czas wypełniania ankiety online)
library(ggplot2)
library(patchwork)

# Motyw i paleta (Okabe–Ito: niebieski i cynober są rozróżnialne także przy deuteranopii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0),
        legend.position = "bottom", plot.caption = element_text(colour = "grey30", hjust = 0),
        plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol <- c(telefon = "#0072B2", komputer = "#D55E00", jasny = "#56B4E9", slupek = "grey70", ciemny = "grey25")

set.seed(577)                                   # ziarno ustalone raz, bez dobierania pod wynik
n_tel <- 230; n_komp <- 170                     # 400 osób: ankieta na telefonie albo na komputerze
czas <- round(c(rlnorm(n_tel, log(9), 0.30), rlnorm(n_komp, log(21), 0.25)), 1)   # minuty, prawostronnie skośne
urzadzenie <- factor(rep(c("telefon", "komputer"), c(n_tel, n_komp)), levels = c("telefon", "komputer"))
# skala satysfakcji: suma 5 pozycji 1–5 (zakres 5–25), większość odpowiedzi blisko maksimum
cecha <- rnorm(n_tel + n_komp)
pozycje <- sapply(1:5, function(j) pmin(5, pmax(1, round(4.5 + 0.9 * cecha + rnorm(n_tel + n_komp, 0, 0.7)))))
satysfakcja <- rowSums(pozycje)
dane <- data.frame(id = 1:400, urzadzenie, czas, satysfakcja)
# write.csv(dane, "rozklad-zmiennej-dane.csv", row.names = FALSE)

round(c(n = length(czas), min = min(czas), Q1 = unname(quantile(czas, .25)), mediana = median(czas),
        srednia = mean(czas), Q3 = unname(quantile(czas, .75)), max = max(czas), SD = sd(czas)), 2)

# ile przedziałów i ile „szczytów” (słupków wyższych od obu sąsiadów) daje każda szerokość
szerokosci <- c(0.5, 2, 5, 10)
opis <- t(sapply(szerokosci, function(w) {
  h <- hist(czas, breaks = seq(0, ceiling(max(czas) / w) * w, by = w), plot = FALSE)
  k <- h$counts; wierzch <- which(diff(sign(diff(c(0, k, 0)))) == -2)
  c(szerokosc_min = w, przedzialy = length(k), szczyty = length(wierzch), najwyzszy_slupek = max(k))
}))
opis
hist(czas, breaks = seq(0, 45, by = 5), plot = FALSE)$counts    # liczebności w przedziałach co 5 minut

hist_w <- function(w, x = czas) {                # jeden histogram o zadanej szerokości przedziału
  ggplot(data.frame(x), aes(x)) +
    geom_histogram(binwidth = w, boundary = 0, fill = kol[["slupek"]], colour = "white", linewidth = 0.2) +
    scale_x_continuous(breaks = seq(0, 45, 10)) + coord_cartesian(xlim = c(0, 45)) +
    labs(subtitle = paste("Przedziały co", w, "min"), x = NULL, y = NULL) + motyw
}
p1 <- wrap_plots(lapply(szerokosci, hist_w), ncol = 2) +
  plot_annotation(title = "Te same 400 wyników, cztery histogramy",
                  caption = "Oś pozioma: czas wypełniania ankiety (minuty); oś pionowa: liczba osób", theme = motyw)
# p1   # wyświetl; zapis: ggsave("rozklad-zmiennej-cztery-szerokosci.svg", p1, width = 10, height = 6.4)
Wynik w R
      n     min      Q1 mediana srednia      Q3     max      SD
 400.00    4.10    8.50   12.10   14.57   20.62   42.30    7.41
     szerokosc_min przedzialy szczyty najwyzszy_slupek
[1,]           0.5         85      14               25
[2,]           2.0         22       4               74
[3,]           5.0          9       2              149
[4,]          10.0          5       1              155
[1]   6 149  80  57  75  22   6   3   2
Rysunek 2: reguły szerokości i punkt startowy
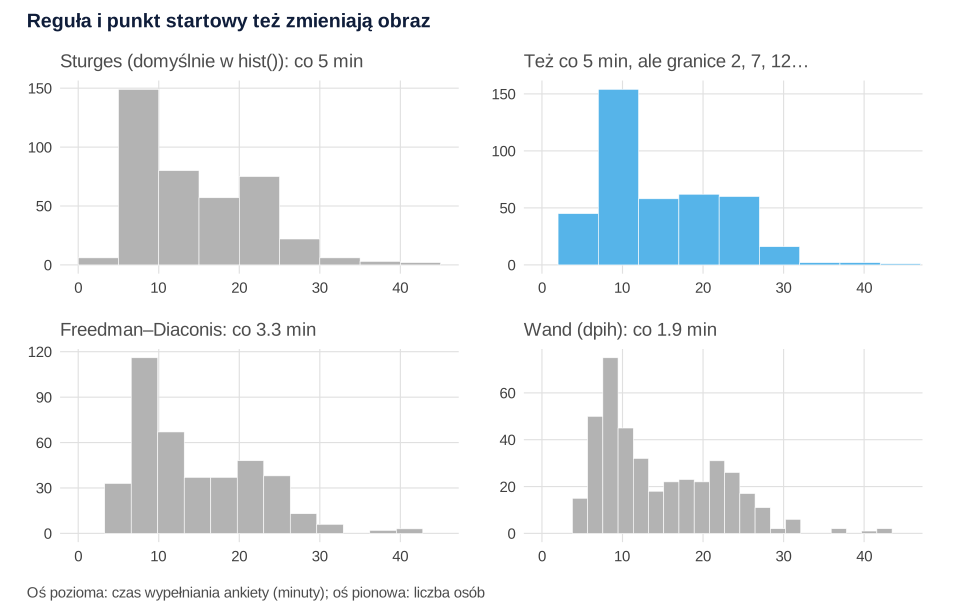
Co widać. Reguła Sturgesa wyznacza liczbę przedziałów z log₂n + 1 (Sturges, 1926) – dla 400 osób jest to 10 przedziałów. Funkcja hist() w R stosuje ją domyślnie i zaokrągla granice do „ładnych” liczb, więc tnie co 5 minut (panel u góry po lewej). Reguły zależne od rozproszenia dają węższe przedziały. Reguła Scotta (oparta na SD; Scott, 1979) daje 3.51 min, a reguła Freedmana–Diaconisa (oparta na rozstępie ćwiartkowym; Freedman i Diaconis, 1981) – 3.29 min. Najwęższe przedziały, co 1.89 min, daje reguła Wanda (1997), liczona funkcją dpih() z pakietu KernSmooth. Wand zauważył, że domyślne szerokości w popularnych programach są przy dużych próbach dość dalekie od optymalnych. Tutaj domyślne 5 minut to ponad dwa i pół raza więcej niż 1.89.
Czego ten wykres nie pokazuje – i jak może zmylić. Nawet przy tej samej szerokości wygląd histogramu zależy od tego, gdzie zaczyna się pierwszy przedział. Przy granicach 0, 5, 10… kolejne słupki to 149, 80, 57 i 75 osób, więc drugi garb jest widoczny. Po przesunięciu granic o 2 minuty (2, 7, 12…) słupki wynoszą 154, 58, 62 i 60 – drugi garb znika. Jeśli garb pojawia się albo znika po przesunięciu granic, nie opisuj go w pracy bez sprawdzenia na krzywej gęstości albo ECDF.
Podpis do pracy:
Zdanie do Metody:
Kod rysunku 2: reguły Sturgesa, Scotta, Freedmana–Diaconisa i Wanda
2. Reguły szerokości przedziału i przesunięty punkt startowy
R
# Rysunek 2. Reguły szerokości przedziału i punkt startowy (kontynuacja: czas, kol, motyw, hist_w z bloku 1)
suppressPackageStartupMessages(library(KernSmooth))   # dpih(): szerokość przedziału metodą „plug-in” Wanda
n <- length(czas)
reguly <- c(Sturges_k = nclass.Sturges(czas),                      # liczba przedziałów: log2(n) + 1
            Sturges_szer = diff(range(czas)) / nclass.Sturges(czas),
            Scott_szer = 3.49 * sd(czas) * n^(-1/3),               # zależy od SD
            FD_szer = 2 * IQR(czas) * n^(-1/3),                    # zależy od rozstępu ćwiartkowego
            Wand_szer = dpih(czas))
round(reguly, 2)
diff(hist(czas, plot = FALSE)$breaks)[1]          # co ile minut tnie domyślny hist() w R (Sturges + „ładne” granice)
round(c(FD_k = diff(range(czas)) / reguly[["FD_szer"]], Wand_k = diff(range(czas)) / reguly[["Wand_szer"]]), 1)

# ta sama szerokość (5 min), dwa punkty startowe: granice 0, 5, 10… albo 2, 7, 12…
start <- function(b) hist(czas, breaks = seq(b - 5, 50 + b, by = 5), plot = FALSE)$counts
rbind(granice_0_5_10 = start(0)[2:9], granice_2_7_12 = start(2)[2:9])

p2 <- wrap_plots(
  hist_w(5) + labs(subtitle = "Sturges (domyślnie w hist()): co 5 min"),
  ggplot(data.frame(czas), aes(czas)) +
    geom_histogram(binwidth = 5, boundary = 2, fill = kol[["jasny"]], colour = "white", linewidth = 0.2) +
    scale_x_continuous(breaks = seq(0, 45, 10)) + coord_cartesian(xlim = c(0, 45)) +
    labs(subtitle = "Też co 5 min, ale granice 2, 7, 12…", x = NULL, y = NULL) + motyw,
  hist_w(reguly[["FD_szer"]]) + labs(subtitle = sprintf("Freedman–Diaconis: co %.1f min", reguly[["FD_szer"]])),
  hist_w(reguly[["Wand_szer"]]) + labs(subtitle = sprintf("Wand (dpih): co %.1f min", reguly[["Wand_szer"]])),
  ncol = 2) +
  plot_annotation(title = "Reguła i punkt startowy też zmieniają obraz",
                  caption = "Oś pozioma: czas wypełniania ankiety (minuty); oś pionowa: liczba osób", theme = motyw)
# p2   # zapis: ggsave("rozklad-zmiennej-reguly-przedzialow.svg", p2, width = 10, height = 6.4)
Wynik w R
   Sturges_k Sturges_szer   Scott_szer      FD_szer    Wand_szer
       10.00         3.82         3.51         3.29         1.89
[1] 5
  FD_k Wand_k
  11.6   20.2
               [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8]
granice_0_5_10    6  149   80   57   75   22    6    3
granice_2_7_12   45  154   58   62   60   16    2    2
Rysunek 3: gęstość jądrowa – za gładko i za szorstko
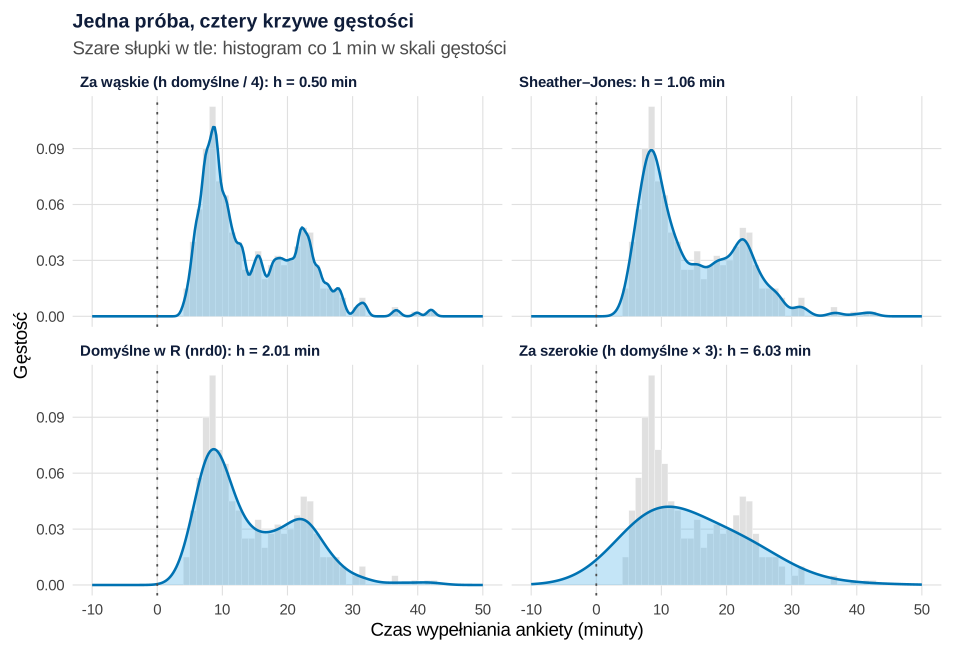
Co widać. Krzywa gęstości nie ma granic przedziałów, ale ma pasmo h, które działa jak szerokość przedziału. Przy h = 0.50 min (jedna czwarta domyślnego) krzywa ma 9 szczytów, czyli powtarza szum. Pasmo Sheathera–Jonesa, dobierane z danych (Sheather i Jones, 1991), wynosi 1.06 min i daje 6 szczytów. Główne są przy 8.5 i 22.4 min, a reszta to drobne wybrzuszenia w rzadkim prawym ogonie. Domyślne pasmo R (bw.nrd0, 2.01 min) daje dwa gładkie garby przy 8.7 i 21.9 min oraz maleńki szczyt przy 41.0 min, gdzie leży kilka pojedynczych wyników. Przy h trzy razy większym zostaje jeden garb – podgrupy znikają.
Czego ten wykres nie pokazuje – i jak może zmylić. Liczba szczytów zależy od pasma, więc „dwumodalność” z jednej krzywej to hipoteza, nie wynik. Silverman (1981) opisał na tej podstawie technikę badania liczby szczytów rozkładu za pomocą estymatorów jądrowych. Krzywa nie zna też granic zmiennej: przy h = 6.03 aż 4.65% pola pod nią leży poniżej zera minut, choć nikt nie wypełnił ankiety w czasie ujemnym. Krzywa nie pokazuje liczebności, więc z gęstości 0.03 nie odczytasz, ile osób ma dany wynik. Przy 40 i przy 4000 osobach gęstość może wyglądać podobnie, choć jej precyzja jest zupełnie inna.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 3: gęstość przy czterech pasmach
3. Pasmo za wąskie, z danych, domyślne i za szerokie
R
# Rysunek 3. Gęstość jądrowa przy czterech szerokościach pasma (kontynuacja: czas, kol, motyw z bloku 1)
pasma <- c(za_waskie = bw.nrd0(czas) / 4, SJ = bw.SJ(czas), domyslne_nrd0 = bw.nrd0(czas), za_szerokie = 3 * bw.nrd0(czas))
szczyty <- function(h) {                          # położenie lokalnych maksimów krzywej
  d <- density(czas, bw = h, n = 1024); d$x[which(diff(sign(diff(d$y))) == -2) + 1]
}
tab3 <- data.frame(pasmo_h = pasma, liczba_szczytow = sapply(pasma, function(h) length(szczyty(h))),
                   ponizej_zera_proc = 100 * sapply(pasma, function(h) mean(pnorm(0, czas, h))))   # masa krzywej przy czasie < 0
round(tab3, 2)
lapply(pasma[c("SJ", "domyslne_nrd0")], function(h) round(szczyty(h), 1))   # gdzie są garby

etyk <- sprintf("%s: h = %.2f min", c("Za wąskie (h domyślne / 4)", "Sheather–Jones", "Domyślne w R (nrd0)", "Za szerokie (h domyślne × 3)"), pasma)
d3 <- do.call(rbind, lapply(seq_along(pasma), function(i) {
  d <- density(czas, bw = pasma[i], n = 256, from = -10, to = 50)
  data.frame(panel = etyk[i], x = d$x, y = d$y)
}))
d3$panel <- factor(d3$panel, levels = etyk)
p3 <- ggplot(d3, aes(x, y)) +
  geom_histogram(data = data.frame(czas), aes(czas, after_stat(density)), inherit.aes = FALSE,
                 binwidth = 1, boundary = 0, fill = "grey88", colour = "white", linewidth = 0.1) +
  geom_area(fill = kol[["jasny"]], alpha = 0.35) +
  geom_line(colour = kol[["telefon"]], linewidth = 0.9) +
  geom_vline(xintercept = 0, linetype = "dotted", colour = "grey30") +
  facet_wrap(~ panel, ncol = 2) +
  scale_x_continuous(breaks = seq(-10, 50, 10)) +
  labs(x = "Czas wypełniania ankiety (minuty)", y = "Gęstość",
       title = "Jedna próba, cztery krzywe gęstości",
       subtitle = "Szare słupki w tle: histogram co 1 min w skali gęstości") + motyw
# p3   # zapis: ggsave("rozklad-zmiennej-gestosc-pasmo.svg", p3, width = 10, height = 6.8)
Wynik w R
              pasmo_h liczba_szczytow ponizej_zera_proc
za_waskie        0.50               9              0.00
SJ               1.06               6              0.00
domyslne_nrd0    2.01               3              0.03
za_szerokie      6.03               1              4.65
$SJ
[1]  8.5 15.2 22.4 31.2 36.7 41.9

$domyslne_nrd0
[1]  8.7 21.9 41.0
Rysunek 4: ECDF – wykres bez parametrów
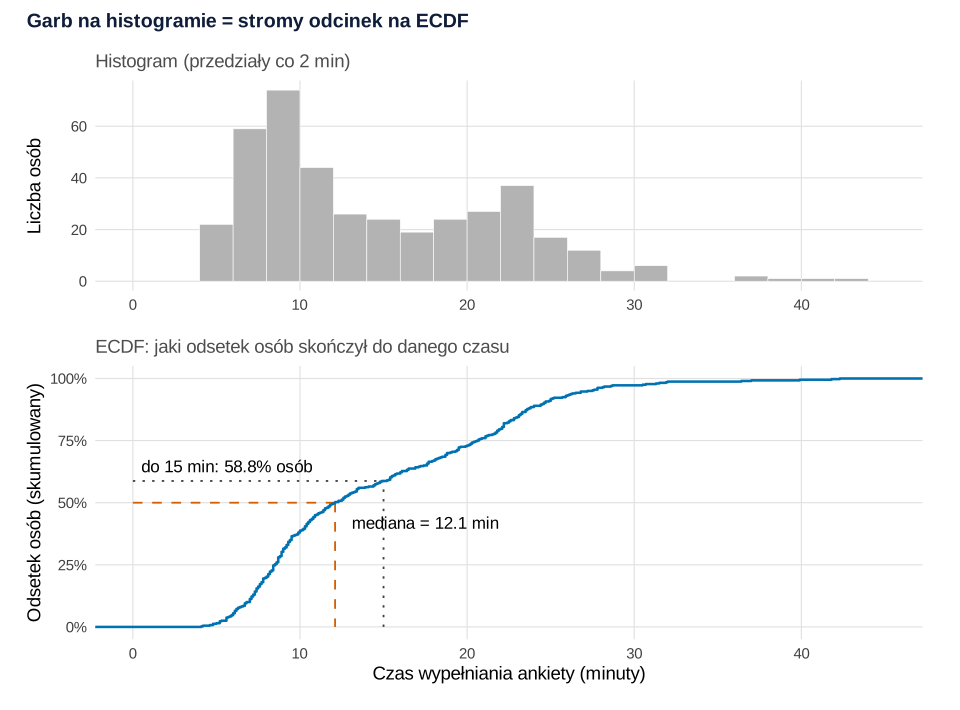
Co widać. ECDF przy każdej wartości osi poziomej pokazuje, jaki odsetek osób miał wynik nie większy. Nie wymaga ani przedziałów, ani pasma, a każda osoba to jeden schodek wysokości 1/400. Odczyt jest dwukierunkowy. Od osi poziomej: do 15 minut ankietę skończyło 58.75% osób, a powyżej 30 minut wypełniało ją tylko 2.75%. Od osi pionowej: na wysokości 50% leży mediana (12.1 min), na 25% i 75% – kwartyle (8.5 i 20.6 min), na 90% – 90. percentyl (24.6 min). Garby histogramu to strome odcinki krzywej. Między 8 a 10 minutami przybywa 18.5% osób, między 16 a 18 – tylko 4.7%, a między 22 a 24 znów 9.3%.
Czego ten wykres nie pokazuje – i jak może zmylić. Dwa garby są na ECDF tylko zmianą nachylenia, a nie dwoma szczytami. Kto nie zna tego wykresu, zobaczy po prostu „esowatą krzywą”. Dlatego w pracy dobrze jest pokazać ECDF obok histogramu, jak tutaj. Oś pionowa to odsetek skumulowany, a nie liczba osób. Przy małej próbie schodki są duże i krzywa jest niepewna – szerokość pasma ufności omawia hasło ECDF. Związek dystrybuanty z gęstością wyjaśnia hasło funkcja gęstości i dystrybuanta.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 4: ECDF pod histogramem
4. Odczyt mediany, kwantyli i odsetka do progu
R
# Rysunek 4. ECDF pod histogramem: odczyt mediany i odsetka poniżej progu (kontynuacja: czas, kol, motyw, hist_w)
Fn <- ecdf(czas)                                  # dystrybuanta empiryczna: odsetek wyników <= x
round(c(proc_do_15_min = 100 * Fn(15), proc_powyzej_30_min = 100 * (1 - Fn(30))), 2)
quantile(czas, c(.10, .25, .50, .75, .90), type = 1)   # odwrotność ECDF: kwantyle próby
# gdzie ECDF rośnie najszybciej (= garby histogramu): przyrost odsetka na każde 2 minuty
przyrost <- diff(Fn(seq(4, 32, by = 2))) * 100
names(przyrost) <- paste0(seq(4, 30, by = 2), "–", seq(6, 32, by = 2)); round(przyrost, 1)

med <- median(czas); f15 <- Fn(15)
p4a <- hist_w(2) + labs(subtitle = "Histogram (przedziały co 2 min)", y = "Liczba osób")
p4b <- ggplot(data.frame(czas), aes(czas)) +
  annotate("segment", x = 0, xend = med, y = 0.5, yend = 0.5, linetype = "dashed", colour = kol[["komputer"]]) +
  annotate("segment", x = med, xend = med, y = 0.5, yend = 0, linetype = "dashed", colour = kol[["komputer"]]) +
  annotate("segment", x = 15, xend = 15, y = 0, yend = f15, linetype = "dotted", colour = kol[["ciemny"]]) +
  annotate("segment", x = 0, xend = 15, y = f15, yend = f15, linetype = "dotted", colour = kol[["ciemny"]]) +
  stat_ecdf(geom = "step", colour = kol[["telefon"]], linewidth = 0.9) +
  annotate("text", x = med + 1, y = 0.42, hjust = 0, size = 4.5,
           label = sprintf("mediana = %.1f min", med)) +
  annotate("text", x = 0.5, y = f15 + 0.06, hjust = 0, size = 4.5,
           label = sprintf("do 15 min: %.1f%% osób", 100 * f15)) +
  scale_x_continuous(breaks = seq(0, 45, 10)) + coord_cartesian(xlim = c(0, 45)) +
  scale_y_continuous(breaks = seq(0, 1, 0.25), labels = function(v) paste0(100 * v, "%")) +
  labs(subtitle = "ECDF: jaki odsetek osób skończył do danego czasu", x = "Czas wypełniania ankiety (minuty)",
       y = "Odsetek osób (skumulowany)") + motyw
p4 <- p4a / p4b + plot_layout(heights = c(1, 1.3)) +
  plot_annotation(title = "Garb na histogramie = stromy odcinek na ECDF", theme = motyw)
# p4   # zapis: ggsave("rozklad-zmiennej-ecdf.svg", p4, width = 10, height = 7.4)
Wynik w R
     proc_do_15_min proc_powyzej_30_min
              58.75                2.75
 10%  25%  50%  75%  90%
 6.8  8.5 12.1 20.6 24.6
  4–6   6–8  8–10 10–12 12–14 14–16 16–18 18–20 20–22 22–24 24–26 26–28 28–30
  5.5  14.8  18.5  11.0   6.5   6.0   4.7   6.0   6.8   9.3   4.2   3.0   1.0
30–32
  1.5
Rysunek 5: dwie grupy – histogramy, gęstości czy ECDF
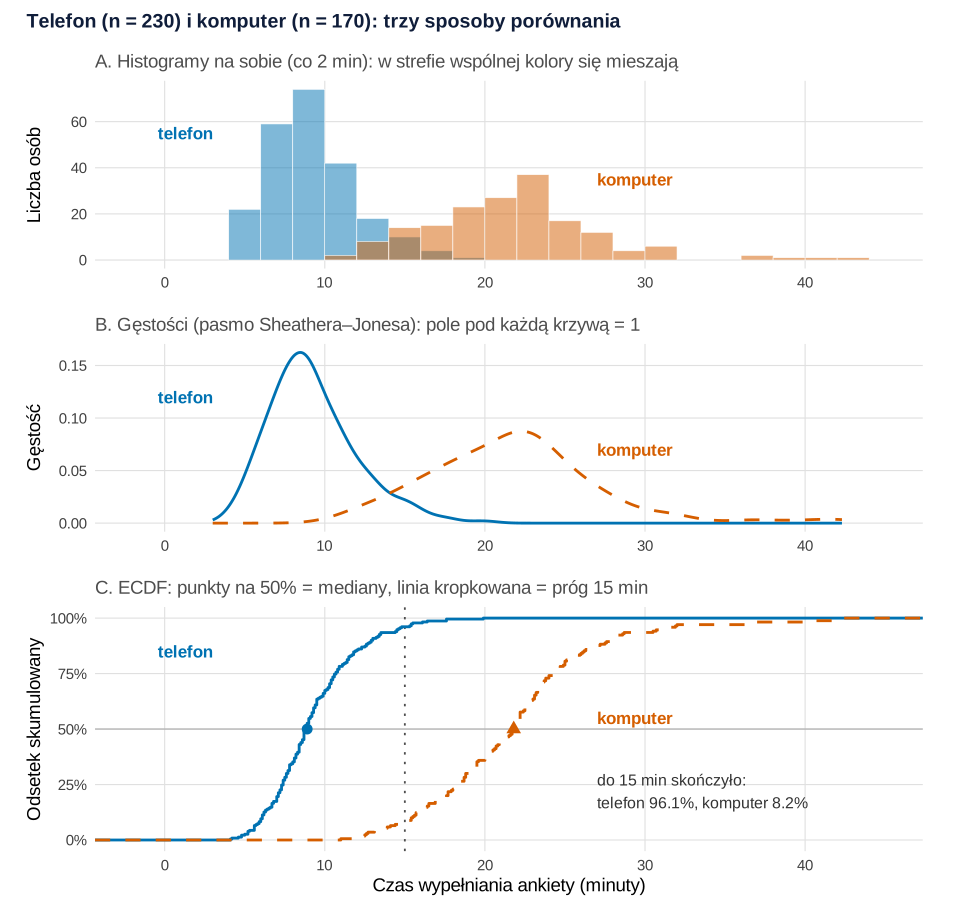
Co widać. Dwa garby z rysunków 1–4 to dwie grupy: telefon (Mdn = 8.9 min, Q1–Q3: 7.4–10.7) i komputer (Mdn = 21.8 min, 18.3–24.4). Każdy wykres pokazuje to inaczej. Nakładające się histogramy (A) są czytelne tylko tam, gdzie grupy się nie stykają. W strefie 12–18 minut (32 osoby z telefonem, 37 z komputerem) kolory się mieszają i trudno ocenić, który słupek jest wyższy. Słupki pokazują liczebności, więc większa grupa wygląda na „ważniejszą”. Gęstości (B) mają pole 1, więc nie zależą od liczebności grup i dobrze pokazują kształty, ale nie mówią, ile osób jest w grupie. ECDF (C) pozwala odczytać liczby: mediany to punkty na wysokości 50%, a na linii 15 minut krzywa telefonu jest na 96.1% (95% CI [92.7, 98.2]), a komputera – na 8.2% [4.6, 13.4]. Największa pionowa odległość między krzywymi wynosi 0.89, przy 14.7 min. Na tej odległości opiera się test Kołmogorowa–Smirnowa dla dwóch prób.
Czego ten wykres nie pokazuje – i jak może zmylić. Żaden z trzech paneli nie jest testem. Różnicę median i jej istotność opisz osobno, np. testem U Manna–Whitneya. Kolejność kolorów na nakładce zależy od kolejności rysowania, a przezroczystość tworzy trzeci kolor, którego nie ma w legendzie. Dlatego grupy podpisaliśmy bezpośrednio, a kolor wspieramy rodzajem linii i kształtem punktu. Gdy grup jest więcej niż dwie, lepiej sprawdzają się panele jeden pod drugim ze wspólną osią poziomą albo wykresy z wpisu porównanie grup na wykresie: od słupka do raincloud.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 5: dwie grupy na trzech wykresach
5. Telefon i komputer: nakładka, gęstości i ECDF
R
# Rysunek 5. Dwie grupy: nakładające się histogramy, gęstości i ECDF (kontynuacja: dane, kol, motyw z bloku 1)
prog <- 15                                        # próg: ankieta wypełniona w 15 minut lub szybciej
opis5 <- do.call(rbind, lapply(split(dane$czas, dane$urzadzenie), function(x) {
  b <- binom.test(sum(x <= prog), length(x))      # odsetek do progu z dokładnym 95% CI
  data.frame(n = length(x), mediana = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)),
             proc_do_15 = 100 * b$estimate, CI_dolna = 100 * b$conf.int[1], CI_gorna = 100 * b$conf.int[2])
}))
round(opis5, 1)
Ft <- ecdf(dane$czas[dane$urzadzenie == "telefon"]); Fk <- ecdf(dane$czas[dane$urzadzenie == "komputer"])
siatka <- sort(unique(dane$czas))                 # największa pionowa odległość między krzywymi ECDF
round(c(najwieksza_roznica_ECDF = max(abs(Ft(siatka) - Fk(siatka))),
        przy_czasie = siatka[which.max(abs(Ft(siatka) - Fk(siatka)))]), 2)
table(nakladanie_12_do_18_min = cut(dane$czas, c(0, 12, 18, Inf)), dane$urzadzenie)   # ile osób w strefie wspólnej

# podpisy bezpośrednio przy grupach zamiast legendy (kolor + rodzaj linii + tekst)
podpis <- function(y_tel, y_komp) list(
  annotate("text", x = 3, y = y_tel, label = "telefon", colour = kol[["telefon"]], hjust = 1, size = 4.5, fontface = "bold"),
  annotate("text", x = 27, y = y_komp, label = "komputer", colour = kol[["komputer"]], hjust = 0, size = 4.5, fontface = "bold"))
wsp <- list(scale_x_continuous(breaks = seq(0, 45, 10)), coord_cartesian(xlim = c(-2, 45)), motyw,
            theme(legend.position = "none"))
p5a <- ggplot(dane, aes(czas, fill = urzadzenie)) +
  geom_histogram(binwidth = 2, boundary = 0, position = "identity", alpha = 0.5, colour = "white", linewidth = 0.2) +
  scale_fill_manual(values = kol[c("telefon", "komputer")]) + podpis(55, 35) + wsp +
  labs(subtitle = "A. Histogramy na sobie (co 2 min): w strefie wspólnej kolory się mieszają", x = NULL, y = "Liczba osób")
p5b <- ggplot(dane, aes(czas, colour = urzadzenie, linetype = urzadzenie)) +
  geom_density(linewidth = 1, bw = "SJ") +
  scale_colour_manual(values = kol[c("telefon", "komputer")]) +
  scale_linetype_manual(values = c(telefon = "solid", komputer = "dashed")) + podpis(0.12, 0.07) + wsp +
  labs(subtitle = "B. Gęstości (pasmo Sheathera–Jonesa): pole pod każdą krzywą = 1", x = NULL, y = "Gęstość")
mediany <- data.frame(urzadzenie = factor(c("telefon", "komputer"), levels = levels(dane$urzadzenie)), m = opis5$mediana)
p5c <- ggplot(dane, aes(czas, colour = urzadzenie, linetype = urzadzenie)) +
  geom_hline(yintercept = 0.5, colour = "grey60", linewidth = 0.3) +
  geom_vline(xintercept = prog, colour = "grey30", linetype = "dotted") +
  stat_ecdf(geom = "step", linewidth = 1) +
  geom_point(data = mediany, aes(m, 0.5, shape = urzadzenie), size = 3.4) +
  scale_colour_manual(values = kol[c("telefon", "komputer")]) +
  scale_linetype_manual(values = c(telefon = "solid", komputer = "dashed")) +
  scale_shape_manual(values = c(telefon = 16, komputer = 17)) +
  annotate("text", x = 27, y = 0.22, hjust = 0, size = 4.2, colour = "grey20",
           label = sprintf("do %d min skończyło:\ntelefon %.1f%%, komputer %.1f%%", prog, opis5$proc_do_15[1], opis5$proc_do_15[2])) +
  podpis(0.85, 0.55) +
  scale_y_continuous(breaks = seq(0, 1, 0.25), labels = function(v) paste0(100 * v, "%")) + wsp +
  labs(subtitle = "C. ECDF: punkty na 50% = mediany, linia kropkowana = próg 15 min",
       x = "Czas wypełniania ankiety (minuty)", y = "Odsetek skumulowany")
p5 <- p5a / p5b / p5c + plot_layout(heights = c(1, 1, 1.3)) +
  plot_annotation(title = "Telefon (n = 230) i komputer (n = 170): trzy sposoby porównania", theme = motyw)
# p5   # zapis: ggsave("rozklad-zmiennej-dwie-grupy.svg", p5, width = 10, height = 9.6)
Wynik w R
           n mediana   Q1   Q3 proc_do_15 CI_dolna CI_gorna
telefon  230     8.9  7.4 10.7       96.1     92.7     98.2
komputer 170    21.8 18.3 24.4        8.2      4.6     13.4
najwieksza_roznica_ECDF             przy_czasie
                   0.89                   14.70

nakladanie_12_do_18_min telefon komputer
               (0,12]       197        2
               (12,18]       32       37
               (18,Inf]       1      131
Rysunek 6: dane dyskretne – słupki zamiast gęstości
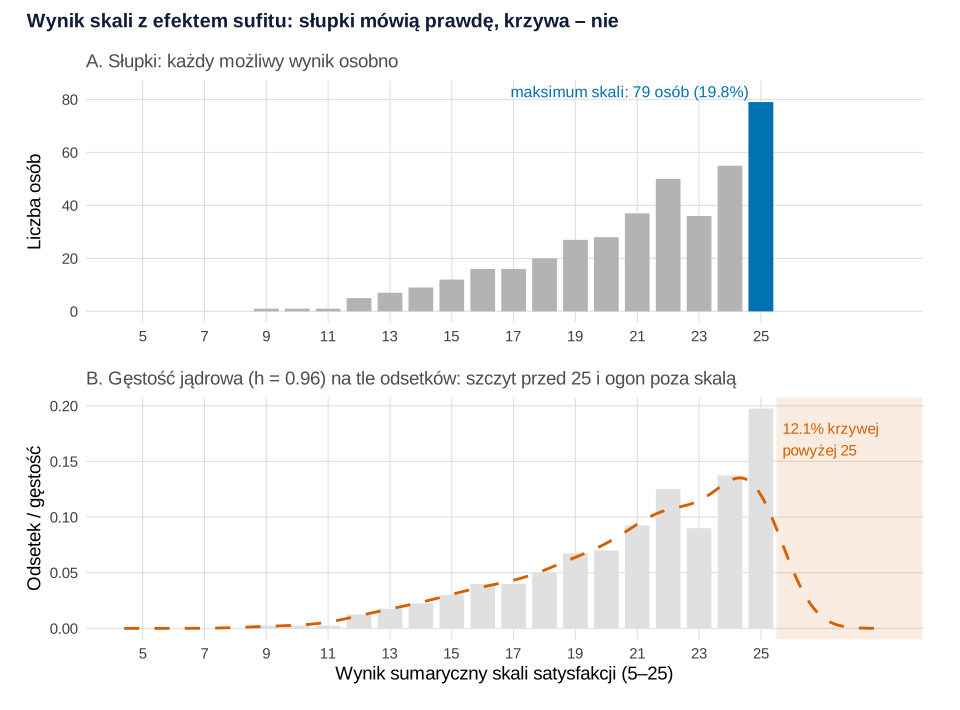
Co widać. Wynik sumaryczny ma tylko 21 możliwych wartości, więc najuczciwszy wykres to słupek dla każdej z nich. Panel A pokazuje efekt sufitu: wynik maksymalny 25 ma 79 osób (19.75%, 95% CI [15.96, 23.99]) i jest to najczęstszy wynik. W każdej z pięciu pozycji „5” zaznaczyło od 45.5% do 48.5% osób. Średnia (21.12) leży poniżej mediany (22), a 64.25% osób ma co najmniej 21 punktów. Krzywa gęstości (panel B, domyślne pasmo 0.96) psuje ten obraz na trzy sposoby. Rozmywa słupek 25, więc szczyt krzywej wypada przy 24.3, a przy 25 jej wysokość (0.120) jest wyraźnie niższa niż odsetek osób z tym wynikiem (0.198). Wypełnia też przerwy między liczbami całkowitymi, których nikt nie może uzyskać. Wreszcie umieszcza 12.1% pola powyżej 25 punktów, czyli poza skalą.
Czego ten wykres nie pokazuje – i jak może zmylić. Słupki nie mówią, skąd bierze się sufit: z łatwych pozycji, z prawdziwie wysokiej satysfakcji czy ze stylu odpowiadania. Opisuje to hasło efekt sufitu i podłogi. Przy pojedynczej pozycji skali Likerta (5 wartości) potrzebny jest wykres słupkowy albo rozbieżny – zob. odpowiedzi Likerta w raporcie. Przy sumie wielu pozycji, gdy możliwych wartości są dziesiątki, histogram z przedziałem 1 punktu jest tym samym co słupki.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 6: wynik skali – słupki i krzywa
6. Efekt sufitu na słupkach i na krzywej gęstości
R
# Rysunek 6. Wynik sumaryczny skali Likerta (5–25) z efektem sufitu: słupki zamiast gęstości
# (kontynuacja: satysfakcja, pozycje, kol, motyw z bloku 1)
table(satysfakcja)                                # liczebności każdego możliwego wyniku
b25 <- binom.test(sum(satysfakcja == 25), length(satysfakcja))
round(c(srednia = mean(satysfakcja), mediana = median(satysfakcja), proc_wynik_25 = 100 * unname(b25$estimate),
        CI_dolna = 100 * b25$conf.int[1], CI_gorna = 100 * b25$conf.int[2], proc_21_25 = 100 * mean(satysfakcja >= 21)), 2)
apply(pozycje, 2, function(p) round(100 * mean(p == 5), 1))   # % odpowiedzi „5” w każdej pozycji

h6 <- bw.nrd0(satysfakcja)                        # domyślne pasmo gęstości
kde_po_25 <- mean(pnorm(25, satysfakcja, h6, lower.tail = FALSE))   # część krzywej nad niemożliwymi wynikami > 25
d6 <- density(satysfakcja, bw = h6, n = 2048, from = 0, to = 32)
round(c(pasmo_h = h6, proc_krzywej_powyzej_25 = 100 * kde_po_25, moda_krzywej = d6$x[which.max(d6$y)],
        gestosc_przy_25 = approx(d6$x, d6$y, 25)$y, odsetek_wyniku_25 = mean(satysfakcja == 25)), 3)

s6 <- data.frame(satysfakcja)
p6a <- ggplot(s6, aes(satysfakcja)) +
  geom_bar(fill = kol[["slupek"]], width = 0.8) +
  geom_bar(data = subset(s6, satysfakcja == 25), fill = kol[["telefon"]], width = 0.8) +
  annotate("text", x = 24.6, y = sum(satysfakcja == 25) + 4, hjust = 1, size = 4.2, colour = kol[["telefon"]],
           label = sprintf("maksimum skali: %d osób (%.1f%%)", sum(satysfakcja == 25), 100 * mean(satysfakcja == 25))) +
  scale_x_continuous(breaks = seq(5, 25, 2), limits = c(4.4, 29)) +
  labs(subtitle = "A. Słupki: każdy możliwy wynik osobno", x = NULL, y = "Liczba osób") + motyw
p6b <- ggplot(s6, aes(satysfakcja)) +
  geom_bar(aes(y = after_stat(prop)), fill = "grey88", width = 0.8) +
  annotate("rect", xmin = 25.5, xmax = Inf, ymin = -Inf, ymax = Inf, fill = kol[["komputer"]], alpha = 0.12) +
  geom_density(bw = h6, colour = kol[["komputer"]], linewidth = 1, linetype = "dashed") +
  annotate("text", x = 25.7, y = 0.17, hjust = 0, size = 4, colour = kol[["komputer"]],
           label = sprintf("%.1f%% krzywej\npowyżej 25", 100 * kde_po_25)) +
  scale_x_continuous(breaks = seq(5, 25, 2), limits = c(4.4, 29)) +
  labs(subtitle = sprintf("B. Gęstość jądrowa (h = %.2f) na tle odsetków: szczyt przed 25 i ogon poza skalą", h6),
       x = "Wynik sumaryczny skali satysfakcji (5–25)", y = "Odsetek / gęstość") + motyw
p6 <- p6a / p6b + plot_annotation(title = "Wynik skali z efektem sufitu: słupki mówią prawdę, krzywa – nie", theme = motyw)
# p6   # zapis: ggsave("rozklad-zmiennej-likert-slupki.svg", p6, width = 10, height = 7.4)
Wynik w R
satysfakcja
 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25
 1  1  1  5  7  9 12 16 16 20 27 28 37 50 36 55 79
      srednia       mediana proc_wynik_25      CI_dolna      CI_gorna
        21.12         22.00         19.75         15.96         23.99
   proc_21_25
        64.25
[1] 48.5 45.5 48.2 48.5 47.2
                pasmo_h proc_krzywej_powyzej_25            moda_krzywej
                  0.962                  12.109                  24.324
        gestosc_przy_25       odsetek_wyniku_25
                  0.120                   0.198
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (histogramy, reguły Sturgesa, Scotta i Freedmana–Diaconisa, gęstość jądrowa, ECDF i przedziały dla odsetków – pakiety graphics, grDevices i stats; reguła Wanda – pakiet KernSmooth). Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- KernSmooth (wersja 2.23-26): Wand, M. (2025). KernSmooth: Functions for kernel smoothing supporting Wand & Jones (1995) [R package]. https://doi.org/10.32614/CRAN.package.KernSmooth
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Który wykres do pracy
- Jedna zmienna ciągła, opis próby: histogram z regułą Freedmana–Diaconisa albo Wanda, sprawdzony przy jednej szerokości węższej i jednej szerszej. Szerokość przedziału podaj w nocie.
- Pytanie o kształt (jeden garb czy dwa): krzywa gęstości z pasmem Sheathera–Jonesa na tle histogramu i porównanie z pasmem domyślnym.
- Pytanie o progi i odsetki („ile osób poniżej 15 minut”, „jaki wynik ma 90% osób”): ECDF. To jedyny z tych trzech wykresów, z którego odczytasz liczby bez żadnych ustawień.
- Dwie lub trzy grupy: ECDF na jednym wykresie albo gęstości w panelach ze wspólną osią. Histogramów na sobie unikaj.
- Dane dyskretne (pozycja Likerta, krótka skala sumaryczna, liczba zdarzeń): słupki dla każdej wartości, bez krzywej.
W tekście pracy rozkład streszczasz liczbami – medianą, kwartylami, zakresem. Tabelę tych liczb przygotujesz według wpisu statystyki opisowe w pracy. Symulacyjne spojrzenie na inne pojęcia znajdziesz we wpisach przedział ufności w obrazkach i skąd się biorą rozkłady t, χ² i F.
Najczęstsze błędy
- Domyślny histogram bez sprawdzenia. Przy 400 osobach domyślne przedziały R miały 5 minut i ukrywały drugi garb (rysunki 1 i 2).
- Opis garbu, który znika po przesunięciu granic przedziałów (rysunek 2).
- Liczba szczytów krzywej gęstości podana jako fakt. Zależy od pasma – podaj pasmo i sprawdź drugie (rysunek 3).
- Krzywa gęstości wychodząca poza możliwy zakres (czas ujemny, wynik powyżej maksimum skali) bez komentarza (rysunki 3 i 6).
- ECDF bez opisu osi pionowej. Napisz w podpisie, że to odsetek skumulowany (rysunek 4).
- Dwa histogramy na sobie z przezroczystością przy grupach różnej wielkości (rysunek 5).
- Gładka krzywa dla danych z kilkoma wartościami – efekt sufitu ginie (rysunek 6).
Najczęstsze pytania
Dlaczego dwa histogramy tych samych danych wyglądają inaczej?
Bo o obrazie decydują dwie decyzje: szerokość przedziału i miejsce, w którym zaczyna się pierwszy przedział. W przykładzie 400 czasów wypełniania ankiety przedziały co 2 minuty pokazały dwa garby, a co 10 minut – jeden schodek. Przy tej samej szerokości 5 minut przesunięcie granic z 0, 5, 10… na 2, 7, 12… zmieniło słupki ze 149, 80, 57, 75 na 154, 58, 62, 60 i drugi garb zniknął. Sprawdzaj kształt przy kilku ustawieniach.
Kiedy krzywa gęstości jest za gładka, a kiedy za szorstka?
Za szorstka jest wtedy, gdy ma szczyty w miejscach pojedynczych obserwacji. W przykładzie przy paśmie 0.50 minuty krzywa miała 9 szczytów. Za gładka jest wtedy, gdy zlewa podgrupy – przy paśmie 6.03 minuty został jeden garb, a 4.65% pola krzywej trafiło na czas ujemny. Punktem wyjścia jest pasmo Sheathera–Jonesa (Sheather i Jones, 1991), które warto porównać z domyślnym.
Jak odczytać medianę i odsetek osób poniżej progu z wykresu ECDF?
Medianę odczytasz poziomo: od 50% na osi pionowej do krzywej i w dół na oś poziomą (w przykładzie 12.1 minuty). Odsetek do progu odczytasz pionowo: od progu na osi poziomej do krzywej i w lewo (do 15 minut – 58.75% osób). Kwartyle leżą na wysokości 25% i 75%.
Jak porównać rozkład zmiennej w dwóch grupach na jednym wykresie?
Najwięcej liczb da się odczytać z dwóch krzywych ECDF: mediany są na wysokości 50%, a odsetki do progu na pionowej linii. W przykładzie do 15 minut ankietę skończyło 96.1% osób na telefonie i 8.2% na komputerze. Krzywe gęstości dobrze pokazują kształty, ale ukrywają liczebność grup, a półprzezroczyste histogramy na sobie są nieczytelne tam, gdzie grupy się nakładają.
Czy wynik skali Likerta można pokazać jako krzywą gęstości?
Lepiej nie, gdy możliwych wartości jest kilka lub kilkanaście. W przykładzie skali 5–25 krzywa przesunęła szczyt na 24.3 punktu, choć najczęstszym wynikiem było maksimum 25 (19.75% osób), i umieściła 12.1% swojego pola powyżej 25 punktów, czyli poza skalą. Słupek dla każdej wartości pokazuje efekt sufitu wprost.
Powiązane hasła
Przeczytaj też
Porównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Nie wiesz, jak pokazać rozkład zmiennych w swojej pracy?
Pomożemy dobrać wykresy do danych, przygotować czytelne rysunki z podpisami APA i opisać rozkłady tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/bf01025868 ● Otwarty dostęp
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sheather, S. J., & Jones, M. C. (1991). A reliable data-based bandwidth selection method for kernel density estimation. Journal of the Royal Statistical Society: Series B (Methodological), 53(3), 683–690. https://doi.org/10.1111/j.2517-6161.1991.tb01857.x
- Silverman, B. W. (1981). Using kernel density estimates to investigate multimodality. Journal of the Royal Statistical Society: Series B (Methodological), 43(1), 97–99. https://doi.org/10.1111/j.2517-6161.1981.tb01155.x
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Wand, M. P. (1997). Data-based choice of histogram bin width. The American Statistician, 51(1), 59–64. https://doi.org/10.1080/00031305.1997.10473591
Cytowania BibTeX
@article{freedman1981histogram, author={Freedman, David and Diaconis, Persi}, title={{On the histogram as a density estimator: L2 theory}}, journal={Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete}, year={1981}, volume={57}, number={4}, pages={453--476}, doi={10.1007/bf01025868}}@article{scott1979optimal, author={Scott, David W.}, title={{On optimal and data-based histograms}}, journal={Biometrika}, year={1979}, volume={66}, number={3}, pages={605--610}, doi={10.1093/biomet/66.3.605}}@article{sheather1991reliable, author={Sheather, S. J. and Jones, M. C.}, title={{A reliable data-based bandwidth selection method for kernel density estimation}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1991}, volume={53}, number={3}, pages={683--690}, doi={10.1111/j.2517-6161.1991.tb01857.x}}@article{silverman1981using, author={Silverman, Bernard W.}, title={{Using kernel density estimates to investigate multimodality}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1981}, volume={43}, number={1}, pages={97--99}, doi={10.1111/j.2517-6161.1981.tb01155.x}}@article{sturges1926choice, author={Sturges, Herbert A.}, title={{The choice of a class interval}}, journal={Journal of the American Statistical Association}, year={1926}, volume={21}, number={153}, pages={65--66}, doi={10.1080/01621459.1926.10502161}}@article{wand1997data, author={Wand, M. P.}, title={{Data-based choice of histogram bin width}}, journal={The American Statistician}, year={1997}, volume={51}, number={1}, pages={59--64}, doi={10.1080/00031305.1997.10473591}}