Jeden zbiór danych, pięć wykresów
Porównanie grup to najczęstszy rysunek w pracy dyplomowej: ta sama zmienna ilościowa w dwóch, trzech albo czterech grupach. Ten sam zbiór danych można jednak pokazać na kilka sposobów, a każdy z nich coś ukrywa. W tym wpisie przepuszczamy jeden fikcyjny zbiór przez pięć wykresów: słupek ze średnią, wykres pudełkowy, wykres skrzypcowy, punkty ze średnią i przedziałem ufności oraz wykres raincloud. Przy każdym rysunku znajdziesz to samo: co widać, czego wykres nie pokazuje, gotowy podpis do pracy i zdanie do rozdziału Wyniki.
Weissgerber i in. (2015) przejrzeli 703 artykuły z czołowych czasopism fizjologicznych. Dane ciągłe przedstawiano w nich głównie na wykresach słupkowych i liniowych, choć bardzo różne rozkłady mogą dać taki sam słupek. Jak ten problem wygląda na trzech grupach po 30 osób, pokazuje hasło wykres słupkowy. Tutaj grupy mają różne liczebności, co zmienia ocenę każdego wykresu. Ogólne zasady (typ wykresu do pytania, numer i tytuł rysunku, eksport, kolory) są we wpisach wykresy w pracy dyplomowej i tabele i rysunki do artykułu – tu ich nie powtarzamy.
Dane: trzy grupy, trzy różne rozkłady
Przykład jest fikcyjny (dane symulowane w R, ziarno set.seed(561) ustalone raz, bez dobierania pod wynik). Studenci jednego przedmiotu podali, ile godzin tygodniowo uczą się samodzielnie. Przedmiot prowadzono w trzech formach:
- stacjonarne (n = 40) – jeden szczyt, rozkład zbliżony do symetrycznego;
- hybrydowe (n = 15) – mała grupa z dwiema podgrupami: jedni uczą się kilka godzin, drudzy kilkanaście;
- online (n = 90) – rozkład prawoskośny i kilka bardzo wysokich wyników (powyżej 30 godzin).
Plik do pobrania: porownanie-grup-czas-nauki.csv. Statystyki opisowe (przepis 1 w kodzie niżej):
| Grupa | n | M | SD | SE | 95% CI średniej | Me | Min–maks |
|---|---|---|---|---|---|---|---|
| Stacjonarne | 40 | 8.79 | 2.21 | 0.35 | [8.08, 9.49] | 8.95 | 3.3–12.7 |
| Hybrydowe | 15 | 9.43 | 5.40 | 1.39 | [6.44, 12.43] | 6.30 | 3.0–17.2 |
| Online | 90 | 8.44 | 5.94 | 0.63 | [7.19, 9.68] | 6.75 | 1.7–32.4 |
Średnie są prawie równe (8.44–9.43 godziny). Za tymi liczbami stoją jednak trzy różne historie. W grupie hybrydowej tylko 1 z 15 osób uczy się od 6 do 12 godzin, czyli w okolicy średniej. W grupie online mediana (6.75) jest wyraźnie niższa od średniej, bo średnią podnosi kilka skrajnych wyników. Tabela tego nie pokazuje – rysunek może, ale nie każdy.
1. Słupek ze średnią: ± SE czy ± SD?
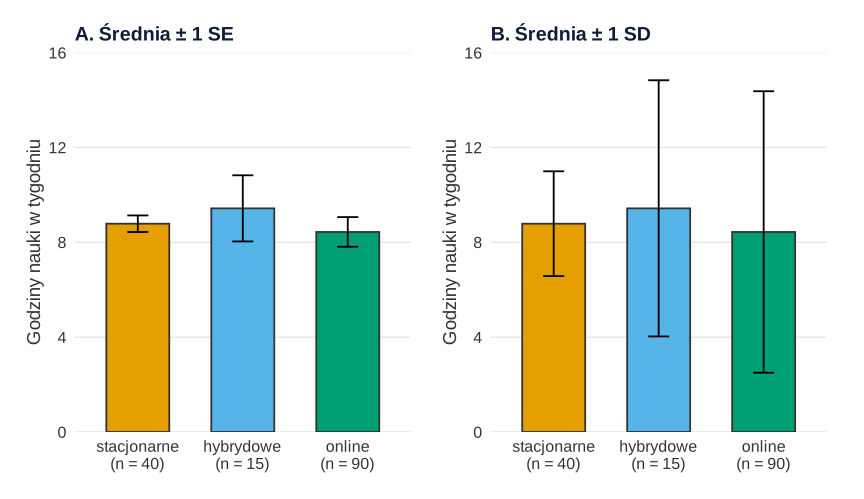
Wąs przy słupku może oznaczać trzy różne rzeczy, a każda niesie inną informację (Cumming i in., 2007):
- odchylenie standardowe (SD) opisuje rozrzut wyników osób;
- błąd standardowy (SE) = SD / √n opisuje niepewność średniej, więc maleje z liczebnością;
- 95% przedział ufności to w przybliżeniu ±2 SE – też dotyczy średniej, nie osób.
W naszych danych SD jest od 3.87 do 9.49 razy większe od SE – dokładnie √15 i √90. Dlatego ten sam słupek grupy online ma wąs od 7.81 do 9.06 godziny (± SE) albo od 2.50 do 14.37 (± SD).
- Co widać. Średnie są zbliżone. W panelu A wąs grupy hybrydowej jest najdłuższy, bo grupa jest mała, a rozrzut duży. W panelu B najdłuższe wąsy mają grupy online i hybrydowa, bo mają największy rozrzut.
- Czego ten wykres nie pokazuje. Dwóch podgrup w grupie hybrydowej, skośności i skrajnych wyników w grupie online ani liczby osób. Wąs ± SD w grupie online schodzi do 2.50 godziny, choć rozkład jest prawoskośny – symetryczny wąs sugeruje symetryczny rozkład. Słupek zaczyna się od zera, więc najwięcej „tuszu” idzie na zakres 0–8 godzin, o którym wykres nic nie mówi. Krótki wąs ± SE łatwo wziąć za mały rozrzut wyników.
- Podpis do pracy. Rysunek 1. Średni tygodniowy czas samodzielnej nauki w trzech formach zajęć. Nota. Słupki – średnie; wąsy – ±1 błąd standardowy średniej. Stacjonarne n = 40, hybrydowe n = 15, online n = 90. Bez informacji, co oznacza wąs, rysunek jest nieczytelny.
- Zdanie do Wyników. „Średni tygodniowy czas nauki był zbliżony w trzech formach zajęć (od M = 8.44, SD = 5.94 w grupie online do M = 9.43, SD = 5.40 w grupie hybrydowej; Rysunek 1)”. Podaj SD w tekście, nawet jeśli na wykresie jest SE.
Słupek ze średnią zostaw dla liczebności i odsetków. Do porównania zmiennej ilościowej wybierz jeden z wykresów niżej. Jeśli promotor wymaga słupków, rysuj 95% CI i dodaj punkty.
2. Pudełko i skrzypce
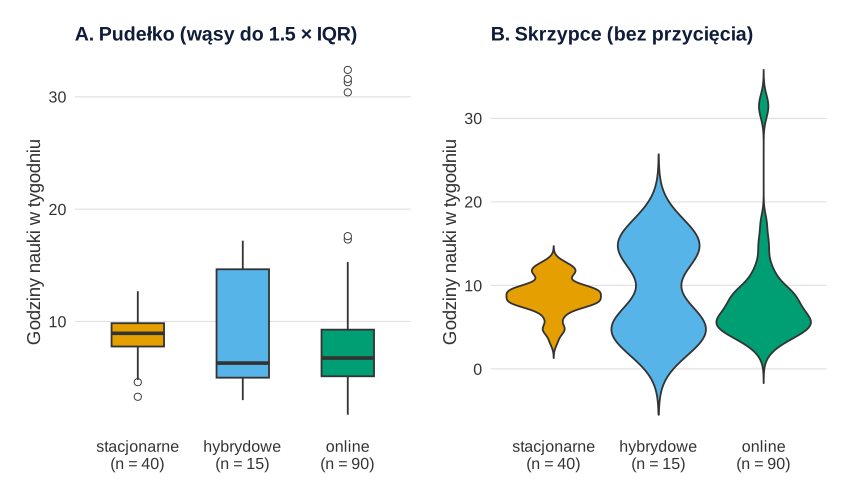
Pudełko pokazuje medianę, kwartyle i wąsy. W ggplot2 wąs kończy się na ostatniej obserwacji leżącej nie dalej niż 1.5 × IQR od krawędzi pudełka. Punkty dalej rysuje się osobno. Skrzypce łączą statystyki pudełka z oszacowaniem gęstości (Hintze i Nelson, 1998), czyli z wygładzonym histogramem (estymator jądrowy gęstości).
- Co widać. Pudełko trafnie pokazuje skośność grupy online: mediana 6.75 leży nisko w pudełku (od 5.12 do 9.28), a 6 wyników leży powyżej górnego wąsa (15.3 godziny). Skrzypce pokazują to, czego pudełko nie umie: dwa wybrzuszenia w grupie hybrydowej.
- Czego te wykresy nie pokazują. Pudełko grupy hybrydowej rozciąga się od 5.00 do 14.65 godziny, jakby wyniki rozkładały się w całym tym zakresie. Tymczasem w środku jest jedna osoba. Mediana (6.30) wypada przy dolnej podgrupie i nie opisuje „typowej” osoby. Punkty poza wąsami to reguła, nie diagnoza. W grupie stacjonarnej, symulowanej z rozkładu normalnego, dwie osoby leżą poniżej dolnego wąsa (4.8 godziny). Nie są więc automatycznie obserwacjami odstającymi do usunięcia (zob. czy można usunąć obserwacje odstające). Skrzypce ukrywają liczebność. Grupa 15 osób ma kształt tak samo gładki i pewny jak grupa 90 osób, choć oszacowanie gęstości z 15 wyników jest bardzo niepewne. Przy ustawieniu
trim = FALSE(w kodzie celowo) krzywa grupy hybrydowej schodzi do −5.5 godziny, a grupy online do −1.7. To wartości niemożliwe, wygenerowane przez wygładzanie. - Podpis do pracy. Rysunek 2. Rozkład tygodniowego czasu samodzielnej nauki w trzech formach zajęć. Nota. Pudełko – mediana i kwartyle; wąsy – najdalsze wyniki w odległości do 1.5 × IQR od pudełka; punkty – wyniki poza wąsami. Stacjonarne n = 40, hybrydowe n = 15, online n = 90.
- Zdanie do Wyników. „W grupie online rozkład czasu nauki był prawoskośny (Me = 6.75, IQR: 5.12–9.28), a osiem osób deklarowało ponad 15 godzin tygodniowo, w tym cztery ponad 30 (Rysunek 2)”.
Pudełko bez punktów rysuj tylko przy dużych grupach i jednym szczycie. Skrzypce bez punktów nie nadają się do małych grup. Jeśli ich używasz, zostaw domyślne trim = TRUE, które ogranicza krzywą do zakresu danych, i podaj n pod osią.
3. Wszystkie wyniki i średnia z 95% CI
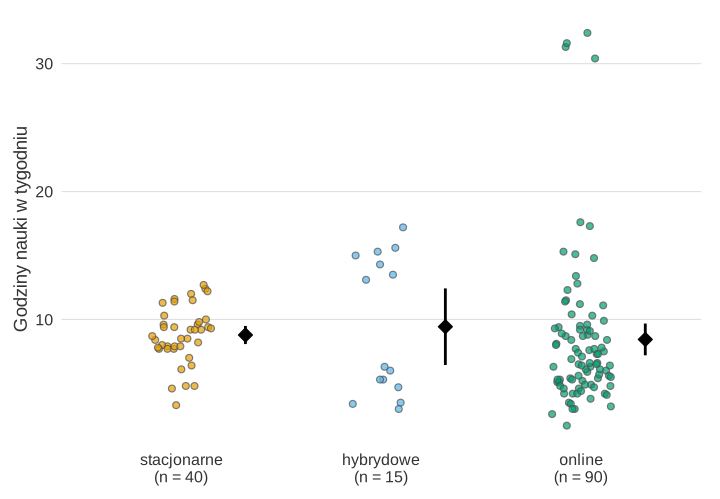
- Co widać. Wszystko, co ukrywały poprzednie wykresy: pusty środek grupy hybrydowej, skośność i cztery wyniki powyżej 30 godzin w grupie online, liczebność każdej grupy. Średnia z przedziałem ufności stoi obok punktów, a nie na nich. Widać też, że średnia grupy hybrydowej (9.43) leży tam, gdzie nie ma ani jednej osoby.
- Czego ten wykres nie pokazuje. Przy setkach osób punkty się zlewają, a rozsunięcie (jitter) jest losowe – to tylko sposób rysowania, a nie dane. Przedział ufności średniej w grupie online [7.19, 9.68] jest wąski, ale opisuje średnią, która przy skośnym rozkładzie słabo opisuje typową osobę. W takiej grupie rozważ medianę albo pokaż obie miary. Nachodzące na siebie przedziały ufności nie dowodzą braku różnicy – porównanie grup to zadanie testu i wielkości efektu, nie oka (Belia i in., 2005).
- Podpis do pracy. Rysunek 3. Tygodniowy czas samodzielnej nauki w trzech formach zajęć. Nota. Punkty – wyniki poszczególnych osób (rozsunięte w poziomie dla czytelności); romby – średnie; linie pionowe – 95% przedziały ufności średnich. Stacjonarne n = 40, hybrydowe n = 15, online n = 90.
- Zdanie do Wyników. „W grupie hybrydowej wyniki tworzyły dwa skupienia – 7 osób uczyło się do 6 godzin tygodniowo, a 7 co najmniej 12 godzin – dlatego średnia (M = 9.43, 95% CI [6.44, 12.43]) nie opisuje typowego studenta tej grupy (Rysunek 3)”.
Weissgerber i in. (2019) wymieniają wykresy punktowe, pudełkowe i skrzypcowe wśród rysunków, które odsłaniają dane. Przy małych grupach punkty to najbezpieczniejszy wybór, bo nie wymagają żadnego wygładzania.
4. Raincloud: gęstość, pudełko i punkty razem
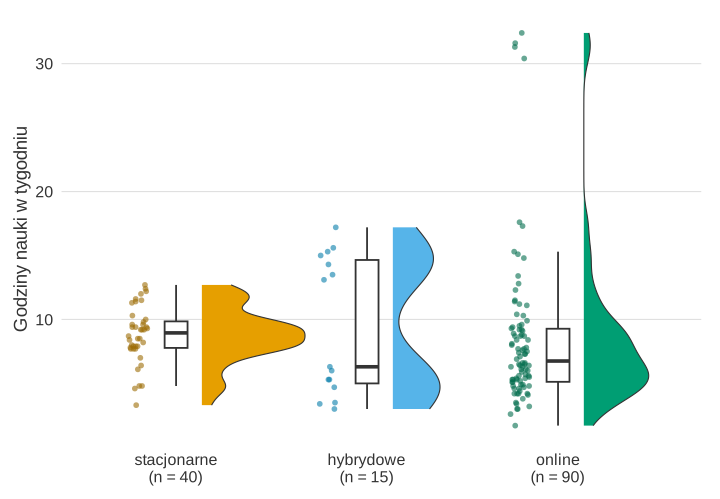
Allen i in. (2021) zaproponowali raincloud jako odpowiedź na krytykę słupków z wąsami. Taki wykres łączy surowe dane, gęstość rozkładu i statystyki podsumowujące. W R zbudujesz go z trzech warstw: stat_halfeye() z pakietu ggdist (chmura), geom_boxplot() i geom_point() przesunięte w lewo.
- Co widać. Kształt rozkładu (dwa szczyty w grupie hybrydowej, ogon w grupie online), medianę i kwartyle oraz każdą osobę. W odróżnieniu od skrzypiec chmura kończy się na najniższym i najwyższym wyniku. ggdist domyślnie ogranicza gęstość do zakresu danych, więc nie ma ujemnych godzin.
- Czego ten wykres nie pokazuje. Chmury mają tę samą maksymalną szerokość, więc chmura 15 osób wygląda tak samo „pewnie” jak chmura 90 osób. Liczebność widać dopiero po punktach i etykiecie pod osią. Kształt chmury zależy od szerokości pasma: przy zbyt wąskim paśmie pojawiają się „szczyty”, których nie ma w populacji, a przy zbyt szerokim znikają prawdziwe. Raincloud ma też trzy warstwy, więc przy wielu grupach robi się ciasno – wtedy wystarczą punkty z pudełkiem.
- Podpis do pracy. Rysunek 4. Rozkład tygodniowego czasu samodzielnej nauki w trzech formach zajęć. Nota. Punkty – wyniki poszczególnych osób; pudełko – mediana i kwartyle; krzywa – oszacowanie gęstości rozkładu (estymator jądrowy). Stacjonarne n = 40, hybrydowe n = 15, online n = 90.
- Zdanie do Wyników. „Rozkłady czasu nauki różniły się kształtem mimo zbliżonych średnich: w grupie stacjonarnej były symetryczne, w hybrydowej dwumodalne, a w online prawoskośne z kilkoma wynikami powyżej 30 godzin (Rysunek 4)”.
Który wykres przy małych, a który przy dużych grupach
- Małe grupy (do ok. 20–30 osób). Wszystkie punkty plus średnia z 95% CI albo mediana. Nie rysuj skrzypiec ani chmury bez punktów – gęstość z kilkunastu wyników to w dużej mierze efekt wygładzania. Pudełko z pięciu liczb przy 8 osobach też niewiele mówi.
- Grupy średnie (orientacyjnie 30–200 osób). Raincloud albo punkty z pudełkiem. To dobry domyślny wybór do pracy dyplomowej.
- Duże grupy (setki osób i więcej). Pudełko lub chmura, a punkty małe i półprzezroczyste albo pominięte. Przy kilku tysiącach wyników lepiej sprawdzi się histogram w osobnych panelach.
- Zawsze. n każdej grupy pod osią albo w nocie, a w nocie wyjaśnienie, co oznacza każdy element. Kolor najwyżej powtarza informację z osi – grupy są podpisane, więc wykres da się odczytać także w druku czarno-białym.
Paleta w kodzie to kolory Okabe–Ito: pomarańczowy, błękitny i zielony. Po symulacji deuteranopii (colorspace::deutan()) pozostają rozróżnialne jako żółtawy, niebieski i szary. Wykresy odpowiedzi na skali Likerta mają własne zasady (wpis odpowiedzi Likerta w raporcie), a statystyki opisowe w tabeli omawia wpis statystyki opisowe w pracy.
Para przed–po: linie par zamiast dwóch słupków
Gdy te same osoby mierzysz dwa razy, dwa słupki obok siebie gubią najważniejsze – parowanie. Osobny fikcyjny przykład: 20 osób rozwiązało test (0–40 punktów) przed krótkim kursem i po nim (ziarno set.seed(5610), ustalone raz).
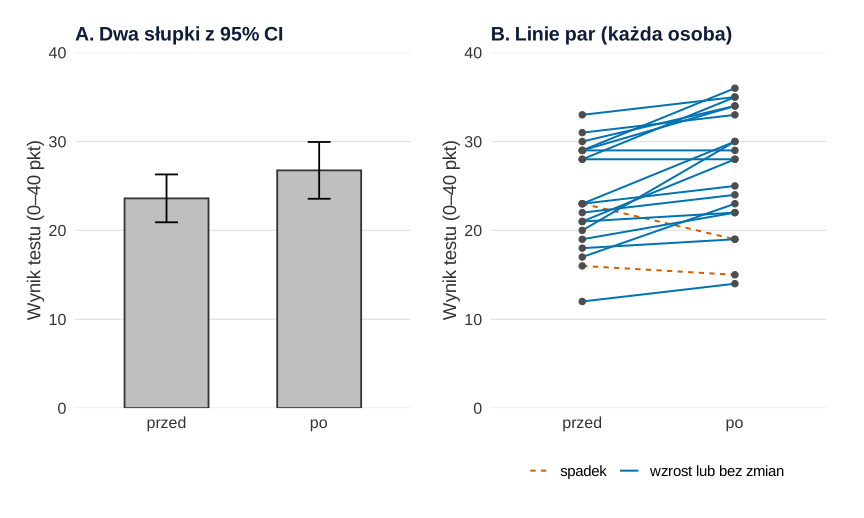
- Co widać. Na panelu A przedziały ufności średnich [20.91, 26.29] i [23.55, 29.95] mocno zachodzą na siebie. Łatwo wyczytać z tego „brak różnicy”. Panel B pokazuje, że wynik obniżył się tylko u 2 z 20 osób. Średnia zmiana wyniosła 3.15 punktu, 95% CI [1.55, 4.75], t(19) = 4.12, p < .001, dz = 0.92 (test t dla prób zależnych). Przedziały średnich są szerokie, bo osoby bardzo różnią się poziomem. Różnice w parach są natomiast spójne – korelacja przed–po wynosi r = .87.
- Czego ten wykres nie pokazuje. Przy 100 osobach linie zlewają się w plamę. Wtedy narysuj różnice (po − przed) jako punkty z 95% CI albo losową próbkę osób. Linie nie mówią też, czy zmiana wynika z kursu – bez grupy kontrolnej to tylko zmiana w czasie.
- Podpis do pracy. Rysunek 5. Wynik testu wiedzy przed kursem i po nim. Nota. Linie łączą wyniki tej samej osoby (n = 20); linie przerywane – osoby, których wynik się obniżył.
- Zdanie do Wyników. „Po kursie wynik testu wzrósł średnio o 3.15 punktu, 95% CI [1.55, 4.75], t(19) = 4.12, p < .001, dz = 0.92; wynik obniżył się u 2 z 20 osób (Rysunek 5)”.
Belia i in. (2005) pokazali, że wielu autorów artykułów nie bierze pod uwagę, czy dwie średnie na rycinie są niezależne, czy pochodzą z pomiarów powtarzanych – a to zmienia znaczenie słupków błędu. Więcej pomiarów w czasie, linie osób i średnie trajektorie opisuje wpis dane podłużne na wykresie. Inne wpisy z tej serii to kwartet Anscombe’a i wynik regresji na wykresie.
Pięć wykresów porównania grup w R – pełny kod
Kod odtwarza dane, wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R – kolejne korzystają z obiektów utworzonych wcześniej. Przepis 1 zapisuje plik CSV w katalogu roboczym. Rysunek wyświetlisz, wpisując jego nazwę (np. rys1), a zapiszesz odkomentowaną linią ggsave(). Ziarna danych (561 i 5610) i rozsunięcia punktów (1) ustalono raz, bez dobierania pod wynik.
1. Dane fikcyjne i statystyki opisowe
R
# Porównanie grup na wykresie – dane fikcyjne: tygodniowy czas samodzielnej nauki (godziny)
# w trzech formach zajęć z tego samego przedmiotu
options(width = 100)
set.seed(561)
stacjonarne <- round(rnorm(40, mean = 9, sd = 2.5), 1)                      # jeden szczyt, symetrycznie
hybrydowe   <- round(c(rnorm(8, 4, 1.2), rnorm(7, 14.5, 1.5)), 1)           # dwie podgrupy, mała próba
online      <- round(c(rlnorm(86, log(7), 0.45), runif(4, 24, 34)), 1)      # prawoskośny + 4 skrajne wyniki
dane <- data.frame(
  grupa = factor(rep(c("stacjonarne", "hybrydowe", "online"), times = c(40, 15, 90)),
                 levels = c("stacjonarne", "hybrydowe", "online")),
  godziny = c(stacjonarne, hybrydowe, online))
write.csv(dane, "porownanie-grup-czas-nauki.csv", row.names = FALSE)

# Statystyki opisowe w grupach: n, M, SD, SE, 95% CI średniej, mediana, kwartyle, min–max
opis <- function(x) {
  n <- length(x); m <- mean(x); s <- sd(x); se <- s / sqrt(n); t <- qt(.975, n - 1)
  q <- quantile(x, c(.25, .5, .75), type = 7)
  odst <- sum(x > q[3] + 1.5 * IQR(x) | x < q[1] - 1.5 * IQR(x))
  c(n = n, M = m, SD = s, SE = se, CI_dolna = m - t * se, CI_gorna = m + t * se,
    Me = q[[2]], Q1 = q[[1]], Q3 = q[[3]], min = min(x), max = max(x), odstajace = odst)
}
statystyki <- t(sapply(split(dane$godziny, dane$grupa), opis))
round(statystyki, 2)

# Ile osób w grupie hybrydowej leży blisko średniej (6–12 godzin)?
with(subset(dane, grupa == "hybrydowe"), c(blisko_sredniej = sum(godziny > 6 & godziny < 12),
                                           ponizej_6 = sum(godziny <= 6), od_12 = sum(godziny >= 12)))
# Ile osób w grupie online ma skrajnie wysokie wyniki?
with(subset(dane, grupa == "online"), c(powyzej_15 = sum(godziny > 15), powyzej_30 = sum(godziny > 30)))
# Ile razy SD jest większe od SE w każdej grupie (= pierwiastek z n)?
round(statystyki[, "SD"] / statystyki[, "SE"], 2)
Wynik w R
             n    M   SD   SE CI_dolna CI_gorna   Me   Q1    Q3 min  max odstajace
stacjonarne 40 8.79 2.21 0.35     8.08     9.49 8.95 7.77  9.85 3.3 12.7         2
hybrydowe   15 9.43 5.40 1.39     6.44    12.43 6.30 5.00 14.65 3.0 17.2         0
online      90 8.44 5.94 0.63     7.19     9.68 6.75 5.12  9.28 1.7 32.4         6
blisko_sredniej       ponizej_6           od_12
              1               7               7
powyzej_15 powyzej_30
         8          4
stacjonarne   hybrydowe      online
       6.32        3.87        9.49
2. Motyw, paleta i słupki ± SE / ± SD (Rysunek 1)
R
# Rysunek 1: słupki średnich z wąsem ±1 SE (A) i ±1 SD (B) (kontynuacja: dane, statystyki)
library(ggplot2)
library(patchwork)

# Krótki motyw i paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw)
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.x = element_blank(),
        axis.text = element_text(size = 12, colour = "grey20"),
        plot.title = element_text(face = "bold"), legend.position = "bottom")
paleta <- c(stacjonarne = "#E69F00", hybrydowe = "#56B4E9", online = "#009E73")
# Nazwy grup z liczebnością pod osią – n widać na każdym wykresie
etykiety <- sprintf("%s\n(n = %d)", levels(dane$grupa), as.integer(table(dane$grupa)))
os_x <- scale_x_discrete(labels = etykiety)

sr <- data.frame(grupa = factor(rownames(statystyki), levels = levels(dane$grupa)),
                 M = statystyki[, "M"], SE = statystyki[, "SE"], SD = statystyki[, "SD"])
slupki <- function(wasy, tytul) {
  ggplot(sr, aes(grupa, M, fill = grupa)) +
    geom_col(width = 0.6, colour = "grey20") +
    geom_errorbar(aes(ymin = M - .data[[wasy]], ymax = M + .data[[wasy]]), width = 0.2) +
    scale_fill_manual(values = paleta, guide = "none") + os_x +
    scale_y_continuous(limits = c(0, 16), expand = c(0, 0)) +
    labs(title = tytul, x = NULL, y = "Godziny nauki w tygodniu") + motyw
}
rys1 <- slupki("SE", "A. Średnia ± 1 SE") + slupki("SD", "B. Średnia ± 1 SD")
# ggsave("porownanie-grup-slupki-se-sd.svg", rys1, width = 9, height = 5.2)

# Co pokazują wąsy: koniec wąsu SE i SD w każdej grupie
round(data.frame(M = sr$M, SE_od = sr$M - sr$SE, SE_do = sr$M + sr$SE,
                 SD_od = sr$M - sr$SD, SD_do = sr$M + sr$SD, row.names = sr$grupa), 2)
Wynik w R
               M SE_od SE_do SD_od SD_do
stacjonarne 8.79  8.44  9.13  6.58 10.99
hybrydowe   9.43  8.04 10.83  4.03 14.84
online      8.44  7.81  9.06  2.50 14.37
3. Pudełko i skrzypce (Rysunek 2)
R
# Rysunek 2: wykres pudełkowy (A) i skrzypcowy (B) (kontynuacja: dane, motyw, paleta, os_x)
rys2a <- ggplot(dane, aes(grupa, godziny, fill = grupa)) +
  geom_boxplot(width = 0.5, outlier.shape = 21, outlier.size = 2.2, outlier.fill = "white") +
  scale_fill_manual(values = paleta, guide = "none") + os_x +
  labs(title = "A. Pudełko (wąsy do 1.5 × IQR)", x = NULL, y = "Godziny nauki w tygodniu") + motyw
rys2b <- ggplot(dane, aes(grupa, godziny, fill = grupa)) +
  geom_violin(scale = "width", trim = FALSE, colour = "grey20") +
  scale_fill_manual(values = paleta, guide = "none") + os_x +
  labs(title = "B. Skrzypce (bez przycięcia)", x = NULL, y = "Godziny nauki w tygodniu") + motyw
rys2 <- rys2a + rys2b
# ggsave("porownanie-grup-pudelko-skrzypce.svg", rys2, width = 9, height = 5.2)

# Z czego zbudowane jest pudełko: kwartyle, końce wąsów i liczba punktów poza wąsami
pud <- layer_data(rys2a)
data.frame(grupa = levels(dane$grupa), dolny_was = pud$ymin, Q1 = pud$lower, Me = pud$middle,
           Q3 = pud$upper, gorny_was = pud$ymax, poza_wasami = lengths(pud$outliers))
# Skrzypce wychodzą poza dane (trim = FALSE): najniższy punkt krzywej vs najniższy wynik
skrz <- layer_data(rys2b)
data.frame(grupa = levels(dane$grupa), krzywa_od = tapply(skrz$y, skrz$group, min),
           min_wynik = tapply(dane$godziny, dane$grupa, min)) |> transform(krzywa_od = round(krzywa_od, 1))
Wynik w R
        grupa dolny_was    Q1   Me     Q3 gorny_was poza_wasami
1 stacjonarne       4.8 7.775 8.95  9.850      12.7           2
2   hybrydowe       3.0 5.000 6.30 14.650      17.2           0
3      online       1.7 5.125 6.75  9.275      15.3           6
        grupa krzywa_od min_wynik
1 stacjonarne       1.3       3.3
2   hybrydowe      -5.5       3.0
3      online      -1.7       1.7
4. Punkty i średnia z 95% CI (Rysunek 3)
R
# Rysunek 3: wszystkie wyniki (jitter) + średnia z 95% CI (kontynuacja: dane, statystyki, motyw, paleta, os_x)
sr_ci <- data.frame(grupa = factor(rownames(statystyki), levels = levels(dane$grupa)),
                    M = statystyki[, "M"], dolna = statystyki[, "CI_dolna"], gorna = statystyki[, "CI_gorna"])
rys3 <- ggplot(dane, aes(grupa, godziny)) +
  geom_point(aes(fill = grupa), shape = 21, colour = "grey30", size = 2, alpha = 0.7,
             position = position_jitter(width = 0.15, height = 0, seed = 1)) +
  geom_errorbar(data = sr_ci, aes(y = M, ymin = dolna, ymax = gorna),
                width = 0, linewidth = 1, position = position_nudge(x = 0.32)) +
  geom_point(data = sr_ci, aes(y = M), shape = 23, size = 3.5, fill = "black",
             position = position_nudge(x = 0.32)) +
  scale_fill_manual(values = paleta, guide = "none") + os_x +
  labs(x = NULL, y = "Godziny nauki w tygodniu") + motyw
# ggsave("porownanie-grup-punkty-ci.svg", rys3, width = 7.5, height = 5.2)

# Średnia i 95% CI obok punktów; dla porównania mediana
round(cbind(sr_ci[, -1], Me = statystyki[, "Me"]), 2)
Wynik w R
               M dolna gorna   Me
stacjonarne 8.79  8.08  9.49 8.95
hybrydowe   9.43  6.44 12.43 6.30
online      8.44  7.19  9.68 6.75
5. Raincloud z ggdist (Rysunek 4)
R
# Rysunek 4: raincloud z ggdist – połówka gęstości, wąskie pudełko i punkty („deszcz”) obok (kontynuacja: dane, motyw, paleta, os_x)
library(ggdist)
rys4 <- ggplot(dane, aes(grupa, godziny, fill = grupa)) +
  stat_halfeye(width = 0.6, justification = -0.25,
               .width = 0, point_colour = NA, slab_colour = "grey20", slab_linewidth = 0.4) +
  geom_boxplot(width = 0.12, outlier.shape = NA, fill = "white") +
  geom_point(aes(x = as.numeric(grupa) - 0.2, colour = grupa), shape = 16, size = 1.6, alpha = 0.6,
             position = position_jitter(width = 0.05, height = 0, seed = 1)) +
  scale_fill_manual(values = paleta, guide = "none") +
  scale_colour_manual(values = colorspace::darken(paleta, 0.3), guide = "none") +
  os_x +
  labs(x = NULL, y = "Godziny nauki w tygodniu") + motyw
# ggsave("porownanie-grup-raincloud.svg", rys4, width = 7.5, height = 5.2)

# Gdzie zaczyna się i kończy „chmura”: ggdist domyślnie ogranicza gęstość do zakresu danych
chmura <- subset(layer_data(rys4, 1), !is.na(thickness))
data.frame(grupa = levels(dane$grupa), chmura_od = tapply(chmura$y, chmura$group, min),
           chmura_do = tapply(chmura$y, chmura$group, max),
           min_wynik = tapply(dane$godziny, dane$grupa, min), max_wynik = tapply(dane$godziny, dane$grupa, max))
Wynik w R
        grupa chmura_od chmura_do min_wynik max_wynik
1 stacjonarne       3.3      12.7       3.3      12.7
2   hybrydowe       3.0      17.2       3.0      17.2
3      online       1.7      32.4       1.7      32.4
6. Przed–po: słupki a linie par (Rysunek 5)
R
# Rysunek 5: te same osoby przed i po – dwa słupki (A) a linie par (B); osobny przykład fikcyjny
set.seed(5610)
n <- 20
przed <- round(rnorm(n, 22, 6))
po <- round(przed + rnorm(n, 2.5, 3))            # wynik testu 0–40 pkt przed kursem i po nim
pary <- data.frame(osoba = rep(1:n, 2), pomiar = factor(rep(c("przed", "po"), each = n), levels = c("przed", "po")),
                   wynik = c(przed, po))
pary$kierunek <- rep(ifelse(po >= przed, "wzrost lub bez zmian", "spadek"), 2)

ci_sredniej <- function(x) mean(x) + c(0, -1, 1) * qt(.975, length(x) - 1) * sd(x) / sqrt(length(x))
sr_p <- aggregate(wynik ~ pomiar, pary, ci_sredniej)
sr_p <- data.frame(pomiar = sr_p$pomiar, M = sr_p$wynik[, 1], dolna = sr_p$wynik[, 2], gorna = sr_p$wynik[, 3])
rys5a <- ggplot(sr_p, aes(pomiar, M)) +
  geom_col(width = 0.55, fill = "grey75", colour = "grey20") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.15) +
  scale_y_continuous(limits = c(0, 40), expand = c(0, 0)) +
  labs(title = "A. Dwa słupki z 95% CI", x = NULL, y = "Wynik testu (0–40 pkt)") + motyw
rys5b <- ggplot(pary, aes(pomiar, wynik, group = osoba)) +
  geom_line(aes(colour = kierunek, linetype = kierunek), linewidth = 0.7) +
  geom_point(size = 1.8, colour = "grey30") +
  scale_colour_manual(values = c("wzrost lub bez zmian" = "#0072B2", spadek = "#D55E00"), name = NULL) +
  scale_linetype_manual(values = c("wzrost lub bez zmian" = "solid", spadek = "22"), name = NULL) +
  scale_y_continuous(limits = c(0, 40), expand = c(0, 0)) +
  labs(title = "B. Linie par (każda osoba)", x = NULL, y = "Wynik testu (0–40 pkt)") + motyw
rys5 <- rys5a + rys5b
# ggsave("porownanie-grup-przed-po.svg", rys5, width = 9, height = 5.4)

# Liczby do opisu: 95% CI każdej średniej (panel A), różnica z 95% CI, ile osób spadło, korelacja przed–po
round(sr_p[, -1], 2)
roznica <- po - przed
tt <- t.test(po, przed, paired = TRUE)
round(c(M_przed = mean(przed), M_po = mean(po), M_roznicy = mean(roznica), SD_roznicy = sd(roznica),
        CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2], t = unname(tt$statistic),
        df = unname(tt$parameter), d_z = mean(roznica) / sd(roznica),
        spadek = sum(roznica < 0), r_przed_po = cor(przed, po)), 3)
format.pval(tt$p.value, digits = 2)
Wynik w R
      M dolna gorna
1 23.60 20.91 26.29
2 26.75 23.55 29.95
   M_przed       M_po  M_roznicy SD_roznicy   CI_dolna   CI_gorna          t         df        d_z
    23.600     26.750      3.150      3.422      1.548      4.752      4.116     19.000      0.920
    spadek r_przed_po
     2.000      0.866
[1] "0.00059"
Bibliografia oprogramowania
Wyniki i rysunki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; pliki SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2025). ggdist: Visualizations of distributions and uncertainty [R package]. https://doi.org/10.5281/zenodo.3879620
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Wąs bez opisu – czytelnik nie wie, czy to SD, SE, czy 95% CI, a długości różnią się kilkukrotnie.
- ± SE zamiast ± SD do opisu rozrzutu – SE maleje z n i nie mówi, jak bardzo różnią się osoby.
- Słupek ze średnią przy rozkładzie dwumodalnym lub skośnym – średnia może leżeć tam, gdzie nie ma nikogo.
- Skrzypce lub chmura bez punktów w małej grupie – gładki kształt sugeruje pewność, której przy 15 wynikach nie ma; krzywa może wyjść poza możliwy zakres.
- Punkty poza wąsami usuwane jako „odstające” tylko dlatego, że pudełko je wyróżniło.
- Dwa niezależne słupki dla pomiaru przed–po – wykres gubi parowanie, a zachodzące przedziały ufności sugerują brak zmiany.
- Brak n – różne liczebności grup zmieniają ocenę każdego wykresu, więc podaj je pod osią lub w nocie.
Najczęstsze pytania
Czy na wykresie słupkowym pokazać błąd standardowy czy odchylenie standardowe?
To zależy od tego, co chcesz pokazać. Odchylenie standardowe (SD) opisuje rozrzut wyników osób, a błąd standardowy (SE = SD / √n) – niepewność średniej. W przykładzie SD było od 3.87 do 9.49 razy dłuższe od SE. Do wnioskowania o średniej lepszy jest 95% przedział ufności. Najważniejsze: w nocie pod rysunkiem napisz, co oznacza wąs.
Jak zrobić wykres raincloud w R w ggplot2?
Złóż go z trzech warstw ggplot2: ggdist::stat_halfeye() (połówka gęstości przesunięta w bok), geom_boxplot() z wąskim pudełkiem i geom_point() z lekkim rozsunięciem po drugiej stronie. Pełny kod jest w przepisie 5 we wpisie.
Wykres pudełkowy czy skrzypcowy – który wybrać do porównania grup?
Pudełko dobrze pokazuje medianę, kwartyle i skośność, ale nie widzi dwóch szczytów: w przykładzie pudełko grupy hybrydowej rozciągało się od 5.00 do 14.65 godziny, choć w środku była jedna osoba. Skrzypce pokazują dwumodalność, ale ukrywają liczebność i mogą wyjść poza możliwy zakres (do −5.5 godziny). W małych grupach dodaj do obu punkty.
Jak pokazać na wykresie pomiar przed i po u tych samych osób?
Narysuj linie par: każda osoba to jedna linia od wyniku przed do wyniku po. Dwa osobne słupki gubią parowanie – w przykładzie przedziały ufności średnich mocno zachodziły na siebie, choć wynik obniżył się tylko u 2 z 20 osób, a średnia zmiana wyniosła 3.15 punktu, 95% CI [1.55, 4.75].
Jaki wykres porównania grup wybrać przy małej liczebności?
Przy kilkunastu–kilkudziesięciu osobach w grupie rysuj wszystkie punkty i obok średnią z 95% przedziałem ufności (albo medianę). Gęstość w skrzypcach czy raincloudzie oszacowana z 15 wyników jest bardzo niepewna, a pudełko z pięciu liczb mówi niewiele. Pod osią podaj n każdej grupy.
Powiązane hasła
Przeczytaj też
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikTabele i rysunki do artykułu
Wymogi czasopism, wykresy z danymi zamiast słupków, kolory czytelne dla daltonistów, eksport z R w 300 dpi i materiały uzupełniające.
Czytaj →PoradnikDane podłużne na wykresie
Wykres spaghetti, średnie z 95% CI i liczbą osób, rzeczywista oś czasu i trajektorie z modelu mieszanego – sześć rysunków z kodem R i podpisami.
Czytaj →Przygotowujesz wykresy do pracy dyplomowej?
Pomożemy dobrać wykres do danych i liczebności grup, przygotować kod w R i napisać podpisy oraz opis wyników tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., van Langen, J., & Kievit, R. A. (2021). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, Article 63. https://doi.org/10.12688/wellcomeopenres.15191.2 ● Otwarty dostęp
- Belia, S., Fidler, F., Williams, J., & Cumming, G. (2005). Researchers misunderstand confidence intervals and standard error bars. Psychological Methods, 10(4), 389–396. https://doi.org/10.1037/1082-989x.10.4.389
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141 ● Otwarty dostęp
- Hintze, J. L., & Nelson, R. D. (1998). Violin plots: A box plot-density trace synergism. The American Statistician, 52(2), 181–184. https://doi.org/10.1080/00031305.1998.10480559
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Weissgerber, T. L., Winham, S. J., Heinzen, E. P., Milin-Lazovic, J. S., Garcia-Valencia, O., Bukumiric, Z., Savic, M. D., Garovic, V. D., & Milic, N. M. (2019). Reveal, don’t conceal: Transforming data visualization to improve transparency. Circulation, 140(18), 1506–1518. https://doi.org/10.1161/circulationaha.118.037777 ● Otwarty dostęp
Cytowania BibTeX
@article{allen2021raincloud, author={Allen, Micah and Poggiali, Davide and Whitaker, Kirstie and Marshall, Tom Rhys and van Langen, Jordy and Kievit, Rogier A.}, title={{Raincloud plots: A multi-platform tool for robust data visualization}}, journal={Wellcome Open Research}, year={2021}, volume={4}, eid={63}, doi={10.12688/wellcomeopenres.15191.2}}@article{belia2005researchers, author={Belia, Sarah and Fidler, Fiona and Williams, Jennifer and Cumming, Geoff}, title={{Researchers misunderstand confidence intervals and standard error bars}}, journal={Psychological Methods}, year={2005}, volume={10}, number={4}, pages={389--396}, doi={10.1037/1082-989x.10.4.389}}@article{cumming2007error, author={Cumming, Geoff and Fidler, Fiona and Vaux, David L.}, title={{Error bars in experimental biology}}, journal={Journal of Cell Biology}, year={2007}, volume={177}, number={1}, pages={7--11}, doi={10.1083/jcb.200611141}}@article{hintze1998violin, author={Hintze, Jerry L. and Nelson, Ray D.}, title={{Violin plots: A box plot-density trace synergism}}, journal={The American Statistician}, year={1998}, volume={52}, number={2}, pages={181--184}, doi={10.1080/00031305.1998.10480559}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{weissgerber2019reveal, author={Weissgerber, Tracey L. and Winham, Stacey J. and Heinzen, Ethan P. and Milin-Lazovic, Jelena S. and Garcia-Valencia, Oscar and Bukumiric, Zoran and Savic, Marko D. and Garovic, Vesna D. and Milic, Natasa M.}, title={{Reveal, don’t conceal: Transforming data visualization to improve transparency}}, journal={Circulation}, year={2019}, volume={140}, number={18}, pages={1506--1518}, doi={10.1161/circulationaha.118.037777}}