Po co rysować, skoro wszystko jest policzone
Średnia, odchylenie standardowe, korelacja Pearsona i prosta regresji to streszczenia. Każde z nich gubi część informacji, a tabela złożona z samych streszczeń może wyglądać tak samo dla zupełnie różnych danych. Wykres pokazuje, czy liczba, którą zaraz wpiszesz do pracy, w ogóle opisuje Twoje dane.
Ten wpis prowadzi przez pięć rysunków: klasyczny kwartet Anscombe’a i cztery własne symulacje typowych pułapek. Przy każdym rysunku znajdziesz ten sam układ: co widać, czego wykres nie pokazuje, gotowy podpis do pracy i zdanie do Wyników. Ogólnych zasad (jaki typ wykresu, osie, numeracja) nie powtarzam – są we wpisach wykresy w pracy dyplomowej i tabele i rysunki do artykułu. Budowę samego wykresu rozrzutu opisuje hasło w słowniku. Pełny kod wszystkich rysunków jest w sekcji Kod R.
W podpisach stosuję układ APA 7: w pracy numer rysunku pogrub, a tytuł zapisz kursywą w osobnym wierszu nad rysunkiem; notę („Uwaga.”) umieść pod rysunkiem. W ramkach do skopiowania wszystko jest w jednym ciągu – podziel tekst w Wordzie.
Kwartet Anscombe’a: jedna tabela, cztery obrazy
Anscombe (1973) ułożył cztery zbiory po 11 par x–y, które w R są dostępne jako zbiór anscombe. Przepis 1 liczy dla nich statystyki, które zwykle trafiają do tabeli.
| Statystyka | Zbiór 1 | Zbiór 2 | Zbiór 3 | Zbiór 4 |
|---|---|---|---|---|
| M (SD) dla x | 9.00 (3.32) | 9.00 (3.32) | 9.00 (3.32) | 9.00 (3.32) |
| M (SD) dla y | 7.50 (2.03) | 7.50 (2.03) | 7.50 (2.03) | 7.50 (2.03) |
| r Pearsona | .82 | .82 | .82 | .82 |
| Prosta regresji | y = 3.00 + 0.50x | y = 3.00 + 0.50x | y = 3.00 + 0.50x | y = 3.00 + 0.50x |
| R² | .67 | .67 | .67 | .67 |
| p dla r | .002 | .002 | .002 | .002 |
| ρ Spearmana | .82 | .69 | .99 | .50 |
Wartości z wydruku R różnią się między zbiorami najwyżej na trzecim miejscu po przecinku (np. r = .816 albo .817). Jedyny sygnał ostrzegawczy to ostatni wiersz: korelacja Spearmana waha się od .50 do .99. Nie mówi jednak, co jest nie tak – to widać dopiero na rysunku.
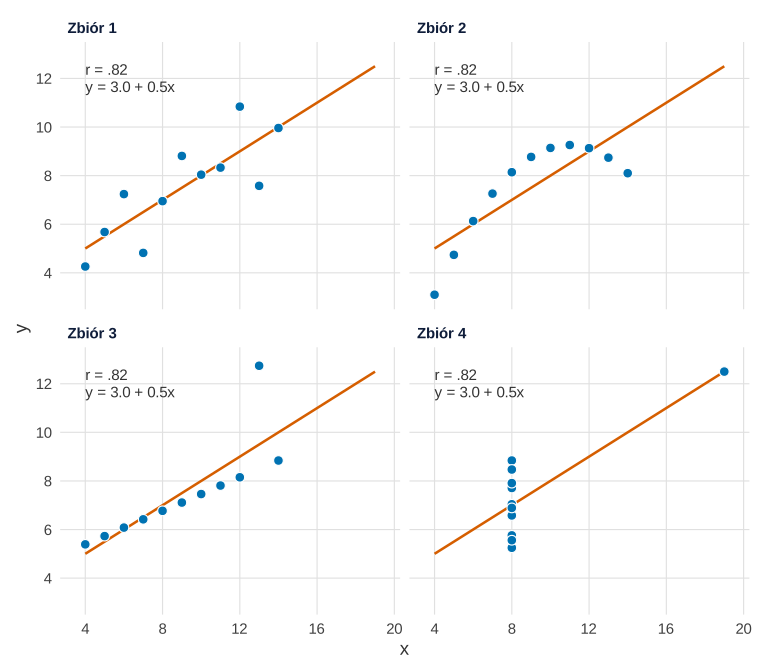
Co widać. Tylko zbiór 1 wygląda tak, jak „obiecuje” tabela: punkty rozrzucone wokół prostej. W zbiorze 2 punkty leżą na łuku, więc prosta jest złym modelem, choć r wynosi .82. W zbiorze 3 dziesięć punktów leży niemal idealnie na jednej prostej (stąd ρ = .99), a jeden punkt odstaje wysoko nad nimi i to on zmienia prostą. W zbiorze 4 zmienna x nie zmienia się wcale – oprócz jednej obserwacji przy x = 19, która sama wyznacza nachylenie.
Czego ten wykres nie pokazuje. Nie mówi, co zrobić z problemem – to decyzja merytoryczna, nie graficzna. Przy 11 punktach każdy wzór łatwo zobaczyć; w prawdziwych danych z setkami osób te same kłopoty bywają ukryte w chmurze punktów, dlatego przy dużym N dodaj przezroczystość albo krzywą wygładzoną (LOESS). Wreszcie: identyczna linia we wszystkich panelach może sugerować, że model jest „ten sam” – a w trzech zbiorach z czterech nie powinno się go w ogóle raportować.
Podpis do pracy.
Zdanie do Wyników. Tak opisałbyś zbiór 3, gdyby to były Twoje dane:
Pułapka 1: jedna osoba tworzy korelację
Przykład (dane symulowane): 24 studentów podało, ile godzin tygodniowo grają w gry wideo, i rozwiązało test rotacji umysłowej (0–24 pkt). Do danych trafia jeszcze jedna osoba: 42 godziny gry i 23 punkty. Policzona na 25 osobach korelacja jest „istotna”: r(23) = .47, 95% CI [.09, .73], p = .018. Bez tej osoby: r(22) = −.15, 95% CI [−.52, .27], p = .492.
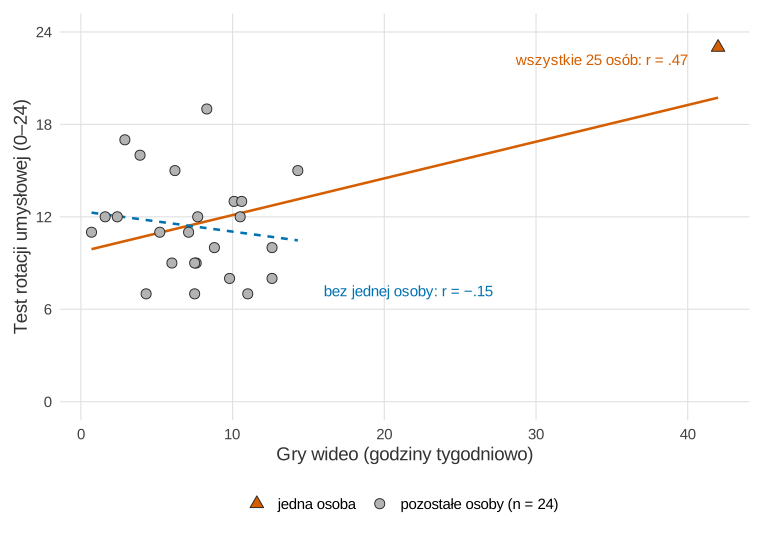
Co widać. W grupie 24 osób nie ma żadnego wzoru. Całe nachylenie ciągłej prostej bierze się z jednego punktu, który leży daleko na osi x – ma dużą dźwignię. Jego odległość Cooka wynosi 8.22, a korelacja Spearmana na 25 osobach to ρ = −.004, czyli praktycznie zero: rangi nie „widzą”, jak bardzo skrajna jest ta osoba.
Czego ten wykres nie pokazuje. Nie powie, czy ta osoba to błąd (np. 42 zamiast 4.2), czy prawdziwy, rzadki przypadek. Nie rozstrzyga też, czy ją usunąć. Aguinis i in. (2013) pokazują, że różne sposoby definiowania i usuwania obserwacji odstających zmieniają wnioski merytoryczne. Dlatego reguły ustal przed analizą i pokaż wynik z tą osobą i bez niej – procedurę krok po kroku opisuje wpis o wartościach odstających.
Podpis do pracy.
Zdanie do Wyników.
Pułapka 2: dwie grupy w jednej chmurze
Przykład (dane symulowane): 120 osób rozwiązało test logiczny w jednej z dwóch wersji – łatwej albo trudnej (po 60 osób). Mierzymy czas rozwiązywania i liczbę poprawnych odpowiedzi (0–20). W całej próbie korelacja jest wyraźnie ujemna: r(118) = −.68, 95% CI [−.76, −.57], p < .001. Wniosek „kto dłużej myśli, ten gorzej wypada” byłby jednak odwrotny do tego, co dzieje się w każdej wersji.
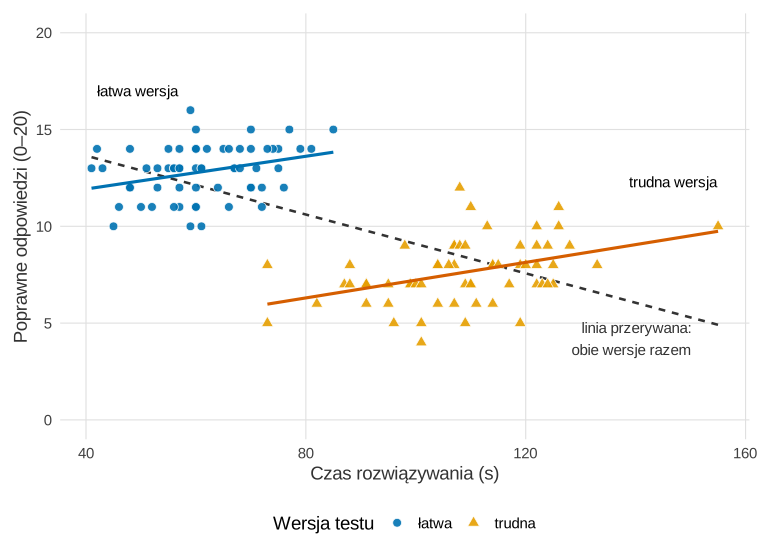
Co widać. W obu wersjach dłuższy czas idzie w parze z lepszym wynikiem: r = .31 w łatwej i .42 w trudnej. Ujemna korelacja w całej próbie bierze się z różnicy między wersjami: trudną rozwiązywano średnio 108.67 s z wynikiem 7.62 poprawnej odpowiedzi, łatwą – 61.45 s z wynikiem 12.83. To paradoks Simpsona na wykresie rozrzutu. W modelu z wersją testu nachylenie zmienia znak: z −0.076 na +0.045 punktu na sekundę.
Czego ten wykres nie pokazuje. Grupy widać tylko dlatego, że oznaczyłeś je kształtem i kolorem. Grupy, której nie zmierzyłeś (np. różne sale albo pory badania), żaden wykres nie ujawni. Kievit i in. (2013) pokazują, że ten paradoks w psychologii zdarza się częściej, niż się sądzi, zwłaszcza przy przenoszeniu wniosków między poziomami (populacja → podgrupy → osoby). Wykres nie mówi też, czy wersja testu to zmienna zakłócająca, którą trzeba kontrolować – o tym decyduje wiedza o przyczynach (zob. korelacja a przyczynowość).
Podpis do pracy.
Zdanie do Wyników.
Pułapka 3: związek jest, a r wynosi prawie zero
Przykład (dane symulowane): 120 studentów oceniło swój stres przed wystąpieniem (0–10), a prowadzący ocenił wystąpienie. Korelacja liniowa: r = .02, p = .804. Zdanie „stres nie miał związku z jakością wystąpienia” byłoby jednak fałszywe.
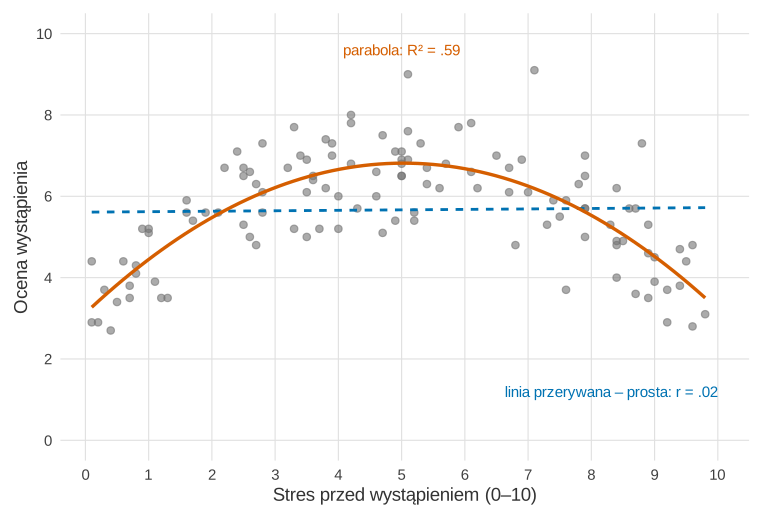
Co widać. Wyniki rosną do średniego poziomu stresu i spadają przy wysokim – kształt odwróconego U. Prosta jest pozioma, bo rosnąca i malejąca połowa się znoszą. Model kwadratowy wyjaśnia 59% wariancji (R² = .59 wobec .001 dla prostej), a dodanie kwadratu stresu poprawia dopasowanie: F(1, 117) = 170.64, p < .001. Jak taki model zbudować i zinterpretować, opisuje hasło regresja krzywoliniowa.
Czego ten wykres nie pokazuje. Parabola to Twój wybór, nie odkrycie – wykres nie dowodzi, że kształt jest dokładnie kwadratowy ani gdzie leży szczyt. Na krańcach skali punktów jest mniej, więc krzywa jest tam najmniej pewna. I nadal są to dane korelacyjne: wykres nie pokaże, czy stres obniża jakość wystąpienia, czy słabiej przygotowane osoby bardziej się stresują.
Podpis do pracy.
Zdanie do Wyników.
Pułapka 4: ograniczony zakres
Przykład (dane symulowane): 400 kandydatów napisało test rekrutacyjny (0–100). Przyjęto osoby z wynikiem co najmniej 67 punktów – górną ćwiartkę, a z remisami 110 osób. Po roku badacz ma średnie ocen tylko przyjętych i sprawdza, czy test je przewiduje: r(108) = .29, 95% CI [.10, .45], p = .002. W całej grupie kandydatów korelacja wynosiłaby .44 (w populacji, z której losowano, .50).
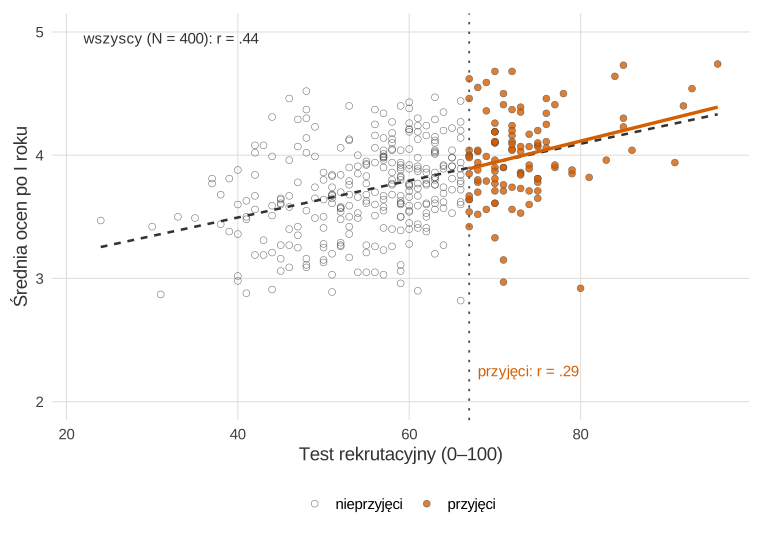
Co widać. Przyjęci zajmują wąski pas osi x: odchylenie standardowe wyniku testu spada z 11.05 do 5.84. W tak wąskim pasie rozrzut ocen przy podobnym wyniku testu dominuje nad różnicami wyjaśnianymi przez test, więc korelacja słabnie. Klasyczna poprawka dla selekcji bezpośrednio po x odtwarza w tym przykładzie r = .49. Sackett i Yang (2000) pokazują jednak, że właściwa poprawka zależy od tego, po jakiej zmiennej nastąpiła selekcja i czy znasz wariancję bez ograniczenia – nie stosuj jej mechanicznie.
Czego ten wykres nie pokazuje. Rysunek 5 da się narysować tylko w symulacji. W prawdziwym badaniu pustych kółek nie masz, a chmura pełnych kółek wygląda po prostu jak słaby związek. Dlatego porównaj SD i zakres zmiennej w próbie z normami albo z populacją, o której chcesz wnioskować. Ten sam mechanizm działa w badaniach na studentach (wąski zakres wieku czy wykształcenia – zob. badanie na studentach) i jest odmianą błędu selekcji.
Podpis do pracy.
Zdanie do Wyników (i do ograniczeń):
Co narysować, zanim policzysz – lista do pracy
Te same statystyki mogą opisywać dowolnie różne dane. Matejka i Fitzmaurice (2017) przedstawili metodę, która, startując od jednego zbioru i stopniowo przesuwając punkty, tworzy kolejne zbiory o tych samych statystykach i zupełnie innym wyglądzie. Wniosek dla pracy jest prosty: zanim wpiszesz liczbę do tabeli, obejrzyj rysunek, który może jej zaprzeczyć.
| Zanim policzysz… | Narysuj | Szukaj |
|---|---|---|
| korelację lub regresję prostą | wykres rozrzutu, grupy oznaczone kształtem | krzywizny, punktów o dużej dźwigni, osobnych chmur, wąskiego zakresu |
| regresję wieloraką | reszty względem wartości przewidywanych | łuku, lejka, pojedynczych dużych reszt (zob. diagnostyka regresji w R) |
| porównanie średnich grup | punkty z rozkładem zamiast samego słupka | dwumodalności, skośności, różnych n (zob. od słupka do raincloud) |
| analizę pomiarów powtarzanych | linie poszczególnych osób | różnych typów zmian ukrytych pod średnią (zob. dane podłużne na wykresie) |
| dowolną analizę ankiety | mapę braków danych | bloków braków, porzuceń w połowie (zob. braki danych na wykresie) |
| macierz korelacji | macierz wykresów rozrzutu dla kluczowych zmiennych | efektu sufitu i nieliniowości (zob. korelacje na wykresie) |
Po analizie pokaż wynik modelu na wykresie przewidywań, nie tylko w tabeli współczynników – jak to zrobić, opisuje wpis wynik regresji na wykresie. Rysunki z listy są przede wszystkim dla Ciebie; do pracy wybierz te, które pokazują coś, czego nie oddaje tabela.
Kolory. Wszystkie rysunki używają palety Okabe–Ito, a różnice między grupami niesie też kształt punktu lub rodzaj linii. Czerwono-zielone zestawienia są nieczytelne dla części osób z zaburzeniami widzenia barw (Crameri i in., 2020). W przepisie 6 sprawdzam to symulacją deuteranopii: odległość barw dla pary niebieski–cynober prawie się nie zmienia (z 114.6 na 108.3 w ΔE), a dla pary czerwony–zielony spada ze 121.7 do 21.1. Więcej o kolorach – we wpisie o rysunkach do artykułu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje paletę, motyw i funkcję bez_zera(), z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu przepisu 1. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane symulowane nie wymagają pobierania – kod sam je tworzy. Dla wygody są też w pliku kwartet-anscombea-dane-symulowane.csv (kolumny przyklad, x, y, grupa). Ziarno losowania 560 ustalono z góry, jednakowe we wszystkich przepisach, bez dobierania pod wynik. Parametry symulacji (dopisana osoba z 42 godzinami gry, średnie w wersjach testu, współczynniki paraboli, korelacja .50 i selekcja górnej ćwiartki) dobrano ręcznie, żeby każda pułapka była wyraźnie widoczna.
1. Kwartet Anscombe’a: statystyki i Rysunek 1
R
# Kwartet Anscombe'a: zbiór anscombe z bazowego R – statystyki i rysunek
library(ggplot2)
# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw) i prosty motyw
okabe <- c(niebieski = "#0072B2", cynober = "#D55E00", zielony = "#009E73",
           pomarancz = "#E69F00", szary = "grey50")
theme_set(theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", hjust = 0)))
bez_zera <- function(x, d = 2)            # zapis APA: ".82", "−.15" (bez zera, z minusem typograficznym)
  sub("-", "−", sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x)))

ans <- data.frame(zbior = rep(paste("Zbiór", 1:4), each = 11),
                  x = unlist(anscombe[1:4]), y = unlist(anscombe[5:8]))
staty <- sapply(split(ans, ans$zbior), function(d) {
  m <- lm(y ~ x, data = d)
  c(M_x = mean(d$x), SD_x = sd(d$x), M_y = mean(d$y), SD_y = sd(d$y),
    r = cor(d$x, d$y), b0 = coef(m)[[1]], b1 = coef(m)[[2]],
    R2 = summary(m)$r.squared, p = cor.test(d$x, d$y)$p.value,
    rho = cor(d$x, d$y, method = "spearman"))
})
round(staty, 3)

etykiety <- data.frame(zbior = colnames(staty),
                       tekst = paste0("r = ", bez_zera(staty["r", ]), "\ny = 3.0 + 0.5x"))
p1 <- ggplot(ans, aes(x, y)) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, fullrange = TRUE,
              colour = okabe[["cynober"]], linewidth = 0.9) +
  geom_point(shape = 21, size = 3, fill = okabe[["niebieski"]], colour = "white", stroke = 0.6) +
  geom_text(data = etykiety, aes(x = 4, y = 12.6, label = tekst), hjust = 0, vjust = 1,
            size = 4, lineheight = 0.95, colour = "grey20") +
  facet_wrap(~ zbior, ncol = 2) +
  scale_x_continuous(breaks = seq(4, 20, 4)) +
  scale_y_continuous(breaks = seq(4, 12, 2)) +
  coord_cartesian(xlim = c(3.5, 19.5), ylim = c(3, 13)) +
  labs(x = "x", y = "y")
p1
# ggsave("kwartet-anscombea.svg", p1, width = 8, height = 7)   # zapis do pliku (pakiet svglite)
Wynik w R
     Zbiór 1 Zbiór 2 Zbiór 3 Zbiór 4
M_x    9.000   9.000   9.000   9.000
SD_x   3.317   3.317   3.317   3.317
M_y    7.501   7.501   7.500   7.501
SD_y   2.032   2.032   2.030   2.031
r      0.816   0.816   0.816   0.817
b0     3.000   3.001   3.002   3.002
b1     0.500   0.500   0.500   0.500
R2     0.667   0.666   0.666   0.667
p      0.002   0.002   0.002   0.002
rho    0.818   0.691   0.991   0.500
2. Jedna osoba tworzy korelację: Rysunek 2
R
# Jedna osoba tworzy korelację: czas gier wideo a wynik testu rotacji umysłowej (dane symulowane)
set.seed(560)
n <- 24
odst <- data.frame(gry = round(runif(n, 0, 15), 1),                       # godziny tygodniowo
                   rotacja = round(pmin(pmax(rnorm(n, 12, 3.5), 0), 24)), # wynik testu 0–24
                   kto = "pozostałe osoby (n = 24)")
odst <- rbind(odst, data.frame(gry = 42, rotacja = 23, kto = "jedna osoba"))
bez <- subset(odst, kto != "jedna osoba")
z_nia <- cor.test(~ gry + rotacja, data = odst); bez_niej <- cor.test(~ gry + rotacja, data = bez)
wiersz <- function(ct) c(r = unname(ct$estimate), CI_dolna = ct$conf.int[1], CI_gorna = ct$conf.int[2],
                        df = unname(ct$parameter), p = ct$p.value)
round(rbind(z_nia = wiersz(z_nia), bez_niej = wiersz(bez_niej)), 3)
round(c(rho_z_nia = cor(odst$gry, odst$rotacja, method = "spearman"),
        cook_tej_osoby = cooks.distance(lm(rotacja ~ gry, data = odst))[[25]]), 3)

p2 <- ggplot(odst, aes(gry, rotacja)) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, fullrange = TRUE,
              colour = okabe[["cynober"]], linewidth = 0.9) +
  geom_smooth(data = bez, method = "lm", formula = y ~ x, se = FALSE,
              colour = okabe[["niebieski"]], linewidth = 0.9, linetype = "22") +
  geom_point(aes(shape = kto, fill = kto), size = 3.2, colour = "grey15", stroke = 0.5) +
  scale_shape_manual(values = c("pozostałe osoby (n = 24)" = 21, "jedna osoba" = 24), name = NULL) +
  scale_fill_manual(values = c("pozostałe osoby (n = 24)" = "grey70", "jedna osoba" = okabe[["cynober"]]),
                    name = NULL) +
  annotate("text", x = 40, y = 22.2, hjust = 1, size = 4, colour = okabe[["cynober"]],
           label = paste0("wszystkie 25 osób: r = ", bez_zera(z_nia$estimate))) +
  annotate("text", x = 16, y = 7.2, hjust = 0, size = 4, colour = okabe[["niebieski"]],
           label = paste0("bez jednej osoby: r = ", bez_zera(bez_niej$estimate))) +
  scale_x_continuous(breaks = seq(0, 40, 10)) +
  scale_y_continuous(limits = c(0, 24), breaks = seq(0, 24, 6)) +
  labs(x = "Gry wideo (godziny tygodniowo)", y = "Test rotacji umysłowej (0–24)")
p2
Wynik w R
              r CI_dolna CI_gorna df     p
z_nia     0.468    0.089    0.728 23 0.018
bez_niej -0.147   -0.520    0.272 22 0.492
     rho_z_nia cook_tej_osoby
        -0.004          8.217
3. Dwie grupy w jednej chmurze: Rysunek 3
R
# Dwie grupy w jednej chmurze: czas rozwiązywania a liczba poprawnych odpowiedzi (dane symulowane)
set.seed(560)
wersja <- rep(c("łatwa", "trudna"), each = 60)
czas <- round(ifelse(wersja == "łatwa", rnorm(120, 60, 12), rnorm(120, 110, 15)))   # sekundy
poprawne <- ifelse(wersja == "łatwa", 8 + 0.08 * czas, 1 + 0.06 * czas) + rnorm(120, 0, 1.5)
simp <- data.frame(wersja = factor(wersja), czas, poprawne = round(pmin(pmax(poprawne, 0), 20)))
korelacja <- function(d) { ct <- cor.test(d$czas, d$poprawne)
  c(r = unname(ct$estimate), CI_dolna = ct$conf.int[1], CI_gorna = ct$conf.int[2], df = unname(ct$parameter), p = ct$p.value) }
round(rbind(razem = korelacja(simp), t(sapply(split(simp, simp$wersja), korelacja))), 4)
round(c(nachylenie_razem = coef(lm(poprawne ~ czas, data = simp))[["czas"]],
        nachylenie_w_wersjach = coef(lm(poprawne ~ czas + wersja, data = simp))[["czas"]]), 3)
aggregate(cbind(czas, poprawne) ~ wersja, data = simp, FUN = mean)

p3 <- ggplot(simp, aes(czas, poprawne)) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "grey20",
              linewidth = 0.9, linetype = "22") +
  geom_point(aes(shape = wersja, fill = wersja), size = 2.8, colour = "white", stroke = 0.4, alpha = 0.9) +
  geom_smooth(aes(colour = wersja), method = "lm", formula = y ~ x, se = FALSE, linewidth = 1.1) +
  scale_shape_manual(values = c("łatwa" = 21, "trudna" = 24), name = "Wersja testu") +
  scale_fill_manual(values = c("łatwa" = okabe[["niebieski"]], "trudna" = okabe[["pomarancz"]]),
                    name = "Wersja testu") +
  scale_colour_manual(values = c("łatwa" = okabe[["niebieski"]], "trudna" = okabe[["cynober"]]),
                      guide = "none") +
  annotate("text", x = 42, y = 17, hjust = 0, size = 4, label = "łatwa wersja") +
  annotate("text", x = 155, y = 12.3, hjust = 1, size = 4, label = "trudna wersja") +
  annotate("text", x = 150, y = 4.2, hjust = 1, size = 4, colour = "grey20",
           label = "linia przerywana:\nobie wersje razem") +
  scale_y_continuous(limits = c(0, 20), breaks = seq(0, 20, 5)) +
  labs(x = "Czas rozwiązywania (s)", y = "Poprawne odpowiedzi (0–20)")
p3
Wynik w R
             r CI_dolna CI_gorna  df      p
razem  -0.6764  -0.7631  -0.5657 118 0.0000
łatwa   0.3127   0.0638   0.5249  58 0.0150
trudna  0.4186   0.1843   0.6079  58 0.0009
     nachylenie_razem nachylenie_w_wersjach
               -0.076                 0.045
  wersja     czas  poprawne
1  łatwa  61.4500 12.833333
2 trudna 108.6667  7.616667
4. Związek krzywoliniowy przy r ≈ 0: Rysunek 4
R
# Zależność w kształcie odwróconego U przy r bliskim 0: stres przed wystąpieniem a jego ocena (dane symulowane)
set.seed(560)
stres <- round(runif(120, 0, 10), 1)                                   # samoocena stresu 0–10
ocena <- round(3 + 1.6 * stres - 0.16 * stres^2 + rnorm(120, 0, 1), 1) # ocena wystąpienia
krzyw <- data.frame(stres, ocena)
liniowy <- lm(ocena ~ stres, data = krzyw)
kwadratowy <- lm(ocena ~ stres + I(stres^2), data = krzyw)
lin <- cor.test(krzyw$stres, krzyw$ocena)
round(c(r = unname(lin$estimate), p = lin$p.value,
        R2_liniowy = summary(liniowy)$r.squared, R2_kwadratowy = summary(kwadratowy)$r.squared), 3)
anova(liniowy, kwadratowy)

p4 <- ggplot(krzyw, aes(stres, ocena)) +
  geom_point(colour = "grey45", alpha = 0.6, size = 2.2) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = okabe[["niebieski"]],
              linewidth = 1, linetype = "22") +
  geom_smooth(method = "lm", formula = y ~ x + I(x^2), se = FALSE,
              colour = okabe[["cynober"]], linewidth = 1.2) +
  annotate("text", x = 10, y = 1.2, hjust = 1, size = 4, colour = okabe[["niebieski"]],
           label = paste0("linia przerywana – prosta: r = ", bez_zera(lin$estimate))) +
  annotate("text", x = 5, y = 9.6, size = 4, colour = okabe[["cynober"]],
           label = paste0("parabola: R² = ", bez_zera(summary(kwadratowy)$r.squared))) +
  scale_x_continuous(breaks = 0:10) +
  scale_y_continuous(limits = c(0, 10), breaks = seq(0, 10, 2)) +
  labs(x = "Stres przed wystąpieniem (0–10)", y = "Ocena wystąpienia")
p4
Wynik w R
            r             p    R2_liniowy R2_kwadratowy
        0.023         0.804         0.001         0.593
Analysis of Variance Table

Model 1: ocena ~ stres
Model 2: ocena ~ stres + I(stres^2)
  Res.Df     RSS Df Sum of Sq      F    Pr(>F)
1    118 227.990
2    117  92.736  1    135.25 170.64 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
5. Ograniczony zakres: Rysunek 5
R
# Ograniczony zakres: test rekrutacyjny a średnia ocen tylko wśród przyjętych (dane symulowane)
set.seed(560)
z1 <- rnorm(400); z2 <- 0.5 * z1 + sqrt(1 - 0.5^2) * rnorm(400)        # korelacja w populacji .50
rekr <- data.frame(test = round(pmin(pmax(60 + 12 * z1, 0), 100)),       # test rekrutacyjny 0–100
                   srednia = round(pmin(pmax(3.8 + 0.4 * z2, 2), 5), 2))  # średnia ocen 2–5
prog <- quantile(rekr$test, 0.75)                                         # przyjęto górne 25%
rekr$grupa <- ifelse(rekr$test >= prog, "przyjęci", "nieprzyjęci")
przyj <- subset(rekr, grupa == "przyjęci")
r_wszyscy <- cor(rekr$test, rekr$srednia); r_przyjeci <- cor(przyj$test, przyj$srednia)
u <- sd(rekr$test) / sd(przyj$test)                                       # ile razy węższy zakres
r_skor <- r_przyjeci * u / sqrt(1 + r_przyjeci^2 * (u^2 - 1))             # korekta (selekcja po x)
round(c(prog = unname(prog), n_przyjetych = nrow(przyj), SD_wszyscy = sd(rekr$test),
        SD_przyjeci = sd(przyj$test), r_skorygowane = r_skor), 3)
ci <- function(d) { ct <- cor.test(d$test, d$srednia)
  c(r = unname(ct$estimate), CI_dolna = ct$conf.int[1], CI_gorna = ct$conf.int[2], df = unname(ct$parameter), p = ct$p.value) }
round(rbind(wszyscy = ci(rekr), przyjeci = ci(przyj)), 4)

p5 <- ggplot(rekr, aes(test, srednia)) +
  geom_vline(xintercept = prog, linetype = "dotted", colour = "grey30") +
  geom_point(aes(shape = grupa, fill = grupa), size = 2.2, colour = "grey30", stroke = 0.3, alpha = 0.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "grey20",
              linewidth = 0.9, linetype = "22") +
  geom_smooth(data = przyj, method = "lm", formula = y ~ x, se = FALSE,
              colour = okabe[["cynober"]], linewidth = 1.2) +
  scale_shape_manual(values = c("nieprzyjęci" = 1, "przyjęci" = 21), name = NULL) +
  scale_fill_manual(values = c("nieprzyjęci" = NA, "przyjęci" = okabe[["cynober"]]), name = NULL) +
  annotate("text", x = 22, y = 4.95, hjust = 0, size = 4, colour = "grey20",
           label = paste0("wszyscy (N = 400): r = ", bez_zera(r_wszyscy))) +
  annotate("text", x = prog + 1, y = 2.25, hjust = 0, size = 4, colour = okabe[["cynober"]],
           label = paste0("przyjęci: r = ", bez_zera(r_przyjeci))) +
  scale_y_continuous(limits = c(2, 5)) +
  labs(x = "Test rekrutacyjny (0–100)", y = "Średnia ocen po I roku")
p5
Wynik w R
         prog  n_przyjetych    SD_wszyscy   SD_przyjeci r_skorygowane
       67.000       110.000        11.052         5.843         0.492
              r CI_dolna CI_gorna  df      p
wszyscy  0.4351   0.3521   0.5114 398 0.0000
przyjeci 0.2862   0.1046   0.4494 108 0.0024
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańcz" = c("#0072B2", "#E69F00"),
             "szary – cynober" = c("#B3B3B3", "#D55E00"),
             "czerwony – zielony" = c("#E41A1C", "#4DAF4A"))   # dla porównania: para do unikania
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                      widzenie_typowe deuteranopia protanopia
niebieski – cynober             114.6        108.3       91.9
niebieski – pomarańcz           120.2        121.5      109.3
szary – cynober                  78.9         64.4       59.5
czerwony – zielony              121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Tabela korelacji bez jednego wykresu rozrzutu – zwłaszcza gdy korelacje są zaskakująco wysokie albo bliskie zera.
- „Brak związku”, gdy r ≈ 0 – r mierzy tylko związek liniowy; napisz „brak związku liniowego” i pokaż wykres.
- Usunięcie jednej osoby bez reguły i bez wyniku sprzed usunięcia. Podaj oba wyniki i powód.
- Jedna chmura punktów dla kilku grup (wersje testu, płeć, kierunki) bez oznaczenia grup kształtem lub kolorem.
- Wniosek o całej populacji z wąskiej, wyselekcjonowanej próby bez porównania zakresu i SD z populacją.
- Kolor jako jedyny nośnik informacji i para czerwony–zielony – po wydruku w skali szarości lub dla części czytelników grupy się zlewają.
- Prosta regresji narysowana „z automatu” na danych, które jej nie pasują (zbiory 2–4 Anscombe’a).
Najczęstsze pytania
Dlaczego przed obliczeniem korelacji trzeba narysować wykres rozrzutu?
Bo ten sam współczynnik r może opisywać bardzo różne dane. W kwartecie Anscombe’a cztery zbiory mają r = .82 i tę samą prostą regresji, a tylko jeden pasuje do modelu liniowego. Wykres pokazuje krzywiznę, obserwacje odstające, osobne grupy i wąski zakres, których liczba nie ujawni.
Czy jedna osoba może sprawić, że korelacja będzie istotna?
Tak, jeśli leży daleko od pozostałych na osi x (ma dużą dźwignię). W przykładzie na tej stronie 24 osoby nie wykazywały związku, r = −.15, a po dopisaniu jednej osoby korelacja wyniosła r = .47, p = .018. Podaj wtedy wynik z tą osobą i bez niej oraz regułę decyzji.
Czy korelacja bliska zera oznacza brak związku między zmiennymi?
Nie. Korelacja Pearsona mierzy tylko związek liniowy. Przy zależności w kształcie odwróconego U wartości rosną, a potem maleją, więc r może być bliskie zera, choć model kwadratowy wyjaśnia dużą część wariancji. Pisz „brak związku liniowego” i pokaż wykres rozrzutu.
Dlaczego korelacja w wyselekcjonowanej grupie jest niższa?
Bo selekcja zawęża zakres zmiennej. Gdy badasz tylko przyjętych z wysokim wynikiem testu, różnice w teście są małe w porównaniu z rozrzutem drugiej zmiennej, więc korelacja słabnie. W ograniczeniach porównaj SD w próbie z populacją; poprawki na ograniczony zakres zależą od tego, po jakiej zmiennej nastąpiła selekcja.
Co napisać pod wykresem rozrzutu w pracy?
W stylu APA 7 nad rysunkiem podaj pogrubiony numer i tytuł kursywą, a pod rysunkiem notę zaczynającą się od „Uwaga.”: liczebność, znaczenie symboli i linii (np. prosta regresji, grupy oznaczone kształtem) oraz źródło danych, jeśli nie są Twoje. W tekście Wyników odwołaj się do rysunku i napisz jednym zdaniem, co z niego wynika.
Powiązane hasła
Przeczytaj też
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikKorelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →PoradnikWynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →Nie wiesz, co pokazują Twoje wykresy?
Pomożemy obejrzeć dane przed analizą, wychwycić obserwacje wpływowe, ukryte grupy i nieliniowość oraz przygotować rysunki z podpisami do pracy – tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aguinis, H., Gottfredson, R. K., & Joo, H. (2013). Best-practice recommendations for defining, identifying, and handling outliers. Organizational Research Methods, 16(2), 270–301. https://doi.org/10.1177/1094428112470848
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- Matejka, J., & Fitzmaurice, G. (2017). Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing. In Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems (pp. 1290–1294). Association for Computing Machinery. https://doi.org/10.1145/3025453.3025912
- Sackett, P. R., & Yang, H. (2000). Correction for range restriction: An expanded typology. Journal of Applied Psychology, 85(1), 112–118. https://doi.org/10.1037/0021-9010.85.1.112
Cytowania BibTeX
@article{aguinis2013best, author={Aguinis, Herman and Gottfredson, Ryan K. and Joo, Harry}, title={{Best-practice recommendations for defining, identifying, and handling outliers}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={2}, pages={270--301}, doi={10.1177/1094428112470848}}@article{anscombe1973graphs, author={Anscombe, Francis J.}, title={{Graphs in statistical analysis}}, journal={The American Statistician}, year={1973}, volume={27}, number={1}, pages={17--21}, doi={10.1080/00031305.1973.10478966}}@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@inproceedings{matejka2017same, author={Matejka, Justin and Fitzmaurice, George}, title={{Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing}}, booktitle={Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems}, year={2017}, pages={1290--1294}, publisher={Association for Computing Machinery}, doi={10.1145/3025453.3025912}}@article{sackett2000correction, author={Sackett, Paul R. and Yang, Hyuckseung}, title={{Correction for range restriction: An expanded typology}}, journal={Journal of Applied Psychology}, year={2000}, volume={85}, number={1}, pages={112--118}, doi={10.1037/0021-9010.85.1.112}}