Diagnostyka to część analizy
Recenzenci coraz częściej pytają, jak sprawdzono założenia modelu. W przeglądzie 12 czasopism psychologii klinicznej Ernst i Albers (2017) ustalili, że 92% artykułów z regresją liniową nie raportowało jasno sprawdzania założeń. Część autorów badała przy tym normalność zmiennych zamiast reszt. Williams i in. (2013) przypominają, że założenie normalności dotyczy błędów modelu, a nie predyktorów ani zmiennej zależnej.
Ten wpis zakłada, że znasz model i jego założenia z poradnika regresja wieloraka krok po kroku. Tutaj zajmiemy się samą diagnostyką w R: co policzyć, jak czytać wykresy i progi oraz co zrobić, gdy diagnostyka coś wykaże. Tabela pokazuje plan.
| Problem | Co psuje | Narzędzie w R | Typowa reakcja |
|---|---|---|---|
| Nieliniowość | oszacowania b | residualPlots(), crPlots() (car) | człon kwadratowy, splajn, transformacja |
| Heteroskedastyczność | błędy standardowe, p, CI | bptest() (lmtest), ncvTest() (car) | błędy HC3 (sandwich) |
| Obserwacje wpływowe | b i wnioski | rstudent(), hatvalues(), cooks.distance(), dfbetas() | sprawdzenie danych, analiza wrażliwości |
| Współliniowość | precyzja b dla skorelowanych predyktorów | vif() (car) | interpretacja łączna, zmiana pytania |
| Nienormalność reszt | p i CI w małych próbach | wykres Q-Q reszt studentyzowanych | zwykle nic; przy małej próbie bootstrap |
| Zależność obserwacji | błędy standardowe | plan badania, test Durbina–Watsona przy danych w czasie | model wielopoziomowy |
Przykład: wyczerpanie emocjonalne personelu pielęgniarskiego
Badasz 240 pielęgniarek i pielęgniarzy. Zmienna zależna to wyczerpanie emocjonalne (średnia z pozycji, 0–6). Predyktory to obciążenie pracą (1–5), wsparcie przełożonego (1–5), wiek i staż pracy w latach. Dane są symulowane, z dwiema nietypowymi osobami dodanymi celowo. Możesz je pobrać jako CSV. Model lm(wycz ~ obc + wsp + wiek + staz) wyjaśnia 26.7% wariancji, F(4, 235) = 21.44, p < .001. Obciążenie ma b = 0.612 (SE = 0.076, p < .001), a wsparcie b = −0.142 (SE = 0.073, p = .053). Wynik dla wsparcia leży na granicy istotności, więc diagnostyka może przesądzić o wniosku.
Krok 1. Cztery wykresy diagnostyczne
Zacznij od wykresów, a nie od testów. plot(m) w R rysuje cztery panele. Na rysunku 1 są ich odpowiedniki w ggplot2, z zaznaczonymi osobami 239 i 240.
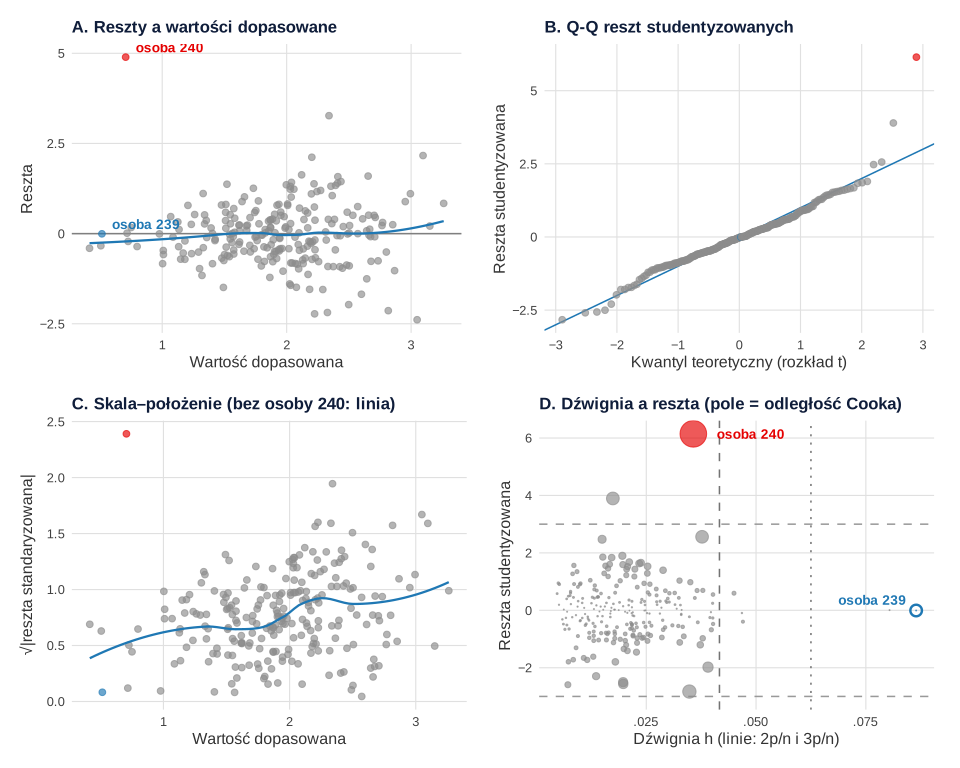
- Panel A (reszty a wartości dopasowane): linia wygładzona jest prawie płaska, więc nic nie wskazuje na nieliniowość. Wyróżnia się jedna osoba z resztą 4.89 punktu na skali 0–6.
- Panel B (Q-Q): punkty leżą na prostej, z wyjątkiem tej samej osoby.
- Panel C (skala–położenie): rozrzut reszt rośnie razem z wartością dopasowaną. To klasyczny obraz heteroskedastyczności.
- Panel D (dźwignia a reszta): osoba 240 ma umiarkowaną dźwignię i ogromną resztę, a osoba 239 dużą dźwignię i resztę bliską zera.
Krok 2. Reszty: którą wybrać
R podaje trzy rodzaje reszt. Surowe resid() są w jednostkach zmiennej zależnej. Standaryzowane rstandard() dzielą resztę przez jej błąd standardowy, z uwzględnieniem dźwigni. Studentyzowane rstudent() liczą ten błąd z modelu bez danej osoby. Tylko te ostatnie mają znany rozkład t i nadają się do testu, dlatego do wykrywania obserwacji odstających używaj ich. Dla osoby 240 reszta standaryzowana wynosi 5.72, a studentyzowana 6.15. Ta duża reszta zawyża bowiem błąd standardowy w pełnym modelu.
car::outlierTest() sprawdza największą resztę studentyzowaną z poprawką Bonferroniego na liczbę obserwacji. Dla osoby 240 skorygowane p < .001. Test wskazał też osobę 113 (reszta studentyzowana 3.90, skorygowane p = .031). Pamiętaj jednak, że przy 240 osobach dwie reszty powyżej 3 nie są niczym dziwnym, zwłaszcza gdy wariancja błędu rośnie z obciążeniem.
Krok 3. Dźwignia, odległość Cooka i DFBETAS
Obserwacja odstająca nie musi być wpływowa. Dźwignia h mierzy, jak nietypowy jest układ predyktorów danej osoby. Odległość Cooka łączy dźwignię z resztą studentyzowaną i pokazuje, jak bardzo zmieniłyby się wszystkie współczynniki po usunięciu jednej osoby (Cook, 1977). DFBETAS pokazuje tę zmianę osobno dla każdego współczynnika, w jednostkach jego błędu standardowego.
| Miara | Próg orientacyjny | Wartość progu (p = 5, n = 240) | Osoby powyżej |
|---|---|---|---|
| Dźwignia h | 2p/n; 3p/n | .042; .063 | 5; 2 |
| Odległość Cooka | 4/n | .017 | 8 |
| |DFBETAS| | 2/√n | .129 | osoba 240: −0.78 dla obciążenia, 0.36 dla wsparcia |
Progi są umowne i przy dużym n zawsze wskażą kilka osób. summary(influence.measures(m)) oznaczyło w przykładzie 13 osób, większość tylko z powodu wskaźnika COVRATIO. To lista do obejrzenia, a nie do usunięcia. Liczy się to, czy jedna osoba wyraźnie odstaje od reszty. Tu taką osobą jest 240: odległość Cooka .24, kilkakrotnie więcej niż u kolejnej osoby (.06). Jej DFBETAS dla obciążenia wynosi −0.78. Oznacza to, że ta jedna osoba obniża współczynnik obciążenia o prawie 0.8 jego błędu standardowego.
Osoba 239 to przykład „dobrej” dźwigni. Ma 63 lata i 41 lat stażu (h = .086, największa w próbie), ale jej wynik leży na linii modelu (odległość Cooka < .001). Takiej obserwacji nie ma powodu usuwać, bo tylko zwiększa precyzję oszacowań. Szerzej o regułach wykluczeń piszemy we wpisie wartości odstające: jak je wykryć.
Krok 4. Liniowość
car::residualPlots(m) rysuje reszty względem każdego predyktora i dla każdego testuje człon kwadratowy. Dla całego modelu podaje test Tukeya. W przykładzie żaden test nie wskazał krzywizny (dla predyktorów p ≥ .464, test Tukeya: p = .417). Wykresy składnik + reszta (crPlots()) pokazują to samo dla każdego predyktora z osobna. Gdyby krzywizna się pojawiła, sięgnij po regresję krzywoliniową albo transformację, a nie po usuwanie osób.
Krok 5. Współliniowość i VIF
car::vif(m) daje 1.10 dla obciążenia i wsparcia oraz 5.38 dla wieku i stażu, które korelują ze sobą na poziomie .90. Dla zmiennych jakościowych z kilkoma poziomami vif() podaje uogólniony GVIF. Według reguły „VIF > 5” należałoby coś usunąć. O’Brien (2007) pokazuje jednak, że VIF trzeba czytać razem z liczebnością próby i R². Nawet duże wartości same w sobie nie przekreślają modelu.
Współliniowość wieku i stażu poszerza przedziały tylko dla tych dwóch zmiennych. Na obciążenie i wsparcie nie wpływa. Jeśli pytanie dotyczy wieku i stażu razem, przetestuj je łącznie: linearHypothesis(m, c("wiek = 0", "staz = 0")) daje F(2, 235) = 0.02, p = .979. Oba predyktory można więc zostawić jako zmienne kontrolne.
Krok 6. Heteroskedastyczność: uwaga na maskowanie
Test Breuscha–Pagana bada, czy kwadraty reszt zależą od predyktorów (Breusch i Pagan, 1979). lmtest::bptest() domyślnie liczy jego wersję studentyzowaną. W przykładzie BP = 2.89, df = 4, p = .576. Wygląda to na homoskedastyczność. Panel C rysunku 1 mówi jednak co innego. Po usunięciu osoby 240 ten sam test daje BP = 22.52, p < .001. Jedna ogromna reszta przy niskiej wartości dopasowanej „wyrównała” rozrzut i zamaskowała rosnącą wariancję.
Dlatego nie uzależniaj wyboru błędów standardowych od testu wstępnego. Long i Ervin (2000) zalecają odporne błędy standardowe zawsze, gdy można podejrzewać heteroskedastyczność, a przy N ≤ 250 wersję HC3. Rosopa i in. (2013) przypominają, że heteroskedastyczność w naukach społecznych jest częsta i może zawyżać błąd I rodzaju albo obniżać moc. W R wystarczy coeftest(m, vcov. = vcovHC(m, type = "HC3")). Błędy HC3 zmieniają SE, ale nie zmieniają współczynników. Dla obciążenia SE rośnie z 0.076 do 0.094, a dla wsparcia maleje z 0.073 do 0.070.
Krok 7. Normalność reszt: na końcu listy
Test Shapiro–Wilka dla reszt studentyzowanych daje W = .939, p < .001. Po usunięciu osoby 240 wychodzi W = .984, p = .008. Pozostałe odchylenie wynika z mieszania reszt o różnej wariancji, czyli z heteroskedastyczności, a nie z innego rozkładu błędu. Knief i Forstmeier (2021) pokazują w symulacjach, że modele zakładające normalne błędy są odporne na nienormalność w szerokim zakresie warunków. Wyjątkiem są wpływowe obserwacje odstające. Przy 240 osobach ważniejsze są więc kroki 3 i 6 niż sam test normalności. Kiedy test normalności w ogóle coś mówi, wyjaśnia wpis jak sprawdzić normalność rozkładu.
Krok 8. Decyzja o obserwacji wpływowej i analiza wrażliwości
Osoba 240 ma wyczerpanie 5.60 przy obciążeniu 1.4 i wsparciu 4.6. Najpierw sprawdź dane źródłowe: błąd wprowadzania poprawiasz, a nie usuwasz. Jeśli wynik jest prawdziwy, Bollen i Jackman (1985) radzą traktować usunięcie jako środek ostateczny. Ważniejsze jest pytanie, dlaczego obserwacja jest wpływowa: czy to inna populacja, błąd specyfikacji modelu, czy błąd pomiaru. Raportuj model główny z regułą zapisaną przed analizą, a model bez osoby 240 jako analizę wrażliwości.
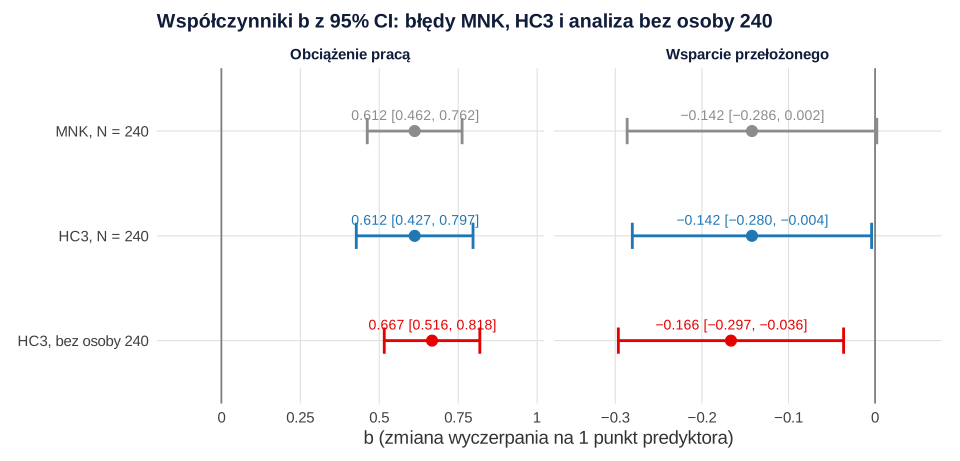
Wniosek o obciążeniu pracą jest stabilny: b od 0.612 do 0.667 we wszystkich wariantach. Wniosek o wsparciu jest kruchy. Przy klasycznych błędach 95% CI obejmuje zero ([−0.286, 0.002]). Przy HC3 ledwo je wyklucza ([−0.280, −0.004], p = .044). Bez osoby 240 efekt jest wyraźniejszy (b = −0.166, p = .012), a R² rośnie z .267 do .332. Uczciwy opis mówi o niewielkim efekcie wsparcia, którego istotność zależy od jednej osoby. Nie wybieraj wariantu, w którym p jest najmniejsze.
Jak opisać diagnostykę w artykule
Współczynniki podaj w tabeli według wzoru tabeli regresji w APA, z notą o błędach HC3. Do metody i wyników wystarczy kilka zdań:
Jeśli recenzent kwestionuje założenia albo obserwacje wpływowe w Twoim modelu, możemy przejść przez diagnostykę razem w ramach oferty analizy statystyczne dla badaczy.
Diagnostyka regresji w R: kompletny skrypt
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Funkcje rstandard(), rstudent(), hatvalues(), cooks.distance(), dfbetas() i influence.measures() pochodzą z podstawowego pakietu stats. Testy i VIF pochodzą z pakietów car i lmtest, a macierz HC3 z pakietu sandwich. Skrypt zapisuje też plik CSV do pobrania.
Model, reszty, miary wpływu, VIF, heteroskedastyczność i analiza wrażliwości
R
# Diagnostyka regresji w R – przepis 1: model, reszty, dźwignia, odległość Cooka, VIF, heteroskedastyczność
# Dane symulowane, set.seed(1239): 240 pielęgniarek i pielęgniarzy; wyczerpanie emocjonalne (średnia 0–6)
# Predyktory: obciążenie pracą (1–5), wsparcie przełożonego (1–5), wiek (lata), staż pracy (lata)
suppressPackageStartupMessages({ library(car); library(lmtest); library(sandwich) })
set.seed(1239)
n <- 238
wiek  <- round(pmin(64, pmax(23, rnorm(n, 42, 10))))
staz  <- round(pmax(0, pmin(wiek - 22, (wiek - 23) * 0.8 + rnorm(n, 0, 4))))
obc   <- round(pmin(5, pmax(1, rnorm(n, 3.2, 0.8))), 1)
wsp   <- round(pmin(5, pmax(1, 3.4 - 0.25 * (obc - 3.2) + rnorm(n, 0, 0.8))), 1)
blad  <- rnorm(n, 0, 0.20 + 0.28 * (obc - 1))                      # wariancja rośnie z obciążeniem
wycz  <- 0.6 + 0.70 * obc - 0.30 * wsp + 0.010 * staz + blad
dane <- data.frame(id = 1:n, wycz, obc, wsp, wiek, staz)
# dwie nietypowe osoby: duża dźwignia przy zgodnym wyniku oraz wynik sprzeczny z resztą danych
dane <- rbind(dane,
  data.frame(id = 239, wycz = NA, obc = 1.2, wsp = 4.8, wiek = 63, staz = 41),
  data.frame(id = 240, wycz = 5.6, obc = 1.4, wsp = 4.6, wiek = 31, staz = 6))
dane$wycz[239] <- 0.6 + 0.70 * 1.2 - 0.30 * 4.8 + 0.010 * 41 + 0.1
dane$wycz <- round(pmin(6, pmax(0, dane$wycz)), 2)
write.csv(dane, "../diagnostyka-regresji-w-r-dane.csv", row.names = FALSE)
round(sapply(dane[-1], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2)

m <- lm(wycz ~ obc + wsp + wiek + staz, data = dane)
summary(m)
n <- nrow(dane); p <- length(coef(m))                              # p = liczba parametrów z wyrazem wolnym

# 1. Reszty: surowe, standaryzowane (wewnętrznie) i studentyzowane (zewnętrznie)
diag <- data.frame(id = dane$id, dop = fitted(m), e = resid(m), r_std = rstandard(m), r_stud = rstudent(m),
                   h = hatvalues(m), cook = cooks.distance(m))
head(diag[order(-abs(diag$r_stud)), ], 4)
outlierTest(m)                                                     # test Bonferroniego dla max |reszty studentyzowanej|

# 2. Dźwignia i odległość Cooka – progi orientacyjne
c(prog_h_2p_n = 2 * p / n, prog_h_3p_n = 3 * p / n, prog_cook_4_n = 4 / n)
c(h_ponad_2p_n = sum(diag$h > 2 * p / n), h_ponad_3p_n = sum(diag$h > 3 * p / n), cook_ponad_4_n = sum(diag$cook > 4 / n))
round(diag[diag$id %in% c(239, 240), -2], 3)
dfb <- dfbetas(m); round(dfb[c(239, 240), ], 2)                    # zmiana b w jednostkach SE
c(prog_dfbetas = round(2 / sqrt(n), 3))
summary(influence.measures(m))

# 3. Liniowość: wykresy składnik + reszta i test krzywizny
residualPlots(m, plot = FALSE)

# 4. Współliniowość
round(vif(m), 2)
round(cor(dane$wiek, dane$staz), 2)
linearHypothesis(m, c("wiek = 0", "staz = 0"))                    # łączny test wieku i stażu

# 5. Heteroskedastyczność: Breusch–Pagan (wersja studentyzowana Koenkera) i test wyniku car
bptest(m)
nc <- function(t) round(c(chi2 = t$ChiSquare, df = t$Df, p = t$p), 4)   # zwięzły wydruk ncvTest
nc(ncvTest(m))                                                     # względem wartości dopasowanych
nc(ncvTest(m, ~ obc))                                              # względem obciążenia pracą

# 6. Normalność reszt – tylko uzupełniająco
shapiro.test(rstudent(m))

# 7. Wnioskowanie: błędy MNK, HC3 i model bez osoby 240
ols <- coeftest(m); hc3 <- coeftest(m, vcov. = vcovHC(m, type = "HC3"))
round(cbind(b = ols[, 1], SE_MNK = ols[, 2], p_MNK = ols[, 4], SE_HC3 = hc3[, 2], p_HC3 = hc3[, 4]), 3)
round(hc3, 3)
round(coefci(m, vcov. = vcovHC(m, type = "HC3")), 3)
m_bez <- update(m, data = subset(dane, id != 240))
round(cbind(z_240 = coef(m), bez_240 = coef(m_bez)), 3)
round(c(R2 = summary(m)$r.squared, R2_bez = summary(m_bez)$r.squared), 3)
round(coeftest(m_bez, vcov. = vcovHC(m_bez, type = "HC3")), 3)
round(coefci(m_bez, vcov. = vcovHC(m_bez, type = "HC3")), 3)
# Diagnostyka modelu bez osoby 240
bptest(m_bez); nc(ncvTest(m_bez))
residualPlots(m_bez, plot = FALSE)
shapiro.test(rstudent(m_bez))
Wynik w R
    wycz  obc  wsp  wiek  staz
M   1.93 3.15 3.41 42.70 15.58
SD  1.01 0.78 0.81  9.48  8.17
min 0.00 1.00 1.10 23.00  0.00
max 5.61 5.00 5.00 64.00 41.00

Call:
lm(formula = wycz ~ obc + wsp + wiek + staz, data = dane)

Residuals:
    Min      1Q  Median      3Q     Max
-2.3882 -0.5090 -0.0155  0.4453  4.8934

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)  5.401e-01  5.509e-01   0.980   0.3279
obc          6.120e-01  7.621e-02   8.031 4.64e-14 ***
wsp         -1.422e-01  7.317e-02  -1.943   0.0532 .
wiek        -1.156e-03  1.380e-02  -0.084   0.9333
staz        -8.823e-05  1.601e-02  -0.006   0.9956
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.8719 on 235 degrees of freedom
Multiple R-squared:  0.2674,	Adjusted R-squared:  0.2549
F-statistic: 21.44 on 4 and 235 DF,  p-value: 4.313e-15

     id       dop         e     r_std    r_stud           h        cook
240 240 0.7066019  4.893398  5.715588  6.146623 0.035716760 0.242002216
113 113 2.3402265  3.269773  3.783387  3.895842 0.017394527 0.050678648
80   80 3.0482287 -2.388229 -2.788204 -2.829460 0.034820212 0.056092166
118 118 2.2245881 -2.224588 -2.560706 -2.591666 0.007146599 0.009439822
    rstudent unadjusted p-value Bonferroni p
240 6.146623         3.3824e-09   8.1179e-07
113 3.895842         1.2777e-04   3.0664e-02
  prog_h_2p_n   prog_h_3p_n prog_cook_4_n
   0.04166667    0.06250000    0.01666667
  h_ponad_2p_n   h_ponad_3p_n cook_ponad_4_n
             5              2              8
     id      e  r_std r_stud     h  cook
239 239 -0.006 -0.007 -0.007 0.086 0.000
240 240  4.893  5.716  6.147 0.036 0.242
    (Intercept)   obc  wsp  wiek staz
239        0.00  0.00 0.00  0.00    0
240        0.47 -0.78 0.36 -0.23    0
prog_dfbetas
       0.129
Potentially influential observations of
	 lm(formula = wycz ~ obc + wsp + wiek + staz, data = dane) :

    dfb.1_ dfb.obc dfb.wsp dfb.wiek dfb.staz dffit   cov.r   cook.d hat
7   -0.06   0.41    0.11   -0.18     0.09     0.51_*  0.92_*  0.05   0.04
34   0.00   0.05   -0.03   -0.01    -0.01    -0.09    1.07_*  0.00   0.05
67   0.04  -0.27    0.00    0.11    -0.13    -0.36    0.91_*  0.02   0.02
80   0.36  -0.42   -0.02   -0.23     0.15    -0.54_*  0.89_*  0.06   0.03
83   0.30  -0.21   -0.13   -0.24     0.21    -0.36    0.91_*  0.03   0.02
112 -0.04  -0.15    0.00    0.14    -0.15    -0.27    0.93_*  0.01   0.01
113  0.01   0.28    0.22   -0.32     0.30     0.52_*  0.76_*  0.05   0.02
118  0.08  -0.10    0.00   -0.09     0.10    -0.22    0.89_*  0.01   0.01
143  0.00   0.00    0.00    0.00     0.00     0.00    1.11_*  0.00   0.08_*
202  0.02   0.00   -0.18    0.07     0.01     0.30    0.91_*  0.02   0.01
224  0.02   0.00   -0.01   -0.02     0.01    -0.02    1.07_*  0.00   0.05
239  0.00   0.00    0.00    0.00     0.00     0.00    1.12_*  0.00   0.09_*
240  0.47  -0.78    0.36   -0.23     0.00     1.18_*  0.50_*  0.24   0.04
           Test stat Pr(>|Test stat|)
obc           0.7329           0.4644
wsp           0.5343           0.5937
wiek          0.0718           0.9428
staz         -0.0162           0.9871
Tukey test    0.8118           0.4169
 obc  wsp wiek staz
1.10 1.10 5.38 5.38
[1] 0.9

Linear hypothesis test:
wiek = 0
staz = 0

Model 1: restricted model
Model 2: wycz ~ obc + wsp + wiek + staz

  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    237 178.66
2    235 178.63  2  0.032176 0.0212 0.9791

	studentized Breusch-Pagan test

data:  m
BP = 2.8903, df = 4, p-value = 0.5764

  chi2     df      p
2.1108 1.0000 0.1463
  chi2     df      p
3.0971 1.0000 0.0784

	Shapiro-Wilk normality test

data:  rstudent(m)
W = 0.93891, p-value = 1.885e-08

                 b SE_MNK p_MNK SE_HC3 p_HC3
(Intercept)  0.540  0.551 0.328  0.534 0.313
obc          0.612  0.076 0.000  0.094 0.000
wsp         -0.142  0.073 0.053  0.070 0.044
wiek        -0.001  0.014 0.933  0.013 0.927
staz         0.000  0.016 0.996  0.013 0.995

t test of coefficients:

            Estimate Std. Error t value Pr(>|t|)
(Intercept)    0.540      0.534   1.012    0.313
obc            0.612      0.094   6.523   <2e-16 ***
wsp           -0.142      0.070  -2.027    0.044 *
wiek          -0.001      0.013  -0.091    0.927
staz           0.000      0.013  -0.007    0.995
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

             2.5 % 97.5 %
(Intercept) -0.512  1.592
obc          0.427  0.797
wsp         -0.280 -0.004
wiek        -0.026  0.024
staz        -0.026  0.026
             z_240 bez_240
(Intercept)  0.540   0.301
obc          0.612   0.667
wsp         -0.142  -0.166
wiek        -0.001   0.002
staz         0.000   0.000
    R2 R2_bez
 0.267  0.332

t test of coefficients:

            Estimate Std. Error t value Pr(>|t|)
(Intercept)    0.301      0.482   0.624    0.533
obc            0.667      0.077   8.686   <2e-16 ***
wsp           -0.166      0.066  -2.521    0.012 *
wiek           0.002      0.012   0.147    0.883
staz           0.000      0.013  -0.003    0.998
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

             2.5 % 97.5 %
(Intercept) -0.649  1.252
obc          0.516  0.818
wsp         -0.297 -0.036
wiek        -0.022  0.026
staz        -0.026  0.026

	studentized Breusch-Pagan test

data:  m_bez
BP = 22.516, df = 4, p-value = 0.0001582

   chi2      df       p
33.6835  1.0000  0.0000
           Test stat Pr(>|Test stat|)
obc          -0.2852           0.7757
wsp           0.2105           0.8335
wiek         -0.0291           0.9768
staz         -0.1092           0.9131
Tukey test   -0.4456           0.6559

	Shapiro-Wilk normality test

data:  rstudent(m_bez)
W = 0.98367, p-value = 0.007567
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm() i miary wpływu z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W artykule podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w diagnostyce regresji
- Testowanie normalności zmiennej zależnej zamiast reszt.
- Wybór błędów standardowych na podstawie testu Breuscha–Pagana. Jedna obserwacja potrafi zamaskować heteroskedastyczność. HC3 kosztuje niewiele.
- Usuwanie wszystkich osób powyżej 4/n i ponowne liczenie diagnostyki aż do „czystego” modelu.
- Mylenie dźwigni z wpływem. Osoba z dużym h i małą resztą stabilizuje model.
- Usuwanie predyktora tylko dlatego, że VIF przekracza 5 lub 10, choć pytanie badawcze go wymaga.
- Raport wyłącznie wariantu bez obserwacji wpływowych, bez informacji, ile osób usunięto i dlaczego.
- Testy t dla współczynników przy danych zagnieżdżonych (pacjenci w oddziałach, uczniowie w klasach). Żadna diagnostyka reszt tego nie wykryje. To kwestia planu badania.
Najczęstsze pytania
Jakie reszty wybrać do wykrywania obserwacji odstających w regresji?
Reszty studentyzowane (w R rstudent()). Ich błąd standardowy liczony jest z modelu bez danej osoby, więc mają rozkład t i nie są zaniżane przez samą obserwację odstającą. Największą z nich możesz sprawdzić testem z poprawką Bonferroniego, car::outlierTest().
Jaki próg odległości Cooka przyjąć?
Najczęściej podaje się 4/n, rzadziej 1. Przy dużej próbie próg 4/n zawsze wskaże kilka osób, więc traktuj go jako sygnał do obejrzenia danych, a nie regułę usuwania. Ważniejsze jest, czy jedna osoba wyraźnie odstaje od reszty i czy zmienia wnioski, co pokaże analiza wrażliwości.
Czym różni się dźwignia od obserwacji wpływowej?
Dźwignia (h) mówi, jak nietypowe są wartości predyktorów danej osoby. Wpływ zależy od dźwigni i reszty jednocześnie. Osoba z dużą dźwignią, która leży na linii regresji, nie zmienia współczynników i zwiększa precyzję. Wpływowa jest dopiero wtedy, gdy ma też dużą resztę.
Czy test Breuscha–Pagana wystarczy do oceny heteroskedastyczności?
Nie. Test może nie wykryć rosnącej wariancji, gdy w danych jest obserwacja wpływowa, a przy dużej próbie wykryje nawet nieistotne różnice. Oglądaj wykres skala–położenie i stosuj odporne błędy HC3 niezależnie od wyniku testu.
Co zrobić z obserwacją wpływową w regresji?
Najpierw sprawdź dane źródłowe: błąd wprowadzania popraw. Prawdziwą obserwację zwykle zostaw w modelu głównym, a model bez niej pokaż jako analizę wrażliwości. Usunięcie uzasadnij regułą zapisaną przed analizą i podaj w artykule, ile osób usunięto i jak zmieniły się wyniki.
Powiązane hasła
Przeczytaj też
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Recenzent pyta o założenia modelu regresji?
Przeprowadzimy pełną diagnostykę Twojego modelu, policzymy analizę wrażliwości i przygotujemy opis decyzji do odpowiedzi recenzentom.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A., & Jackman, R. W. (1985). Regression diagnostics: An expository treatment of outliers and influential cases. Sociological Methods & Research, 13(4), 510–542. https://doi.org/10.1177/0049124185013004004
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- Knief, U., & Forstmeier, W. (2021). Violating the normality assumption may be the lesser of two evils. Behavior Research Methods, 53(6), 2576–2590. https://doi.org/10.3758/s13428-021-01587-5 ● Otwarty dostęp
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Rosopa, P. J., Schaffer, M. M., & Schroeder, A. N. (2013). Managing heteroscedasticity in general linear models. Psychological Methods, 18(3), 335–351. https://doi.org/10.1037/a0032553
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bollen1985regression, author={Bollen, Kenneth A. and Jackman, Robert W.}, title={{Regression diagnostics: An expository treatment of outliers and influential cases}}, journal={Sociological Methods \& Research}, year={1985}, volume={13}, number={4}, pages={510--542}, doi={10.1177/0049124185013004004}}@article{breusch1979simple, author={Breusch, T. S. and Pagan, A. R.}, title={{A simple test for heteroscedasticity and random coefficient variation}}, journal={Econometrica}, year={1979}, volume={47}, number={5}, pages={1287--1294}, doi={10.2307/1911963}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@article{knief2021violating, author={Knief, Ulrich and Forstmeier, Wolfgang}, title={{Violating the normality assumption may be the lesser of two evils}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2576--2590}, doi={10.3758/s13428-021-01587-5}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{obrien2007caution, author={O’Brien, Robert M.}, title={{A caution regarding rules of thumb for variance inflation factors}}, journal={Quality \& Quantity}, year={2007}, volume={41}, number={5}, pages={673--690}, doi={10.1007/s11135-006-9018-6}}@article{rosopa2013managing, author={Rosopa, Patrick J. and Schaffer, Meline M. and Schroeder, Amber N.}, title={{Managing heteroscedasticity in general linear models}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={335--351}, doi={10.1037/a0032553}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}