Kiedy używać tabeli regresji?
Gdy sprawdzasz, które zmienne przewidują wynik przy kontroli pozostałych (regresja wieloraka), albo czy kolejne grupy zmiennych wnoszą coś ponad zmienne kontrolne (regresja hierarchiczna). Dla wyniku dwuwartościowego zobacz tabelę regresji logistycznej.
Wzory tabel regresji w APA
Intencja zakupu przewidywana przez łatwość korzystania, użyteczność, obawy i cele.
Tabela 1
Wyniki regresji liniowej wielokrotnej dla intencji zakupu
| Predyktor | b | SE | 95% CI dla b | β | t | p | |
|---|---|---|---|---|---|---|---|
| LL | UL | ||||||
| Stała | 0.13 | 0.33 | −0.51 | 0.78 | 0.41 | .682 | |
| Łatwość korzystania | 0.02 | 0.06 | −0.09 | 0.13 | 0.02 | 0.36 | .723 |
| Użyteczność | 0.58 | 0.06 | 0.46 | 0.70 | 0.50 | 9.48 | < .001 |
| Obawy | −0.09 | 0.06 | −0.21 | 0.03 | −0.06 | −1.45 | .149 |
| Cele | 0.43 | 0.07 | 0.30 | 0.56 | 0.31 | 6.60 | < .001 |
Uwaga. N = 303. R2 = .59, skorygowane R2 = .58, F(4, 298) = 106.68, p < .001. b = współczynnik niestandaryzowany; β = współczynnik standaryzowany; LL i UL = dolna i górna granica przedziału ufności. Współczynniki VIF mieściły się w zakresie 1.30–2.01.
Wariant: regresja hierarchiczna
Krok 1 — zmienne kontrolne (płeć, wiek), krok 2 — zmienne modelu TAM, krok 3 — obawy i cele.
Tabela 2
Hierarchiczna regresja liniowa: predyktory intencji zakupu
| Krok i predyktor | b | SE | β | p | R2 | ΔR2 |
|---|---|---|---|---|---|---|
| Krok 1 | .00 | .00 | ||||
| Płeć (mężczyzna) | 0.08 | 0.12 | 0.04 | .529 | ||
| Wiek | 0.00 | 0.01 | 0.02 | .700 | ||
| Krok 2 | .52 | .52*** | ||||
| Płeć (mężczyzna) | −0.05 | 0.08 | −0.03 | .516 | ||
| Wiek | 0.01 | 0.01 | 0.04 | .297 | ||
| Łatwość korzystania | 0.02 | 0.06 | 0.01 | .780 | ||
| Użyteczność | 0.83 | 0.05 | 0.72 | < .001 | ||
| Krok 3 | .59 | .07*** | ||||
| Płeć (mężczyzna) | −0.06 | 0.08 | −0.03 | .504 | ||
| Wiek | 0.01 | 0.01 | 0.05 | .147 | ||
| Łatwość korzystania | 0.03 | 0.06 | 0.02 | .637 | ||
| Użyteczność | 0.57 | 0.06 | 0.50 | < .001 | ||
| Obawy | −0.10 | 0.06 | −0.07 | .110 | ||
| Cele | 0.43 | 0.07 | 0.31 | < .001 |
Uwaga. N = 303. Płeć zakodowano: 0 = kobieta, 1 = mężczyzna. Zmiana R2 w kroku 2: F(2, 298) = 161.71; w kroku 3: F(2, 296) = 25.71.
*p < .05. **p < .01. ***p < .001.
Co jest w tabeli i jak ją czytać
- b i β — b mówi o zmianie wyniku w jednostkach skali, β pozwala porównać siłę predyktorów mierzonych na różnych skalach. β zapisuje się z zerem wiodącym, bo może przekroczyć 1.
- CI dla b — granice LL (dolna) i UL (górna); przedział niezawierający zera oznacza istotny predyktor.
- Nota z R² i F — opisuje cały model; dodaj w niej informację o współliniowości (VIF).
- Regresja hierarchiczna — wiersze kroków pogrubione, predyktory wcięte; ΔR² z testem F zmiany pokazuje przyrost wyjaśnionej wariancji.
Jak opisać tabelę w tekście pracy
W tekście nie powtarzaj wszystkich liczb z tabeli — przywołaj ją i opisz najważniejsze wyniki. Przykład dla danych z tej strony:
Wykres współczynników zamiast tabeli
W ekonomii, epidemiologii i naukach politycznych wyniki regresji często pokazuje się na wykresie współczynników (ang. coefficient plot): punkt to oszacowanie, odcinek — przedział ufności. Pozwala to od razu zobaczyć, które predyktory są istotne i jak duże są efekty.
Rysunek 1
Standaryzowane współczynniki regresji intencji zakupu
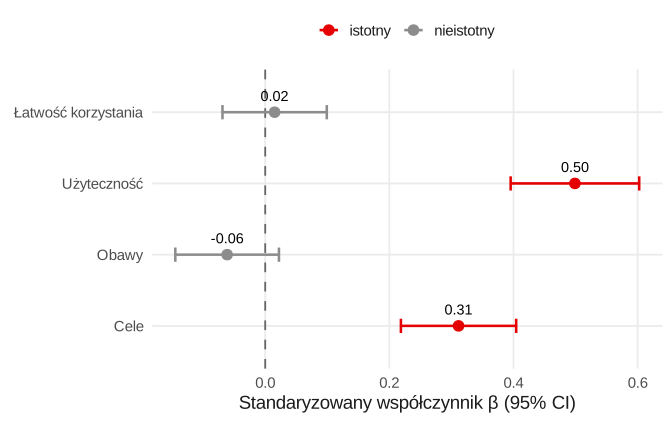
Uwaga. N = 303. Punkty to standaryzowane współczynniki β, odcinki — 95% przedziały ufności. Czerwone oznaczenia: predyktory istotne (p < .05).
Jak przygotować tabelę: SPSS, JASP, R i Word
SPSS: Analiza → Regresja → Liniowa; w Statystykach zaznacz przedziały ufności, zmianę R² (przy regresji hierarchicznej z blokami zmiennych) i diagnostykę współliniowości. JASP: Regression → Linear Regression z opcjami Confidence intervals, R squared change i Collinearity diagnostics.
Jak sformatować tabelę w Wordzie
- Wstaw tabelę, a następnie w Projekt tabeli → Obramowania wybierz Bez obramowania.
- Dodaj tylko trzy linie poziome: nad wierszem nagłówka, pod nagłówkiem i pod ostatnim wierszem (oraz krótkie linie pod nagłówkami grupującymi).
- Nazwy wierszy wyrównaj do lewej, liczby do środka (lub do kropki dziesiętnej); w całej kolumnie zachowaj tę samą liczbę miejsc po kropce.
- Nad tabelą wpisz numer (pogrubiony) i w nowym wierszu tytuł kursywą; pod tabelą notę zaczynającą się od Uwaga.
- Przy długiej tabeli zaznacz wiersz nagłówka i włącz Powtórz jako wiersz nagłówka, aby pojawiał się na każdej stronie.
Przykład w R
Kod szacuje model regresji wielorakiej (z β i VIF) oraz trzy kroki regresji hierarchicznej.
Regresja wieloraka i hierarchiczna
R
library(readxl); library(psych)
dane <- as.data.frame(read_excel("dane_ankieta_tam.xlsx"))
dane$LAT <- rowMeans(dane[, paste0("Łatwość_korzystania", 1:4)])   # łatwość korzystania
dane$UZY <- rowMeans(dane[, paste0("Użyteczność", 1:4)])           # użyteczność
dane$INT <- rowMeans(dane[, paste0("Intencja_kupna", 1:4)])        # intencja zakupu
library(car)
model <- lm(INT ~ LAT + UZY + Obawy + Cele, data = dane)
summary(model)                        # b, SE, t, p, R², F
confint(model)                        # 95% CI dla b
model_z <- lm(scale(INT) ~ scale(LAT) + scale(UZY) + scale(Obawy) + scale(Cele), data = dane)
round(coef(model_z), 2)               # współczynniki β
vif(model)
# regresja hierarchiczna
dane$plec_m <- as.integer(dane$Płeć == "Mężczyzna")
k1 <- lm(INT ~ plec_m + Wiek, data = dane)
k2 <- update(k1, . ~ . + LAT + UZY)
k3 <- update(k2, . ~ . + Obawy + Cele)
anova(k1, k2, k3)                     # F zmiany dla kolejnych kroków
sapply(list(k1, k2, k3), function(m) summary(m)$r.squared)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://CRAN.R-project.org/package=readxl
Najczęstsze błędy
- Zrzut ekranu z SPSS zamiast tabeli przepisanej w formacie APA.
- Linie pionowe i kolorowe tło — tabela APA ma wyłącznie linie poziome.
- Tylko β bez b i SE — czytelnik nie może odtworzyć przewidywań w jednostkach skali.
- Brak R² i testu F modelu.
- „Beta” opisane jako korelacja — β to efekt przy kontroli pozostałych predyktorów.
- Pominięcie diagnostyki (współliniowość, reszty).
Najczęstsze pytania
Jak przedstawić regresję w tabeli APA?
Dla każdego predyktora podaj b, SE, 95% CI dla b, β, t i p. Pod tabelą podaj R², skorygowane R² i F modelu ze stopniami swobody.
Czy podawać stałą w tabeli regresji?
Tak, w wierszu „Stała” (b, SE, t, p) — bez β, bo dla stałej nie ma współczynnika standaryzowanego.
Jak pokazać regresję hierarchiczną?
Podziel tabelę na kroki, w każdym podaj współczynniki predyktorów, a w kolumnach lub nocie R², ΔR² i F zmiany.
Zero przed kropką przy β?
Tak, w stylu APA β zapisuje się z zerem wiodącym (0.50), bo teoretycznie może przekroczyć 1. Bez zera piszemy R², r i p.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (b.d.). Table setup. APA Style. Pobrano 8 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
- American Psychological Association. (b.d.). Sample tables. APA Style. Pobrano 9 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Karch, J. (2020). Improving on adjusted R-squared. Collabra: Psychology, 6(1), Article 45. https://doi.org/10.1525/collabra.343 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020manual, author={{American Psychological Association}}, title={Publication Manual of the American Psychological Association}, edition={7}, publisher={American Psychological Association}, address={Washington, DC}, year={2020}, doi={10.1037/0000165-000}}@misc{apa_table_setup, author={{American Psychological Association}}, title={Table setup}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}, note={Pobrano 8 października 2026}}@misc{apa_sample_tables, author={{American Psychological Association}}, title={Sample tables}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables}, note={Pobrano 9 października 2026}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{karch2020improving, author={Karch, Julian}, title={Improving on adjusted R-squared}, journal={Collabra: Psychology}, year={2020}, volume={6}, number={1}, eid={45}, doi={10.1525/collabra.343}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={Beyond bar and line graphs: Time for a new data presentation paradigm}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}