Kiedy używać tabeli regresji logistycznej?
Gdy zmienna zależna ma dwie kategorie (np. zdał/nie zdał, intencja tak/nie) — zob. regresja logistyczna. W przykładzie intencję zakupu podzielono na „co najmniej umiarkowaną” (≥ 3) i niską; taki podział upraszcza interpretację, ale traci część informacji, więc w pracy uzasadnij go teoretycznie.
Wzór tabeli regresji logistycznej w APA
Co najmniej umiarkowana intencja zakupu (148 osób) wobec niskiej (155 osób).
Tabela 1
Regresja logistyczna: predyktory co najmniej umiarkowanej intencji zakupu
| Predyktor | B | SE | Wald | p | OR | 95% CI dla OR | |
|---|---|---|---|---|---|---|---|
| LL | UL | ||||||
| Stała | −6.59 | 1.49 | 19.44 | < .001 | 0.001 | ||
| Łatwość korzystania | −0.12 | 0.24 | 0.26 | .608 | 0.89 | 0.56 | 1.41 |
| Użyteczność | 1.68 | 0.28 | 35.24 | < .001 | 5.37 | 3.08 | 9.36 |
| Obawy | −0.20 | 0.25 | 0.63 | .426 | 0.82 | 0.51 | 1.33 |
| Cele | 0.94 | 0.27 | 11.98 | < .001 | 2.55 | 1.50 | 4.34 |
Uwaga. N = 303. Zmienna zależna: intencja zakupu ≥ 3 (1; n = 148) wobec < 3 (0; n = 155). Model: χ2(4) = 141.22, p < .001; R2 Nagelkerkego = .50; poprawnie sklasyfikowano 75.9% osób (próg .50). OR = iloraz szans; Wald = statystyka Walda z 1 stopniem swobody.
Co jest w tabeli i jak ją czytać
- B i OR — B to zmiana logarytmu szans, OR — mnożnik szans przy wzroście predyktora o jednostkę. OR > 1 zwiększa, < 1 zmniejsza szanse.
- CI dla OR — przedział niezawierający 1 oznacza istotny predyktor (Szumilas, 2010).
- Wald — kwadrat statystyki z (B/SE)²; SPSS podaje go jako „Wald”, R jako z.
- Nota z dopasowaniem — χ² modelu, R² Nagelkerkego i trafność klasyfikacji (Sperandei, 2014).
Jak opisać tabelę w tekście pracy
W tekście nie powtarzaj wszystkich liczb z tabeli — przywołaj ją i opisz najważniejsze wyniki. Przykład dla danych z tej strony:
Wykres ilorazów szans (forest plot)
W epidemiologii i medycynie ilorazy szans pokazuje się na wykresie lasu (forest plot) z osią logarytmiczną, na której efekty zwiększające i zmniejszające szanse są symetryczne wokół 1.
Rysunek 1
Ilorazy szans co najmniej umiarkowanej intencji zakupu
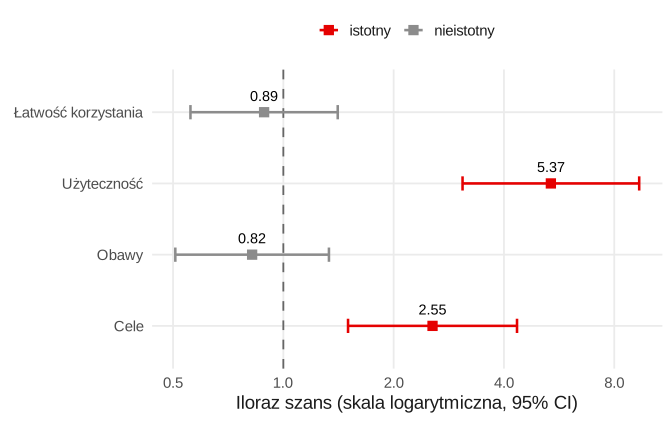
Uwaga. N = 303. Kwadraty to ilorazy szans, odcinki — 95% przedziały ufności (oś logarytmiczna). Linia przerywana: OR = 1 (brak efektu).
Jak przygotować tabelę: SPSS, JASP, R i Word
SPSS: Analiza → Regresja → Logistyczna; w Opcjach zaznacz CI dla exp(B) i statystykę Hosmera-Lemeshowa. Tabela „Zmienne w równaniu” zawiera B, S.E., Wald, istotność i Exp(B). JASP: Regression → Logistic Regression z opcjami Odds ratios i Confidence intervals.
Jak sformatować tabelę w Wordzie
- Wstaw tabelę, a następnie w Projekt tabeli → Obramowania wybierz Bez obramowania.
- Dodaj tylko trzy linie poziome: nad wierszem nagłówka, pod nagłówkiem i pod ostatnim wierszem (oraz krótkie linie pod nagłówkami grupującymi).
- Nazwy wierszy wyrównaj do lewej, liczby do środka (lub do kropki dziesiętnej); w całej kolumnie zachowaj tę samą liczbę miejsc po kropce.
- Nad tabelą wpisz numer (pogrubiony) i w nowym wierszu tytuł kursywą; pod tabelą notę zaczynającą się od Uwaga.
- Przy długiej tabeli zaznacz wiersz nagłówka i włącz Powtórz jako wiersz nagłówka, aby pojawiał się na każdej stronie.
Przykład w R
Kod szacuje regresję logistyczną i liczy wszystkie wartości z tabeli i noty.
Regresja logistyczna z ilorazami szans
R
library(readxl); library(psych)
dane <- as.data.frame(read_excel("dane_ankieta_tam.xlsx"))
dane$LAT <- rowMeans(dane[, paste0("Łatwość_korzystania", 1:4)])   # łatwość korzystania
dane$UZY <- rowMeans(dane[, paste0("Użyteczność", 1:4)])           # użyteczność
dane$INT <- rowMeans(dane[, paste0("Intencja_kupna", 1:4)])        # intencja zakupu
dane$int_wys <- as.integer(dane$INT >= 3)
m <- glm(int_wys ~ LAT + UZY + Obawy + Cele, family = binomial, data = dane)
summary(m)                                     # B, SE, z (Wald = z²), p
exp(cbind(OR = coef(m), confint.default(m)))   # ilorazy szans z 95% CI
n <- nrow(dane); lr <- m$null.deviance - m$deviance
cs <- 1 - exp(-lr / n); cs / (1 - exp(-m$null.deviance / n))   # R² Nagelkerkego
mean((fitted(m) >= .5) == dane$int_wys)        # odsetek poprawnych klasyfikacji
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://CRAN.R-project.org/package=readxl
Najczęstsze błędy
- Zrzut ekranu z SPSS zamiast tabeli przepisanej w formacie APA.
- Linie pionowe i kolorowe tło — tabela APA ma wyłącznie linie poziome.
- OR interpretowany jak ryzyko względne („dwa razy bardziej prawdopodobne”).
- Brak informacji o kodowaniu zmiennej zależnej (co oznacza 1).
- Brak przedziałów ufności dla OR.
- Trafność klasyfikacji bez punktu odniesienia (odsetek najliczniejszej kategorii).
Najczęstsze pytania
Jak przedstawić regresję logistyczną w tabeli APA?
Podaj B, SE, Wald, p, OR i 95% CI dla OR dla każdego predyktora. W nocie opisz kodowanie zmiennej zależnej, test χ² modelu, pseudo-R² i trafność klasyfikacji.
Czy podawać B, jeśli jest OR?
Tak — B z SE pozwala odtworzyć model; OR jest wygodniejszy w interpretacji. Oba elementy są standardem.
Który pseudo-R² podać?
Najczęściej R² Nagelkerkego (i ewentualnie Coxa i Snella), bo podaje je SPSS. Pamiętaj, że pseudo-R² nie jest odsetkiem wyjaśnionej wariancji jak w regresji liniowej.
Jak zapisać OR dla stałej?
OR dla stałej rzadko się interpretuje; można go podać bez przedziału ufności albo pominąć.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Tabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikRegresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (b.d.). Table setup. APA Style. Pobrano 8 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
- American Psychological Association. (b.d.). Sample tables. APA Style. Pobrano 9 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Sperandei, S. (2014). Understanding logistic regression analysis. Biochemia Medica, 24(1), 12–18. https://doi.org/10.11613/BM.2014.003 ● Otwarty dostęp
- Szumilas, M. (2010). Explaining odds ratios. Journal of the Canadian Academy of Child and Adolescent Psychiatry, 19(3), 227–229. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/ ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020manual, author={{American Psychological Association}}, title={Publication Manual of the American Psychological Association}, edition={7}, publisher={American Psychological Association}, address={Washington, DC}, year={2020}, doi={10.1037/0000165-000}}@misc{apa_table_setup, author={{American Psychological Association}}, title={Table setup}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}, note={Pobrano 8 października 2026}}@misc{apa_sample_tables, author={{American Psychological Association}}, title={Sample tables}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables}, note={Pobrano 9 października 2026}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{sperandei2014understanding, author={Sperandei, Sandro}, title={Understanding logistic regression analysis}, journal={Biochemia Medica}, year={2014}, volume={24}, number={1}, pages={12--18}, doi={10.11613/BM.2014.003}}@article{szumilas2010explaining, author={Szumilas, Magdalena}, title={Explaining odds ratios}, journal={Journal of the Canadian Academy of Child and Adolescent Psychiatry}, year={2010}, volume={19}, number={3}, pages={227--229}, url={https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/}}