Co to jest tabela krzyżowa?
Tabela krzyżowa (ang. cross-tabulation, contingency table; po polsku także tabela kontyngencji, tabela dwudzielcza lub tabela wielodzielcza) to tabela liczebności dla dwóch (lub więcej) zmiennych mierzonych na skali nominalnej lub porządkowej. Każda komórka zawiera liczbę obserwacji, które mają określoną kombinację kategorii. Na marginesach znajdują się sumy wierszy i kolumn (liczebności brzegowe).
Wymiar tabeli zapisuje się jako liczba wierszy × liczba kolumn. Najprostsza jest tabela 2 × 2, w której obie zmienne są dychotomiczne:
| Zmienna A / zmienna B | B = tak | B = nie | Razem |
|---|---|---|---|
| A = tak | a | b | a + b |
| A = nie | c | d | c + d |
| Razem | a + c | b + d | N |
Tabela krzyżowa jest podstawą testu chi-kwadrat niezależności, ilorazu szans i ryzyka względnego, a także macierzy pomyłek, która jest tabelą krzyżową prognoz i rzeczywistości. W ankietach tabele krzyżowe są najczęstszym sposobem porównywania odpowiedzi różnych grup — zob. analiza ankiet.
Liczebności i procenty: jak czytać tabelę
Surowe liczebności trudno porównywać, gdy grupy mają różną wielkość, dlatego tabelę uzupełnia się procentami. Można je liczyć na trzy sposoby:
- procenty w wierszach — każdy wiersz sumuje się do 100%; odpowiadają na pytanie „jaki odsetek osób z danej grupy ma daną cechę?”;
- procenty w kolumnach — każda kolumna sumuje się do 100%;
- procenty z całości — wszystkie komórki sumują się do 100%.
Zasada: procenty liczy się w obrębie kategorii zmiennej niezależnej. Jeśli pytamy, czy warsztaty zwiększają zdawalność, porównujemy odsetek zdających wśród uczestników i nieuczestników warsztatów, czyli procenty w wierszach (gdy grupy są w wierszach).
Przykład: tabela 2 × 2 i test chi-kwadrat
Sprawdzamy, czy udział w warsztatach przygotowawczych wiąże się ze zdaniem egzaminu. W przykładowych danych było po 100 osób w każdej grupie (N = 200).
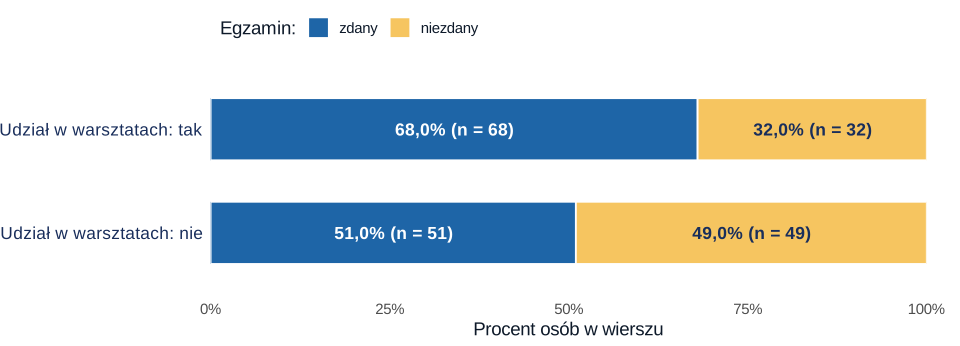
Krok 1. Liczebności oczekiwane. Gdyby zmienne były niezależne, w każdej grupie zdawalność byłaby taka sama jak w całej próbie: 119 / 200 = 59,5%. Liczebność oczekiwana komórki to (suma wiersza × suma kolumny) / N, np. dla uczestników, którzy zdali: 100 · 119 / 200 = 59,5.
| Warsztaty | Zdany: obserwowane | Zdany: oczekiwane | Niezdany: obserwowane | Niezdany: oczekiwane |
|---|---|---|---|---|
| tak | 68 | 59,5 | 32 | 40,5 |
| nie | 51 | 59,5 | 49 | 40,5 |
Wszystkie liczebności oczekiwane są większe od 5, więc klasyczny test chi-kwadrat jest odpowiedni (McHugh, 2013).
Krok 2. Statystyka chi-kwadrat sumuje znormalizowane odchylenia liczebności obserwowanych od oczekiwanych:
Przy df = (2 − 1)(2 − 1) = 1 odpowiada to p = 0,014. Skorygowane reszty standaryzowane wynoszą ±2,45, czyli przekraczają ±1,96: uczestnicy warsztatów zdawali częściej, a nieuczestnicy rzadziej, niż wynikałoby z niezależności (por. Sharpe, 2015).
| Test | Statystyka | p | Kiedy stosować |
|---|---|---|---|
| χ² Pearsona (bez poprawki) | χ²(1) = 6,00 | 0,014 | standard przy oczekiwanych liczebnościach ≥ 5 |
| χ² z poprawką Yatesa | χ²(1) = 5,31 | 0,021 | domyślny w R dla 2 × 2; konserwatywny |
| χ² „N − 1” (Campbell, 2007) | χ²(1) = 5,97 | 0,015 | zalecany, gdy najmniejsza oczekiwana liczebność ≥ 1 |
| Dokładny test Fishera | — | 0,021 | małe próby, oczekiwane liczebności < 1 |
Krok 3. Wielkość efektu. Sama istotność nie mówi, jak silny jest związek (Kim, 2017). Dla tabeli 2 × 2 podaje się:
- współczynnik φ = √(χ² / N) = √(6,00 / 200) = 0,17 — słaby związek według konwencji Cohena (0,10 / 0,30 / 0,50);
- iloraz szans OR = (a · d) / (b · c) = (68 · 49) / (32 · 51) = 2,04, 95% CI [1,15; 3,63] — szanse zdania egzaminu były u uczestników warsztatów około dwukrotnie większe (Szumilas, 2010);
- ryzyko względne RR = 68% / 51% = 1,33 — odsetek zdających był o jedną trzecią wyższy.
Iloraz szans i ryzyko względne to różne miary: przy częstym wyniku (tu zdawało ok. 60% osób) OR jest wyraźnie większy od RR, dlatego nie należy interpretować OR = 2 jako „dwa razy większe prawdopodobieństwo”. Więcej o mierze siły efektu w haśle wielkość efektu.
Tabela krzyżowa w formacie APA
Według stylu APA (7. wydanie) tabela ma numer zapisany pogrubioną czcionką, pod nim tytuł kursywą, tylko poziome linie oraz notkę pod tabelą, rozpoczętą słowem „Uwaga.” zapisanym kursywą (American Psychological Association, b.d.). W notce podaj liczebność, sposób liczenia procentów i wynik testu. Tak może wyglądać tabela z przykładu:
Tabela 1
Zdawalność egzaminu w zależności od udziału w warsztatach przygotowawczych
| Udział w warsztatach | Zdany | Niezdany | Razem | ||
|---|---|---|---|---|---|
| n | % | n | % | ||
| Tak | 68 | 68,0 | 32 | 32,0 | 100 |
| Nie | 51 | 51,0 | 49 | 49,0 | 100 |
| Razem | 119 | 59,5 | 81 | 40,5 | 200 |
Uwaga. N = 200. Procenty obliczono w wierszach. Związek udziału w warsztatach ze zdaniem egzaminu: χ²(1, N = 200) = 6,00, p = 0,014, φ = 0,17; iloraz szans zdania egzaminu (warsztaty: tak vs nie) OR = 2,04, 95% CI [1,15; 3,63].
W tekście pracy przywołaj tabelę i opisz najważniejszy wynik, nie powtarzając wszystkich liczb. Zasady formatowania opisuje też hasło styl APA i poradnik wytyczne APA w metodologii i statystyce.
Kalkulator tabeli krzyżowej 2 × 2
Wpisz liczebności i nazwy kategorii
Wpisz liczebności i kliknij „Policz test chi-kwadrat”. Kalkulator wymaga włączonej obsługi JavaScriptu.
Gotowy opis wyniku
Kalkulator liczy χ² Pearsona i z poprawką Yatesa (jak chisq.test() w R), dokładny test Fishera (jak fisher.test()), φ oraz iloraz szans z 95% przedziałem ufności Woolfa (logitowym). Dla danych z przykładu wyniki są identyczne z R. Iloraz szans z fisher.test() (2,03) to estymator warunkowy, dlatego nieznacznie różni się od zwykłego OR.
Przykład w R
Kod tworzy tabelę 2 × 2, liczy procenty w wierszach, liczebności oczekiwane, test chi-kwadrat w trzech wariantach, test Fishera oraz φ i iloraz szans. Liczby w tekście, w tabeli APA i w kalkulatorze pochodzą z tego kodu.
Tabela krzyżowa 2 × 2 i test chi-kwadrat
R
# Udział w warsztatach przygotowawczych a zdanie egzaminu: N = 200
tab <- matrix(c(68, 32,
                51, 49), nrow = 2, byrow = TRUE,
              dimnames = list(Warsztaty = c("tak", "nie"), Egzamin = c("zdany", "niezdany")))
tab
addmargins(tab)                          # liczebności brzegowe
round(100 * prop.table(tab, 1), 1)       # procenty w wierszach
test <- chisq.test(tab, correct = FALSE) # test chi-kwadrat Pearsona
test
test$expected                            # liczebności oczekiwane
chisq.test(tab)                          # z poprawką Yatesa (domyślnie w R dla 2×2)
fisher.test(tab)                         # dokładny test Fishera
phi <- unname(sqrt(test$statistic / sum(tab)) * sign(tab[1, 1] * tab[2, 2] - tab[1, 2] * tab[2, 1]))
OR  <- (tab[1, 1] * tab[2, 2]) / (tab[1, 2] * tab[2, 1])
se  <- sqrt(sum(1 / tab))
c(phi = phi, OR = OR, OR_dolna = exp(log(OR) - 1.96 * se), OR_gorna = exp(log(OR) + 1.96 * se))
test$stdres                              # skorygowane reszty standaryzowane
chi_N1 <- unname(test$statistic) * (sum(tab) - 1) / sum(tab)   # wariant „N − 1” (Campbell, 2007)
c(chi_N1 = chi_N1, p = pchisq(chi_N1, df = 1, lower.tail = FALSE))
Wynik w R
         Egzamin
Warsztaty zdany niezdany
      tak    68       32
      nie    51       49
         Egzamin
Warsztaty zdany niezdany Sum
      tak    68       32 100
      nie    51       49 100
      Sum   119       81 200
         Egzamin
Warsztaty zdany niezdany
      tak    68       32
      nie    51       49

	Pearson's Chi-squared test

data:  tab
X-squared = 5.9965, df = 1, p-value = 0.01433

         Egzamin
Warsztaty zdany niezdany
      tak  59.5     40.5
      nie  59.5     40.5

	Pearson's Chi-squared test with Yates' continuity correction

data:  tab
X-squared = 5.3118, df = 1, p-value = 0.02118


	Fisher's Exact Test for Count Data

data:  tab
p-value = 0.02092
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
 1.105598 3.782145
sample estimates:
odds ratio
   2.03427

      phi        OR  OR_dolna  OR_gorna
0.1731542 2.0416667 1.1492110 3.6271868
         Egzamin
Warsztaty    zdany niezdany
      tak  2.44877 -2.44877
      nie -2.44877  2.44877
    chi_N1          p
5.96649030 0.01458027
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak opisać wynik w tekście
Pamiętaj, że w badaniu nieeksperymentalnym związek nie oznacza wpływu: na warsztaty mogli częściej zapisywać się studenci bardziej zmotywowani.
Najczęstsze błędy
- Procenty liczone w złym kierunku (w kolumnach zamiast w grupach) albo brak informacji, jak je policzono.
- Test chi-kwadrat na procentach zamiast na liczebnościach.
- Ta sama osoba w kilku komórkach (np. pytania wielokrotnego wyboru) — test chi-kwadrat wymaga niezależnych obserwacji.
- Pomijanie liczebności oczekiwanych przy małych próbach.
- Raportowanie samego p bez φ, V Craméra lub ilorazu szans.
- Interpretowanie ilorazu szans jak ryzyka względnego przy częstym wyniku.
Najczęstsze pytania
Co to jest tabela krzyżowa?
Tabela krzyżowa (tabela kontyngencji, tabela dwudzielcza) to tabela, która pokazuje liczebności osób dla każdej kombinacji kategorii dwóch zmiennych jakościowych. Wiersze odpowiadają kategoriom jednej zmiennej, kolumny — drugiej, a w komórkach są liczby osób (często z procentami). Tabela 2 × 2 to najprostszy przypadek: dwie zmienne o dwóch kategoriach.
Jak policzyć test chi-kwadrat dla tabeli 2 × 2?
Dla każdej komórki oblicza się liczebność oczekiwaną: (suma wiersza × suma kolumny) / N. Następnie sumuje się (obserwowana − oczekiwana)² / oczekiwana po czterech komórkach. Wynik porównuje się z rozkładem chi-kwadrat z 1 stopniem swobody. W R wystarczy chisq.test(tabela, correct = FALSE); kalkulator na tej stronie zrobi to automatycznie.
Procenty w wierszach czy w kolumnach?
Procenty liczy się w obrębie kategorii zmiennej niezależnej (wyjaśniającej). Jeśli wiersze to grupy (np. udział w warsztatach), a kolumny to wynik (zdany/niezdany), podaj procenty w wierszach — wtedy porównujesz odsetek zdających w każdej grupie. W notce pod tabelą napisz, jak policzono procenty.
Kiedy zamiast chi-kwadrat użyć testu Fishera?
Tradycyjna reguła Cochrana mówi, by przejść na test Fishera, gdy którakolwiek liczebność oczekiwana jest mniejsza niż 5. Badania symulacyjne (Campbell, 2007) wskazują, że wariant chi-kwadrat „N − 1” działa dobrze już przy najmniejszej liczebności oczekiwanej co najmniej 1; poniżej tej wartości lepszy jest dokładny test Fishera.
Jak przedstawić tabelę krzyżową w stylu APA?
Nad tabelą umieść numer pogrubiony (Tabela 1), a pod nim tytuł kursywą. W tabeli używaj tylko linii poziomych, podaj liczebności i procenty. Pod tabelą dodaj notkę zaczynającą się od słowa „Uwaga.” zapisanego kursywą — z liczebnością próby, sposobem liczenia procentów i wynikiem testu. Wzór znajdziesz na tej stronie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikWytyczne APA dla metodologii i raportowania statystyki
Lista kontrolna JARS-Quant prowadząca od projektu i pomiaru do wyników, niepewności, analiz dodatkowych i ograniczeń.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikStatystyka w pracy z pedagogiki
Ankiety wśród nauczycieli i rodziców: skala Likerta, chi-kwadrat i test Fishera, testy rangowe z korektą Holma, procenty w tabelach i uczniowie w klasach.
Czytaj →PoradnikAnaliza statystyczna w Excelu – możliwości i granice
Test t (Welch = T.TEST typ 3), chi-kwadrat, korelacja, regresja i Analysis ToolPak z polskimi nazwami funkcji, plikiem z formułami i listą tego, czego Excel nie policzy.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikBadanie wiedzy przed i po szkoleniu
Test t i Wilcoxona z d_z, McNemar z korektą Holma, znormalizowany przyrost, test Bowkera i pomiar odroczony – z danymi, kodem R i opisem APA.
Czytaj →PoradnikAnaliza treści pytań otwartych
Klucz kategoryzacji, pilotaż, kappa dla każdej kategorii, odsetki z przedziałem Wilsona i porównanie grup – z plikiem Excel, kodem R i opisem APA.
Czytaj →PoradnikStatystyka w pracy z socjologii
Sondaż, tabele krzyżowe z resztami, ważenie próby, regresja logistyczna z AME i skale postaw: plan analiz, APA, dane XLSX i kod R.
Czytaj →PoradnikTesty statystyczne – przewodnik po wyborze
Schemat wyboru testu i osiem etapów od hipotezy do zapisu APA: test t, ANOVA, testy nieparametryczne, chi-kwadrat, korelacje, regresja i poprawki.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →PoradnikJak porównać odsetki w dwóch grupach?
Tabela 2 × 2, test chi-kwadrat lub Fishera i różnica w punktach procentowych z 95% CI Newcombe’a – z przykładem w R i wzorem opisu.
Czytaj →PoradnikDIF krok po kroku: Mantel–Haenszel, regresja i IRT
Trzy metody wykrywania DIF na jednych danych: klasyfikacja ETS, ΔR² w regresji logistycznej, IRT z kotwicą, DTF i wzór opisu.
Czytaj →PoradnikKalkulator kappy Cohena i testu McNemara
Kappa Cohena i kappa ważona z przedziałem ufności dla dwóch oceniających oraz test McNemara w czterech wersjach z przedziałem dla różnicy odsetków.
Czytaj →PoradnikKalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →PoradnikKalkulator testu diagnostycznego
Czułość, swoistość, PPV, NPV, LR+ i LR− z przedziałami ufności z tabeli 2×2 oraz wykres wartości predykcyjnych w funkcji częstości.
Czytaj →PoradnikChi-kwadrat w SPSS krok po kroku
Crosstabs w SPSS od pliku po opis APA: opcje Statistics i Cells, wiersz Pearsona, V Craméra, reszty skorygowane, test dokładny, Weight Cases i składnia CROSSTABS – z plikiem .sav.
Czytaj →PoradnikKappa Cohena i ICC w SPSS
Kappa w Crosstabs, kappa ważona w Weighted Kappa i ICC w Reliability Analysis: wybór modelu i typu, tabele wynikowe, składnia i zapis APA – z plikiem .sav do pobrania.
Czytaj →PoradnikAnaliza logliniowa tabel wielodzielczych
Modele hierarchiczne, G² i selekcja wsteczna, interakcje jako ilorazy szans oraz równoważność z regresją Poissona na tabeli 2 × 2 × 2.
Czytaj →PoradnikChi-kwadrat i tabele krzyżowe – zadania z rozwiązaniami
Dziesięć zadań z testu χ²: zgodność, tabele krzyżowe, reszty skorygowane, φ i V, Yates, małe liczności, test trendu i paradoks Simpsona – krok po kroku.
Czytaj →PoradnikChi-kwadrat w jamovi krok po kroku
Menu Frequencies w jamovi: tabele krzyżowe z resztami i V Craméra, OR dla tabeli 2 × 2, McNemar i test zgodności – z opisem APA i plikami do pobrania.
Czytaj →PoradnikStatystyka w pracy z finansów i rachunkowości
Ankieta wśród przedsiębiorców, skośne wskaźniki i winsoryzacja, regresja z błędami odpornymi, dane panelowe i model upadłości – z gotowymi zdaniami APA i kodem R.
Czytaj →PoradnikPytanie wielokrotnego wyboru: tabela i wykres APA
Tabela APA z % osób i 95% CI, porównanie grup, poziome słupki, punkty dla grup, macierz współwystępowania i wykres kombinacji – z kodem R.
Czytaj →PoradnikJak napisać pracę z socjologii
Pytanie o zjawisko, koncept–wymiar–wskaźnik, populacja i operat, próba z internetu, wagi, dane wtórne i gotowe fragmenty pracy – na przykładzie zaufania i aktywności sąsiedzkiej.
Czytaj →PoradnikAnaliza ankiety w Arkuszach Google
Kodowanie odpowiedzi formułami, pola wyboru bez SPLIT, tabela przestawna, chi-kwadrat, korelacja i T.TEST typ 3 – z plikiem CSV i liczbami kontrolnymi z R.
Czytaj →PoradnikTabele niestandardowe w SPSS
Custom Tables krok po kroku: układ tabeli, odsetki kolumn, średnie, litery testów, pytania wielokrotnego wyboru i eksport do Worda w stylu APA – z plikiem .sav.
Czytaj →PoradnikAnaliza korespondencji krok po kroku
Inercja jako χ²/n, profile, wkłady i cos², mapa symetryczna a asymetryczna, mała kategoria i drugi wymiar, MCA i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikAnaliza korespondencji w SPSS krok po kroku
Correspondence Analysis od pliku .sav po opis APA: Define Range, normalizacje, tabela Summary, wkłady punktów i czytanie biplotu.
Czytaj →PoradnikTabela krzyżowa na wykresie
Słupki 100% w wierszach i kolumnach, mozaika, mapa reszt χ² z korektą i odsetki z CI – jedna tabela 3 × 4, pięć rysunków z R, podpisy APA.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →PoradnikAnaliza koszykowa i rekomendacje
Wsparcie, ufność i lift na przykładzie sklepu z kawą, sieć reguł, test na nowych paragonach i rekomendacje „klienci kupili też” z kodem R.
Czytaj →PoradnikMapa percepcji marek
Sześć marek, 10 cech: analiza korespondencji, pułapka wielkości marki, indeksy, biplot PCA z efektem halo i bootstrap mapy – sześć rysunków z kodem R.
Czytaj →PoradnikAnaliza ABC/XYZ asortymentu
Hurtownia części: krzywa Lorenza, umowne progi ABC, CV popytu i tygodnie bez sprzedaży, macierz ABC × XYZ i stabilność klas – pięć rysunków z kodem R.
Czytaj →PoradnikPrzechodzenie klientów między markami
Macierz przejść z panelu 2500 gospodarstw: lojalność, odchylenia od niezależności, łańcuch Markowa, bootstrap i promocja – z kodem R.
Czytaj →PoradnikZmiana planu abonamentu
Macierz przejść między planami, łańcuch Markowa i przychód na konto, staż w planie, model wielomianowy i symulacja podwyżki – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- McHugh, M. L. (2013). The chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018 ● Otwarty dostęp: pełny tekst
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp: pełny tekst
- Sharpe, D. (2015). Chi-square test is statistically significant: Now what?. Practical Assessment, Research, and Evaluation, 20, Article 8. https://doi.org/10.7275/tbfa-x148 ● Otwarty dostęp
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Szumilas, M. (2010). Explaining odds ratios. Journal of the Canadian Academy of Child and Adolescent Psychiatry, 19(3), 227–229. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/ ● Otwarty dostęp
- American Psychological Association. (b.d.). Table setup. APA Style. Pobrano 8 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
Cytowania BibTeX
@article{mchugh2013the, author={McHugh, Mary L.}, title={The chi-square test of independence}, journal={Biochemia Medica}, year={2013}, volume={23}, number={2}, pages={143--149}, doi={10.11613/BM.2013.018}}@article{kim2017statistical, author={Kim, Hae-Young}, title={Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{sharpe2015chisquare, author={Sharpe, Donald}, title={Chi-square test is statistically significant: Now what?}, journal={Practical Assessment, Research, and Evaluation}, year={2015}, volume={20}, eid={8}, doi={10.7275/tbfa-x148}}@article{campbell2007chisquared, author={Campbell, Ian}, title={Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{szumilas2010explaining, author={Szumilas, Magdalena}, title={Explaining odds ratios}, journal={Journal of the Canadian Academy of Child and Adolescent Psychiatry}, year={2010}, volume={19}, number={3}, pages={227--229}, url={https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/}}@misc{apa_table_setup, author={{American Psychological Association}}, title={Table setup}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}, note={Pobrano 8 października 2026}}