Co to jest współczynnik determinacji R²?
Współczynnik determinacji (R², R-kwadrat) to miara dopasowania modelu regresji liniowej: odsetek zmienności zmiennej zależnej, który można przypisać predyktorom. R² = 0 oznacza, że model nie wyjaśnia niczego (przewiduje po prostu średnią), a R² = 1 — że przewiduje wyniki bezbłędnie.
gdzie SStot = Σ(yi − ȳ)² to całkowita zmienność wyników, SSres = Σ(yi − ŷi)² — zmienność, której model nie wyjaśnił (reszty), a SSreg = SStot − SSres — zmienność wyjaśniona.
W regresji z wyrazem wolnym R² ma jeszcze dwie przydatne interpretacje:
- to kwadrat korelacji wielokrotnej R, czyli korelacji między wynikami obserwowanymi a przewidywanymi przez model;
- w regresji z jednym predyktorem równa się kwadratowi korelacji Pearsona: r = 0,50 daje R² = 0,25.
Przykład: ile wariancji dobrostanu wyjaśniają trzy predyktory?
W przykładowym badaniu (N = 80) dobrostan (0–100) przewidywano na podstawie wsparcia społecznego, stresu i samooceny. Model regresji wielorakiej oszacowano funkcją lm() w R.
| Predyktor | b | SE | t | p |
|---|---|---|---|---|
| Stała | 31,548 | 8,833 | 3,57 | < 0,001 |
| Wsparcie społeczne | 0,248 | 0,125 | 1,99 | 0,050 |
| Stres | −0,513 | 0,117 | −4,38 | < 0,001 |
| Samoocena | 0,796 | 0,207 | 3,85 | < 0,001 |
- SStot = 9217,6, SSres = 5695,6, więc R² = 1 − 5695,6 / 9217,6 = 0,382. Trzy predyktory wyjaśniają 38,2% wariancji dobrostanu.
- Korelacja wielokrotna R = √0,382 = 0,618.
- R² skorygowany = 1 − (1 − 0,382) · (80 − 1) / (80 − 3 − 1) = 0,358.
- Model jako całość jest istotny: F(3, 76) = 15,67, p < 0,001.
- Wielkość efektu f² Cohena = R² / (1 − R²) = 0,62, czyli efekt duży według konwencji Cohena (1988).
Test F odpowiada na pytanie, czy R² w populacji jest większe od zera, a samo R² — jak dużo wariancji model wyjaśnia. R² mówi o sile całego modelu; o roli poszczególnych predyktorów informują współczynniki regresji, a wkład jednego predyktora ponad pozostałe pokazuje zmiana R² w regresji hierarchicznej.
R² skorygowany: dlaczego zwykłe R² jest zbyt optymistyczne
Zwykłe R² ma dwie wady. Po pierwsze, nigdy nie maleje po dodaniu predyktora — każda zmienna, nawet losowa, „dopasuje się” do przypadkowych wahań w próbie. Po drugie, jako estymator wariancji wyjaśnianej w populacji jest dodatnio obciążone, zwłaszcza w małych próbach z wieloma predyktorami (Karch, 2020).
gdzie n to liczebność próby, a k — liczba predyktorów. Ta klasyczna poprawka (w R podawana jako Adjusted R-squared) zastępuje sumy kwadratów ich nieobciążonymi odpowiednikami: wariancję reszt dzieli się przez n − k − 1, a wariancję całkowitą przez n − 1. R² skorygowany rośnie po dodaniu predyktora tylko wtedy, gdy ten poprawia model bardziej, niż zrobiłaby to zmienna losowa.
Symulacja. Do modelu dobrostanu dodawaliśmy kolejne predyktory wygenerowane losowo, czyli bez żadnego związku z dobrostanem, i powtórzyliśmy to 500 razy.
| Dodane losowe predyktory | Łączna liczba predyktorów | R² | R² skorygowany |
|---|---|---|---|
| 0 | 3 | 0,382 | 0,358 |
| 5 | 8 | 0,424 | 0,359 |
| 10 | 13 | 0,465 | 0,360 |
| 20 | 23 | 0,546 | 0,360 |
| 30 | 33 | 0,625 | 0,356 |
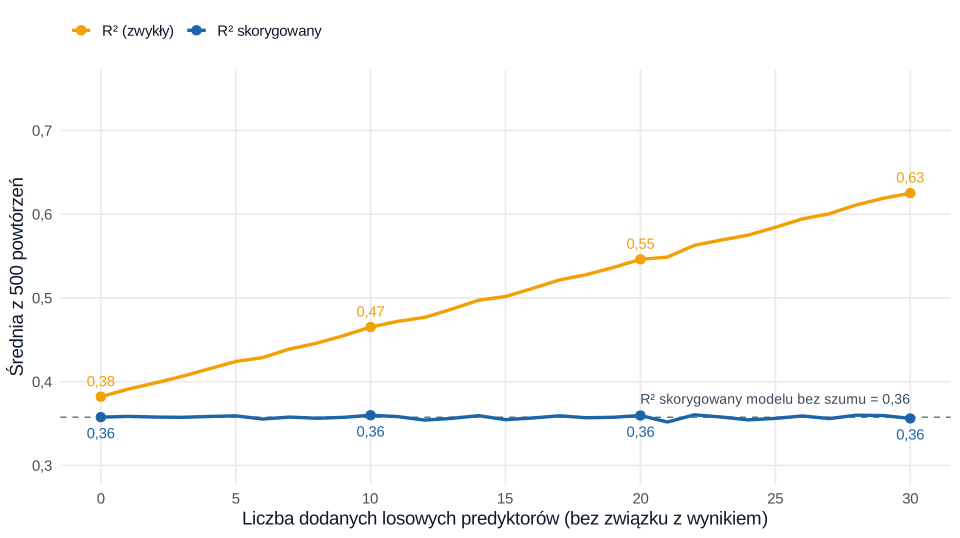
Po dodaniu 30 zupełnie przypadkowych zmiennych zwykłe R² wzrosło z 0,382 do 0,625 — model „wyjaśniałby” prawie dwie trzecie wariancji. R² skorygowany pozostał przy 0,356, czyli tam, gdzie był. Dlatego do porównywania modeli o różnej liczbie predyktorów używaj R² skorygowanego, a przy wyborze modelu — także kryteriów informacyjnych (AIC, BIC) albo walidacji krzyżowej.
Sam R² skorygowany też jest lekko obciążony; dokładnie nieobciążony jest estymator Olkina–Pratta, który Karch (2020) zaleca zamiast domyślnej poprawki (pakiet altR2 w R). R² skorygowany nie rozwiązuje jednak wszystkiego: opisuje wariancję wyjaśnianą w populacji, ale nie mówi, jak dobrze model przewidzi wyniki w nowej próbie. Do tego służą miary walidacji krzyżowej lub wzory na R² w nowych danych. Przy liczbie obserwacji mniejszej niż kilkanaście na predyktor każde R² jest niestabilne — zob. dobór liczebności próby.
Jak interpretować R²?
- R² to nie trafność modelu. Wysokie R² nie dowodzi, że model jest poprawnie określony ani że zależności są przyczynowe. Niskie R² nie oznacza, że predyktory są bez znaczenia — zjawiska psychologiczne mają wiele przyczyn.
- R² z danych, na których budowano model, zawyża trafność predykcji. Gdy model ma przewidywać, licz R² na danych testowych (Alexander i in., 2015). Jako miara jakości regresji R² jest przy tym bardziej informatywny niż MSE czy MAE, bo ma jasną skalę od 0 do 1 (Chicco i in., 2021).
- R² zależy od zróżnicowania próby. W jednorodnej próbie (np. tylko studenci) R² będzie niższe niż w zróżnicowanej, mimo tych samych zależności.
- Nie porównuj R² między różnymi zmiennymi zależnymi ani po transformacji zmiennej zależnej (np. logarytmowaniu).
- W regresji logistycznej klasyczne R² nie istnieje; stosuje się pseudo-R² (Nagelkerkego, McFaddena), które interpretuje się ostrożniej — oraz miary klasyfikacji, takie jak macierz pomyłek. W modelach mieszanych podaje się R² brzegowe i warunkowe (Nakagawa i Schielzeth, 2013).
- Wielkość efektu: z R² liczy się f² = R² / (1 − R²); dla pojedynczego predyktora — f² = ΔR² / (1 − R²pełny) (Selya i in., 2012).
Kalkulator R² skorygowanego, F i f²
Policz R² skorygowany i test F modelu
Wpisz R², N i k, a następnie kliknij „Policz”. Kalkulator wymaga włączonej obsługi JavaScriptu.
Kalkulator liczy R² skorygowany klasycznym wzorem (jak summary(lm()) w R), statystykę F = (R²/k) / ((1 − R²)/(N − k − 1)) z wartością p z rozkładu F oraz f² Cohena. Dla danych z przykładu daje F(3, 76) = 15,67 i R² skorygowany = 0,358, tak jak R. Każdy predyktor kategorialny liczy się jako tyle predyktorów, ile ma zmiennych zero-jedynkowych.
Przykład w R
Pierwszy fragment szacuje model regresji i liczy R² z definicji, R² skorygowany, kwadrat korelacji R i f². Drugi fragment pokazuje, co się dzieje z R² po dodaniu losowych predyktorów. Dane są przykładowe (N = 80).
R² i R² skorygowany w regresji wielorakiej
R
# Dobrostan (0–100) przewidywany przez wsparcie społeczne, stres i samoocenę; N = 80
set.seed(4321)
n <- 80
wsparcie  <- rnorm(n, 50, 10)
stres     <- rnorm(n, 30, 8)
samoocena <- rnorm(n, 25, 5)
dobrostan <- 20 + 0.45 * wsparcie - 0.55 * stres + 0.8 * samoocena + rnorm(n, 0, 9)
model <- lm(dobrostan ~ wsparcie + stres + samoocena)
summary(model)                                   # Multiple R-squared, Adjusted R-squared, F
# R² z definicji: 1 − SS_reszt / SS_całkowite
ss_res <- sum(resid(model)^2)
ss_tot <- sum((dobrostan - mean(dobrostan))^2)
R2  <- 1 - ss_res / ss_tot
k   <- 3
R2_adj <- 1 - (1 - R2) * (n - 1) / (n - k - 1)
c(R2 = R2, R2_skorygowany = R2_adj, r_kwadrat = cor(fitted(model), dobrostan)^2, f2_Cohena = R2 / (1 - R2))
Wynik w R
Call:
lm(formula = dobrostan ~ wsparcie + stres + samoocena)

Residuals:
     Min       1Q   Median       3Q      Max
-19.9963  -5.4809  -0.2701   5.3565  19.5444

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  31.5479     8.8332   3.572 0.000620 ***
wsparcie      0.2478     0.1247   1.987 0.050499 .
stres        -0.5126     0.1169  -4.383  3.7e-05 ***
samoocena     0.7961     0.2066   3.853 0.000242 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 8.657 on 76 degrees of freedom
Multiple R-squared:  0.3821,	Adjusted R-squared:  0.3577
F-statistic: 15.67 on 3 and 76 DF,  p-value: 5.028e-08

            R2 R2_skorygowany      r_kwadrat      f2_Cohena
     0.3820985      0.3577077      0.3820985      0.6183810
Symulacja: losowe predyktory a R²
R
set.seed(99)
dodaj_szum <- function(j) {             # j losowych predyktorów bez związku z dobrostanem
  X <- matrix(rnorm(n * j), n, j)
  s <- summary(lm(dobrostan ~ wsparcie + stres + samoocena + X))
  c(R2 = s$r.squared, R2_skorygowany = s$adj.r.squared)
}
round(sapply(c(5, 15, 30), function(j) rowMeans(replicate(500, dodaj_szum(j)))), 3)
Wynik w R
                [,1]  [,2]  [,3]
R2             0.424 0.504 0.629
R2_skorygowany 0.359 0.358 0.364
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak raportować R² (APA)
W stylu APA R² podaje się z dwoma miejscami po przecinku i bez zera przed przecinkiem (R² = ,38) w tekstach anglojęzycznych; w polskich pracach zwykle zapisuje się zero (R² = 0,38) — trzymaj się jednej konwencji. Zasady opisuje hasło styl APA.
Najczęstsze błędy
- Dodawanie predyktorów „aż R² będzie wysokie” — zwykłe R² zawsze wzrośnie; to przeuczenie modelu.
- Porównywanie modeli o różnej liczbie predyktorów po zwykłym R² zamiast po R² skorygowanym, AIC/BIC albo ΔR² z testem F.
- Utożsamianie R² z „procentem wpływu” poszczególnych zmiennych — przy skorelowanych predyktorach (współliniowość) wariancji nie da się jednoznacznie przypisać zmiennym.
- Raportowanie R² bez testu F i liczebności próby.
- Interpretowanie R² skorygowanego jako trafności predykcji w nowych danych.
Najczęstsze pytania
Co to jest współczynnik determinacji?
Współczynnik determinacji R² to odsetek wariancji zmiennej zależnej wyjaśniany przez model regresji. R² = 0,38 oznacza, że predyktory wyjaśniają 38% zmienności wyników, a 62% pozostaje niewyjaśnione. Przyjmuje wartości od 0 do 1.
Jaki jest wzór na współczynnik determinacji?
R² = 1 − SSres / SStot, gdzie SSres to suma kwadratów reszt, a SStot — całkowita suma kwadratów odchyleń zmiennej zależnej od jej średniej. W regresji liniowej z wyrazem wolnym R² równa się też kwadratowi korelacji między wartościami obserwowanymi i przewidywanymi.
Czym różni się R² od R² skorygowanego?
Zwykłe R² nigdy nie maleje po dodaniu predyktora, nawet zupełnie przypadkowego. R² skorygowany uwzględnia liczbę predyktorów i wielkość próby: R²adj = 1 − (1 − R²)(n − 1)/(n − k − 1). Rośnie tylko wtedy, gdy nowy predyktor poprawia model bardziej, niż wynikałoby z przypadku, dlatego lepiej nadaje się do porównywania modeli o różnej liczbie predyktorów.
Jakie R² jest dobre?
Nie ma uniwersalnego progu. W naukach społecznych R² = 0,10–0,30 bywa wartościowym wynikiem, w naukach technicznych oczekuje się często R² powyżej 0,90. Cohen (1988) uznawał f² = 0,02, 0,15 i 0,35 (co odpowiada R² ≈ 0,02, 0,13 i 0,26) za efekty małe, średnie i duże. Ważniejsze od progu jest porównanie z wcześniejszymi badaniami i celem modelu.
Czy R² skorygowany może być ujemny?
Tak. Dzieje się tak, gdy R² jest bardzo małe w stosunku do liczby predyktorów — model wyjaśnia mniej wariancji, niż oczekiwalibyśmy po samych losowych predyktorach. Taki wynik traktuje się jako zero wyjaśnionej wariancji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikStatystyka dla psychologów
Co statystyka daje psychologii, gdzie ma granice i jak jej nie nadużywać: wartość p, moc, replikacje, braki danych, metody odporne i symulacja w R.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikCzy korelacja .30 to dużo?
Jak ocenić r = .30: konwencja Cohena a typowe korelacje w psychologii, R² = .09, przedział ufności przy różnej liczebności próby i wzór opisu APA.
Czytaj →PoradnikWynik istotny, ale efekt mały
Dlaczego przy dużej próbie słaby efekt daje p < .001, jak ocenić jego znaczenie praktyczne i jak go uczciwie opisać w pracy – przykład w R.
Czytaj →PoradnikKalkulator mocy: ANOVA, χ², regresja
Moc dla N albo N dla mocy w jednoczynnikowej ANOVA, teście chi-kwadrat, regresji (R² i ΔR²) i interakcji 2 × 2. Wzory, kod R i opis APA.
Czytaj →PoradnikKorelacja kanoniczna krok po kroku
Testy kolejnych par (Wilks, Bartlett, F Rao), wagi a ładunki z supresją, redundancja, liczebność próby i tabela APA – z danymi i kodem R.
Czytaj →PoradnikKorelacja i regresja – zadania z rozwiązaniami
Dziesięć zadań: kowariancja, Pearson i Spearman, metoda najmniejszych kwadratów, R², przedział predykcji, reszty, punkt wpływowy, regresja wieloraka i kwartet Anscombe’a.
Czytaj →PoradnikPytania na egzamin ze statystyki
66 krótkich pytań z odpowiedziami w 9 działach – od skal pomiarowych i SD po wartość p, moc, wybór testu, regresję i pytania „wyjaśnij różnicę”.
Czytaj →PoradnikWykresy w Excelu do pracy dyplomowej
Słupki błędów z UFNOŚĆ.T, histogram, linia trendu i R², Likert 100% skumulowany i wykres przed–po – krok po kroku, z plikiem XLSX i przenoszeniem do Worda.
Czytaj →PoradnikMetoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →PoradnikKluczowe czynniki satysfakcji
Ankieta gości hotelu: korelacje, β przy współliniowości, wagi względne i dominacja, macierz ważność–ocena i bootstrap rankingu z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Karch, J. (2020). Improving on adjusted R-squared. Collabra: Psychology, 6(1), Article 45. https://doi.org/10.1525/collabra.343 ● Otwarty dostęp
- Chicco, D., Warrens, M. J., & Jurman, G. (2021). The coefficient of determination R-squared is more informative than SMAPE, MAE, MAPE, MSE and RMSE in regression analysis evaluation. PeerJ Computer Science, 7, Article e623. https://doi.org/10.7717/peerj-cs.623 ● Otwarty dostęp
- Alexander, D. L. J., Tropsha, A., & Winkler, D. A. (2015). Beware of R2: Simple, unambiguous assessment of the prediction accuracy of QSAR and QSPR models. Journal of Chemical Information and Modeling, 55(7), 1316–1322. https://doi.org/10.1021/acs.jcim.5b00206 ● Otwarty dostęp: pełny tekst
- Selya, A. S., Rose, J. S., Dierker, L. C., Hedeker, D., & Mermelstein, R. J. (2012). A practical guide to calculating Cohen's f2, a measure of local effect size, from PROC MIXED. Frontiers in Psychology, 3, Article 111. https://doi.org/10.3389/fpsyg.2012.00111 ● Otwarty dostęp
- Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining R2 from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
Cytowania BibTeX
@article{karch2020improving, author={Karch, Julian}, title={Improving on adjusted R-squared}, journal={Collabra: Psychology}, year={2020}, volume={6}, number={1}, eid={45}, doi={10.1525/collabra.343}}@article{chicco2021the, author={Chicco, Davide and Warrens, Matthijs J. and Jurman, Giuseppe}, title={The coefficient of determination R-squared is more informative than SMAPE, MAE, MAPE, MSE and RMSE in regression analysis evaluation}, journal={PeerJ Computer Science}, year={2021}, volume={7}, eid={e623}, doi={10.7717/peerj-cs.623}}@article{alexander2015beware, author={Alexander, D. L. J. and Tropsha, A. and Winkler, David A.}, title={Beware of R2: Simple, unambiguous assessment of the prediction accuracy of QSAR and QSPR models}, journal={Journal of Chemical Information and Modeling}, year={2015}, volume={55}, number={7}, pages={1316--1322}, doi={10.1021/acs.jcim.5b00206}}@article{selya2012a, author={Selya, Arielle S. and Rose, Jennifer S. and Dierker, Lisa C. and Hedeker, Donald and Mermelstein, Robin J.}, title={A practical guide to calculating Cohen's f2, a measure of local effect size, from PROC MIXED}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={111}, doi={10.3389/fpsyg.2012.00111}}@article{nakagawa2013a, author={Nakagawa, Shinichi and Schielzeth, Holger}, title={A general and simple method for obtaining R2 from generalized linear mixed-effects models}, journal={Methods in Ecology and Evolution}, year={2013}, volume={4}, number={2}, pages={133--142}, doi={10.1111/j.2041-210x.2012.00261.x}}@book{cohen1988statistical, author={Cohen, Jacob}, title={Statistical Power Analysis for the Behavioral Sciences}, edition={2}, publisher={Lawrence Erlbaum Associates}, address={Hillsdale, NJ}, year={1988}, doi={10.4324/9780203771587}}