Co to jest R² skorygowane?
R² skorygowane (skorygowany współczynnik determinacji, ang. adjusted R-squared) to wersja R² – miary dopasowania modelu regresji liniowej – która uwzględnia liczbę predyktorów i liczebność próby. Zwykłe R² nigdy nie maleje po dodaniu predyktora – nawet całkowicie losowego – a R² skorygowane „karze” model za każdy predyktor, który nie poprawia dopasowania bardziej, niż poprawiłby je przypadek.
To hasło uzupełnia pełne omówienie współczynnika determinacji. Definicję R², jego interpretację, kalkulator i zapis w APA znajdziesz w haśle współczynnik determinacji R². Tutaj skupiamy się na tym, co poprawka naprawia, a czego nie, i jak ją raportować.
gdzie n to liczebność próby, a k – liczba predyktorów (każda zmienna zero-jedynkowa liczy się osobno). Ten wzór, nazywany wzorem Wherry’ego, jest najczęściej używany i podają go m.in. SPSS i SAS (Yin i Fan, 2001); tak samo liczy go summary() w R.
Dlaczego R² skorygowane karze za predyktory
Zwykłe R² = 1 − SSE/SST porównuje sumy kwadratów, które w próbie są zbyt optymistyczne: każdy dodany predyktor dopasowuje się także do przypadkowych wahań danych. R² skorygowane zastępuje sumy kwadratów wariancjami z poprawką na stopnie swobody:
Każdy nowy predyktor zmniejsza mianownik n − k − 1, więc oszacowana wariancja reszt rośnie – chyba że suma kwadratów reszt spadnie wystarczająco mocno. W efekcie R² skorygowane rośnie tylko wtedy, gdy statystyka F dla dodanych zmiennych jest większa od 1 (dla pojedynczego predyktora: gdy |t| > 1). Może też być ujemne – gdy model wyjaśnia mniej, niż wyjaśniałyby same losowe zmienne.
Przykład (dane symulowane): wynik testu wiedzy 60 osób przewidywano ich motywacją, R² = .188, R² skorygowane = .174, F(1, 58) = 13.39, p < .001. Po dodaniu dziesięciu pytań z ankiety, które z wynikiem nie miały żadnego związku, R² wzrosło do .294, a R² skorygowane spadło do .132:
Test przyrostu potwierdza, że dziesięć zmiennych nic nie wniosło: ΔR² = .106, F(10, 48) = 0.72, p = .700. Zwykłe R² „nagrodziło” model za dopasowanie do przypadku, skorygowane – nie.
Symulacja: R², R² skorygowane i R² w nowej próbie
Pojedyncza próba może zmylić, dlatego powtórzyliśmy ten eksperyment 1000 razy. W populacji motywacja wyjaśniała 16% wariancji wyniku. W każdej próbie 60 osób dodawaliśmy od 0 do 20 zmiennych losowych i liczyliśmy trzy miary: R², R² skorygowane oraz R² w nowej próbie 5000 osób z tej samej populacji, czyli to, jak dobrze model przewiduje wyniki osób, których nie widział.
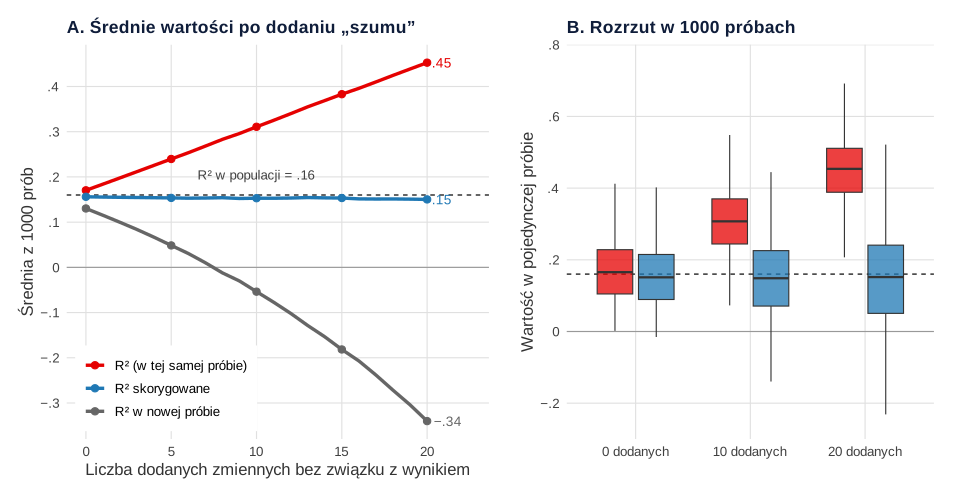
- Zwykłe R² rosło niemal liniowo – ze średnio .170 bez dodatkowych zmiennych do .311 przy dziesięciu i .453 przy dwudziestu zmiennych losowych.
- R² skorygowane pozostało blisko prawdy – średnio od .156 do .150 przy wartości w populacji .16.
- Kara działa średnio, a nie w każdej próbie. Po dodaniu dziesięciu zmiennych losowych R² skorygowane wzrosło w 42.2% prób. Rósł też jego rozrzut (SD = .086, .112 i .141), a ujemne wartości pojawiły się w 0.7%, 7.4% i 14.9% prób.
- Trafność przewidywania spadała. R² w nowej próbie wyniosło .130 bez dodatkowych zmiennych, −.054 przy dziesięciu i −.340 przy dwudziestu – model z dwudziestoma losowymi zmiennymi przewidywał nowe osoby gorzej niż sama średnia.
Wniosek: R² skorygowane to rozsądny szacunek wariancji wyjaśnianej w populacji, ale nie miara trafności przewidywań dla nowych osób. Yin i Fan (2001) rozróżniają właśnie te dwa cele – szacowanie kwadratu korelacji wielokrotnej w populacji i trafności krzyżowej – i w symulacji Monte Carlo stwierdzili, że popularny wzór Wherry’ego prawdopodobnie nie jest najskuteczniejszym estymatorem wariancji wyjaśnianej w populacji; najlepiej wypadły wzór Pratta (dla populacji) i wzór Browne’a (dla trafności krzyżowej). Karch (2020) przypomina, że domyślne R² skorygowane nie jest nieobciążone, i – gdy nie ma powodu, by wybrać inne kryterium – zaleca zamiast niego dokładny estymator Olkina–Pratta (pakiet altR2 w R). W symulacjach Austina i Steyerberga (2015) zwykłe R² wymagało dużej liczby obserwacji na predyktor, by nie być zawyżone, podczas gdy R² skorygowane zachowywało się dobrze – to jeszcze jeden argument za planowaniem liczebności próby z uwzględnieniem liczby predyktorów.
Jak raportować R² skorygowane
- Podawaj obie wartości obok testu F modelu: R² = .19, skorygowane R² = .17. Gdy predyktorów jest dużo w stosunku do liczebności próby, różnica między nimi bywa duża – skomentuj ją.
- Do porównania modeli zagnieżdżonych używaj ΔR² z testem F zmiany, jak w regresji hierarchicznej; R² skorygowane traktuj jako informację uzupełniającą.
- Jeśli w pracy twierdzisz, że model dobrze przewiduje wyniki, sprawdź to na nowych danych albo walidacją krzyżową – R² skorygowane tego nie mówi.
Wzór opisu dla przykładu:
Pełny wzór opisu modelu regresji z tabelą znajdziesz w hasłach regresja wieloraka i tabela regresji w APA, a przykład raportowania R², skorygowanego R² i ΔR² w całej analizie – w poradniku regresja wieloraka krok po kroku.
Przykład w R
Pierwszy przepis liczy R² i R² skorygowane dla jednej próby (także „ręcznie” ze wzoru), drugi – symulację z rysunku. Liczby w tekście pochodzą z tego kodu.
1. R² i R² skorygowane w jednej próbie
R
# Dane symulowane: 60 osób – wynik testu wiedzy (standaryzowany), motywacja
# i 10 dodatkowych zmiennych z ankiety, które z wynikiem nie mają żadnego związku
set.seed(2033)
n <- 60
motywacja <- rnorm(n)
wynik <- 0.4 * motywacja + rnorm(n, sd = sqrt(0.84))     # w populacji R² = .16
szum <- as.data.frame(matrix(rnorm(n * 10), nrow = n, dimnames = list(NULL, paste0("pyt", 1:10))))
dane <- data.frame(wynik, motywacja, szum)

m1  <- lm(wynik ~ motywacja, data = dane)                  # 1 predyktor
m11 <- lm(wynik ~ ., data = dane)                          # 11 predyktorów
round(c(R2_m1 = summary(m1)$r.squared, R2_skor_m1 = summary(m1)$adj.r.squared,
        R2_m11 = summary(m11)$r.squared, R2_skor_m11 = summary(m11)$adj.r.squared), 3)

# R² skorygowane „ręcznie”: 1 − (1 − R²)(n − 1)/(n − k − 1)
r2 <- summary(m11)$r.squared; k <- 10 + 1
round(1 - (1 - r2) * (n - 1) / (n - k - 1), 3)

# Test F modelu z samą motywacją
fm1 <- summary(m1)$fstatistic
round(c(F = unname(fm1[1]), df1 = unname(fm1[2]), df2 = unname(fm1[3]),
        p = unname(pf(fm1[1], fm1[2], fm1[3], lower.tail = FALSE))), 4)

# Przyrost R² po dodaniu 10 zmiennych i jego test F
round(summary(m11)$r.squared - summary(m1)$r.squared, 3)
anova(m1, m11)
Wynik w R
      R2_m1  R2_skor_m1      R2_m11 R2_skor_m11
      0.188       0.174       0.294       0.132
[1] 0.132
      F     df1     df2       p
13.3855  1.0000 58.0000  0.0005
[1] 0.106
Analysis of Variance Table

Model 1: wynik ~ motywacja
Model 2: wynik ~ motywacja + pyt1 + pyt2 + pyt3 + pyt4 + pyt5 + pyt6 +
    pyt7 + pyt8 + pyt9 + pyt10
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1     58 48.158
2     48 41.864 10    6.2945 0.7217 0.7001
2. Symulacja: dokładanie zmiennych bez związku z wynikiem
R
# Symulacja: 1000 prób po 60 osób; prawdziwy predyktor (R² w populacji = .16)
# plus od 0 do 20 zmiennych bez związku z wynikiem; R² sprawdzane też w nowej próbie
set.seed(33)
n <- 60; k_max <- 20
jedna_proba <- function() {
  X  <- matrix(rnorm(n * (k_max + 1)), nrow = n)            # kolumna 1: motywacja
  y  <- 0.4 * X[, 1] + rnorm(n, sd = sqrt(0.84))
  Xn <- matrix(rnorm(5000 * (k_max + 1)), nrow = 5000)      # nowe osoby z tej samej populacji
  yn <- 0.4 * Xn[, 1] + rnorm(5000, sd = sqrt(0.84))
  t(sapply(0:k_max, function(k) {
    m <- lm(y ~ X[, 1:(k + 1)])
    przew <- cbind(1, Xn[, 1:(k + 1)]) %*% coef(m)
    c(dodane = k, R2 = summary(m)$r.squared, R2_skor = summary(m)$adj.r.squared,
      R2_nowe = 1 - sum((yn - przew)^2) / sum((yn - mean(yn))^2))
  }))
}
sym <- do.call(rbind, replicate(1000, jedna_proba(), simplify = FALSE))
sym <- data.frame(proba = rep(1:1000, each = k_max + 1), sym)
srednie <- aggregate(cbind(R2, R2_skor, R2_nowe) ~ dodane, data = sym, FUN = mean)
round(srednie[srednie$dodane %in% c(0, 1, 2, 5, 10, 15, 20), ], 3)
# Rozrzut R² skorygowanego i odsetek wartości ujemnych
round(aggregate(R2_skor ~ dodane, data = sym, FUN = function(x) c(SD = sd(x), ujemne = mean(x < 0)))[c(1, 11, 21), ], 3)
# W ilu próbach R² skorygowane wzrosło po dodaniu 10 zmiennych bez związku z wynikiem?
mean(sym$R2_skor[sym$dodane == 10] > sym$R2_skor[sym$dodane == 0])
Wynik w R
   dodane    R2 R2_skor R2_nowe
1       0 0.170   0.156   0.130
2       1 0.184   0.155   0.115
3       2 0.198   0.155   0.100
6       5 0.240   0.154   0.049
11     10 0.311   0.153  -0.054
16     15 0.383   0.153  -0.182
21     20 0.453   0.150  -0.340
   dodane R2_skor.SD R2_skor.ujemne
1       0      0.086          0.007
11     10      0.112          0.074
21     20      0.141          0.149
[1] 0.422
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Wybór modelu tylko po najwyższym R² skorygowanym. W symulacji wzrosło ono po dodaniu losowych zmiennych w 42.2% prób. Porównuj modele testem F zmiany, a zmienne dobieraj na podstawie teorii.
- Traktowanie R² skorygowanego jako trafności przewidywań. Opisuje wariancję wyjaśnianą w populacji; przewidywania dla nowych osób są zwykle słabsze.
- Uznawanie ujemnego R² skorygowanego za błąd programu. To poprawny wynik, który oznacza, że model nie wyjaśnia więcej niż przypadek – raportuj go bez zmian.
- Liczenie k bez zmiennych zero-jedynkowych. Predyktor jakościowy o trzech kategoriach to dwa predyktory we wzorze – zob. dummy coding.
- Podawanie samego R² przy wielu predyktorach i małej próbie. Bez wartości skorygowanej czytelnik nie oceni, ile z wyjaśnionej wariancji to dopasowanie do przypadku.
Najczęstsze pytania
Co to jest R² skorygowane?
To współczynnik determinacji z poprawką na liczbę predyktorów i wielkość próby: R²skor = 1 − (1 − R²)(n − 1)/(n − k − 1). Szacuje, jaki odsetek wariancji zmiennej zależnej model wyjaśnia w populacji, a nie tylko w badanej próbie.
Czym różni się R² od R² skorygowanego?
Zwykłe R² nigdy nie maleje po dodaniu predyktora, nawet losowego, więc przy wielu predyktorach i małej próbie jest zawyżone. R² skorygowane rośnie tylko wtedy, gdy dodane zmienne poprawiają model bardziej niż przypadek. W przykładzie z tej strony dziesięć losowych zmiennych podniosło R² z .188 do .294, a R² skorygowane obniżyło z .174 do .132.
Dlaczego R² skorygowane jest ujemne?
Bo model wyjaśnia mniej wariancji, niż wyjaśniłyby same losowe zmienne o tej samej liczbie – zdarza się to przy małym R², wielu predyktorach i małej próbie. To poprawny wynik, a nie błąd programu; interpretuje się go jako brak wyjaśnionej wariancji. W symulacji z tej strony ujemne wartości pojawiły się w 14.9% prób z dwudziestoma losowymi zmiennymi.
Które R² podać w pracy: zwykłe czy skorygowane?
Najlepiej oba, obok testu F modelu, np. R² = .19, skorygowane R² = .17, F(1, 58) = 13.39, p < .001. Gdy porównujesz modele zagnieżdżone, podaj też ΔR² z testem F zmiany, jak w regresji hierarchicznej.
Czy R² skorygowane mówi, jak model przewidzi nowe dane?
Nie. Szacuje wariancję wyjaśnianą w populacji, a trafność przewidywań dla nowych osób jest zwykle niższa. W symulacji z tej strony model z dziesięcioma losowymi zmiennymi miał średnie R² skorygowane .153, ale w nowej próbie jego R² wyniosło −.054. Trafność predykcji sprawdza się na nowych danych albo walidacją krzyżową.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., & Steyerberg, E. W. (2015). The number of subjects per variable required in linear regression analyses. Journal of Clinical Epidemiology, 68(6), 627–636. https://doi.org/10.1016/j.jclinepi.2014.12.014 ● Otwarty dostęp
- Karch, J. (2020). Improving on adjusted R-squared. Collabra: Psychology, 6(1), Article 45. https://doi.org/10.1525/collabra.343 ● Otwarty dostęp
- Yin, P., & Fan, X. (2001). Estimating R² shrinkage in multiple regression: A comparison of different analytical methods. The Journal of Experimental Education, 69(2), 203–224. https://doi.org/10.1080/00220970109600656
Cytowania BibTeX
@article{austin2015number, author={Austin, Peter C. and Steyerberg, Ewout W.}, title={{The number of subjects per variable required in linear regression analyses}}, journal={Journal of Clinical Epidemiology}, year={2015}, volume={68}, number={6}, pages={627--636}, doi={10.1016/j.jclinepi.2014.12.014}}@article{karch2020improving, author={Karch, Julian}, title={{Improving on adjusted R-squared}}, journal={Collabra: Psychology}, year={2020}, volume={6}, number={1}, eid={45}, doi={10.1525/collabra.343}}@article{yin2001estimating, author={Yin, Ping and Fan, Xitao}, title={{Estimating R² shrinkage in multiple regression: A comparison of different analytical methods}}, journal={The Journal of Experimental Education}, year={2001}, volume={69}, number={2}, pages={203--224}, doi={10.1080/00220970109600656}}