Co to jest test Durbina-Watsona?
Test Durbina-Watsona (ang. Durbin–Watson test, statystyka DW) sprawdza, czy reszty regresji kolejnych obserwacji są ze sobą skorelowane – czyli czy występuje autokorelacja reszt pierwszego rzędu. Zaproponowali go Durbin i Watson (1950) dla regresji szacowanej metodą najmniejszych kwadratów, z myślą o danych ułożonych w czasie. Autokorelacja oznacza, że jeśli model przeszacował wynik dziś, to prawdopodobnie przeszacuje go także jutro.
W psychologii taka sytuacja pojawia się wszędzie tam, gdzie te same osoby mierzy się wiele razy po kolei: w badaniach dzienniczkowych, metodzie próbkowania doświadczeń (ESM), kolejnych sesjach terapii, seriach prób eksperymentalnych i badaniach jednoprzypadkowych (zob. szereg czasowy). Klasyczna regresja liniowa zakłada niezależność błędów; przy dodatniej autokorelacji jej błędy standardowe i wartości p przestają być wiarygodne. Test Durbina-Watsona to jedno z narzędzi diagnostyki obok wykresów reszt, VIF i odległości Cooka – i jedyne z nich, które dotyczy kolejności obserwacji.
Wzór: DW ≈ 2(1 − r₁)
W liczniku są kwadraty różnic między resztami sąsiednich obserwacji, w mianowniku – suma kwadratów reszt. Gdy kolejne reszty są do siebie podobne, różnice są małe i DW spada. Dlatego statystyka jest w przybliżeniu równa 2(1 − r1), gdzie r1 to korelacja każdej reszty z resztą poprzednią:
| DW | r1 | Znaczenie |
|---|---|---|
| około 2 | około 0 | Brak autokorelacji pierwszego rzędu |
| wyraźnie poniżej 2 (w skrajnym przypadku 0) | dodatnia | Sąsiednie reszty są podobne – typowe dla danych dziennych i sesji |
| wyraźnie powyżej 2 (w skrajnym przypadku 4) | ujemna | Reszty naprzemiennie dodatnie i ujemne – rzadkie w psychologii |
Rozkład DW zależy od wartości predyktorów, więc Durbin i Watson podali tablice dwóch wartości granicznych: poniżej dL odrzuca się hipotezę o braku autokorelacji, powyżej dU się jej nie odrzuca, a pomiędzy test jest nierozstrzygający. Pierwotne tablice obejmowały szeregi od 15 do 100 obserwacji i najwyżej 5 predyktorów; Savin i White (1977) rozszerzyli je na 6–200 obserwacji i do 20 predyktorów. Dziś programy podają wartość p dla konkretnego modelu – w R funkcja lmtest::dwtest(), dokładnie dla prób poniżej 100 obserwacji i z przybliżenia normalnego dla większych. Spotykana w pracach reguła „DW między 1.5 a 2.5 jest w porządku” nie zastępuje ani testu, ani namysłu nad tym, czy kolejność obserwacji w ogóle ma znaczenie.
Przykład: stres i nastrój w badaniu dzienniczkowym
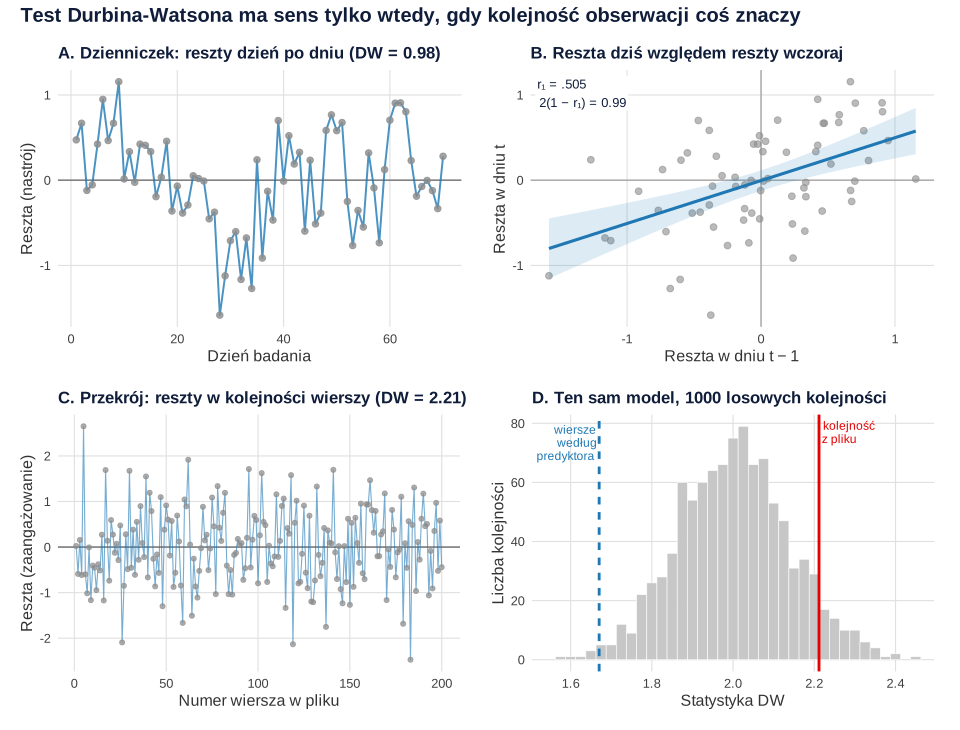
Jedna osoba przez 70 kolejnych dni (dane symulowane) oceniała wieczorem poziom stresu w ciągu dnia (0–10; M = 4.27) i swój nastrój (1–7; M = 4.32). Regresja nastroju na stres daje b = −0.26, SE = 0.04, t(68) = −6.85, p < .001: w dni bardziej stresujące nastrój był gorszy. Reszty tego modelu nie są jednak niezależne (rysunek 1A–B). Statystyka Durbina-Watsona wynosi DW = 0.98, p < .001, a korelacja reszty z resztą poprzedniego dnia r1 = .505 – zgodnie z przybliżeniem 2(1 − .505) = 0.99. Test Breuscha–Godfreya dla autokorelacji do drugiego rzędu także jest istotny, LM(2) = 22.02, p < .001.
Co to oznacza dla wyniku? Klasyczny błąd standardowy zakłada niezależne obserwacje. Błąd standardowy odporny na autokorelację (Newey–West, HAC) dla tego samego współczynnika wynosi 0.057 zamiast 0.038, czyli jest półtora raza większy. Lepszym rozwiązaniem jest model, który wprost uwzględnia autokorelację: regresja uogólnioną metodą najmniejszych kwadratów z błędami AR(1) daje b = −0.24, SE = 0.04, 95% CI [−0.31, −0.17], przy szacowanej autokorelacji błędów φ = .53. Wniosek o związku stresu z nastrojem się utrzymuje, ale do jego opisu trzeba użyć modelu dopasowanego do struktury danych, a nie zwykłej regresji.
Kiedy test ma sens, a kiedy nie
Statystyka DW dotyczy reszt sąsiadujących w pliku danych. Ma więc sens tylko wtedy, gdy kolejność wierszy coś znaczy. W badaniu ankietowym 200 pracowników (dane symulowane), w którym zaangażowanie przewidywano wsparciem przełożonego, DW w kolejności z pliku wyniosło 2.21, p = .135. Ale ten sam model przy 1000 losowych kolejnościach wierszy dawał wartości od 1.73 do 2.29 (95% wyników) – przy danych przekrojowych DW opisuje kolejność wpisania ankiet, a nie właściwość modelu. Po ułożeniu wierszy według wartości predyktora DW spadło do 1.67, poniżej niemal wszystkich losowych kolejności. Nie świadczy to o autokorelacji, tylko o tym, że związek jest lekko zakrzywiony, a prosta go nie oddaje – to sprawa dla wykresu reszt i regresji krzywoliniowej.
- Badanie przekrojowe w przypadkowej kolejności – DW nic nie wnosi. Niezależność obserwacji uzasadnia plan badania (schemat przekrojowy, brak skupień), nie test.
- Jedna osoba albo jeden obiekt mierzony w czasie – DW (albo lepiej test Breuscha–Godfreya) to podstawowa diagnostyka. Przy krótkich seriach zachowaj ostrożność: Huitema i McKean (1991) pokazali, że w małych próbach typowe estymatory autokorelacji są obciążone, a empiryczny odsetek błędów I rodzaju może znacznie odbiegać od nominalnego.
- Model z opóźnioną zmienną zależną (np. wczorajszy nastrój jako predyktor) – zamiast DW użyj testu Breuscha–Godfreya; Godfrey (1978) wyprowadził test mnożników Lagrange’a dla takich modeli i dla autokorelacji wyższych rzędów.
- Wiele osób, wiele dni – nie licz DW na „sklejonych” danych wszystkich osób. Hamaker i Wichers (2017) opisują dwie drogi: analizę szeregu czasowego dla pojedynczej osoby albo dynamiczny model wielopoziomowy, który opisuje proces wewnątrzosobowy i różnice między osobami. Wprowadzenie do analizy szeregów czasowych dla psychologów, z samouczkiem w R, przygotowali Jebb i in. (2015).
Jak opisać test Durbina-Watsona w pracy (APA)
Podaj statystykę DW z wartością p (lub z wartościami granicznymi z tablic), oszacowaną autokorelację i to, jak ją uwzględniono. Wzór dla przykładu dzienniczkowego:
W pracy opartej na jednorazowej ankiecie nie raportuj DW jako dowodu niezależności obserwacji – wystarczy opis doboru próby. Jak zbudować cały akapit o założeniach regresji, pokazujemy w poradniku regresja wieloraka krok po kroku, a o badaniach podłużnych – we wpisie o modelach cross-lagged.
Przykład w R i SPSS
Kod tworzy oba zbiory z przykładu, liczy statystykę Durbina-Watsona i autokorelację reszt, wykonuje test Breuscha–Godfreya, porównuje klasyczne błędy standardowe z odpornymi (HAC) i z modelem AR(1), a dla danych przekrojowych sprawdza, jak DW zależy od kolejności wierszy. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Test Durbina-Watsona, test Breuscha–Godfreya i model AR(1)
R
suppressPackageStartupMessages({
  library(lmtest)     # dwtest(), bgtest(), coeftest()
  library(sandwich)   # NeweyWest() – błędy standardowe odporne na autokorelację
  library(nlme)       # gls() z autokorelacją reszt AR(1)
})

# 1. Dane dzienniczkowe (symulowane): jedna osoba, 70 kolejnych dni – stres (0–10) i wieczorny nastrój (1–7)
set.seed(3818)
n <- 70
stres   <- round(pmin(pmax(4.5 + arima.sim(list(ar = 0.5), n, sd = 1.4), 0), 10), 1)
nastroj <- round(pmin(pmax(5.4 - 0.22 * stres + arima.sim(list(ar = 0.55), n, sd = 0.55), 1), 7), 2)
dziennik <- data.frame(dzien = 1:n, stres, nastroj)
round(sapply(dziennik[, -1], mean), 2)          # średni stres i nastrój
m_dz <- lm(nastroj ~ stres, data = dziennik)
round(summary(m_dz)$coefficients, 3)

dwtest(m_dz)                                     # H1: dodatnia autokorelacja reszt
e  <- resid(m_dz)
r1 <- cor(e[-1], e[-n])                          # autokorelacja reszt z opóźnieniem 1
round(c(r1 = r1, przyblizenie_DW = 2 * (1 - r1)), 3)
bgtest(m_dz, order = 2)                          # test Breuscha–Godfreya (rzędy 1–2)

# Co dalej: błędy standardowe HAC (Newey–West) albo model z autokorelacją AR(1)
coeftest(m_dz, vcov. = NeweyWest(m_dz))
m_ar1 <- gls(nastroj ~ stres, data = dziennik, correlation = corAR1(form = ~ dzien))
round(summary(m_ar1)$tTable, 3)
round(confint(m_ar1), 3)
round(coef(m_ar1$modelStruct$corStruct, unconstrained = FALSE), 3)   # oszacowane phi

# 2. Dane przekrojowe (symulowane): 200 pracowników w przypadkowej kolejności wierszy
set.seed(380)
n2 <- 200
wsparcie <- round(runif(n2, 1, 5), 1)
zaangazowanie <- round(0.3 + 2.4 * wsparcie - 0.32 * wsparcie^2 + rnorm(n2, sd = 0.7), 2)   # związek lekko zakrzywiony
przekroj <- data.frame(wsparcie, zaangazowanie)
m_prz <- lm(zaangazowanie ~ wsparcie, data = przekroj)
dwtest(m_prz, alternative = "two.sided")
# Ta sama regresja, tylko inna kolejność wierszy:
posortowane <- przekroj[order(przekroj$wsparcie), ]
round(dwtest(lm(zaangazowanie ~ wsparcie, data = posortowane))$statistic, 3)     # wiersze ułożone według wsparcia
dw_losowe <- replicate(1000, dwtest(lm(zaangazowanie ~ wsparcie, data = przekroj[sample(n2), ]))$statistic)
round(quantile(dw_losowe, c(.025, .5, .975)), 3)                                  # 1000 losowych kolejności
Wynik w R
  stres nastroj
   4.27    4.32
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    5.425      0.175  30.934        0
stres         -0.258      0.038  -6.849        0

	Durbin-Watson test

data:  m_dz
DW = 0.98384, p-value = 1.653e-06
alternative hypothesis: true autocorrelation is greater than 0

             r1 przyblizenie_DW
          0.505           0.990

	Breusch-Godfrey test for serial correlation of order up to 2

data:  m_dz
LM test = 22.015, df = 2, p-value = 1.658e-05


t test of coefficients:

             Estimate Std. Error t value  Pr(>|t|)
(Intercept)  5.424925   0.193442 28.0442 < 2.2e-16 ***
stres       -0.258497   0.057212 -4.5182 2.554e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

             Value Std.Error t-value p-value
(Intercept)  5.360     0.202  26.471       0
stres       -0.241     0.037  -6.452       0
             2.5 % 97.5 %
(Intercept)  4.963  5.757
stres       -0.314 -0.168
  Phi
0.527

	Durbin-Watson test

data:  m_prz
DW = 2.2116, p-value = 0.1354
alternative hypothesis: true autocorrelation is not 0

  DW
1.67
 2.5%   50% 97.5%
1.733 2.003 2.286
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- DW w pracy ankietowej jako „dowód niezależności obserwacji”. Przy losowej kolejności wierszy wynik zależy od tego, w jakim porządku zapisano ankiety.
- Dane nieposortowane według czasu. SPSS i R liczą DW w kolejności wierszy; po sortowaniu według innej zmiennej wynik traci sens.
- DW w modelu z opóźnioną zmienną zależną. Użyj testu Breuscha–Godfreya (Godfrey, 1978).
- Traktowanie DW ≈ 2 jako braku jakiejkolwiek autokorelacji. DW dotyczy tylko sąsiednich obserwacji; cykl tygodniowy (opóźnienie 7) wykryje test Breuscha–Godfreya z odpowiednim rzędem.
- Liczenie DW na danych wielu osób ułożonych jedna pod drugą. Granice między osobami zaburzają wynik; właściwym narzędziem jest model wielopoziomowy.
- Wykrycie autokorelacji i pozostawienie zwykłej regresji. Błędy standardowe są wtedy zwykle zbyt optymistyczne – w przykładzie klasyczny SE był o jedną trzecią mniejszy od odpornego.
Tematy pokrewne: przy analizie reszt w czasie przydają się też hasła VIF i współliniowość (predyktory zmieniające się razem w czasie bywają silnie skorelowane), a predyktory kategorialne, np. dzień tygodnia, koduje się zmiennymi zero-jedynkowymi (dummy coding).
Najczęstsze pytania
Jak interpretować test Durbina-Watsona?
Wartość DW bliska 2 oznacza brak autokorelacji reszt pierwszego rzędu. Wartości wyraźnie poniżej 2 (w skrajnym przypadku 0) wskazują na autokorelację dodatnią, a powyżej 2 (do 4) – na ujemną. Decyzję podejmuj na podstawie wartości p (np. z lmtest::dwtest()) albo wartości granicznych z tablic, a nie samej reguły „1.5–2.5”.
Jaka wartość Durbina-Watsona jest dobra?
Pożądana jest wartość zbliżona do 2. Zakres, który uznaje się za „bez autokorelacji”, zależy od liczby obserwacji i predyktorów – dlatego istnieją tablice wartości granicznych dL i dU. W przykładzie z tej strony DW = 0.98 przy 70 dniach obserwacji oznaczało wyraźną autokorelację dodatnią, p < .001.
Czy w pracy z ankietą trzeba podawać test Durbina-Watsona?
Zwykle nie. W jednorazowym badaniu przekrojowym kolejność wierszy jest przypadkowa, więc DW opisuje kolejność wpisania ankiet, a nie właściwość modelu. Niezależność obserwacji uzasadnij planem badania i doborem próby.
Czym różni się test Durbina-Watsona od testu Breuscha-Godfreya?
Test Durbina-Watsona dotyczy tylko autokorelacji pierwszego rzędu i nie nadaje się do modeli z opóźnioną zmienną zależną. Test Breuscha–Godfreya sprawdza autokorelację do wybranego rzędu (np. 7 przy cyklu tygodniowym) i działa także w modelach dynamicznych (Godfrey, 1978). W R: lmtest::bgtest(model, order = 2).
Co zrobić, gdy reszty są autokorelowane?
Użyj modelu, który uwzględnia zależność w czasie – np. regresji z błędami AR(1) (nlme::gls() z corAR1()), a przy danych wielu osób – modelu wielopoziomowego. Minimum to błędy standardowe odporne na autokorelację (Newey–West). Zwykła regresja daje wtedy zbyt optymistyczne błędy standardowe.
Jak policzyć test Durbina-Watsona w SPSS?
Analiza → Regresja → Liniowa → Statystyki → zaznacz Durbin-Watson. Wynik pojawi się w tabeli „Model – podsumowanie”, ale bez wartości p. Pamiętaj, by wcześniej posortować dane według czasu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression. I. Biometrika, 37(3–4), 409–428. https://doi.org/10.1093/biomet/37.3-4.409
- Godfrey, L. G. (1978). Testing against general autoregressive and moving average error models when the regressors include lagged dependent variables. Econometrica, 46(6), 1293–1301. https://doi.org/10.2307/1913829
- Hamaker, E. L., & Wichers, M. (2017). No time like the present: Discovering the hidden dynamics in intensive longitudinal data. Current Directions in Psychological Science, 26(1), 10–15. https://doi.org/10.1177/0963721416666518 ● Otwarty dostęp: pełny tekst
- Huitema, B. E., & McKean, J. W. (1991). Autocorrelation estimation and inference with small samples. Psychological Bulletin, 110(2), 291–304. https://doi.org/10.1037/0033-2909.110.2.291
- Jebb, A. T., Tay, L., Wang, W., & Huang, Q. (2015). Time series analysis for psychological research: Examining and forecasting change. Frontiers in Psychology, 6, Article 727. https://doi.org/10.3389/fpsyg.2015.00727 ● Otwarty dostęp
- Savin, N. E., & White, K. J. (1977). The Durbin-Watson test for serial correlation with extreme sample sizes or many regressors. Econometrica, 45(8), 1989–1996. https://doi.org/10.2307/1914122
Cytowania BibTeX
@article{durbin1950testing, author={Durbin, J. and Watson, G. S.}, title={{Testing for serial correlation in least squares regression. I}}, journal={Biometrika}, year={1950}, volume={37}, number={3–4}, pages={409--428}, doi={10.1093/biomet/37.3-4.409}}@article{godfrey1978testing, author={Godfrey, L. G.}, title={{Testing against general autoregressive and moving average error models when the regressors include lagged dependent variables}}, journal={Econometrica}, year={1978}, volume={46}, number={6}, pages={1293--1301}, doi={10.2307/1913829}}@article{hamaker2017no, author={Hamaker, Ellen L. and Wichers, Marieke}, title={{No time like the present: Discovering the hidden dynamics in intensive longitudinal data}}, journal={Current Directions in Psychological Science}, year={2017}, volume={26}, number={1}, pages={10--15}, doi={10.1177/0963721416666518}}@article{huitema1991autocorrelation, author={Huitema, Bradley E. and McKean, Joseph W.}, title={{Autocorrelation estimation and inference with small samples}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={291--304}, doi={10.1037/0033-2909.110.2.291}}@article{jebb2015time, author={Jebb, Andrew T. and Tay, Louis and Wang, Wei and Huang, Qiming}, title={{Time series analysis for psychological research: Examining and forecasting change}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={727}, doi={10.3389/fpsyg.2015.00727}}@article{savin1977durbin, author={Savin, N. E. and White, Kenneth J.}, title={{The Durbin-Watson test for serial correlation with extreme sample sizes or many regressors}}, journal={Econometrica}, year={1977}, volume={45}, number={8}, pages={1989--1996}, doi={10.2307/1914122}}