Co to jest współliniowość?
Współliniowość (ang. collinearity, przy wielu zmiennych także multicollinearity) to silny liniowy związek między predyktorami w modelu regresji. Dormann i in. (2013) opisują ją jako brak niezależności predyktorów, który zawyża wariancję oszacowań parametrów i może prowadzić do błędnego wskazania, które predyktory są ważne. W psychologii pojawia się szczególnie często, bo wiele konstruktów zachodzi na siebie: neurotyczność i lęk, ruminacja i zamartwianie się, podskale jednego kwestionariusza, wiek i staż pracy.
Skrajnym przypadkiem jest współliniowość doskonała: jeden predyktor jest dokładną kombinacją liniową innych, np. gdy do modelu trafia wynik ogólny skali razem ze wszystkimi podskalami albo wszystkie zmienne zero-jedynkowe jednej zmiennej kategorialnej obok stałej (zob. dummy coding). Takiego modelu nie da się oszacować – R wypisze dla jednego ze współczynników NA, a SPSS usunie zmienną z analizy. W praktyce częstsza jest współliniowość silna, ale niedoskonała: model działa, tylko część współczynników staje się mało precyzyjna.
Współliniowość to jeden z kilku tematów diagnostyki regresji wielorakiej, obok nieliniowości i heteroskedastyczności reszt, obserwacji wpływowych (odległość Cooka) i autokorelacji (test Durbina-Watsona). Miarę współliniowości – jak ją policzyć i jakie progi przyjmuje się zwyczajowo – omawiamy w haśle współczynnik VIF. Tutaj zajmujemy się samym zjawiskiem: co robi z wynikami i co z nim zrobić.
Skutki: szerokie przedziały ufności, niestabilne współczynniki, zmiany znaku
Najłatwiej zobaczyć skutki współliniowości w symulacji. Z modelu, w którym oba predyktory mają taki sam dodatni efekt (prawdziwe b1 = b2 = 0.30), wylosowaliśmy po 2000 prób liczących 100 osób – raz przy korelacji predyktorów .20, raz przy korelacji .90 – i za każdym razem oszacowaliśmy regresję z oboma predyktorami (rysunek 1).
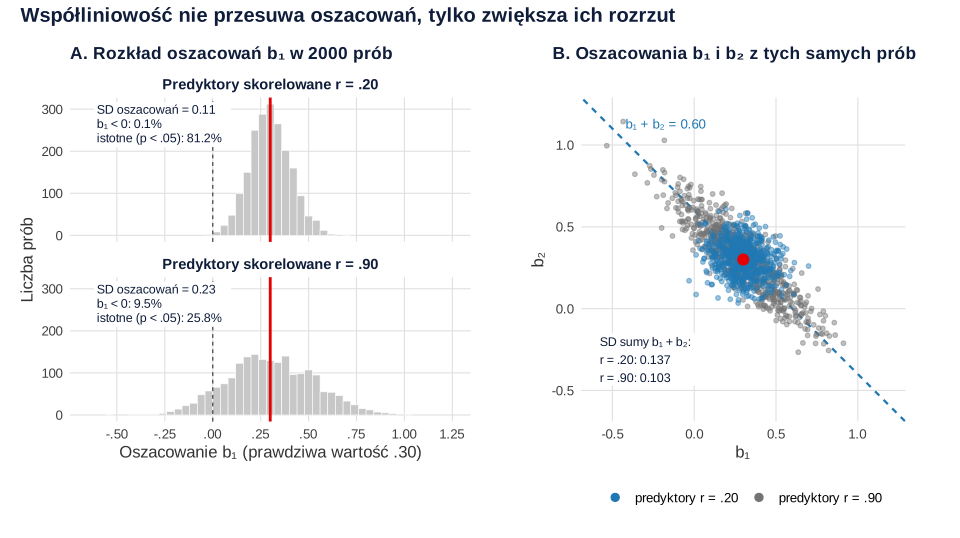
- Większy rozrzut, ten sam środek. Przy korelacji .90 odchylenie standardowe oszacowań b1 wyniosło 0.23 zamiast 0.11 (2.15 raza więcej; teoretycznie 2.25). Oba rozkłady skupiają się jednak wokół prawdziwej wartości – współliniowość nie obciąża współczynników, tylko odbiera im precyzję.
- Spadek mocy dla pojedynczych współczynników. Istotny wynik dla b1 pojawił się w 81.2% prób przy korelacji .20, ale tylko w 25.8% przy korelacji .90 – mimo identycznego efektu (zob. moc testu).
- Zmiany znaku. Przy korelacji .90 aż 9.5% oszacowań było ujemnych, choć prawdziwy efekt był dodatni. Kalnins (2018) pokazuje, że gdy predyktory łączy wspólny nieobserwowany czynnik, para dużych współczynników o przeciwnych znakach może być wynikiem fałszywie dodatnim, a VIF nie musi tego wychwycić.
- Przerzucanie efektu między predyktorami. Panel B pokazuje, że gdy b1 wychodzi za duże, b2 wychodzi za małe. Suma obu współczynników jest oszacowana precyzyjnie – przy korelacji .90 nawet dokładniej (SD 0.103) niż przy korelacji .20 (SD 0.137). Model dobrze wie, ile wyjaśniają oba predyktory razem; nie wie tylko, jak podzielić efekt między nie.
Współliniowość nie zmienia też dopasowania modelu (R², test F) ani jakości przewidywań – o ile nowe dane mają podobną strukturę korelacji. Dormann i in. (2013) zwracają uwagę, że przewidywania pogarszają się, gdy struktura współliniowości w nowych danych jest inna niż w danych, na których model oszacowano.
Przykład: ruminacja, zamartwianie się i objawy depresji
W badaniu 150 studentów (dane symulowane) zmierzono ruminację (1–4), zamartwianie się (16–80) i objawy depresji (0–27). Ruminacja i zamartwianie korelowały ze sobą na poziomie r = .85, a z depresją odpowiednio r = .66 i r = .52. W modelu, z którego wylosowano dane, oba predyktory miały dodatni związek z depresją.
| Model | Predyktor | b | SE | 95% CI | p | R² |
|---|---|---|---|---|---|---|
| 1 | Ruminacja | 6.11 | 0.57 | [4.98, 7.24] | < .001 | .435 |
| 2 | Zamartwianie | 0.25 | 0.03 | [0.18, 0.31] | < .001 | .275 |
| 3 | Ruminacja | 7.08 | 1.08 | [4.95, 9.20] | < .001 | .440 |
| Zamartwianie | −0.06 | 0.05 | [−0.16, 0.05] | .293 | ||
| 4 | Wskaźnik łączny | 3.26 | 0.34 | [2.58, 3.93] | < .001 | .380 |
Osobno oba predyktory są wyraźnie związane z depresją. Razem (model 3) błąd standardowy ruminacji rośnie z 0.57 do 1.08, a współczynnik zamartwiania zmienia znak na ujemny, choć z depresją koreluje ono dodatnio. VIF wynosi tu tylko 3.54, a więc poniżej popularnych progów. R² rośnie z .435 do .440, ale test łączny obu predyktorów jest silnie istotny, F(2, 147) = 57.68, p < .001.
Ujemnego współczynnika nie należy czytać jako „zamartwianie chroni przed depresją”. Przedział ufności [−0.16, 0.05] obejmuje zero i wartości dodatnie, a z rysunku 1 wiadomo, że przy silnie skorelowanych predyktorach zły znak zdarza się przypadkiem. Poprawny wniosek brzmi: zamartwianie nie wnosi wiele ponad ruminację, bo ich wspólna część jest ogromna. Prawdziwa supresja to inny mechanizm – wymaga uzasadnienia teoretycznego i stabilnego wyniku, a nie pojedynczego współczynnika z szerokim przedziałem ufności.
Co zrobić ze współliniowością?
Vanhove (2021) przekonuje, że współliniowość sama w sobie nie jest problemem do „wyleczenia”: kłopoty wynikają z uproszczonej interpretacji współczynników, a popularne „lekarstwa” albo obciążają oszacowania, albo zmieniają pytanie badawcze. Dlatego decyzję zacznij od pytania, czego chcesz się dowiedzieć.
- Interesuje cię wspólny efekt grupy predyktorów – zostaw je w modelu i przetestuj łącznie (F dla bloku albo przyrost R² w regresji hierarchicznej).
- Predyktory mierzą ten sam konstrukt – połącz je, np. w średnią wyników standaryzowanych. W przykładzie wskaźnik „powtarzającego się negatywnego myślenia” ma wąski przedział ufności, ale wyjaśnia mniej wariancji niż sama ruminacja (R² = .38 wobec .44), bo zakłada równe wagi obu składników. To już odpowiedź na inne pytanie. Alternatywą jest zmienna latentna w modelu SEM.
- Jeden predyktor jest teoretycznie ważniejszy – wybierz go z góry, a nie na podstawie wartości p czy metody krokowej, która przy współliniowości daje niestabilny wybór.
- Celem jest predykcja – rozważ regresję grzbietową (ang. ridge regression). Hoerl i Kennard (1970) zaproponowali dodanie niewielkiej stałej do przekątnej macierzy X′X: daje to oszacowania obciążone, ale o mniejszym średnim błędzie kwadratowym. W symulacjach Dormanna i in. (2013) dobrze sprawdzało się połączenie klasycznego modelu z metodami penalizowanymi, zwłaszcza grzbietową. W pracy dyplomowej testującej hipotezy to rzadko właściwy wybór.
- Współliniowość wynika z interakcji lub kwadratu predyktora – wycentruj zmienne. W przykładzie korelacja zamartwiania z jego kwadratem spada po wycentrowaniu z .992 do .137. Dalal i Zickar (2012) pokazują jednak, że centrowanie usuwa tylko współliniowość „nieistotną” (techniczną): nie zmienia współczynnika najwyższego rzędu, dopasowania modelu ani mocy testu interakcji, a ułatwia interpretację współczynników niższego rzędu (zob. regresja krzywoliniowa i moderacja).
Zawsze pomaga też większa próba: zmniejsza błędy standardowe niezależnie od korelacji predyktorów. Pełną ścieżkę – od macierzy korelacji, przez VIF, po interpretację – pokazujemy w poradniku regresja wieloraka krok po kroku.
Jak opisać współliniowość w pracy (APA)
Napisz, które predyktory są silnie powiązane, jak oceniono współliniowość i jak wpłynęła na interpretację. Wzór dla przykładu:
Przykład w R i SPSS
Kod tworzy dane z przykładu, porównuje modele z jednym i dwoma predyktorami, liczy VIF i test łączny, buduje wskaźnik łączny oraz pokazuje, jak centrowanie zmienia korelację zmiennej z jej kwadratem. Liczby w tabeli i w tekście pochodzą z tego kodu; symulację z rysunku 1 zawiera skrypt rysunku.
Współliniowość ruminacji i zamartwiania się
R
suppressPackageStartupMessages({
  library(car)    # vif()
  library(MASS)   # mvrnorm() – tylko do symulacji danych
})

# Dane symulowane: N = 150 studentów; ruminacja (1–4), zamartwianie się (16–80), objawy depresji (0–27).
# W modelu generującym dane OBA predyktory mają dodatni związek z depresją.
set.seed(3698)
n <- 150
Z <- mvrnorm(n, mu = c(0, 0), Sigma = matrix(c(1, .85, .85, 1), 2))
ruminacja    <- round(pmin(pmax(2.3 + 0.55 * Z[, 1], 1), 4), 2)
zamartwianie <- round(pmin(pmax(50 + 11 * Z[, 2], 16), 80))
depresja     <- round(pmin(pmax(9 + 2.4 * Z[, 1] + 1.4 * Z[, 2] + rnorm(n, sd = 4), 0), 27))
dane <- data.frame(depresja, ruminacja, zamartwianie)
round(cor(dane), 2)

# Każdy predyktor osobno i oba razem: b, SE, p i 95% CI
wsp <- function(m) round(cbind(summary(m)$coefficients[-1, -3, drop = FALSE], confint(m)[-1, , drop = FALSE]), 3)
m_rum  <- lm(depresja ~ ruminacja, data = dane)
m_zam  <- lm(depresja ~ zamartwianie, data = dane)
m_oba  <- lm(depresja ~ ruminacja + zamartwianie, data = dane)
wsp(m_rum); wsp(m_zam); wsp(m_oba)
round(c(R2_rum = summary(m_rum)$r.squared, R2_zam = summary(m_zam)$r.squared, R2_oba = summary(m_oba)$r.squared), 3)
vif(m_oba)

# Test łączny: czy oba predyktory razem coś wyjaśniają?
anova(lm(depresja ~ 1, data = dane), m_oba)

# Jedno z rozwiązań: wskaźnik łączny (średnia wyników z) – „powtarzające się negatywne myślenie”
dane$rnt <- as.numeric((scale(dane$ruminacja) + scale(dane$zamartwianie)) / 2)
m_rnt <- lm(depresja ~ rnt, data = dane)
wsp(m_rnt); round(summary(m_rnt)$r.squared, 3)

# Współliniowość „nieistotna” (techniczna): X i X² przed wycentrowaniem i po nim
zc <- dane$zamartwianie - mean(dane$zamartwianie)
round(c(surowe = cor(dane$zamartwianie, dane$zamartwianie^2), wycentrowane = cor(zc, zc^2)), 3)
Wynik w R
             depresja ruminacja zamartwianie
depresja         1.00      0.66         0.52
ruminacja        0.66      1.00         0.85
zamartwianie     0.52      0.85         1.00
          Estimate Std. Error Pr(>|t|) 2.5 % 97.5 %
ruminacja    6.112      0.572        0 4.982  7.243
             Estimate Std. Error Pr(>|t|) 2.5 % 97.5 %
zamartwianie    0.245      0.033        0 0.181   0.31
             Estimate Std. Error Pr(>|t|)  2.5 % 97.5 %
ruminacja       7.076      1.077    0.000  4.948  9.203
zamartwianie   -0.057      0.054    0.293 -0.165  0.050
R2_rum R2_zam R2_oba
 0.435  0.275  0.440
   ruminacja zamartwianie
    3.543829     3.543829
Analysis of Variance Table

Model 1: depresja ~ 1
Model 2: depresja ~ ruminacja + zamartwianie
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    149 3847.3
2    147 2155.7  2    1691.6 57.678 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
    Estimate Std. Error Pr(>|t|) 2.5 % 97.5 %
rnt    3.258      0.342        0 2.581  3.934
[1] 0.38
      surowe wycentrowane
       0.992        0.137
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Interpretowanie zmiany znaku jako odkrycia. Ujemny współczynnik predyktora skorelowanego dodatnio z wynikiem przy szerokim przedziale ufności to często szum, a nie efekt ochronny (Kalnins, 2018).
- Wniosek „predyktor nie ma związku z wynikiem”, bo jest nieistotny w modelu. Zamartwianie koreluje z depresją (r = .52); nieistotny jest tylko jego wkład ponad ruminację.
- Sprawdzanie wyłącznie korelacji par predyktorów. Współliniowość może dotyczyć trzech i więcej zmiennych bez wysokiej korelacji w żadnej parze – dlatego liczy się VIF. Z drugiej strony umiarkowany VIF, jak w przykładzie (3.54), nie wyklucza problemów z interpretacją.
- Centrowanie jako lekarstwo na współliniowość różnych konstruktów. Wycentrowanie ruminacji i zamartwiania nie zmieni ich korelacji .85 (Dalal i Zickar, 2012).
- Wynik ogólny i podskale w jednym modelu albo komplet zmiennych zero-jedynkowych obok stałej – to współliniowość doskonała, której program „pozbywa się” sam, usuwając jedną zmienną bez pytania.
- Usuwanie predyktora tylko po to, by obniżyć VIF. Model bez ważnej zmiennej odpowiada na inne pytanie i może przypisać jej efekt pozostałym predyktorom (Vanhove, 2021).
Najczęstsze pytania
Co to jest współliniowość w regresji?
To sytuacja, w której predyktory są ze sobą silnie liniowo powiązane, np. dwie skale mierzące podobny konstrukt. Model nadal dobrze przewiduje wynik, ale trudno oddzielić wkład każdego predyktora: współczynniki mają duże błędy standardowe i szerokie przedziały ufności.
Jakie są skutki współliniowości?
Większe błędy standardowe i mniejsza moc dla pojedynczych współczynników, niestabilność oszacowań między próbami i możliwa zmiana znaku. W symulacji z tej strony przy korelacji predyktorów .90 istotny wynik pojawiał się w 25.8% prób zamiast 81.2%, a 9.5% oszacowań miało zły znak. Współczynniki nie są przy tym obciążone.
Jak sprawdzić współliniowość?
Obejrzyj macierz korelacji predyktorów i policz VIF dla każdego z nich (w R: car::vif(), w SPSS: Diagnostyka współliniowości). Zwróć uwagę na objawy: szerokie przedziały ufności, nieistotne współczynniki przy istotnym teście F całego modelu i znaki niezgodne z korelacjami.
Jak usunąć współliniowość?
Często nie trzeba jej usuwać. Jeśli interesuje cię wspólny efekt – przetestuj predyktory łącznie; jeśli mierzą ten sam konstrukt – połącz je we wskaźnik albo zmienną latentną; jeśli współliniowość wynika z interakcji lub kwadratu – wycentruj zmienne. Regresja grzbietowa pomaga przy predykcji, a większa próba zawsze zmniejsza błędy standardowe.
Czy centrowanie zmiennych usuwa współliniowość?
Tylko współliniowość techniczną między zmienną a jej iloczynem lub kwadratem: w przykładzie z tej strony korelacja zmiennej z jej kwadratem spadła z .992 do .137. Centrowanie nie zmienia korelacji między różnymi predyktorami ani testu interakcji (Dalal i Zickar, 2012).
Czym różni się współliniowość od VIF?
Współliniowość to zjawisko – związek między predyktorami i jego skutki dla oszacowań. VIF to wskaźnik, który mierzy, o ile współliniowość zwiększa wariancję współczynnika konkretnego predyktora. Wysoki VIF sygnalizuje współliniowość, ale o tym, czy jest ona problemem, decyduje pytanie badawcze i precyzja wyników.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM)
Model pomiarowy i strukturalny, rodzaje modeli SEM, CB-SEM czy PLS-SEM, symulacja w R i etapy analizy od teorii do raportu.
Czytaj →PoradnikWysoki VIF – co zrobić ze współliniowością?
Kiedy wysoki VIF jest problemem, a kiedy nie, dlaczego nie usuwać predyktorów tylko z jego powodu i jak opisać współliniowość w pracy – z przykładem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dalal, D. K., & Zickar, M. J. (2012). Some common myths about centering predictor variables in moderated multiple regression and polynomial regression. Organizational Research Methods, 15(3), 339–362. https://doi.org/10.1177/1094428111430540
- Dormann, C. F., Elith, J., Bacher, S., Buchmann, C., Carl, G., Carré, G., Marquéz, J. R. G., Gruber, B., Lafourcade, B., Leitão, P. J., Münkemüller, T., McClean, C., Osborne, P. E., Reineking, B., Schröder, B., Skidmore, A. K., Zurell, D., & Lautenbach, S. (2013). Collinearity: A review of methods to deal with it and a simulation study evaluating their performance. Ecography, 36(1), 27–46. https://doi.org/10.1111/j.1600-0587.2012.07348.x ● Otwarty dostęp
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Kalnins, A. (2018). Multicollinearity: How common factors cause Type 1 errors in multivariate regression. Strategic Management Journal, 39(8), 2362–2385. https://doi.org/10.1002/smj.2783
- Vanhove, J. (2021). Collinearity isn’t a disease that needs curing. Meta-Psychology, 5. https://doi.org/10.15626/mp.2021.2548 ● Otwarty dostęp
Cytowania BibTeX
@article{dalal2012some, author={Dalal, Dev K. and Zickar, Michael J.}, title={{Some common myths about centering predictor variables in moderated multiple regression and polynomial regression}}, journal={Organizational Research Methods}, year={2012}, volume={15}, number={3}, pages={339--362}, doi={10.1177/1094428111430540}}@article{dormann2013collinearity, author={Dormann, Carsten F. and Elith, Jane and Bacher, Sven and Buchmann, Carsten and Carl, Gudrun and Carré, Gabriel and Marquéz, Jaime R. García and Gruber, Bernd and Lafourcade, Bruno and Leitão, Pedro J. and Münkemüller, Tamara and McClean, Colin and Osborne, Patrick E. and Reineking, Björn and Schröder, Boris and Skidmore, Andrew K. and Zurell, Damaris and Lautenbach, Sven}, title={{Collinearity: A review of methods to deal with it and a simulation study evaluating their performance}}, journal={Ecography}, year={2013}, volume={36}, number={1}, pages={27--46}, doi={10.1111/j.1600-0587.2012.07348.x}}@article{hoerl1970ridge, author={Hoerl, Arthur E. and Kennard, Robert W.}, title={{Ridge regression: Biased estimation for nonorthogonal problems}}, journal={Technometrics}, year={1970}, volume={12}, number={1}, pages={55--67}, doi={10.1080/00401706.1970.10488634}}@article{kalnins2018multicollinearity, author={Kalnins, Arturs}, title={{Multicollinearity: How common factors cause Type 1 errors in multivariate regression}}, journal={Strategic Management Journal}, year={2018}, volume={39}, number={8}, pages={2362--2385}, doi={10.1002/smj.2783}}@article{vanhove2021collinearity, author={Vanhove, Jan}, title={{Collinearity isn’t a disease that needs curing}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2021.2548}}