Kiedy potrzebujesz regresji wielorakiej?
Załóżmy, że w pracy magisterskiej badasz satysfakcję z życia studentów. Wiesz z literatury, że wiąże się ona ze stresem, ze wsparciem społecznym i z samooceną, a także z tym, czy ktoś jest w związku. Każdą z tych zależności można sprawdzić osobno korelacją, ale promotor zadaje inne pytanie: czy wsparcie i samoocena mają znaczenie także wtedy, gdy uwzględnimy stres? Na takie pytania odpowiada regresja wieloraka – regresja liniowa z kilkoma predyktorami, w której każdy współczynnik opisuje związek przy stałym poziomie pozostałych zmiennych.
W tym poradniku przechodzimy przez całą analizę – od pytania badawczego, przez przygotowanie danych i sprawdzenie założeń, po interpretację i gotowy opis w stylu APA. Przez cały tekst pracujemy na jednym zbiorze danych (dane symulowane): 246 studentów wypełniło skalę satysfakcji z życia (5–35 punktów), skalę stresu (0–40), skalę wsparcia społecznego (średnia z pozycji ocenianych na skali 1–7) i skalę samooceny (10–40) oraz odpowiedziało, czy jest w związku. Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z kodu z sekcji Przykład w R. Krótką definicję modelu z jednym predyktorem znajdziesz w haśle regresja prosta.
Krok 1. Sformułuj pytanie badawcze i zapisz model
Regresja wieloraka nie jest „maszynką do sprawdzania wszystkiego naraz”. Zanim cokolwiek policzysz, zapisz, jaką rolę pełni każda zmienna i jaką hipotezę testujesz. W przykładzie:
- Zmienna zależna (Y): satysfakcja z życia (5–35).
- Predyktory: stres (0–40), wsparcie społeczne (1–7), samoocena (10–40) i bycie w związku (nie/tak).
- Pytanie badawcze: czy zasoby psychologiczne – wsparcie społeczne i samoocena – wiążą się z satysfakcją z życia ponad to, co wyjaśniają stres i bycie w związku?
- Hipotezy: wyższe wsparcie i wyższa samoocena wiążą się z wyższą satysfakcją przy kontroli stresu i bycia w związku, a oba zasoby razem zwiększają wyjaśnioną wariancję.
Model końcowy ma postać:
Ponieważ pytanie brzmi „czy zasoby wnoszą coś ponad stres i związek”, predyktory wprowadzimy w dwóch blokach – najpierw stres i związek, potem wsparcie i samoocenę. To regresja hierarchiczna: kolejność bloków wynika z pytania badawczego, a nie z wyników. Nie dobieraj predyktorów metodą krokową – Thompson (1995) pokazał, że takie procedury zawyżają istotność, nie znajdują najlepszego zestawu zmiennych i dają wyniki, które słabo się replikują.
Liczebność próby zaplanuj przed badaniem. Green (1991) sprawdził popularne reguły kciuka i znalazł pewne poparcie dla reguły N ≥ 50 + 8m (dla testu całego modelu, m – liczba predyktorów) i N ≥ 104 + m (dla pojedynczych predyktorów), ale podkreślił, że zakładają one efekt średniej wielkości; lepiej uwzględnić oczekiwaną wielkość efektu. Taką analizę mocy dla regresji wielorakiej policzysz w programie G*Power (Faul i in., 2009); program ma też wariant dla przyrostu R² (R² increase), potrzebny przy regresji hierarchicznej. Symulacje Austina i Steyerberga (2015) pokazują z kolei, że do trafnego oszacowania samych współczynników wystarczą już około dwie obserwacje na predyktor – to jednak dolna granica precyzji, a nie liczebność zapewniająca odpowiednią moc. Więcej o planowaniu próby piszemy w poradniku dobór liczebności próby.
Krok 2. Przygotuj dane
Większość problemów z regresją zaczyna się na etapie danych. Zanim dopasujesz model, sprawdź cztery rzeczy.
Braki danych
W przykładzie sześć osób nie wypełniło skali samooceny. Funkcja lm() w R i procedura regresji w SPSS domyślnie usuwają takie osoby z analizy (analiza kompletnych obserwacji), więc model oszacowano na 240 osobach. Przy kilku procentach braków to zwykle akceptowalne, ale zawsze podaj, ile osób wykluczono i dlaczego. Gdy braków jest więcej, zastanów się nad ich mechanizmem (MCAR, MAR, MNAR) i rozważ imputację wielokrotną – krok po kroku opisujemy ją w poradniku braki danych i imputacja wielokrotna w R.
Zakresy i wyniki skal
Wszystkie wartości mieściły się w zakresach skal: satysfakcja od 6 do 35, stres od 3 do 40, wsparcie od 2.67 do 7, samoocena od 16 do 40. Wartość spoza skali (np. satysfakcja 53) to zwykle błąd wprowadzania danych. Wyniki skal policz dopiero po przekodowaniu pozycji odwróconych.
Kodowanie predyktora jakościowego
Bycie w związku wprowadzamy jako zmienną zero-jedynkową: 0 = nie (131 osób), 1 = tak (109 osób, 45.4%). Współczynnik takiej zmiennej to różnica średnich między grupami przy stałych pozostałych predyktorach. Predyktor o trzech lub więcej kategoriach wymaga kilku zmiennych zero-jedynkowych z jedną kategorią odniesienia – zob. dummy coding. W R wystarczy zmienna typu factor; w SPSS trzeba ją utworzyć samodzielnie.
Statystyki opisowe i korelacje
Zacznij od tabeli średnich, odchyleń standardowych i korelacji Pearsona – taka tabela zwykle otwiera część z wynikami.
| Zmienna | M | SD | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|---|
| 1. Satysfakcja z życia | 21.56 | 5.63 | — | |||
| 2. Stres | 21.27 | 6.92 | −.47 | — | ||
| 3. Wsparcie społeczne | 5.31 | 0.98 | .45 | −.28 | — | |
| 4. Samoocena | 27.93 | 4.78 | .50 | −.55 | .44 | — |
| 5. Bycie w związku (0/1) | — | — | .28 | −.01 | .18 | .08 |
Przy N = 240 istotne (p < .05) są korelacje o wartości bezwzględnej co najmniej .13, czyli wszystkie z wyjątkiem korelacji bycia w związku ze stresem (p = .910) i z samooceną (p = .231). Korelacje z udziałem zmiennej zero-jedynkowej to korelacje punktowo-dwuseryjne. Najsilniej powiązane predyktory to stres i samoocena (r = −.55) – to pierwszy sygnał, że ich związki z satysfakcją częściowo się pokrywają i że w modelu wielorakim ich współczynniki będą mniejsze niż w regresjach prostych.
Krok 3. Dopasuj model i sprawdź założenia
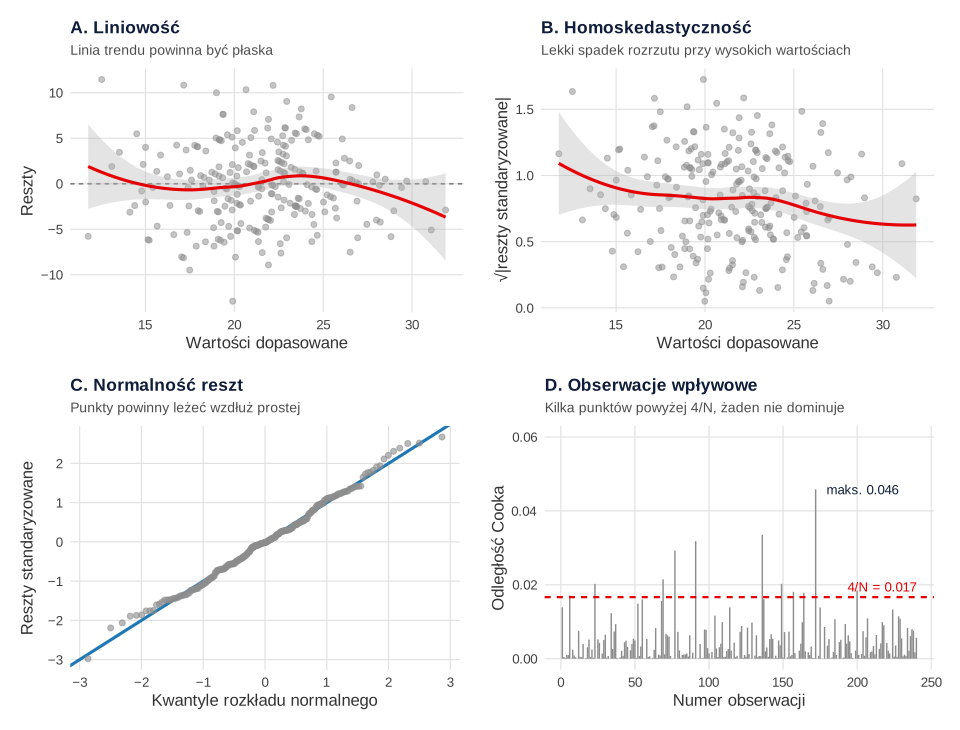
Współczynniki regresji szacuje metoda najmniejszych kwadratów, a wartości p i przedziały ufności są wiarygodne wtedy, gdy spełnione są założenia dotyczące reszt modelu. Dlatego najpierw dopasuj pełny model, obejrzyj reszty, a dopiero potem interpretuj wyniki. W praktyce ten krok często się pomija: Ernst i Albers (2017) w przeglądzie 12 czasopism psychologii klinicznej ustalili, że 92% artykułów stosujących regresję liniową nie raportowało jasno sprawdzania założeń, a w 4% artykułów za założenie błędnie uznano normalność samych zmiennych. Rysunek 1 przedstawia cztery podstawowe wykresy diagnostyczne dla naszego modelu.
Liniowość
Na panelu A reszty powinny układać się losowo wokół zera, a linia trendu – być płaska. Tak jest w środkowym zakresie; linia odchyla się tylko na krańcach, gdzie punktów jest niewiele. Opadanie linii przy najwyższych wartościach przewidywanych to efekt górnej granicy skali: nikt nie może mieć więcej niż 35 punktów, więc osoby z przewidywanym wynikiem bliskim 32 nie mogą mieć dużych dodatnich reszt. Liniowość osobno dla każdego predyktora pokazują wykresy zmiennej dodanej w kroku 5 – wszystkie trzy zależności są wyraźnie liniowe.
Niezależność obserwacji
Tego założenia nie sprawdza się wykresem, tylko planem badania: każda osoba wypełniła ankietę raz i nie tworzyła grup z innymi uczestnikami. Gdyby dane pochodziły np. od studentów z kilkunastu grup ćwiczeniowych albo z wielokrotnych pomiarów tych samych osób, potrzebny byłby model wielopoziomowy. Test Durbina–Watsona ma sens tylko wtedy, gdy kolejność obserwacji coś znaczy (np. w szeregach czasowych).
Homoskedastyczność
Homoskedastyczność oznacza, że rozrzut reszt jest podobny przy wszystkich wartościach przewidywanych. Na panelu B widać lekki spadek rozrzutu przy najwyższych wartościach: średnia wartość bezwzględna reszt standaryzowanych wynosiła 0.67 w najwyższej ćwiartce wartości przewidywanych wobec 0.80–0.89 w pozostałych. Test heteroskedastyczności z pakietu performance był istotny, p = .036. Przyczyną jest najpewniej ten sam efekt sufitu co przy liniowości.
Co z tym zrobić? Przy heteroskedastyczności współczynniki MNK pozostają nieobciążone, ale ich błędy standardowe mogą być obciążone, a testy – zbyt liberalne lub zbyt konserwatywne. Hayes i Cai (2007) zalecają wręcz rutynowe stosowanie w regresji MNK błędów standardowych odpornych na heteroskedastyczność (np. HC3) i udostępniają makra do SPSS. W naszym modelu zmiana jest niewielka: błąd standardowy współczynnika stresu wzrósł z 0.049 do 0.051, a wsparcia zmalał z 0.32 do 0.31; wszystkie predyktory pozostały istotne na poziomie p < .001. Raportujemy więc zwykły model z adnotacją o sprawdzeniu HC3.
Normalność reszt
Reszty na wykresie kwantylowym (panel C) układają się wzdłuż prostej, a test normalności reszt był nieistotny, p = .514. Pamiętaj, że założenie dotyczy reszt, a nie samych zmiennych: Williams i in. (2013) przypominają, że regresja wymaga – zwłaszcza w małych próbach – normalności błędów, a nie zmiennej zależnej czy predyktorów. W dużych próbach nawet wyraźnie nienormalne reszty zwykle nie podważają wniosków o współczynnikach (Lumley i in., 2002). Więcej o ocenie rozkładu piszemy w poradniku jak sprawdzić normalność rozkładu.
Współliniowość
Współliniowość to silne powiązanie predyktorów między sobą. Zawyża ona wariancje współczynników, przez co wartości p i przedziały ufności stają się niewiarygodne; Kim (2019) jako sygnał problemu podaje VIF powyżej 5–10. W przykładzie VIF wynosił od 1.04 (związek) do 1.65 (samoocena), więc współliniowość nie stanowi problemu – mimo korelacji stresu z samooceną na poziomie −.55.
Obserwacje wpływowe
Ostatni panel pokazuje odległość Cooka – miarę, którą Cook (1977) zaproponował do oceny wpływu każdej obserwacji na oszacowania najmniejszych kwadratów; łączy ona wielkość reszty z dźwignią obserwacji. Największa wartość wynosiła 0.046 – daleko od zwyczajowo przyjmowanych progów 0.5 i 1. Liberalny próg 4/N = 0.017 przekroczyło 11 osób. Nie usuwaj ich automatycznie – sprawdź, czy wpływają na wnioski. Po ich wykluczeniu współczynniki zmieniły się nieznacznie: stres −0.25 zamiast −0.23, związek 2.49 zamiast 2.46, wsparcie 1.30 bez zmian, samoocena 0.23 zamiast 0.27. Żadna obserwacja odstająca nie zmienia więc obrazu wyników. Jak postępować, gdy wpływ jest duży, opisujemy w poradniku wartości odstające: jak je wykryć i co z nimi zrobić.
| Założenie | Jak sprawdzono | Wynik w przykładzie | Co zrobić, gdy nie jest spełnione |
|---|---|---|---|
| Liniowość | Reszty a wartości dopasowane; wykresy zmiennej dodanej | Spełnione (odchylenie tylko przy suficie skali) | Dodać składnik kwadratowy (regresja krzywoliniowa) lub przekształcić zmienną |
| Niezależność | Plan badania | Spełnione (jeden pomiar na osobę) | Model wielopoziomowy, modele dla pomiarów powtarzanych |
| Homoskedastyczność | Wykres skali i położenia; test heteroskedastyczności | Lekki spadek rozrzutu, p = .036; HC3 bez zmiany wniosków | Błędy standardowe HC3 |
| Normalność reszt | Wykres Q-Q reszt; test normalności | Spełnione, p = .514 | W dużej próbie zwykle niegroźna; w małej – bootstrap |
| Współliniowość | VIF | VIF ≤ 1.65 | Połączyć lub usunąć nadmiarowe predyktory |
| Obserwacje wpływowe | Odległość Cooka, analiza wrażliwości | Maks. 0.046; wyniki bez 11 osób podobne | Sprawdzić dane; raportować wyniki z obserwacjami i bez nich |
Krok 4. Odpowiedz na pytanie badawcze: R², skorygowane R² i ΔR²
Skoro założenia są spełnione w wystarczającym stopniu, możesz przejść do wyników. Zacznij od poziomu całego modelu. Współczynnik determinacji R² mówi, jaki odsetek wariancji zmiennej zależnej wyjaśniają wszystkie predyktory razem, a test F – czy model wyjaśnia więcej niż sama średnia. Ponieważ R² rośnie po dodaniu każdego predyktora, obok niego podaje się R² skorygowane.
- Krok 1 (stres i bycie w związku): R² = .30, F(2, 237) = 51.09, p < .001.
- Krok 2 (+ wsparcie społeczne i samoocena): R² = .41, skorygowane R² = .40, F(4, 235) = 41.03, p < .001.
- Zmiana: ΔR² = .11, F(2, 235) = 21.94, p < .001.
To jest odpowiedź na pytanie badawcze: wsparcie i samoocena wyjaśniają dodatkowe 11% wariancji satysfakcji ponad stres i bycie w związku. Jako wielkość efektu przyrostu podaje się f² = ΔR² / (1 − R²) – tutaj 0.19. Cohen (1992) uznaje f² = 0.02, 0.15 i 0.35 za umowne progi małego, średniego i dużego efektu w regresji wielokrotnej, więc to efekt średni. Pamiętaj, że ΔR² zależy od kolejności bloków – dlatego tę kolejność ustala się przed analizą (przykład z odwróconą kolejnością bloków pokazujemy w haśle o regresji hierarchicznej).
Krok 5. Zinterpretuj współczynniki: b, β i sr²
Teraz poziom pojedynczych predyktorów. Tabela zawiera wszystkie wielkości, które warto znać, a niżej wyjaśniamy, jak je czytać.
| Predyktor | b | SE | 95% CI dla b | β | sr² | t(235) | p |
|---|---|---|---|---|---|---|---|
| Stała | 10.84 | 2.90 | [5.13, 16.54] | — | — | 3.74 | < .001 |
| Stres | −0.23 | 0.05 | [−0.33, −0.13] | −0.28 | .05 | −4.66 | < .001 |
| Bycie w związku (tak) | 2.46 | 0.58 | [1.33, 3.59] | 0.44 | .05 | 4.28 | < .001 |
| Wsparcie społeczne | 1.30 | 0.32 | [0.66, 1.94] | 0.23 | .04 | 4.01 | < .001 |
| Samoocena | 0.27 | 0.08 | [0.12, 0.42] | 0.23 | .03 | 3.57 | < .001 |
Współczynnik b – w jednostkach skali, „przy kontroli pozostałych”
b to przewidywana różnica w satysfakcji między osobami, które różnią się o jednostkę danego predyktora, a mają takie same wartości pozostałych predyktorów:
- Stres, b = −0.23: przy tym samym wsparciu, samoocenie i statusie związku każdy dodatkowy punkt stresu wiąże się z satysfakcją niższą średnio o 0.23 punktu (10 punktów stresu – o 2.3 punktu).
- Wsparcie, b = 1.30: dwie osoby o przeciętnym stresie (21 punktów) i samoocenie (28 punktów), niebędące w związku, z których jedna ma wsparcie 4, a druga 6 punktów, mają przewidywaną satysfakcję 18.81 i 21.42 punktu.
- Samoocena, b = 0.27: każdy punkt samooceny wiąże się z satysfakcją wyższą o 0.27 punktu przy stałych pozostałych zmiennych.
- Bycie w związku, b = 2.46: osoby w związku mają przewidywaną satysfakcję wyższą średnio o 2.46 punktu niż osoby niebędące w związku o takim samym stresie, wsparciu i samoocenie. Bez kontroli pozostałych zmiennych różnica średnich wynosiła 3.15 punktu (23.28 wobec 20.13).
- Stała, b0 = 10.84: przewidywany wynik osoby niebędącej w związku, z zerowym stresem, wsparciem i samooceną – wartość bez interpretacji, bo wsparcie i samoocena nie mogą wynosić zero. Gdy stała ma coś znaczyć, wycentruj predyktory.
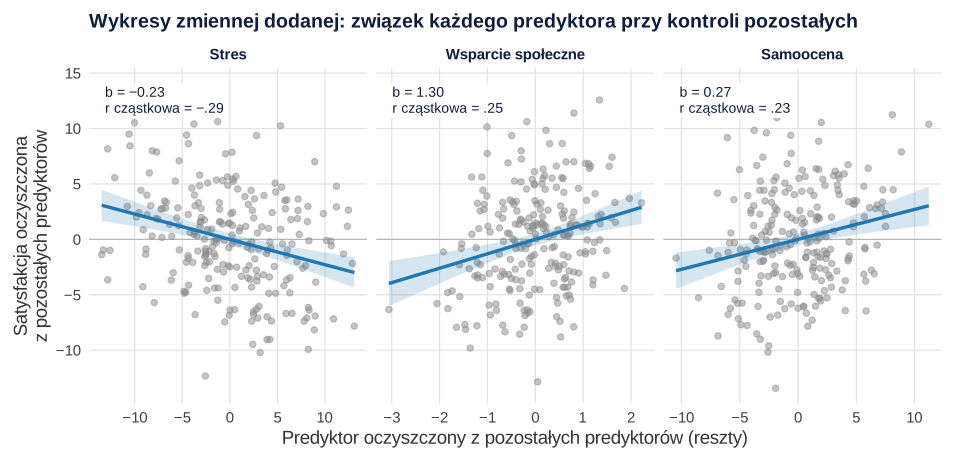
Warto porównać te liczby z krokiem 1. Bez wsparcia i samooceny współczynnik stresu wynosił −0.38, a po ich dodaniu zmalał o 40%, do −0.23. Część związku stresu z satysfakcją pokrywa się więc ze związkiem samooceny i wsparcia z satysfakcją. Wykresy zmiennej dodanej (rysunek 2) pokazują, co dokładnie znaczy „przy kontroli pozostałych”: na osi poziomej jest ta część predyktora, której nie da się przewidzieć z pozostałych zmiennych, a na pionowej – ta część satysfakcji, której nie wyjaśniają pozostałe zmienne. Nachylenie prostej to dokładnie współczynnik b z modelu.
Współczynnik β – w odchyleniach standardowych
Predyktory mierzono na różnych skalach, więc b stresu (−0.23 na punkt skali 0–40) i b wsparcia (1.30 na punkt skali 1–7) nie dają się porównać wprost. Służą do tego współczynniki standaryzowane β, czyli współczynniki z modelu, w którym zmienne ilościowe poddano standaryzacji. β = −0.28 dla stresu oznacza, że wynik wyższy o jedno odchylenie standardowe stresu wiąże się z satysfakcją niższą o 0.28 odchylenia standardowego przy stałych pozostałych zmiennych. Dla zmiennej zero-jedynkowej zwykłe β nie ma jasnej interpretacji, dlatego podajemy różnicę między grupami w odchyleniach standardowych satysfakcji: 0.44 SD.
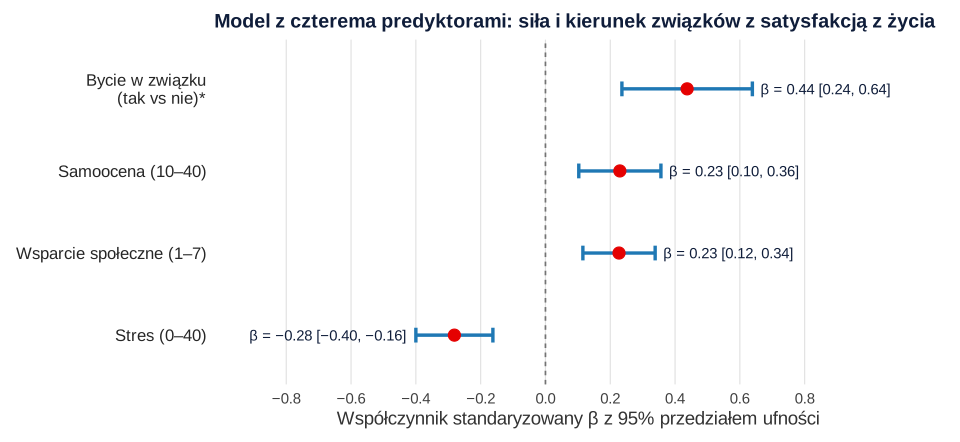
Kusi, by na tej podstawie ustalić ranking „ważności”. Zrób to ostrożnie: przedziały ufności β stresu, wsparcia i samooceny w dużej mierze się pokrywają, więc dane nie pozwalają stwierdzić, że któryś z tych predyktorów jest wyraźnie silniejszy. Nathans i in. (2012) przestrzegają przed opieraniem interpretacji wyłącznie na wagach β, które przy skorelowanych predyktorach dają ograniczony obraz, i zalecają zestawianie kilku uzupełniających się miar – na przykład β i sr².
sr² – unikalny wkład predyktora
Kwadrat korelacji semicząstkowej (sr²) mówi, jaką część wariancji satysfakcji wyjaśnia wyłącznie dany predyktor – o tyle zmalałoby R², gdyby go usunąć z modelu. W przykładzie sr² wynosi .054 dla stresu, .046 dla bycia w związku, .040 dla wsparcia i .032 dla samooceny. Ich suma (.172) jest znacznie mniejsza niż R² = .411. Pozostałe .239 to wariancja wspólna, której nie da się przypisać żadnemu predyktorowi z osobna, bo predyktory są ze sobą skorelowane. Rysunek 4 zestawia ten podział z krokami regresji hierarchicznej.
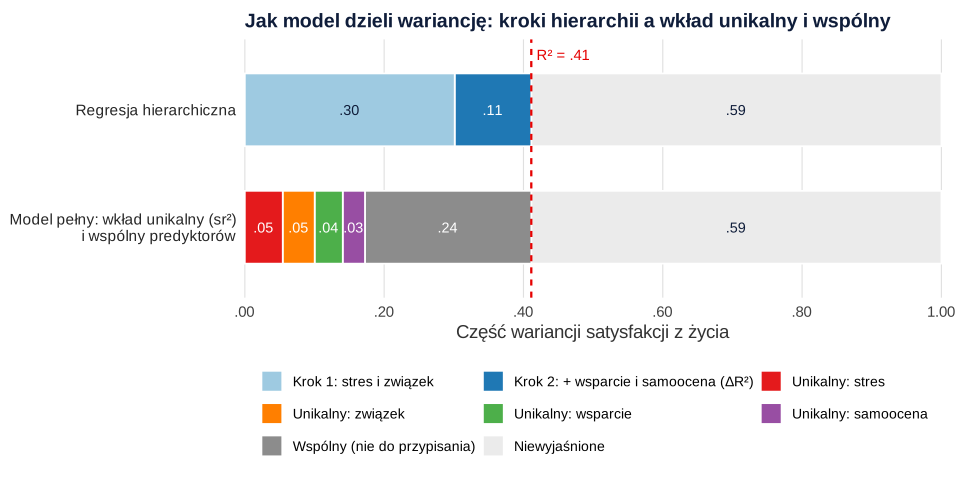
Wniosek praktyczny: nie opisuj wyników jako „procentu wpływu” poszczególnych zmiennych. Uczciwy opis brzmi: cztery predyktory razem wyjaśniają 41% wariancji, każdy wnosi istotny unikalny wkład (od 3% do 5%), a znaczna część wyjaśnionej wariancji jest wspólna.
Krok 6. Opisz wyniki w stylu APA
W części o metodzie opisz model, kolejność bloków i sposób sprawdzenia założeń. Standardy raportowania badań ilościowych APA (Appelbaum i in., 2018) zalecają m.in. rozróżnianie hipotez i analiz pierwszorzędowych, drugorzędowych i eksploracyjnych – zaznacz więc, że regresja testowała zaplanowaną hipotezę. W wynikach podaj R² i test F dla każdego kroku, ΔR², a dla predyktorów b z 95% CI, β i p. Wzór opisu dla przykładu:
Wyniki obu kroków zbierz w tabeli. Wzór poniżej; inne warianty znajdziesz w haśle tabela regresji w APA, a ogólne zasady zapisu statystyk – w poradniku jak opisać wyniki w stylu APA.
Tabela 1
Hierarchiczna regresja liniowa satysfakcji z życia na stres, bycie w związku, wsparcie społeczne i samoocenę
| Krok i predyktor | b | SE | 95% CI dla b | β | p | |
|---|---|---|---|---|---|---|
| LL | UL | |||||
| Krok 1 | ||||||
| Stała | 28.32 | 1.03 | 26.29 | 30.34 | < .001 | |
| Stres | −0.38 | 0.04 | −0.47 | −0.30 | −0.47 | < .001 |
| Bycie w związku (tak) | 3.12 | 0.61 | 1.91 | 4.32 | 0.55 | < .001 |
| Krok 2 | ||||||
| Stała | 10.84 | 2.90 | 5.13 | 16.54 | < .001 | |
| Stres | −0.23 | 0.05 | −0.33 | −0.13 | −0.28 | < .001 |
| Bycie w związku (tak) | 2.46 | 0.58 | 1.33 | 3.59 | 0.44 | < .001 |
| Wsparcie społeczne | 1.30 | 0.32 | 0.66 | 1.94 | 0.23 | < .001 |
| Samoocena | 0.27 | 0.08 | 0.12 | 0.42 | 0.23 | < .001 |
Uwaga. N = 240. β obliczono po standaryzacji satysfakcji i predyktorów ilościowych; dla bycia w związku β to różnica w odchyleniach standardowych satysfakcji między osobami w związku a pozostałymi. Krok 1: R² = .30, F(2, 237) = 51.09, p < .001. Krok 2: R² = .41, skorygowane R² = .40, ΔR² = .11, F(2, 235) = 21.94, p < .001. LL i UL – dolna i górna granica przedziału ufności. Dane symulowane.
Regresja wieloraka w SPSS: ścieżka w menu
Ten sam model policzysz w programie IBM SPSS Statistics. Nazwy opcji podajemy w polskiej i angielskiej wersji programu.
- Zakoduj zmienną jakościową. Przekształcenia → Rekoduj na inne zmienne (Transform → Recode into Different Variables): utwórz zmienną
zwiazeko wartościach 0 = nie, 1 = tak. - Otwórz okno regresji. Analiza → Regresja → Liniowa (Analyze → Regression → Linear). Zmienna zależna: satysfakcja.
- Wprowadź bloki. Blok 1: stres i związek; kliknij Następny (Next); blok 2: wsparcie i samoocena. Metoda: Wprowadzania (Enter) – zob. metoda wprowadzania.
- Statystyki (Statistics): zaznacz oszacowania, przedziały ufności (95%), dopasowanie modelu, zmianę R kwadrat (R squared change), statystyki opisowe, korelacje cząstkowe i semicząstkowe (Part and partial correlations) oraz diagnostykę współliniowości (Collinearity diagnostics).
- Wykresy (Plots): na osi Y ustaw *ZRESID, na osi X *ZPRED; zaznacz histogram i wykres normalności reszt (Normal probability plot).
- Zapisz (Save): odległości Cooka (Cook’s), wartości wpływu (Leverage values) i reszty standaryzowane – posłużą do analizy obserwacji wpływowych.
W wynikach odczytaj tabelę Podsumowanie modelu (Model Summary: R², skorygowane R², zmiana R² i F zmiany dla każdego kroku), tabelę ANOVA (test F modelu) i tabelę Współczynniki (Coefficients): kolumna B to b, Beta – β, a kolumna korelacji semicząstkowej (Part) zawiera sr – jej kwadrat to sr². Tam też znajdziesz tolerancję i VIF. Odporne błędy standardowe policzysz makrami udostępnionymi przez Hayesa i Cai (2007).
Przykład w R
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R – przepisy 2 i 3 korzystają z obiektów utworzonych w przepisie 1. Rysunki na stronie przedstawiają te same modele narysowane w pakiecie ggplot2.
1. Dane, braki i statystyki opisowe
R
library(car)          # vif()
library(performance)  # check_model(), check_normality(), check_heteroscedasticity()
library(effectsize)   # standardize_parameters(), r2_semipartial()
library(lmtest)       # coeftest()
library(sandwich)     # vcovHC() – odporne błędy standardowe

# Dane symulowane: 246 studentów – satysfakcja z życia (5–35), stres (0–40),
# wsparcie społeczne (1–7), samoocena (10–40) i bycie w związku (nie/tak)
set.seed(2026)
n <- 246
z_wsp <- rnorm(n)
z_str <- -0.30 * z_wsp + sqrt(1 - 0.09) * rnorm(n)
z_sam <- 0.30 * z_wsp - 0.40 * z_str + sqrt(1 - 0.30^2 - 0.40^2 - 0.1) * rnorm(n)
zwiazek <- rbinom(n, 1, plogis(-0.2 + 0.35 * z_wsp))
stres <- pmin(pmax(round(21 + 6.5 * z_str), 0), 40)
wsparcie <- pmin(pmax(round((5.3 + 1.05 * z_wsp) * 12) / 12, 1), 7)
samoocena <- pmin(pmax(round(28 + 5 * z_sam), 10), 40)
satysfakcja <- 21 - 0.20 * (stres - 21) + 1.30 * (wsparcie - 5.3) +
  0.33 * (samoocena - 28) + 1.6 * zwiazek + rnorm(n, sd = 4.6)
satysfakcja <- pmin(pmax(round(satysfakcja), 5), 35)
dane <- data.frame(satysfakcja, stres, wsparcie, samoocena,
                   zwiazek = factor(zwiazek, levels = 0:1, labels = c("nie", "tak")))
dane$samoocena[sample(n, 6)] <- NA   # 6 osób nie wypełniło skali samooceny

# Krok 2: przygotowanie danych – braki, zakresy, statystyki opisowe, korelacje
colSums(is.na(dane))
dane <- na.omit(dane)                # analiza kompletnych obserwacji
nrow(dane)
sapply(dane[1:4], range)
round(sapply(dane[1:4], function(x) c(M = mean(x), SD = sd(x))), 2)
table(dane$zwiazek)
aggregate(satysfakcja ~ zwiazek, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
round(cor(data.matrix(dane)), 2)     # zwiazek: korelacja punktowo-dwuseryjna

# Wartości p korelacji i najmniejsza istotna |r| przy N = 240
dm <- data.matrix(dane)
p_kor <- outer(1:5, 1:5, Vectorize(function(i, j) cor.test(dm[, i], dm[, j])$p.value))
dimnames(p_kor) <- list(names(dane), names(dane))
round(p_kor, 3)
round(qt(.975, 238) / sqrt(238 + qt(.975, 238)^2), 3)
Wynik w R
Loading required package: carData
Loading required package: zoo

Attaching package: ‘zoo’

The following objects are masked from ‘package:base’:

    as.Date, as.Date.numeric

satysfakcja       stres    wsparcie   samoocena     zwiazek
          0           0           0           6           0
[1] 240
     satysfakcja stres wsparcie samoocena
[1,]           6     3 2.666667        16
[2,]          35    40 7.000000        40
   satysfakcja stres wsparcie samoocena
M        21.56 21.27     5.31     27.93
SD        5.63  6.92     0.98      4.78

nie tak
131 109
  zwiazek satysfakcja.M satysfakcja.SD
1     nie         20.13           5.67
2     tak         23.28           5.10
            satysfakcja stres wsparcie samoocena zwiazek
satysfakcja        1.00 -0.47     0.45      0.50    0.28
stres             -0.47  1.00    -0.28     -0.55   -0.01
wsparcie           0.45 -0.28     1.00      0.44    0.18
samoocena          0.50 -0.55     0.44      1.00    0.08
zwiazek            0.28 -0.01     0.18      0.08    1.00
            satysfakcja stres wsparcie samoocena zwiazek
satysfakcja           0  0.00    0.000     0.000   0.000
stres                 0  0.00    0.000     0.000   0.910
wsparcie              0  0.00    0.000     0.000   0.004
samoocena             0  0.00    0.000     0.000   0.231
zwiazek               0  0.91    0.004     0.231   0.000
[1] 0.127
2. Model w dwóch krokach, ΔR², β i sr²
R
# Krok 1 hierarchii: stres i bycie w związku; krok 2: + zasoby (wsparcie, samoocena)
m1 <- lm(satysfakcja ~ stres + zwiazek, data = dane)
m2 <- update(m1, . ~ . + wsparcie + samoocena)
summary(m1)
summary(m2)
round(confint(m2), 2)

# Zmiana R² między krokami i jej test F
anova(m1, m2)
r2 <- c(krok1 = summary(m1)$r.squared, krok2 = summary(m2)$r.squared)
round(c(r2, delta_R2 = unname(r2[2] - r2[1]),
        f2 = unname((r2[2] - r2[1]) / (1 - r2[2]))), 3)

# Współczynniki standaryzowane (β) w obu krokach i unikalny wkład predyktorów (sr²)
standardize_parameters(m1)
standardize_parameters(m2)
r2_semipartial(m2, alternative = "two.sided")

# Przewidywany wynik dwóch osób różniących się tylko wsparciem (4 i 6 punktów)
nowe <- data.frame(stres = 21, zwiazek = "nie", wsparcie = c(4, 6), samoocena = 28)
round(predict(m2, nowe, interval = "confidence"), 2)
Wynik w R
Call:
lm(formula = satysfakcja ~ stres + zwiazek, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-13.6341  -3.2223   0.1345   2.9040  11.2865

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 28.31657    1.02768  27.554  < 2e-16 ***
stres       -0.38412    0.04416  -8.699 5.69e-16 ***
zwiazektak   3.11546    0.61269   5.085 7.47e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 4.726 on 237 degrees of freedom
Multiple R-squared:  0.3013,	Adjusted R-squared:  0.2954
F-statistic: 51.09 on 2 and 237 DF,  p-value: < 2.2e-16


Call:
lm(formula = satysfakcja ~ stres + zwiazek + wsparcie + samoocena,
    data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-12.9108  -2.9646  -0.0747   2.5208  11.4603

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 10.83532    2.89760   3.739 0.000232 ***
stres       -0.22859    0.04906  -4.659 5.32e-06 ***
zwiazektak   2.46156    0.57529   4.279 2.74e-05 ***
wsparcie     1.30191    0.32463   4.010 8.15e-05 ***
samoocena    0.27035    0.07577   3.568 0.000436 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 4.356 on 235 degrees of freedom
Multiple R-squared:  0.4112,	Adjusted R-squared:  0.4012
F-statistic: 41.03 on 4 and 235 DF,  p-value: < 2.2e-16

            2.5 % 97.5 %
(Intercept)  5.13  16.54
stres       -0.33  -0.13
zwiazektak   1.33   3.59
wsparcie     0.66   1.94
samoocena    0.12   0.42
Analysis of Variance Table

Model 1: satysfakcja ~ stres + zwiazek
Model 2: satysfakcja ~ stres + zwiazek + wsparcie + samoocena
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    237 5292.9
2    235 4460.0  2    832.91 21.943 1.831e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   krok1    krok2 delta_R2       f2
   0.301    0.411    0.110    0.187
# Standardization method: refit

Parameter     | Std. Coef. |         95% CI
-------------------------------------------
(Intercept)   |      -0.25 | [-0.40, -0.11]
stres         |      -0.47 | [-0.58, -0.37]
zwiazek [tak] |       0.55 | [ 0.34,  0.77]
# Standardization method: refit

Parameter     | Std. Coef. |         95% CI
-------------------------------------------
(Intercept)   |      -0.20 | [-0.33, -0.06]
stres         |      -0.28 | [-0.40, -0.16]
zwiazek [tak] |       0.44 | [ 0.24,  0.64]
wsparcie      |       0.23 | [ 0.12,  0.34]
samoocena     |       0.23 | [ 0.10,  0.36]
Term      |  sr2 |       95% CI
-------------------------------
stres     | 0.05 | [0.01, 0.10]
zwiazek   | 0.05 | [0.00, 0.09]
wsparcie  | 0.04 | [0.00, 0.08]
samoocena | 0.03 | [0.00, 0.07]
    fit   lwr   upr
1 18.81 17.74 19.88
2 21.42 20.50 22.33
3. Diagnostyka, analiza wrażliwości i błędy standardowe HC3
R
# Krok 3: diagnostyka modelu m2 – wykresy reszt i wartości p testów założeń
check_model(m2, check = c("linearity", "homogeneity", "qq", "outliers"))
round(c(normalnosc_reszt = as.numeric(check_normality(m2)),
        heteroskedastycznosc = as.numeric(check_heteroscedasticity(m2))), 3)

# Rozrzut reszt w ćwiartkach wartości przewidywanych (średnia |reszta standaryzowana|)
cwiartka <- cut(fitted(m2), quantile(fitted(m2), 0:4 / 4), include.lowest = TRUE)
round(tapply(abs(rstandard(m2)), cwiartka, mean), 2)

# Współliniowość: VIF każdego predyktora
vif(m2)

# Obserwacje wpływowe: odległość Cooka
cook <- cooks.distance(m2)
round(max(cook), 3)
sum(cook > 4 / nrow(dane))          # liberalny próg 4/N

# Analiza wrażliwości: model bez obserwacji o odległości Cooka > 4/N
round(coef(update(m2, subset = cook <= 4 / nrow(dane))), 2)

# Odporne błędy standardowe HC3 (sprawdzenie przy podejrzeniu heteroskedastyczności)
coeftest(m2, vcov. = vcovHC(m2, type = "HC3"))
Wynik w R
    normalnosc_reszt heteroskedastycznosc
               0.514                0.036
[11.8,19.3] (19.3,21.6] (21.6,23.7] (23.7,31.9]
       0.89        0.81        0.80        0.67
    stres   zwiazek  wsparcie samoocena
 1.452991  1.037506  1.279109  1.652540
[1] 0.046
[1] 11
(Intercept)       stres  zwiazektak    wsparcie   samoocena
      12.24       -0.25        2.49        1.30        0.23

t test of coefficients:

             Estimate Std. Error t value  Pr(>|t|)
(Intercept) 10.835322   2.921474  3.7089 0.0002598 ***
stres       -0.228589   0.051053 -4.4775 1.178e-05 ***
zwiazektak   2.461563   0.573886  4.2893 2.619e-05 ***
wsparcie     1.301911   0.306308  4.2503 3.080e-05 ***
samoocena    0.270354   0.077260  3.4993 0.0005580 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork (panel diagnostyczny check_model() rysuje pakiet see). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- see (wersja 0.13.0): Lüdecke, D., Patil, I., Ben-Shachar, M. S., Wiernik, B. M., Waggoner, P., & Makowski, D. (2021). see: An R package for visualizing statistical models. Journal of Open Source Software, 6(64), 3393. https://doi.org/10.21105/joss.03393
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w regresji wielorakiej
- Sprawdzanie normalności zmiennych zamiast reszt. Skośny rozkład predyktora czy zmiennej zależnej sam w sobie nie narusza założeń regresji (Williams i in., 2013).
- Interpretowanie b bez dopisku „przy kontroli pozostałych”. Współczynnik stresu wynosił −0.38 w kroku 1 i −0.23 w kroku 2 – to dwie różne odpowiedzi na dwa różne pytania.
- Ranking predyktorów według β bez przedziałów ufności. β wsparcia i samooceny wynosiły po 0.23, a przedziały ufności wszystkich trzech predyktorów ilościowych w dużej mierze się pokrywały.
- Opisywanie wyników jako „procentu wpływu” zmiennych. Suma unikalnych wkładów (.17) to mniej niż połowa R² (.41); reszta jest wspólna i nie da się jej przypisać pojedynczej zmiennej.
- Dobór predyktorów metodą krokową. Algorytm wybiera zmienne według przypadkowych cech próby (Thompson, 1995). Predyktory i kolejność bloków ustal przed analizą.
- Automatyczne usuwanie obserwacji powyżej 4/N. Ten próg służy do wskazania przypadków wartych obejrzenia, a nie do ich wykluczania. Zamiast usuwać, przeprowadź analizę wrażliwości.
- Pomijanie heteroskedastyczności. Gdy wykres lub test ją sugerują, sprawdź wyniki z błędami standardowymi HC3 i napisz o tym jednym zdaniem.
- Zbyt wiele predyktorów w małej próbie. Każdy predyktor „zjada” stopień swobody i zawyża R². Przy dziesięciu predyktorach i 60 osobach przedziały ufności współczynników będą szerokie, testy – mało mocne, a R² – wyraźnie zawyżone (zob. R² skorygowane).
- Język przyczynowy w badaniu korelacyjnym. „Wsparcie zwiększa satysfakcję” to interpretacja, której dane przekrojowe nie uzasadniają. Pisz: „wyższe wsparcie wiązało się z wyższą satysfakcją”.
- Regresja liniowa dla wyniku dwuwartościowego. Gdy zmienna zależna ma dwie kategorie (np. zdał/nie zdał), zastosuj regresję logistyczną. Gdy podejrzewasz, że związek predyktora z wynikiem zależy od trzeciej zmiennej, przeczytaj poradnik analiza moderacji krok po kroku.
Jeśli potrzebujesz pomocy w zaplanowaniu lub przeprowadzeniu takiej analizy w pracy dyplomowej, zajrzyj do oferty analiz statystycznych dla studentów.
Najczęstsze pytania
Jakie są założenia regresji wielorakiej?
Liniowość związków, niezależność obserwacji, stała wariancja reszt (homoskedastyczność), normalność reszt (ważna zwłaszcza w małych próbach), brak silnej współliniowości predyktorów i brak obserwacji nadmiernie wpływowych. Założenia dotyczą reszt modelu, a nie surowych zmiennych; sprawdza się je na wykresach reszt, za pomocą VIF i odległości Cooka.
Jak interpretować współczynnik b w regresji wielorakiej?
b to przewidywana różnica w zmiennej zależnej między osobami, które różnią się o jednostkę danego predyktora, a mają takie same wartości pozostałych predyktorów. W przykładzie z tego poradnika b = −0.23 dla stresu oznacza, że przy tym samym wsparciu, samoocenie i statusie związku każdy punkt stresu wiąże się z satysfakcją niższą o 0.23 punktu.
Czym różni się b od β i które podać w pracy?
b jest wyrażone w jednostkach skali, a β – w odchyleniach standardowych, dzięki czemu pozwala porównać predyktory mierzone na różnych skalach. W pracy podaj oba: b z 95% przedziałem ufności i β. Nie traktuj kolejności β jako rozstrzygającego rankingu „ważności” – sprawdź, czy przedziały ufności się nie pokrywają, i zestaw β z sr².
Ile osób potrzeba do regresji wielorakiej?
Najlepiej wyznaczyć to analizą mocy, np. w programie G*Power, na podstawie oczekiwanej wielkości efektu. Popularna reguła Greena (1991) mówi o co najmniej 50 + 8m osobach (m – liczba predyktorów) dla testu całego modelu i 104 + m dla pojedynczych predyktorów, ale zakłada efekt średniej wielkości.
Co zrobić, gdy założenia regresji nie są spełnione?
Zależy od założenia: przy heteroskedastyczności użyj błędów standardowych odpornych (HC3), przy nieliniowości dodaj składnik kwadratowy albo przekształć zmienną, przy danych zagnieżdżonych zastosuj model wielopoziomowy, a przy obserwacjach wpływowych przeprowadź analizę wrażliwości. Nienormalność reszt w dużej próbie zwykle nie jest groźna; w małej pomoże bootstrap.
Jak wprowadzić zmienną jakościową (np. płeć) do regresji?
Zmienną o dwóch kategoriach zakoduj jako 0 i 1 – jej współczynnik to różnica średnich między grupami przy stałych pozostałych predyktorach. Zmienną o k kategoriach zastąp k − 1 zmiennymi zero-jedynkowymi z jedną kategorią odniesienia (dummy coding). W R wystarczy zmienna typu factor.
Powiązane hasła
Przeczytaj też
Analiza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikRegresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Austin, P. C., & Steyerberg, E. W. (2015). The number of subjects per variable required in linear regression analyses. Journal of Clinical Epidemiology, 68(6), 627–636. https://doi.org/10.1016/j.jclinepi.2014.12.014 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- Faul, F., Erdfelder, E., Buchner, A., & Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149–1160. https://doi.org/10.3758/BRM.41.4.1149 ● Otwarty dostęp
- Green, S. B. (1991). How many subjects does it take to do a regression analysis. Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/bf03192961 ● Otwarty dostęp
- Kim, J. H. (2019). Multicollinearity and misleading statistical results. Korean Journal of Anesthesiology, 72(6), 558–569. https://doi.org/10.4097/kja.19087 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Nathans, L. L., Oswald, F. L., & Nimon, K. (2012). Interpreting multiple linear regression: A guidebook of variable importance. Practical Assessment, Research, and Evaluation, 17, Article 9. https://doi.org/10.7275/5fex-b874 ● Otwarty dostęp: pełny tekst
- Thompson, B. (1995). Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial. Educational and Psychological Measurement, 55(4), 525–534. https://doi.org/10.1177/0013164495055004001
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{austin2015number, author={Austin, Peter C. and Steyerberg, Ewout W.}, title={{The number of subjects per variable required in linear regression analyses}}, journal={Journal of Clinical Epidemiology}, year={2015}, volume={68}, number={6}, pages={627--636}, doi={10.1016/j.jclinepi.2014.12.014}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@article{faul2009statistical, author={Faul, Franz and Erdfelder, Edgar and Buchner, Axel and Lang, Albert-Georg}, title={{Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses}}, journal={Behavior Research Methods}, year={2009}, volume={41}, number={4}, pages={1149--1160}, doi={10.3758/brm.41.4.1149}}@article{green1991how, author={Green, Samuel B.}, title={{How many subjects does it take to do a regression analysis}}, journal={Multivariate Behavioral Research}, year={1991}, volume={26}, number={3}, pages={499--510}, doi={10.1207/s15327906mbr2603_7}}@article{hayes2007using, author={Hayes, Andrew F. and Cai, Li}, title={{Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={4}, pages={709--722}, doi={10.3758/bf03192961}}@article{kim2019multicollinearity, author={Kim, Jong Hae}, title={{Multicollinearity and misleading statistical results}}, journal={Korean Journal of Anesthesiology}, year={2019}, volume={72}, number={6}, pages={558--569}, doi={10.4097/kja.19087}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{nathans2012interpreting, author={Nathans, Laura L. and Oswald, Frederick L. and Nimon, Kim}, title={{Interpreting multiple linear regression: A guidebook of variable importance}}, journal={Practical Assessment, Research, and Evaluation}, year={2012}, volume={17}, eid={9}, doi={10.7275/5fex-b874}}@article{thompson1995stepwise, author={Thompson, Bruce}, title={{Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial}}, journal={Educational and Psychological Measurement}, year={1995}, volume={55}, number={4}, pages={525--534}, doi={10.1177/0013164495055004001}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}