Co to jest metoda wprowadzania?
Metoda wprowadzania (ang. enter method, także forced entry lub regresja jednoczesna – simultaneous regression) to sposób budowania modelu regresji wielorakiej, w którym badacz sam ustala zestaw predyktorów, a program wprowadza je do modelu wszystkie naraz, w jednym kroku. Nie ma tu żadnej automatycznej selekcji: zmienna zostaje w modelu niezależnie od tego, czy jej współczynnik okaże się istotny. Dokumentacja SPSS opisuje tę metodę (Enter) jako procedurę, w której wszystkie zmienne bloku są wprowadzane w jednym kroku (IBM, 2026). Jest to ustawienie domyślne w oknie regresji liniowej SPSS; w R odpowiada mu zwykłe wywołanie lm() z pełną listą predyktorów.
Metoda wprowadzania to punkt odniesienia dla metod automatycznych: metody krokowej, selekcji postępującej i eliminacji wstecznej, w których o obecności zmiennej decydują progi istotności. Jej lustrzanym odbiciem jest metoda usuwania (Remove) – wszystkie zmienne bloku są usuwane w jednym kroku.
Jak działa i jak czytać współczynniki
Po wprowadzeniu wszystkich predyktorów model szacuje się raz, metodą najmniejszych kwadratów. Każdy współczynnik b opisuje związek predyktora z wynikiem przy stałych wartościach wszystkich pozostałych predyktorów, a jego test t sprawdza unikalny wkład tej zmiennej. Dlatego wynik zależy od tego, jakie zmienne wpisałeś do modelu: dodanie lub pominięcie zmiennej skorelowanej z innymi zmienia współczynniki pozostałych (zob. współliniowość i supresja). Zestaw predyktorów musi więc wynikać z pytania badawczego i teorii, a nie z danych.
Metodę wprowadzania można stosować w blokach. W SPSS każdy blok zmiennych dostaje własną metodę; gdy wszystkie bloki mają metodę Enter, powstaje regresja hierarchiczna. Kolejność bloków ustala badacz (np. najpierw zmienne demograficzne, potem psychologiczne), a zmiana R² między blokami mówi, ile wyjaśniają zmienne dodane w danym kroku. To nadal metoda wprowadzania – o kolejności decyduje teoria, a nie program.
| Metoda (SPSS) | Kto decyduje o zmiennych | Czy wartości p są poprawne |
|---|---|---|
| Wprowadzania (Enter) | Badacz – cały blok w jednym kroku | Tak (jeden, z góry ustalony model) |
| Usuwania (Remove) | Badacz – cały blok usuwany w jednym kroku | Tak, dla porównania dwóch ustalonych modeli |
| Krokowa (Stepwise) | Program – progi istotności wejścia i usunięcia | Na ogół nie |
| Selekcji postępującej (Forward) | Program – kolejne wejścia | Na ogół nie |
| Eliminacji wstecznej (Backward) | Program – kolejne usunięcia | Na ogół nie |
Ostatnia kolumna pochodzi wprost z dokumentacji SPSS: wartości istotności w wydruku zakładają dopasowanie jednego modelu, więc przy metodach krokowych są na ogół nieprawidłowe (IBM, 2026).
Przykład: satysfakcja z życia studentów
Badanie objęło 180 studentów (dane symulowane). Zmienną zależną była satysfakcja z życia (SWLS, 5–35), a predyktorami: wiek, płeć, wsparcie społeczne (1–7), poczucie własnej skuteczności (10–40) i prokrastynacja (1–5). Wszystkie pięć zmiennych zaplanowano przed zebraniem danych, więc wprowadzono je jednocześnie.
Tabela 1
Regresja satysfakcji z życia na pięć predyktorów (metoda wprowadzania)
| Predyktor | b | SE | 95% CI | β | p |
|---|---|---|---|---|---|
| Wiek | 0.24 | 0.17 | [−0.10, 0.58] | 0.09 | .167 |
| Płeć (kobieta) | 0.56 | 0.77 | [−0.96, 2.07] | – | .469 |
| Wsparcie społeczne | 1.72 | 0.43 | [0.88, 2.56] | 0.28 | < .001 |
| Poczucie własnej skuteczności | 0.32 | 0.09 | [0.15, 0.50] | 0.26 | < .001 |
| Prokrastynacja | −0.57 | 0.46 | [−1.48, 0.35] | −0.08 | .223 |
Uwaga. N = 180. R² = .23, skorygowane R² = .21, F(5, 174) = 10.25, p < .001. Płeć zakodowano 0 = mężczyzna, 1 = kobieta (β nie podano dla zmiennej zero-jedynkowej). CI = przedział ufności. Dane symulowane.
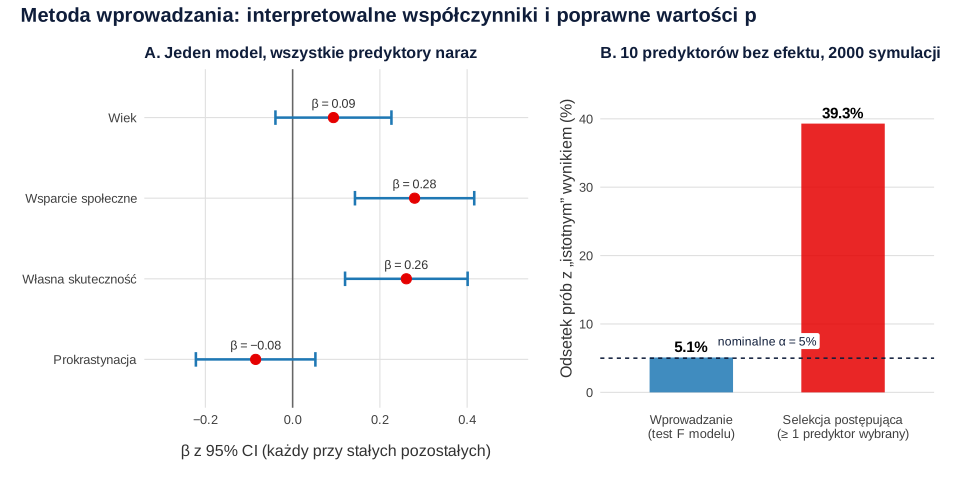
Model wyjaśnia 23% wariancji satysfakcji z życia. Przy kontroli pozostałych zmiennych istotne unikalne związki mają wsparcie społeczne i poczucie własnej skuteczności. Prokrastynacja zostaje w modelu, mimo że jej współczynnik jest nieistotny (p = .223) – był zaplanowany, a jego oszacowanie z przedziałem ufności też jest informacją: w tych danych unikalny związek prokrastynacji z satysfakcją, jeśli istnieje, jest mały (rysunek 1A).
Ta sama analiza w dwóch blokach (blok 1: wiek i płeć; blok 2: zmienne psychologiczne) pokazuje, że zmienne demograficzne wyjaśniają tylko 2.2% wariancji, a dodanie bloku psychologicznego zwiększa R² o .206, F(3, 174) = 15.43, p < .001. Model końcowy jest identyczny z modelem jednego kroku; bloki zmieniają tylko to, jakie pytanie dodatkowo zadajesz.
Dlaczego nie selekcja automatyczna
Metody krokowe kuszą, bo „same wybierają” predyktory. Thompson (1995) opisuje trzy ich problemy: programy liczą stopnie swobody tak, jakby model był ustalony z góry, procedura nie znajduje najlepszego zestawu zmiennych danej wielkości, a wynik wykorzystuje błąd losowy próby i słabo się replikuje. Smith (2018) dodaje, że selekcja krokowa może odrzucić prawdziwe predyktory i przyjąć przypadkowe, zwłaszcza gdy kandydatów jest dużo. Heinze i in. (2018) pokazują, że dobór zmiennych na podstawie danych narusza nieobciążoność współczynników oraz trafność wartości p i przedziałów ufności.
Prosta symulacja w kodzie poniżej pokazuje skalę problemu. Wylosowano 2000 zbiorów po 100 osób z 10 predyktorami, które w populacji nie mają żadnego związku z wynikiem. Test F modelu z metody wprowadzania dał wynik istotny w 5.1% prób – zgodnie z poziomem α = .05. Selekcja postępująca (wejście, gdy p < .05) wybrała co najmniej jeden „istotny” predyktor w 39.3% prób (rysunek 1B). Z punktu widzenia błędu I rodzaju to wynik prawie ośmiokrotnie gorszy.
Metoda wprowadzania nie rozwiązuje wszystkiego. Przy wielu predyktorach i małej próbie oszacowania są nieprecyzyjne, a R² jest zawyżone. Green (1991) zaleca planowanie liczebności na podstawie oczekiwanej wielkości efektu, a nie stałego stosunku liczby osób do liczby predyktorów – zob. dobór liczebności próby. Gdy celem jest czysta predykcja, a nie wyjaśnianie, lepsze od selekcji krokowej są metody z walidacją krzyżową i penalizacją (Heinze i in., 2018).
Jak opisać wynik w pracy (APA)
Napisz wprost, że wszystkie predyktory wprowadzono jednocześnie, i uzasadnij ich wybór w części o metodzie. Wzór dla przykładu:
Więcej wzorów tabel i opisów, wraz ze sprawdzaniem założeń na resztach i diagnostyką VIF, znajdziesz w poradniku regresja wieloraka krok po kroku.
Przykład w R i SPSS
Kod tworzy dane z przykładu, szacuje model metodą wprowadzania, liczy współczynniki standaryzowane, porównuje dwa bloki i wykonuje symulację z 10 predyktorami bez efektu. Liczby w tabeli, tekście i na rysunku 1 pochodzą z tego kodu.
Metoda wprowadzania, bloki i symulacja selekcji postępującej
R
# Dane symulowane: 180 studentów; zmienna zależna – satysfakcja z życia (SWLS, 5–35)
# predyktory: wiek, płeć (0 = mężczyzna, 1 = kobieta), wsparcie społeczne (1–7),
# poczucie własnej skuteczności (10–40), prokrastynacja (1–5)
set.seed(2251)
n <- 180
wiek <- round(runif(n, 19, 26))
kobieta <- rbinom(n, 1, 0.6)
wsparcie <- round(pmin(pmax(rnorm(n, 5.1, 1.0), 1), 7), 2)
skutecznosc <- round(pmin(pmax(rnorm(n, 29, 4.5) + 1.2 * (wsparcie - 5.1), 10), 40))
prokrastynacja <- round(pmin(pmax(rnorm(n, 3.0, 0.8) - 0.06 * (skutecznosc - 29), 1), 5), 2)
swls <- round(pmin(pmax(4 + 0.15 * wiek + 0.6 * kobieta + 1.9 * wsparcie + 0.32 * skutecznosc -
                         0.9 * prokrastynacja + rnorm(n, 0, 4.6), 5), 35))
dane <- data.frame(swls, wiek, kobieta, wsparcie, skutecznosc, prokrastynacja)

# 1. Metoda wprowadzania: wszystkie predyktory jednocześnie, w jednym kroku
m_all <- lm(swls ~ wiek + kobieta + wsparcie + skutecznosc + prokrastynacja, data = dane)
summary(m_all)
round(confint(m_all), 2)
round(coef(lm(scale(swls) ~ scale(wiek) + kobieta + scale(wsparcie) + scale(skutecznosc) + scale(prokrastynacja), data = dane))[-c(1, 3)], 2)  # beta dla zmiennych ilościowych

# 2. Metoda wprowadzania w blokach (regresja hierarchiczna): blok 1 – wiek i płeć, blok 2 – zmienne psychologiczne
m1 <- lm(swls ~ wiek + kobieta, data = dane)
round(c(R2_blok1 = summary(m1)$r.squared, R2_blok2 = summary(m_all)$r.squared,
        delta_R2 = summary(m_all)$r.squared - summary(m1)$r.squared), 3)
anova(m1, m_all)

# 3. Dlaczego nie selekcja automatyczna: 2000 symulacji, 10 predyktorów bez żadnego związku z wynikiem (N = 100)
set.seed(7)
wyn <- replicate(2000, {
  d <- as.data.frame(matrix(rnorm(100 * 11), 100)); names(d) <- c("y", paste0("x", 1:10))
  pel <- summary(lm(y ~ ., data = d))
  p_F <- pf(pel$fstatistic[1], pel$fstatistic[2], pel$fstatistic[3], lower.tail = FALSE)
  # selekcja postępująca jak w SPSS (wejście, gdy p < .05): wybór predyktora o najmniejszym p
  wybrane <- character(0)
  repeat {
    kand <- setdiff(paste0("x", 1:10), wybrane); if (!length(kand)) break
    p <- sapply(kand, function(v) { s <- summary(lm(reformulate(c(wybrane, v), "y"), data = d))$coefficients; s[v, 4] })
    if (min(p) < .05) wybrane <- c(wybrane, kand[which.min(p)]) else break
  }
  c(enter = unname(p_F < .05), forward = length(wybrane) > 0)
})
round(rowMeans(wyn), 3)   # odsetek prób z „istotnym” modelem, choć w populacji nie ma żadnego efektu
Wynik w R
Call:
lm(formula = swls ~ wiek + kobieta + wsparcie + skutecznosc +
    prokrastynacja, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-11.4822  -3.1136  -0.3412   3.2990  11.5463

Coefficients:
               Estimate Std. Error t value Pr(>|t|)
(Intercept)     1.26903    5.25212   0.242 0.809357
wiek            0.24101    0.17353   1.389 0.166653
kobieta         0.55783    0.76834   0.726 0.468805
wsparcie        1.71652    0.42525   4.036 8.12e-05 ***
skutecznosc     0.32398    0.08848   3.662 0.000332 ***
prokrastynacja -0.56722    0.46425  -1.222 0.223429
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 4.912 on 174 degrees of freedom
Multiple R-squared:  0.2276,	Adjusted R-squared:  0.2054
F-statistic: 10.25 on 5 and 174 DF,  p-value: 1.255e-08

               2.5 % 97.5 %
(Intercept)    -9.10  11.64
wiek           -0.10   0.58
kobieta        -0.96   2.07
wsparcie        0.88   2.56
skutecznosc     0.15   0.50
prokrastynacja -1.48   0.35
          scale(wiek)       scale(wsparcie)    scale(skutecznosc)
                 0.09                  0.28                  0.26
scale(prokrastynacja)
                -0.08
R2_blok1 R2_blok2 delta_R2
   0.022    0.228    0.206
Analysis of Variance Table

Model 1: swls ~ wiek + kobieta
Model 2: swls ~ wiek + kobieta + wsparcie + skutecznosc + prokrastynacja
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    177 5315.2
2    174 4198.1  3    1117.1 15.434 6.022e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  enter forward
  0.051   0.393
SPSS
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Usuwanie nieistotnych predyktorów i ponowne liczenie modelu. To ręczna eliminacja wsteczna – wartości p w modelu „oczyszczonym” tracą poprawność, a współczynniki zmieniają znaczenie.
- Brak uzasadnienia zestawu predyktorów. Przy metodzie wprowadzania to badacz odpowiada za listę zmiennych; napisz w metodzie, skąd się wzięła.
- Interpretowanie b jak korelacji prostej. Współczynnik opisuje unikalny związek przy stałych pozostałych predyktorach; może mieć inny znak niż korelacja zmiennej z wynikiem.
- Mylenie bloków z metodą krokową. Regresja hierarchiczna z blokami Enter to nadal decyzja badacza; „krokowa” oznacza wybór przez program.
- Za dużo predyktorów na małej próbie. Metoda wprowadzania nie chroni przed nieprecyzyjnymi oszacowaniami; zaplanuj liczebność i podawaj skorygowane R² (zob. R-kwadrat skorygowany).
- Pomijanie przedziałów ufności przy nieistotnych współczynnikach. Szeroki przedział mówi, że dane są zgodne z wieloma wartościami efektu – to inna informacja niż „brak związku”.
Najczęstsze pytania
Czym różni się metoda wprowadzania od metody krokowej?
W metodzie wprowadzania badacz ustala listę predyktorów i wszystkie wchodzą do modelu w jednym kroku. W metodzie krokowej program sam dodaje i usuwa zmienne według progów istotności, przez co wartości p w końcowym modelu są na ogół nieprawidłowe, a wybrany zestaw słabo się replikuje.
Czy w metodzie wprowadzania usuwa się nieistotne predyktory?
Nie. Zaplanowane zmienne zostają w modelu, a ich nieistotny współczynnik z przedziałem ufności raportujesz jako wynik. Usuwanie ich i ponowne liczenie modelu to ręczna selekcja, która zawyża istotność pozostałych efektów.
Czy regresja hierarchiczna to metoda wprowadzania?
Tak, jeśli każdy blok wprowadzasz metodą Enter. Kolejność bloków ustala badacz na podstawie teorii, a zmiana R² mówi, ile wariancji dodają zmienne z danego bloku. Model po ostatnim bloku jest taki sam jak model ze wszystkimi zmiennymi wprowadzonymi naraz.
Jak napisać w pracy, że użyto metody wprowadzania?
Wystarczy zdanie: „Wszystkie predyktory wprowadzono do modelu jednocześnie (metoda wprowadzania)”, a przy blokach – lista zmiennych w każdym bloku. W części o metodzie uzasadnij, dlaczego wybrano właśnie te predyktory.
Ile predyktorów można wprowadzić metodą Enter?
Tyle, ile uzasadnia pytanie badawcze i na ile pozwala liczebność próby. Stałe reguły typu „10 osób na predyktor” mają słabe uzasadnienie; lepiej zaplanować próbę analizą mocy dla oczekiwanej wielkości efektu (Green, 1991).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Green, S. B. (1991). How many subjects does it take to do a regression analysis. Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067 ● Otwarty dostęp
- IBM. (2026). Linear Regression variable selection methods (IBM SPSS Statistics 31.0.0). https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=regression-linear-variable-selection-methods ● Otwarty dostęp
- Smith, G. (2018). Step away from stepwise. Journal of Big Data, 5(1), Article 32. https://doi.org/10.1186/s40537-018-0143-6 ● Otwarty dostęp
- Thompson, B. (1995). Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial. Educational and Psychological Measurement, 55(4), 525–534. https://doi.org/10.1177/0013164495055004001
Cytowania BibTeX
@article{green1991how, author={Green, Samuel B.}, title={{How many subjects does it take to do a regression analysis}}, journal={Multivariate Behavioral Research}, year={1991}, volume={26}, number={3}, pages={499--510}, doi={10.1207/s15327906mbr2603_7}}@article{heinze2018variable, author={Heinze, Georg and Wallisch, Christine and Dunkler, Daniela}, title={{Variable selection – A review and recommendations for the practicing statistician}}, journal={Biometrical Journal}, year={2018}, volume={60}, number={3}, pages={431--449}, doi={10.1002/bimj.201700067}}@misc{ibm2026regresjametody, author={{IBM}}, title={{Linear Regression variable selection methods (IBM SPSS Statistics 31.0.0)}}, year={2026}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=regression-linear-variable-selection-methods}}@article{smith2018step, author={Smith, Gary}, title={{Step away from stepwise}}, journal={Journal of Big Data}, year={2018}, volume={5}, number={1}, eid={32}, doi={10.1186/s40537-018-0143-6}}@article{thompson1995stepwise, author={Thompson, Bruce}, title={{Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial}}, journal={Educational and Psychological Measurement}, year={1995}, volume={55}, number={4}, pages={525--534}, doi={10.1177/0013164495055004001}}