Co to jest metoda największej wiarygodności?
Metoda największej wiarygodności (ang. maximum likelihood, ML) to sposób estymacji parametrów modelu statystycznego: za oszacowania przyjmuje się te wartości parametrów, przy których zaobserwowane dane są najbardziej prawdopodobne w ramach przyjętego modelu. Punktem wyjścia jest funkcja wiarygodności L(θ) – prawdopodobieństwo (dla danych ciągłych: gęstość) otrzymania właśnie tych danych przy parametrach θ. W praktyce maksymalizuje się jej logarytm, bo iloczyn wielu małych liczb zamienia się w sumę:
Wiarygodność nie jest prawdopodobieństwem, że parametr ma daną wartość. To miara, jak dobrze dana wartość parametru „tłumaczy” dane. W psychologii ML jest domyślnym estymatorem w konfirmacyjnej analizie czynnikowej i SEM, w regresji logistycznej, w modelach mieszanych i w eksploracyjnej analizie czynnikowej metodą ML. W klasycznej regresji liniowej z normalnymi resztami daje te same współczynniki co metoda najmniejszych kwadratów.
Jak działa: najprostszy przykład
25 studentów pierwszego roku wypełniło skalę samotności (20–80; dane symulowane). Zakładamy model normalny z dwoma parametrami: średnią μ i odchyleniem σ. Program sprawdza różne wartości μ i σ i wybiera te, przy których suma logarytmów gęstości 25 wyników jest największa. Wynik numerycznej maksymalizacji to μ = 44.12 i σ = 9.41, przy log L = −91.52 (rysunek 1).
- Oszacowanie μ to dokładnie średnia z próby (44.12) – w modelu normalnym ML i intuicja się zgadzają.
- Oszacowanie σ dzieli sumę kwadratów przez n, a nie przez n − 1: 9.41 zamiast 9.61. Estymator ML wariancji jest więc w małych próbach lekko obciążony w dół. Ta sama własność sprawia, że w modelach mieszanych zamiast ML często używa się REML (ograniczonej wiarygodności), który uwzględnia liczbę szacowanych efektów stałych.
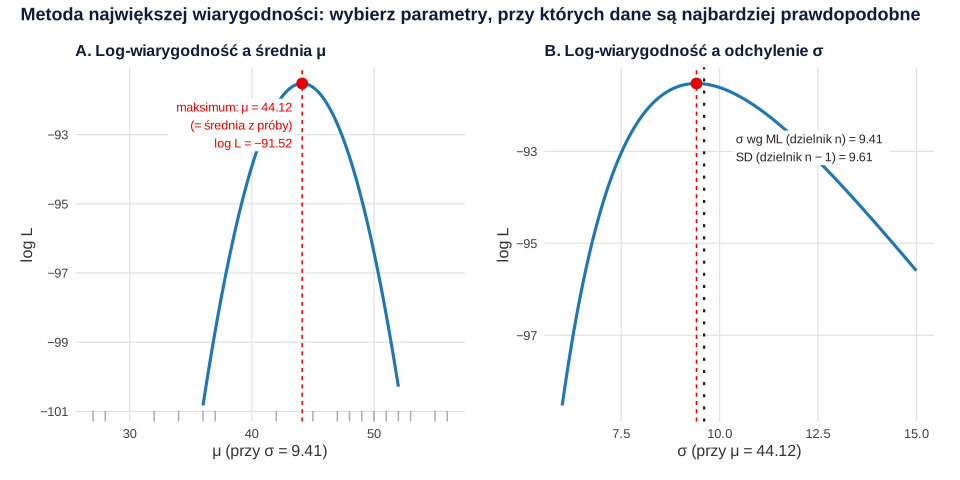
Kształt krzywej też niesie informację. Im ostrzej opada od maksimum, tym precyzyjniej dane wskazują parametr; z krzywizny log-wiarygodności (macierzy informacji) liczy się błędy standardowe oszacowań. Przy dużych próbach estymatory ML są zgodne, asymptotycznie nieobciążone i mają najmniejszą możliwą wariancję – pod warunkiem, że model (w tym założony rozkład) jest poprawny.
ML w CFA i SEM
W SEM danymi dla estymatora są zwykle wariancje i kowariancje zmiennych jawnych. ML szuka parametrów modelu (ładunków, wariancji, ścieżek), przy których macierz kowariancji odtworzona przez model jest najbliższa macierzy z próby, przy założeniu wielowymiarowego rozkładu normalnego. Odległość mierzy funkcja rozbieżności FML; jej minimum program podaje jako FMIN. Ta sama wielkość wyrażona przez log-wiarygodność daje statystykę chi-kwadrat modelu (CMIN):
To test ilorazu wiarygodności: porównuje model z modelem nasyconym, który odtwarza kowariancje bez błędu. W przykładzie jednoczynnikowej skali wsparcia (6 pozycji, N = 300, dane symulowane) log L modelu wynosi −2767.99, modelu nasyconego −2766.14, więc χ²(9) = 3.71, p = .929. Lavaan podaje FMIN = 0.006 i χ² = 2 × N × FMIN – to ta sama liczba. Z log-wiarygodności korzystają też test różnicy chi-kwadrat i kryteria informacyjne AIC i BIC.
Założenia, ograniczenia i alternatywy
| Sytuacja | Co się dzieje przy zwykłym ML | Co rozważyć |
|---|---|---|
| Dane ciągłe, ale nienormalne (skośność, kurtoza) | Oszacowania zwykle w porządku, błędy standardowe i χ² obciążone | MLR lub MLMV (odporne SE i skorygowana statystyka) |
| Pozycje porządkowe z małą liczbą kategorii | Ładunki i dopasowanie obciążone | WLSMV na korelacjach polichorycznych |
| Braki danych MCAR lub MAR | Usuwanie przypadków traci osoby i może obciążać wyniki | ML z pełną informacją (FIML) albo imputacja wielokrotna |
| Mała próba, słabe ładunki | Brak zbieżności, niedopuszczalne rozwiązania | Prostszy model, sprawdzenie identyfikacji, większa próba |
Maydeu-Olivares (2017) zwraca uwagę, że klasyczne błędy standardowe i statystyka chi-kwadrat w ML zakładają normalność; w jego symulacji najlepiej wypadły odporne błędy standardowe z korektą statystyki ze względu na średnią i wariancję (MLMV), nawet przy danych normalnych. Dla pozycji porządkowych Flora i Curran (2004) pokazują, że analiza korelacji polichorycznych z odpornym WLS sprawdza się w szerokim zakresie warunków. Alternatywy oparte na najmniejszych kwadratach opisują hasła GLS i ADF.
Braki danych. ML nie wymaga pełnych danych: w wersji z pełną informacją (FIML) wiarygodność liczy się dla każdej osoby z tych zmiennych, które ma. Enders i Bandalos (2001) wykazali w symulacji, że przy brakach MCAR i MAR FIML daje nieobciążone i bardziej efektywne oszacowania niż usuwanie przypadków. W przykładzie około 13% osób nie odpowiedziało na pozycje 5 i 6, częściej przy niskich wynikach pozycji 1. Usuwanie przypadków zostawiło 228 z 300 osób, a FIML wykorzystał wszystkie 300; niestandaryzowane ładunki pozycji 5 i 6 z FIML (0.663 i 0.655) były bliższe ładunkom z pełnych danych (0.646 i 0.688) niż te po usunięciu przypadków (0.691 i 0.617). Mechanizmy braków opisuje hasło braki danych (MCAR, MAR, MNAR).
Cały proces modelowania – od specyfikacji po interpretację dopasowania – pokazują poradniki CB-SEM krok po kroku i CB-SEM w R w pakiecie lavaan.
Jak opisać estymację w pracy (APA)
Schreiber i in. (2006) zaliczają opis estymatora, sposobu postępowania z brakami danych i oprogramowania do podstawowych informacji w raporcie z CFA i SEM. Wzór dla przykładu:
Przy brakach danych dopisz zdanie w rodzaju: „Braki danych w pozycjach 5 i 6 (12–13% osób) uwzględniono metodą FIML, dzięki czemu analizą objęto wszystkie 300 osób”. Jeśli dane odbiegają od normalności, napisz, której korekty użyto (np. MLR), i podawaj skorygowaną statystykę chi-kwadrat oraz indeksy dopasowania – wzór tabeli znajdziesz na stronie tabela dopasowania modelu CFA w APA.
Przykład w R
Kod szacuje μ i σ metodą ML przez numeryczną maksymalizację log-wiarygodności i porównuje wynik z rozwiązaniem analitycznym, dopasowuje model CFA estymatorem ML i pokazuje, że chi-kwadrat to iloraz wiarygodności, a na koniec porównuje usuwanie przypadków z FIML. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Wiarygodność, ML w lavaan i FIML
R
# Część 1. Dane symulowane: poczucie samotności (skala 20–80) u 25 studentów pierwszego roku
set.seed(2241)
y <- round(rnorm(25, 44, 9))
n <- length(y)

# Logarytm wiarygodności modelu normalnego dla parametrów mu i sigma
logL <- function(par) sum(dnorm(y, mean = par[1], sd = par[2], log = TRUE))
# Numeryczna maksymalizacja (optim minimalizuje, więc podajemy −logL)
opt <- optim(c(40, 5), function(p) -logL(p), method = "L-BFGS-B", lower = c(-Inf, 0.01))
round(c(mu_ML = opt$par[1], sigma_ML = opt$par[2], logL_max = -opt$value), 3)
# Rozwiązanie analityczne: mu = średnia, sigma^2 = SS / n (a nie SS / (n − 1))
round(c(srednia = mean(y), sigma_n = sqrt(sum((y - mean(y))^2) / n), SD_n_minus_1 = sd(y)), 3)

# Część 2. ML w konfirmacyjnej analizie czynnikowej (lavaan): 6 pozycji skali wsparcia (1–7), N = 300
suppressPackageStartupMessages(library(lavaan))
set.seed(2242)
N <- 300
czynnik <- rnorm(N)
lad <- c(.80, .75, .70, .65, .60, .55)
X <- sapply(lad, function(l) round(pmin(pmax(4.6 + 1.3 * (l * czynnik + sqrt(1 - l^2) * rnorm(N)), 1), 7)))
colnames(X) <- paste0("w", 1:6)
dane <- as.data.frame(X)
model <- "wsparcie =~ w1 + w2 + w3 + w4 + w5 + w6"
fit <- cfa(model, data = dane, estimator = "ML")
fm <- fitMeasures(fit, c("logl", "unrestricted.logl", "chisq", "df", "pvalue", "fmin", "cfi", "rmsea", "srmr"))
round(fm, 3)
# Statystyka chi-kwadrat to iloraz wiarygodności: 2 × (logL modelu nasyconego − logL modelu)
round(c(chisq_z_logL = 2 * (fm[["unrestricted.logl"]] - fm[["logl"]]), chisq_z_fmin = 2 * N * fm[["fmin"]]), 3)
ss <- standardizedSolution(fit)[1:6, c("lhs", "op", "rhs", "est.std", "se")]
ss[, 4:5] <- round(ss[, 4:5], 3); ss

# Część 3. Braki danych w w5 i w6 zależne od w1 (MAR); usuwanie przypadków a pełna informacja (FIML)
set.seed(2243)
dane_b <- dane
p_brak <- plogis(-2.2 + 0.6 * (dane$w1 - 4.6))
dane_b$w5[runif(N) < p_brak] <- NA; dane_b$w6[runif(N) < p_brak] <- NA
round(colMeans(is.na(dane_b[, c("w5", "w6")])), 3)
fit_lw   <- cfa(model, data = dane_b, estimator = "ML")                    # usuwanie przypadków (listwise)
fit_fiml <- cfa(model, data = dane_b, estimator = "ML", missing = "fiml")  # pełna informacja
c(N_listwise = lavInspect(fit_lw, "nobs"), N_fiml = lavInspect(fit_fiml, "nobs"))
round(cbind(pelne = coef(fit)[1:5], listwise = coef(fit_lw)[1:5], fiml = coef(fit_fiml)[1:5]), 3)
Wynik w R
   mu_ML sigma_ML logL_max
  44.120    9.412  -91.523
     srednia      sigma_n SD_n_minus_1
      44.120        9.412        9.606
             logl unrestricted.logl             chisq                df
        -2767.990         -2766.135             3.710             9.000
           pvalue              fmin               cfi             rmsea
            0.929             0.006             1.000             0.000
             srmr
            0.014
chisq_z_logL chisq_z_fmin
        3.71         3.71
       lhs op rhs est.std    se
1 wsparcie =~  w1   0.824 0.028
2 wsparcie =~  w2   0.710 0.035
3 wsparcie =~  w3   0.715 0.035
4 wsparcie =~  w4   0.598 0.043
5 wsparcie =~  w5   0.528 0.047
6 wsparcie =~  w6   0.564 0.045
   w5    w6
0.133 0.123
N_listwise     N_fiml
       228        300
             pelne listwise  fiml
wsparcie=~w2 0.871    0.910 0.881
wsparcie=~w3 0.911    0.977 0.927
wsparcie=~w4 0.728    0.729 0.735
wsparcie=~w5 0.646    0.691 0.663
wsparcie=~w6 0.688    0.617 0.655
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lavaan (CFA i FIML); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- „Wiarygodność” jako prawdopodobieństwo hipotezy. Najwyższa wiarygodność oznacza parametry najlepiej zgodne z danymi w danym modelu, a nie, że model jest prawdziwy.
- Zwykłe ML przy wyraźnej nienormalności lub pozycjach porządkowych. Oszacowania mogą być akceptowalne, ale błędy standardowe i χ² wprowadzają w błąd; użyj odpornej wersji albo estymatora dla danych porządkowych.
- Usuwanie przypadków z brakami, choć dostępny jest FIML. Tracisz osoby i ryzykujesz obciążenie przy brakach MAR.
- Brak informacji o estymatorze w raporcie. „Model oszacowano w AMOS” nie mówi, czy użyto ML, MLR czy innej metody.
- Porównywanie log-wiarygodności modeli dopasowanych do różnych danych (np. różnej liczby osób po usunięciu braków) – test ilorazu wiarygodności i AIC wymagają tych samych obserwacji.
- Ignorowanie ostrzeżeń o zbieżności i niedopuszczalnych oszacowaniach, np. ujemnych wariancjach (zob. przypadek Heywooda).
Najczęstsze pytania
Na czym polega metoda największej wiarygodności w prostych słowach?
Program sprawdza różne wartości parametrów modelu i wybiera te, przy których otrzymanie Twoich danych byłoby najbardziej prawdopodobne. Dla wyników z rozkładu normalnego oszacowanie średniej metodą ML to po prostu średnia z próby.
Dlaczego estymator ML wariancji dzieli przez n, a nie przez n − 1?
Bo maksimum funkcji wiarygodności modelu normalnego wypada właśnie przy sumie kwadratów podzielonej przez n. Taki estymator jest w małych próbach lekko obciążony w dół; dlatego w modelach mieszanych często używa się REML, który tę stratę uwzględnia.
Czym różni się ML od MLR w SEM?
Oba dają te same oszacowania parametrów. MLR dodatkowo koryguje błędy standardowe i statystykę chi-kwadrat tak, by były odporne na odstępstwa od normalności. Przy skośnych danych ciągłych bezpieczniej raportować MLR.
Czy metodę największej wiarygodności można stosować przy brakach danych?
Tak – w wersji z pełną informacją (FIML) wiarygodność liczy się dla każdej osoby z dostępnych odpowiedzi. Przy brakach MCAR i MAR daje to nieobciążone oszacowania bez usuwania osób (Enders i Bandalos, 2001).
Skąd się bierze chi-kwadrat w CFA estymowanej metodą ML?
To test ilorazu wiarygodności: dwukrotna różnica log-wiarygodności modelu nasyconego i Twojego modelu. W przykładzie na tej stronie 2 × (−2766.14 + 2767.99) daje χ²(9) = 3.71.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Enders, C. K., & Bandalos, D. L. (2001). The relative performance of full information maximum likelihood estimation for missing data in structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 430–457. https://doi.org/10.1207/s15328007sem0803_5
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466 ● Otwarty dostęp: pełny tekst
- Maydeu-Olivares, A. (2017). Maximum likelihood estimation of structural equation models for continuous data: Standard errors and goodness of fit. Structural Equation Modeling: A Multidisciplinary Journal, 24(3), 383–394. https://doi.org/10.1080/10705511.2016.1269606
- Schreiber, J. B., Nora, A., Stage, F. K., Barlow, E. A., & King, J. (2006). Reporting structural equation modeling and confirmatory factor analysis results: A review. The Journal of Educational Research, 99(6), 323–338. https://doi.org/10.3200/joer.99.6.323-338
Cytowania BibTeX
@article{enders2001relative, author={Enders, Craig K. and Bandalos, Deborah L.}, title={{The relative performance of full information maximum likelihood estimation for missing data in structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={430--457}, doi={10.1207/s15328007sem0803_5}}@article{flora2004empirical, author={Flora, David B. and Curran, Patrick J.}, title={{An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data}}, journal={Psychological Methods}, year={2004}, volume={9}, number={4}, pages={466--491}, doi={10.1037/1082-989x.9.4.466}}@article{maydeuolivares2017maximum, author={Maydeu-Olivares, Alberto}, title={{Maximum likelihood estimation of structural equation models for continuous data: Standard errors and goodness of fit}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2017}, volume={24}, number={3}, pages={383--394}, doi={10.1080/10705511.2016.1269606}}@article{schreiber2006reporting, author={Schreiber, James B. and Nora, Amaury and Stage, Frances K. and Barlow, Elizabeth A. and King, Jamie}, title={{Reporting structural equation modeling and confirmatory factor analysis results: A review}}, journal={The Journal of Educational Research}, year={2006}, volume={99}, number={6}, pages={323--338}, doi={10.3200/joer.99.6.323-338}}